

フロンティアLLMにおける強化学習:RLHFから検証可能な報酬へ
 Toni Lopez Co-Founder at Karumi
大規模言語モデル(LLM)を支えるアーキテクチャと手法は、2025年から2026年にかけて大きく変わりました。かつて基盤モデルを構築するといえば、膨大な生データを使った大規模な事前学習に大きく依存するのが一般的でした。その後に、教師ありファインチューニング(SFT)と人間のフィードバックによる強化学習(RLHF)を用いた基本的なアラインメントの段階が続くのが通例です。しかし、インターネット上の高品質な学習データが枯渇し始め、真の推論能力を備えたAIへのニーズが高まるにつれ、業界はアプローチの転換を迫られました。
現在では、研究者もテック企業も、インタラクティブな事後学習と「テスト時計算(test-time compute)」(回答前に処理・思考する時間をモデルに多く与えること)に、より多くの注力と計算資源を振り向けています。この新しい状況において、強化学習(RL)はもはやモデルのトーンを調整したり不適切な出力を除外したりするための道具ではありません。事後学習の主要なエンジンの一つとなっており、特に計画を立て、中間結果を検証し、ツールを使い、より長い推論トレースを通じて回答を改善する必要があるモデルにとって欠かせない存在です。
OpenAI、Meta、Google DeepMind、Anthropic、DeepSeek、Moonshot AI、Mistralといった組織のフロンティアモデルによって形づくられた現在の最先端は、方策最適化アルゴリズムの適用方法がきわめて多様であることを示しています。業界では、ニューラル報酬モデルを補完するものとして、検証可能な報酬システム、非同期の選好最適化、モデルによる批評、環境からのフィードバックの活用が進んでいます。
本レポートでは、現在のトップモデルで強化学習がどのように活用されているかを詳しく解説します。
「古典的パラダイム」:2025年以前のRLHF
2025年の大転換以前、LLMをアラインメントする標準的な方法は、OpenAIのInstructGPTの影響を強く受けていました。この古典的なアプローチは人間のフィードバックによる強化学習(RLHF)に基づき、厳格な3段階のプロセスをたどります。まず、人間のアノテーターが作成した例を使って、モデルに教師ありファインチューニング(SFT)を施します。次に、人間の選好データセットで別の報酬モデル(RM)を学習させ、人間が最も好む回答を予測できるようにします。最後に、実行中に方策を更新するアルゴリズムであるProximal Policy Optimization(PPO)を用いて、SFTモデルをこの報酬モデルに対して最適化します。
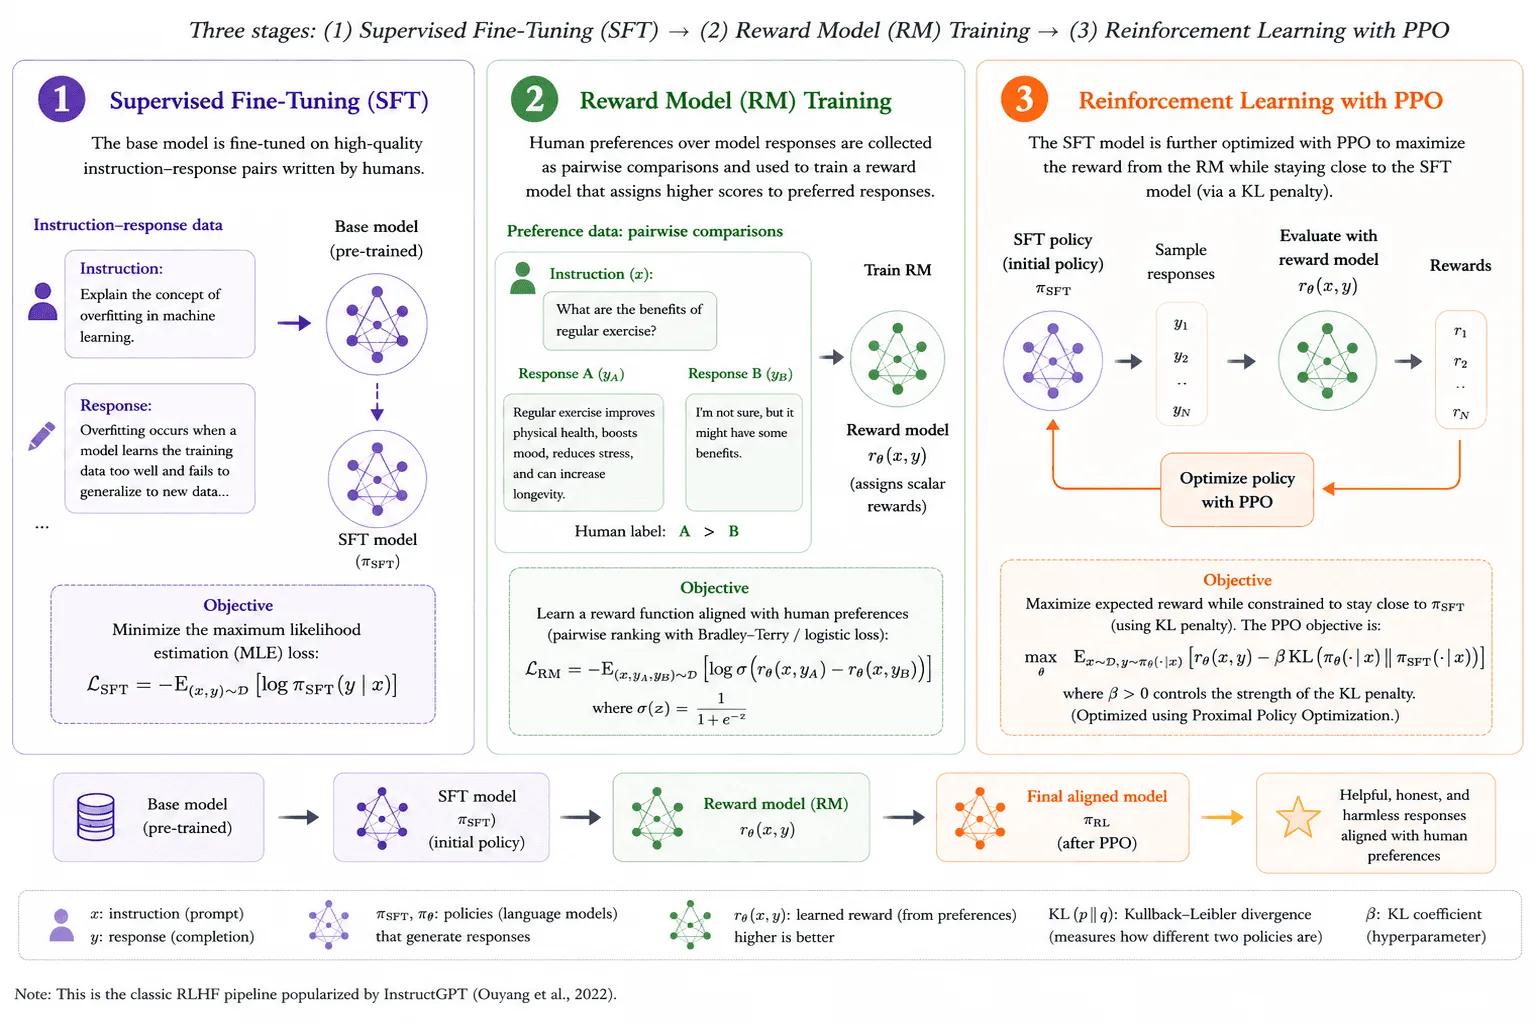
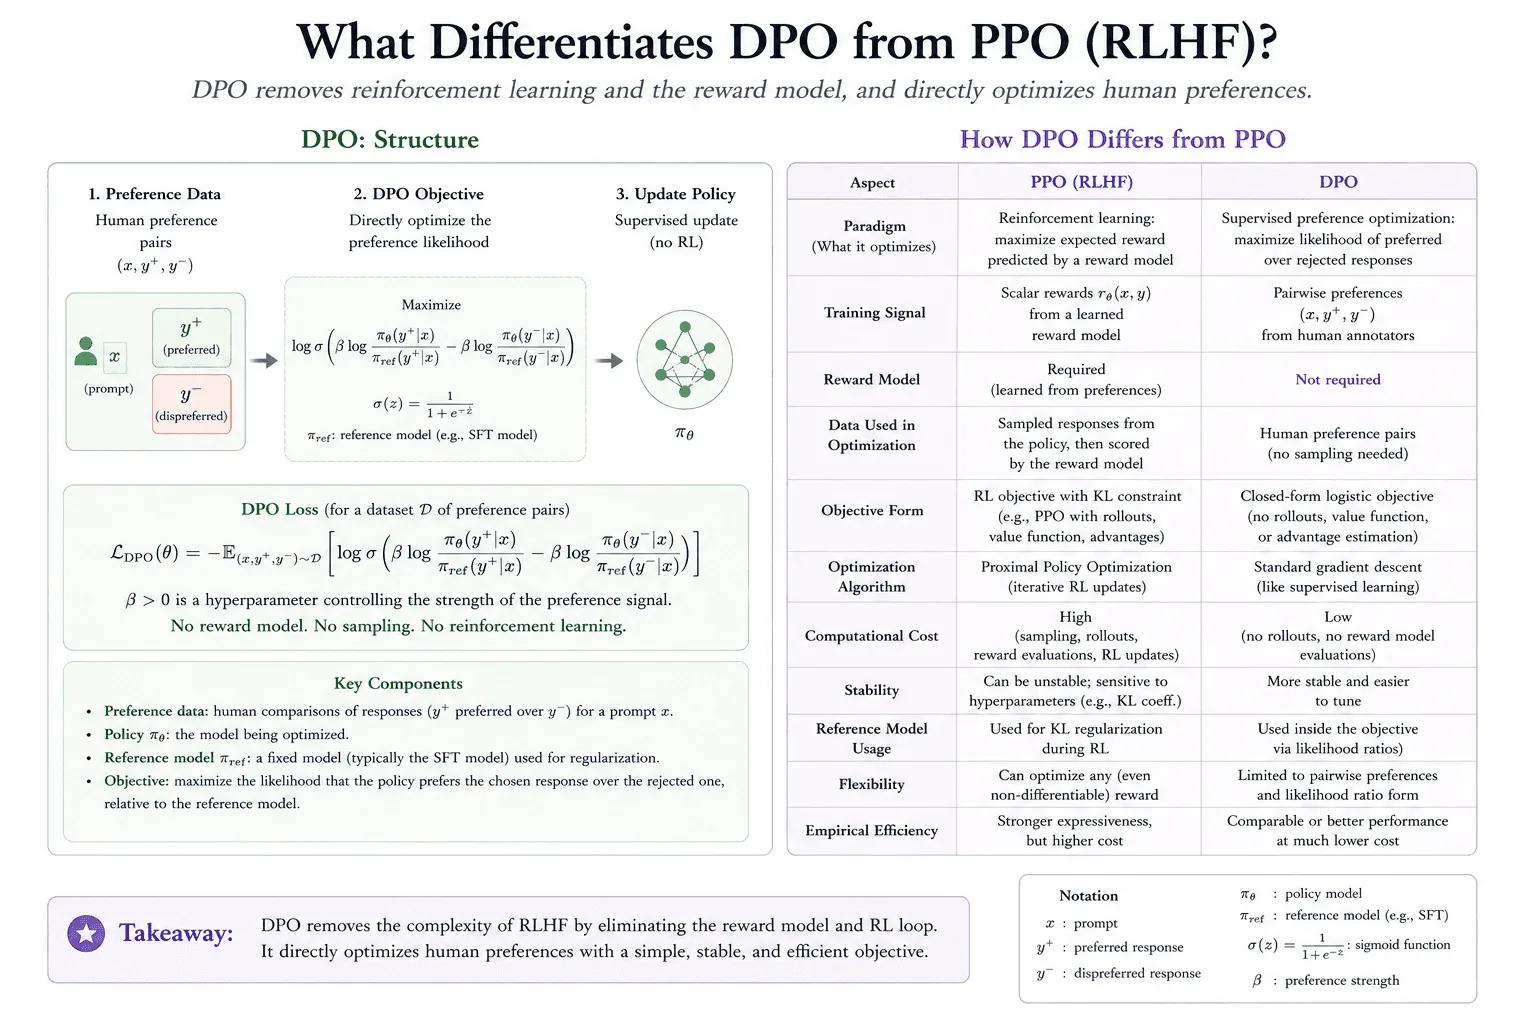
この方法は基本的なトーン調整や簡単な指示への追従にはうまく機能しましたが、古典的なRLHFには深刻な欠点がありました。その一つが「アラインメント税(alignment tax)」と呼ばれる問題で、モデルを礼儀正しく安全に見えるよう最適化すると、根底にある推論能力や学術的なスキルが損なわれてしまうというものです。また、PPOは複数のモデル(Actor、Critic、Reference、Reward)を同時に稼働させる必要があるため、非常に複雑で膨大なメモリを必要とすることで知られていました。
2023年後半、最初の大きな簡素化としてDirect Preference Optimization(DPO)が登場しました。DPOは、独立した報酬モデリングの工程を完全に省略できることを数学的に示し、人間の選好データセットから直接方策を最適化できるようにしました。しかし、2025年以前のDPOは厳密に「オフライン」の手法でした。PPOもDPOも、人間がアノテーションした静的なデータに完全に依存していたため、モデルが人間の推論能力を本当の意味で超えることはできませんでした。この天井を突破するために、業界は検証可能な報酬と、現在見られる「オンライン」手法へと移行する必要があったのです。
選好アラインメントから検証可能な報酬へ
現代のLLMの事後学習における最大の変化は、企業が単に「より多くのRL」を使うようになったことではありません。より本質的な変化は、報酬シグナルそのものが多様化したことです。初期のRLHFは、主に人間が好むもの、つまり明瞭さ、有用性、無害性、会話のトーンを最適化していました。それは有益でしたが、人間が容易に判断できる範囲を超えた答えをモデルが見つけ出すための信頼できる手段にはなりませんでした。
現代の推論システムは、複数の種類のフィードバックを組み合わせています。人間の選好に基づく報酬は、アラインメントやスタイルの面で今も重要です。Direct Preference Optimization(DPO)は、完全なPPOループを回さずに選好ペアから学習することで、これを簡素化します。AIフィードバックによる強化学習(RLAIF)は、人間の判断の一部を、多くの場合は憲法やルーブリックに導かれたAIによる批評に置き換えます。検証可能な報酬による強化学習(RLVR)はさらに踏み込み、数学の解答、テストに合格するコード、期待される形式に合致する構造化出力など、ルールで確認できる回答に報酬を与えます。
さらに、環境報酬という新しいカテゴリーも広がりつつあります。回答が良いかどうかを人間や報酬モデルに尋ねる代わりに、モデルは外部システムの中で行動します。コンパイラは生成されたコードが実行できるかを確認できます。ユニットテストはパッチを検証できます。定理検証器、検索システム、ブラウザ、ツール利用環境は、選好ラベルよりも実態に即したフィードバックを提供できます。
もう一つの重要な区別が、結果報酬とプロセス報酬です。結果報酬は最終的な答えだけを評価します。証明は完了したか、コードはテストに通ったか、数値は一致したか、という点です。プロセス報酬は、推論の中間ステップを評価しようとします。検証者・修正者(verifier-reviser)システムは、人間がすべてのステップに手作業でラベルを付けることなくプロセス監督に近づけるための実践的な方法の一つです。
この区別が重要なのは、学習時のRLとテスト時計算が関連しながらも同一ではないからです。学習時のRLはモデルの重みを変えます。テスト時計算は、回答前にサンプリング、検証、修正、探索を行うための推論予算をモデルに多く与えます。最も強力なフロンティア推論システムは、通常その両方を組み合わせています。RLが有用な推論行動を教え、推論時の追加計算がその行動を発揮する余地を与えるのです。
フロンティアモデルにおける推論革命(2025〜2026年)
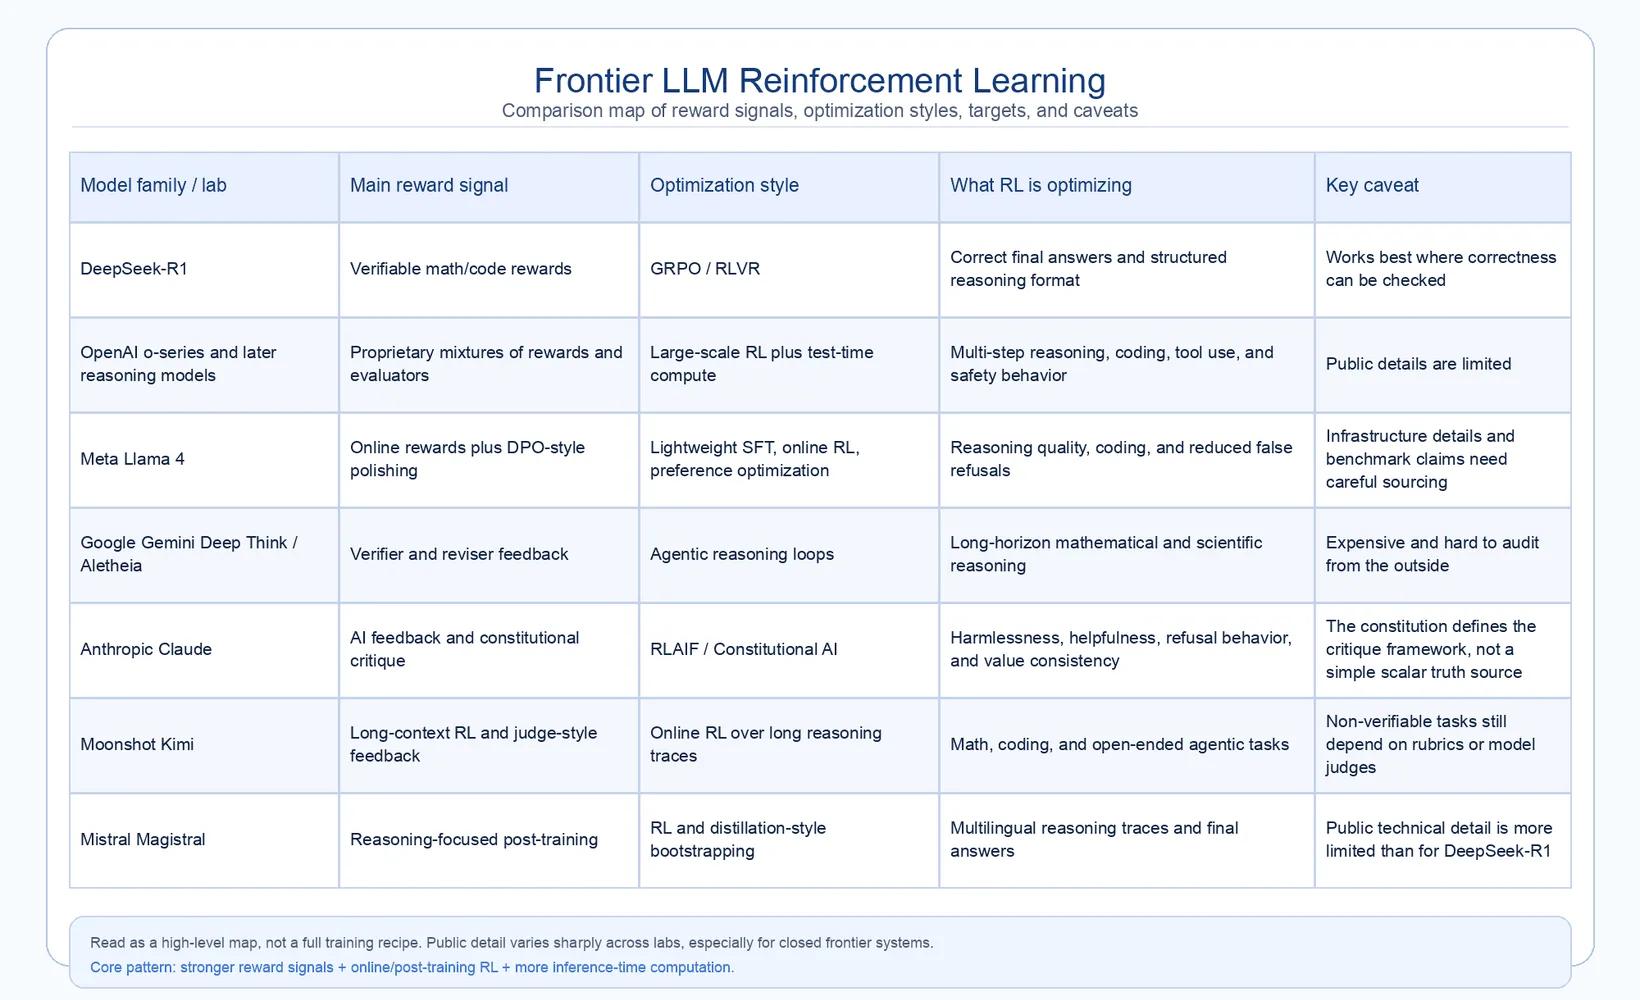
最近の研究によれば、複雑な数学問題の解決、コード生成、論理的分析における大きな飛躍は、単にモデルを大きくすることだけで生まれるわけではありません。より強力な事後学習、より優れた報酬シグナル、そして推論時のより多くの計算にも左右されます。各社は、巨大な言語モデルに豊かで安定したフィードバックを与えるという同じ中核的課題に、それぞれ独自の方法で取り組んできました。
DeepSeek:検証可能な報酬とGRPO
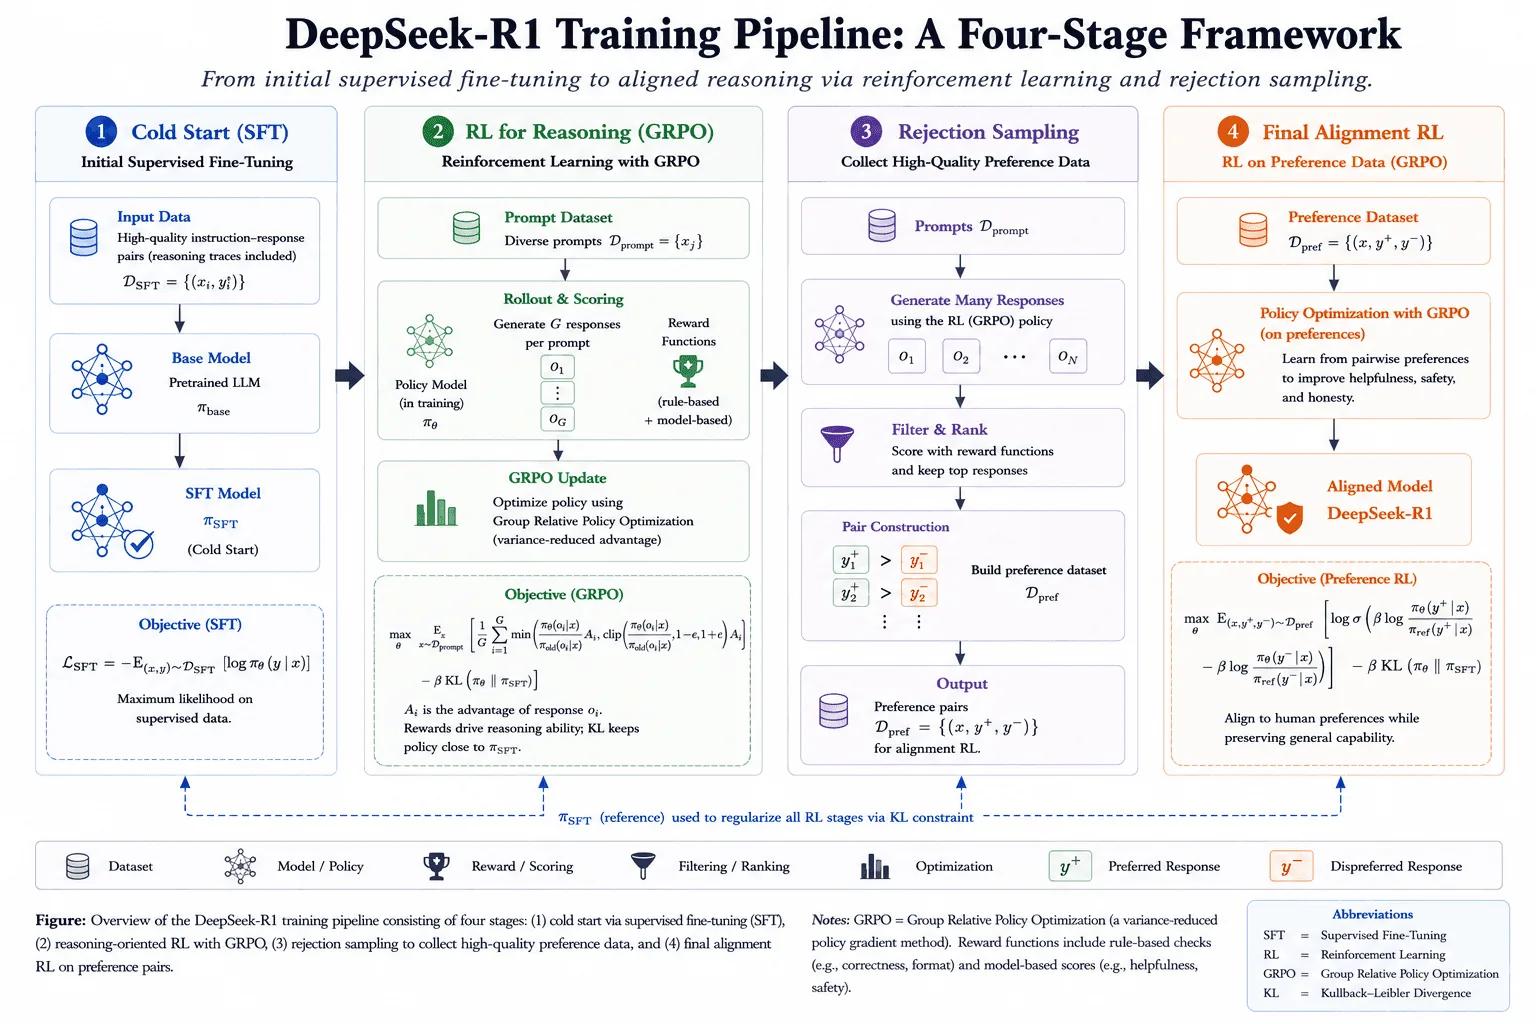
DeepSeek-R1とその前身であるDeepSeek-R1-Zeroは、RLVRのパラダイムを広く知らしめました。InstructGPT以来の従来手法に一石を投じる形で、DeepSeekの研究者たちはR1-Zeroによって、初期の教師ありファインチューニングを経ずとも、大規模な強化学習を通じてベースモデルに高度な推論能力が生まれ得ることを示しました。320億パラメータのモデル(Qwen-32B-Base)を数万ステップにわたるRLで学習させたところ、当初はやや雑然としていて複数の言語が混在していたものの、構造化された思考行動が自発的に現れたのです。
その後、最終的なDeepSeek-R1のパイプラインでは、コールドスタート用の教師ありデータ、リジェクションサンプリング、追加のアラインメント段階が加えられ、挙動がより読みやすく、安定し、実用的なものになりました。
この学習を安定させ、最終的なDeepSeek-R1モデルまでスケールさせるために、チームはGroup Relative Policy Optimization(GRPO)という特定のアルゴリズムを採用しました。ベースラインスコアの計算に重い「Critic」モデルを必要とした従来のPPOとは異なり、GRPOははるかに軽量です。同じプロンプトに対して複数の異なる回答をサンプリングし、それらを互いに比較して採点します。
これにより、グループ内の他の回答と比べて悪い回答には強いペナルティを、良い回答には報酬を与える目的関数が生まれます。同時に、壊滅的忘却を避けるために更新幅は抑えられます。この効率性のおかげで、DeepSeekは通常のごく一部の計算資源で、巨大なプロプライエタリモデルと競うことができました。
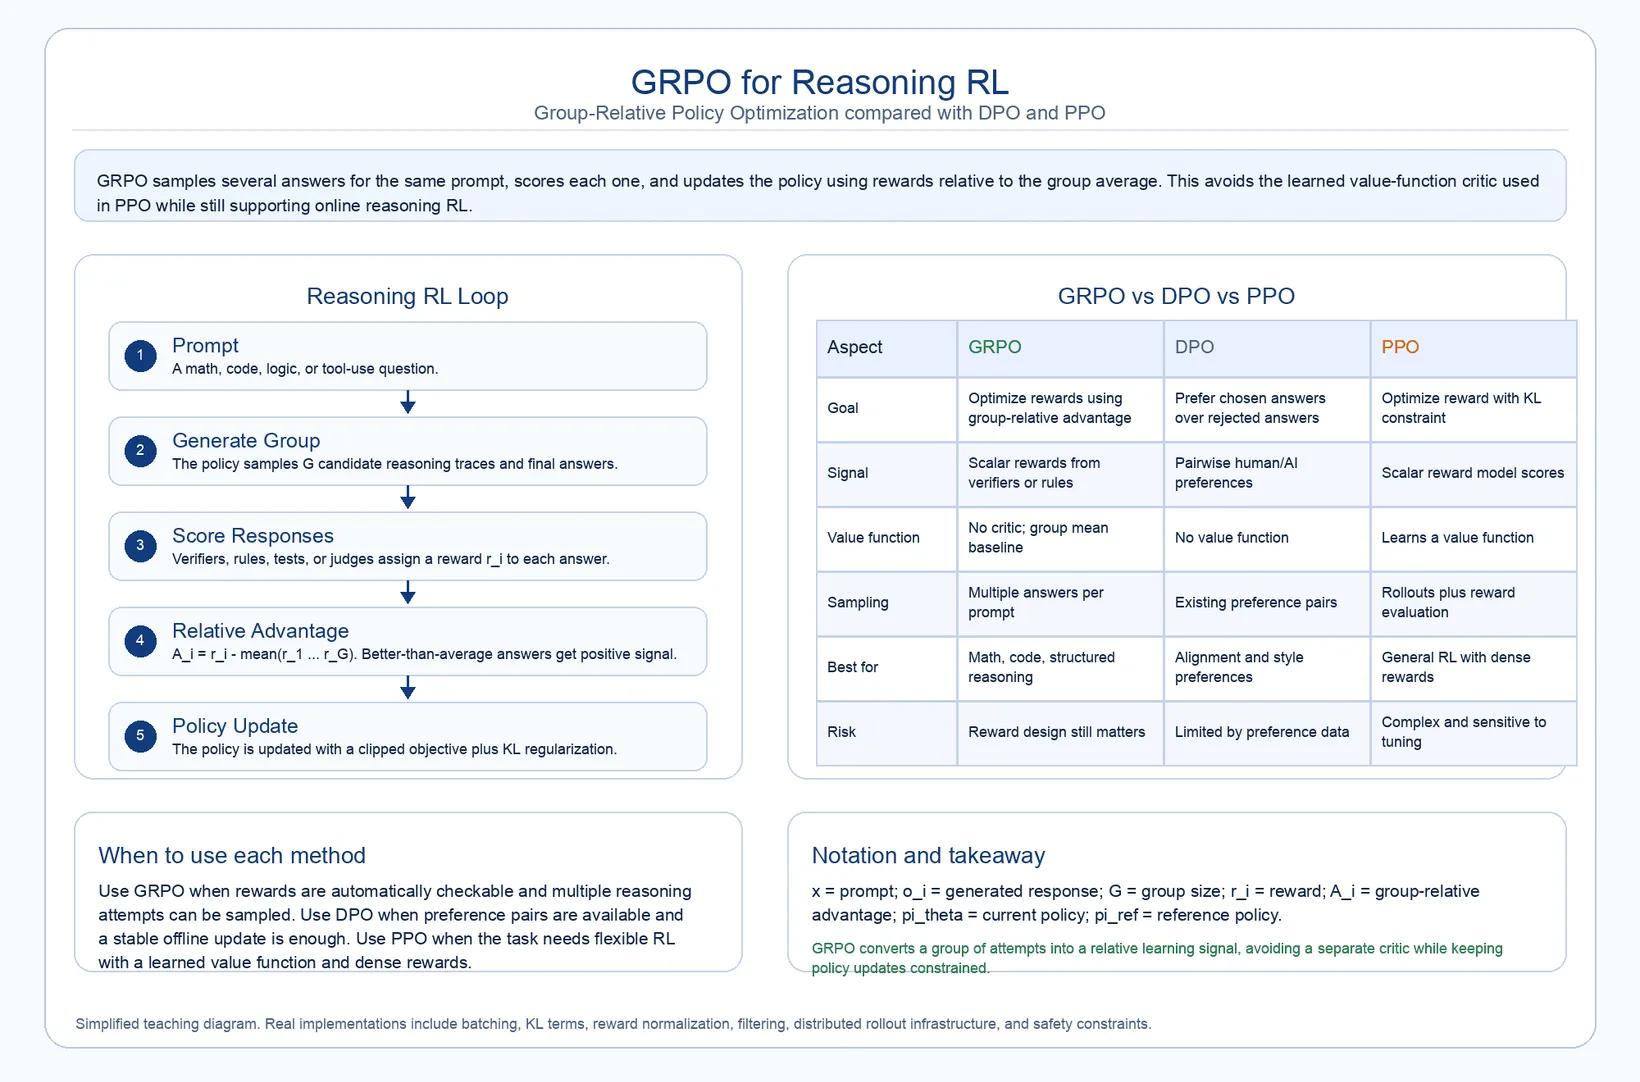
GRPOの成功は、主に検証可能な報酬による強化学習(RLVR)の活用によるものです。人間の評価者や、簡単にだまされたり「ハック」されたりしかねないAI報酬モデルに頼る代わりに、DeepSeekは厳格なルールベースの報酬を使いました。主な報酬は正確性とフォーマットの2つです。正確性報酬は、最終的な答えが完全に正しいかどうか(コードであればユニットテストに合格するかどうか)を確認します。フォーマット報酬は、モデルに内部の思考過程を厳格なXMLタグの中に書かせることで、思考の連鎖(chain-of-thought)が読みやすく構造化されたものになるようにします。
この手法はその後、GRPO-$\lambda$へと発展しました。研究者たちは、長い回答に厳しいペナルティを科す(際限なく考え続けるのを防ぐため)と、学習初期に精度が急落することに気づきました。GRPO-$\lambda$は、ペナルティを動的に調整することでこの問題を解決します。モデルが問題に正解できていない間は、一時的に長さを気にしないようにし、自由に解を探索できるようにするのです。この巧みな調整により、AIME 2024やGSM8Kといった難関ベンチマークで精度が向上し、驚くべきことに平均回答長も半分に短縮されました。
OpenAI:動的な推論、Makora、安全性
「o」シリーズやその後のフロンティア推論モデルを擁するOpenAIのエコシステムは、回答前により長く推論する必要がある領域へと強化学習を押し広げてきました。OpenAIはRLを抽象的な思考だけでなく、ハードウェアアクセラレータ向けのコード作成やサイバー攻撃への防御強化にも活用しています。推論モデルの中核にあるのは、2次元のスケーリング則という考え方です。つまり、RL学習により多くの計算資源を投じるほど、そしてテスト時により多くの推論時間を与えるほど(テスト時計算)、モデルの精度は向上し得るというものです。
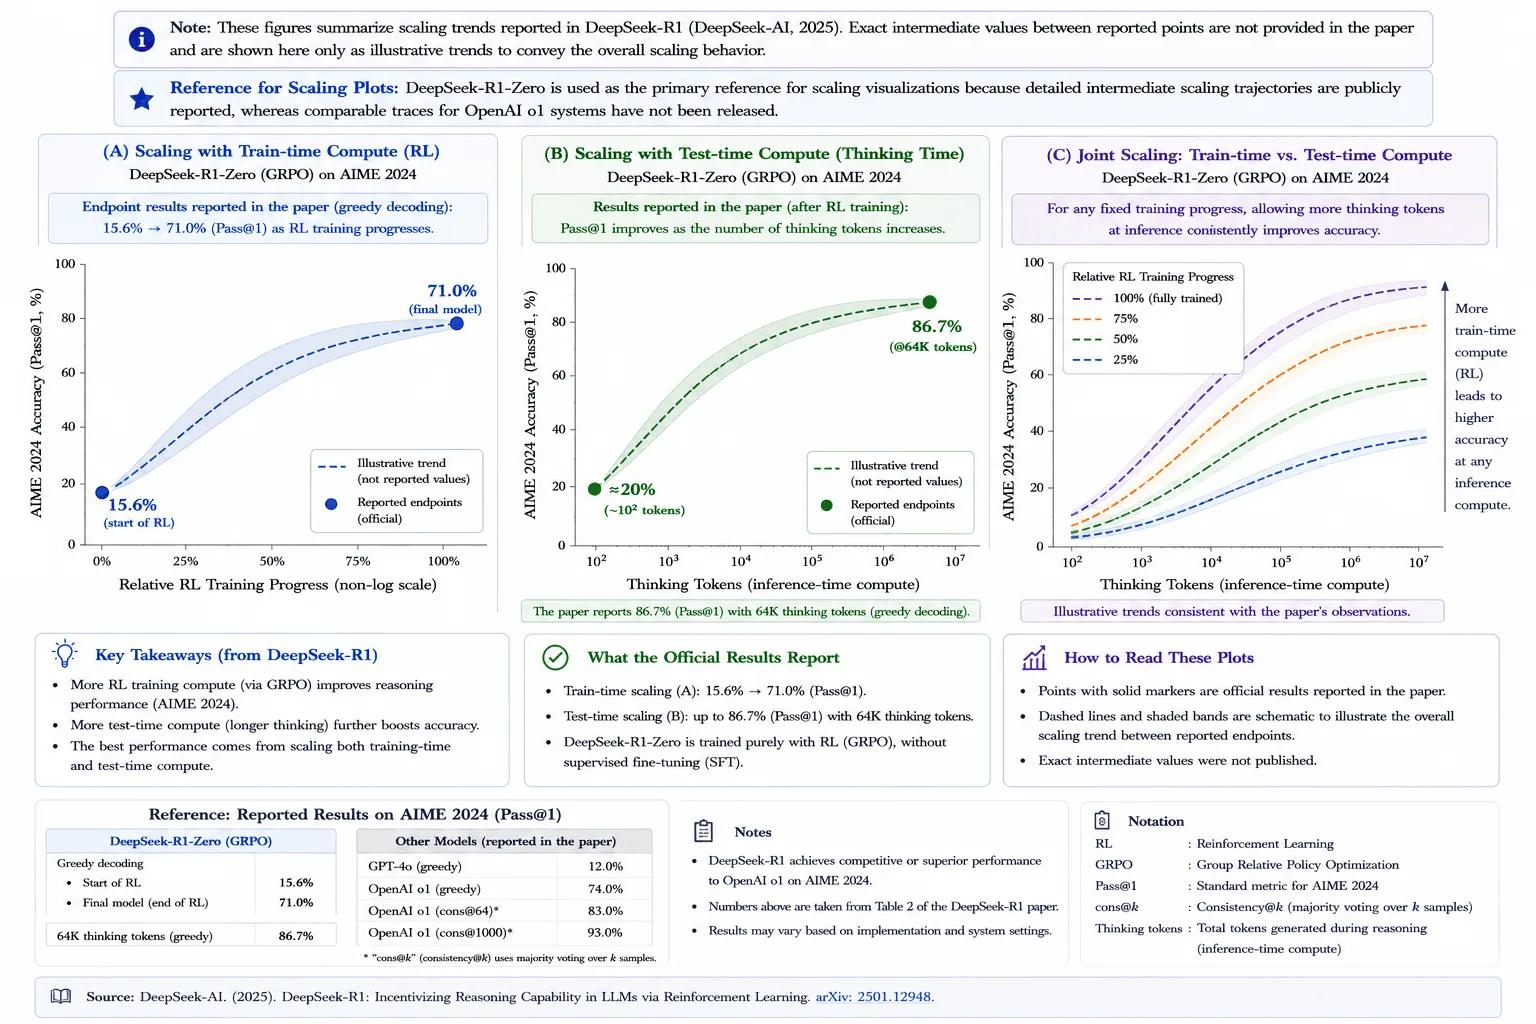
この図では、学習時・テスト時のスケーリングという一般的な考え方を示す公開データとして、DeepSeek-R1-Zeroのスケーリング曲線を用いています。OpenAIも推論モデルについて定性的に同様の挙動を説明していますが、同程度に詳細な中間スケーリングの推移は公開していません。
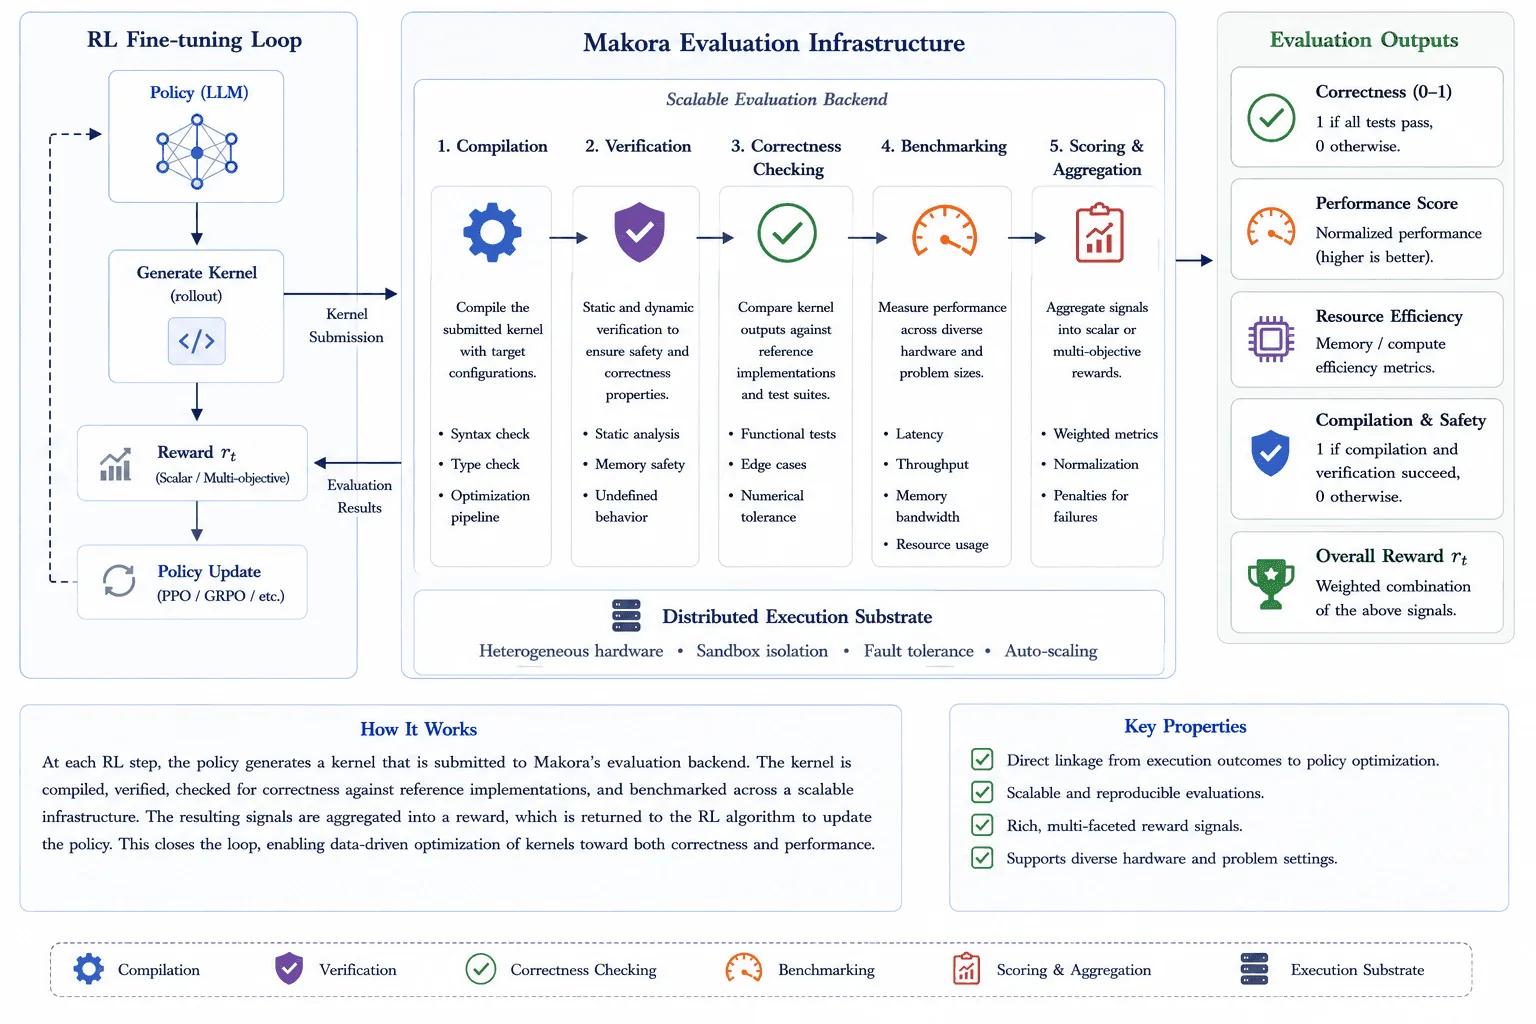
報告された結果を見れば、このパラダイムがなぜこれほど大きな影響力を持つようになったのかがわかります。数学や科学のベンチマークでは、大規模なRLと推論時の追加計算によって、推論モデルが通常のチャットモデルをはるかに上回っているように見えます。しかし、最も興味深い応用はおそらく、人間による学習データがほとんど、あるいはまったく存在しない高度に技術的な分野でのRLの活用でしょう。OpenAIはMakoraという評価システムを通じて、カーネル(ハードウェア向けに高度に最適化されたコード)の作成を純粋なRL問題として扱いました。
LLMがコードの案を書くと、それがバックエンドシステムに送られ、コンパイルされ、動作するかどうかが確認され、実行速度が計測されます。実行が速いほど報酬は高くなります。これにより、現実のソフトウェア性能とモデルの学習が直接つながるループが完成しました。この手法によって、モデルは大半のテストで標準的なコンパイラの2倍の速さで動くコードを書けるようになりました。
Meta Llama 4:非同期最適化と軽量DPO
Llama 4ファミリー(Scout 17B、Maverick 17B、Behemoth 288Bモデルを含む)におけるMetaのアプローチは、オープンソースモデルでオンライン強化学習をスケールさせる別の方法を示しています。膨大な教師ありデータに依存していた従来のモデルとは異なり、Llama 4の事後学習は、無駄を省いた的を絞ったパイプラインを採用していると報告されています。少量の軽量なSFTの後に大規模なオンラインRLを行い、最後にDirect Preference Optimization(DPO)で仕上げるという流れです。
Llama 4 Maverickの事後学習における技術的な目玉は、非同期のRLインフラです。通常、PPOやGRPOのようなアルゴリズムは、同じサーバーノード上でテキストを生成し、モデルを更新します。そのため、報酬の計算を待つ間に学習用GPUがアイドル状態になり、ボトルネックが生じます。Metaはワークロードを分割して報酬計算を独立して実行させることで、コードテストのような複雑な報酬の評価にかかる時間を隠蔽していると説明しています。
この段階で、Metaは難易度の高いプロンプトを重視しています。その後、最終段階のDPOがトーンを磨き上げ、安全な質問への回答をモデルが誤って拒否するケースを減らします。このようにLlama 4は、難しい推論行動にはRLを、ユーザー向けの振る舞いには選好最適化を用いる、ハイブリッドな事後学習スタックの好例となっています。
Google Gemini Deep Think:自律的な研究とAletheia
Google DeepMindのエコシステム、特にGemini Deep Thinkと関連する研究エージェントは、長期的な視野を要する科学的推論に強化学習を適用した最も明確な例の一つです。多くのモデルが単一の回答を最適化するのに対し、Deep Think型のシステムは、自律的で複数の要素から成るエージェントを軸に推論を組み立てます。その最先端の例が、数学エージェントのAletheiaです。
Aletheiaは、数学の証明に厳格なプログラミング言語を使わず、すべて自然な英語で処理します。Generator、Verifier、Reviserの3つの要素からなる強化ループを用いています。難しい定理が与えられると、モデルは考えられる解答を書き出します。Verifierが小さな誤りを見つけても、回答全体を破棄するわけではありません。Reviserに渡して論理を修正させます。回答が破棄されるのは、重大で修正不能な誤りがある場合だけです。Aletheiaは外部検索や科学文献の検索を活用して主張を検証し、架空の引用をでっち上げることも防げます。
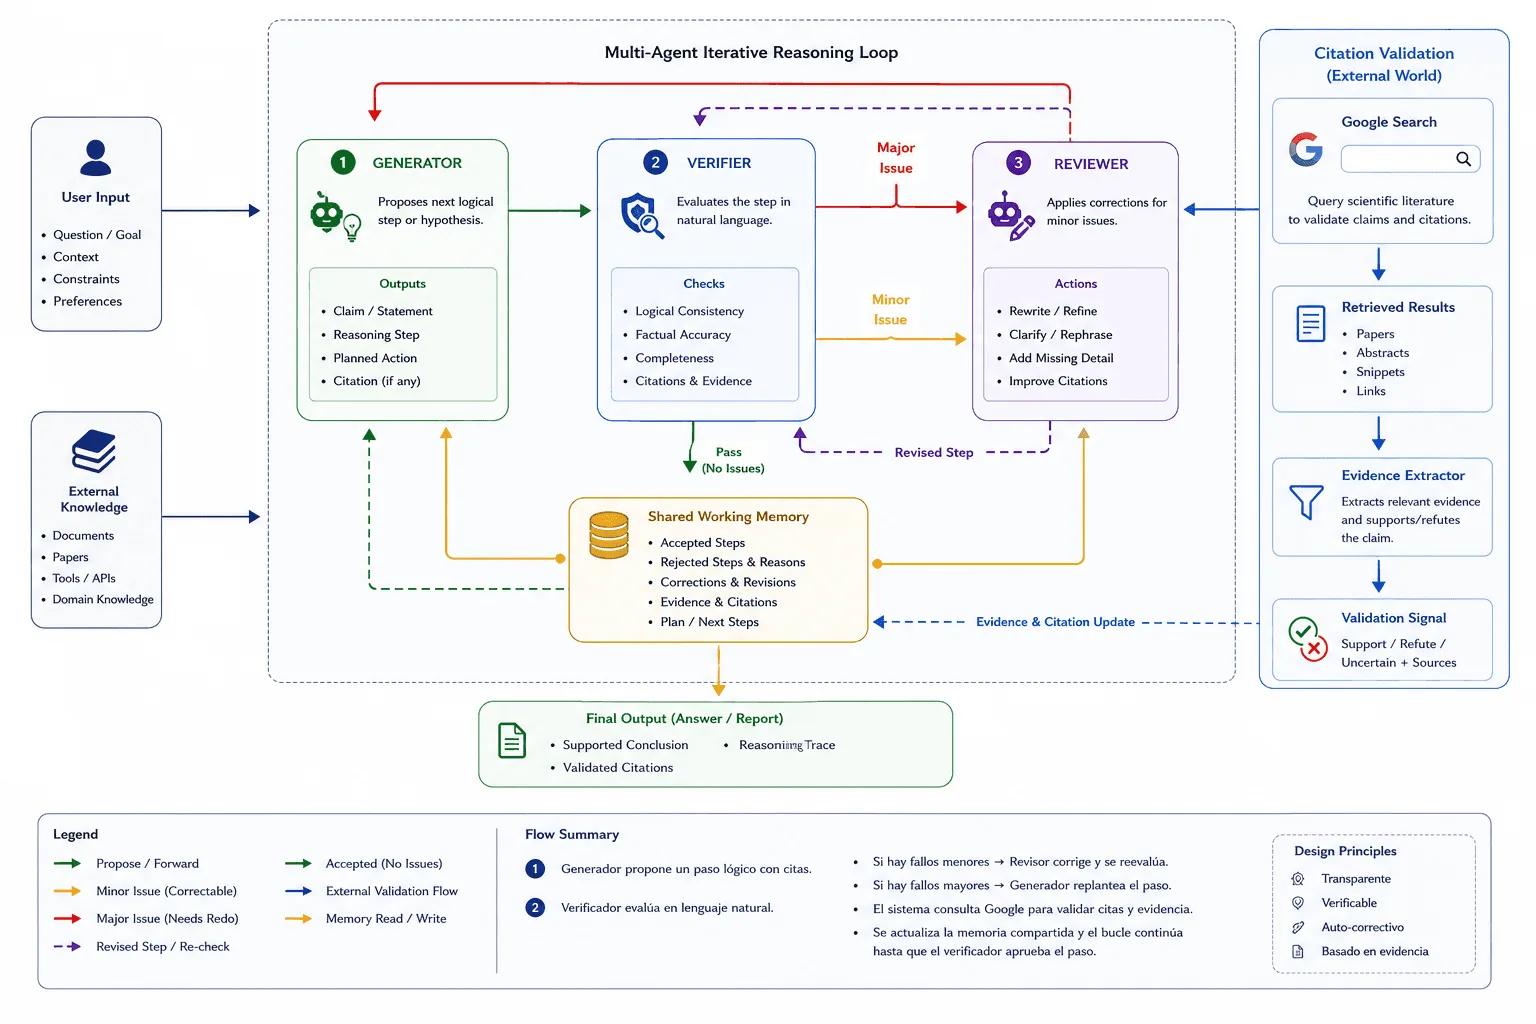
Aletheiaの報告結果は、検証者・修正者ループによって、自然言語による数学的証明システムが、特に難しい証明ベンチマークにおいて、通常の単一パス生成をはるかに超える性能を発揮し得ることを示唆しています。さらに注目すべきは、Aletheiaが本格的な数学研究の成果を生み出し、機械学習アルゴリズムを検証できると説明されている点です。技術的に重要なのはスコアだけではなく、生成し、検証し、修正し、その後に初めて証明を受け入れるというループそのものです。
Anthropic Claude:明文化された憲法とRLAIF
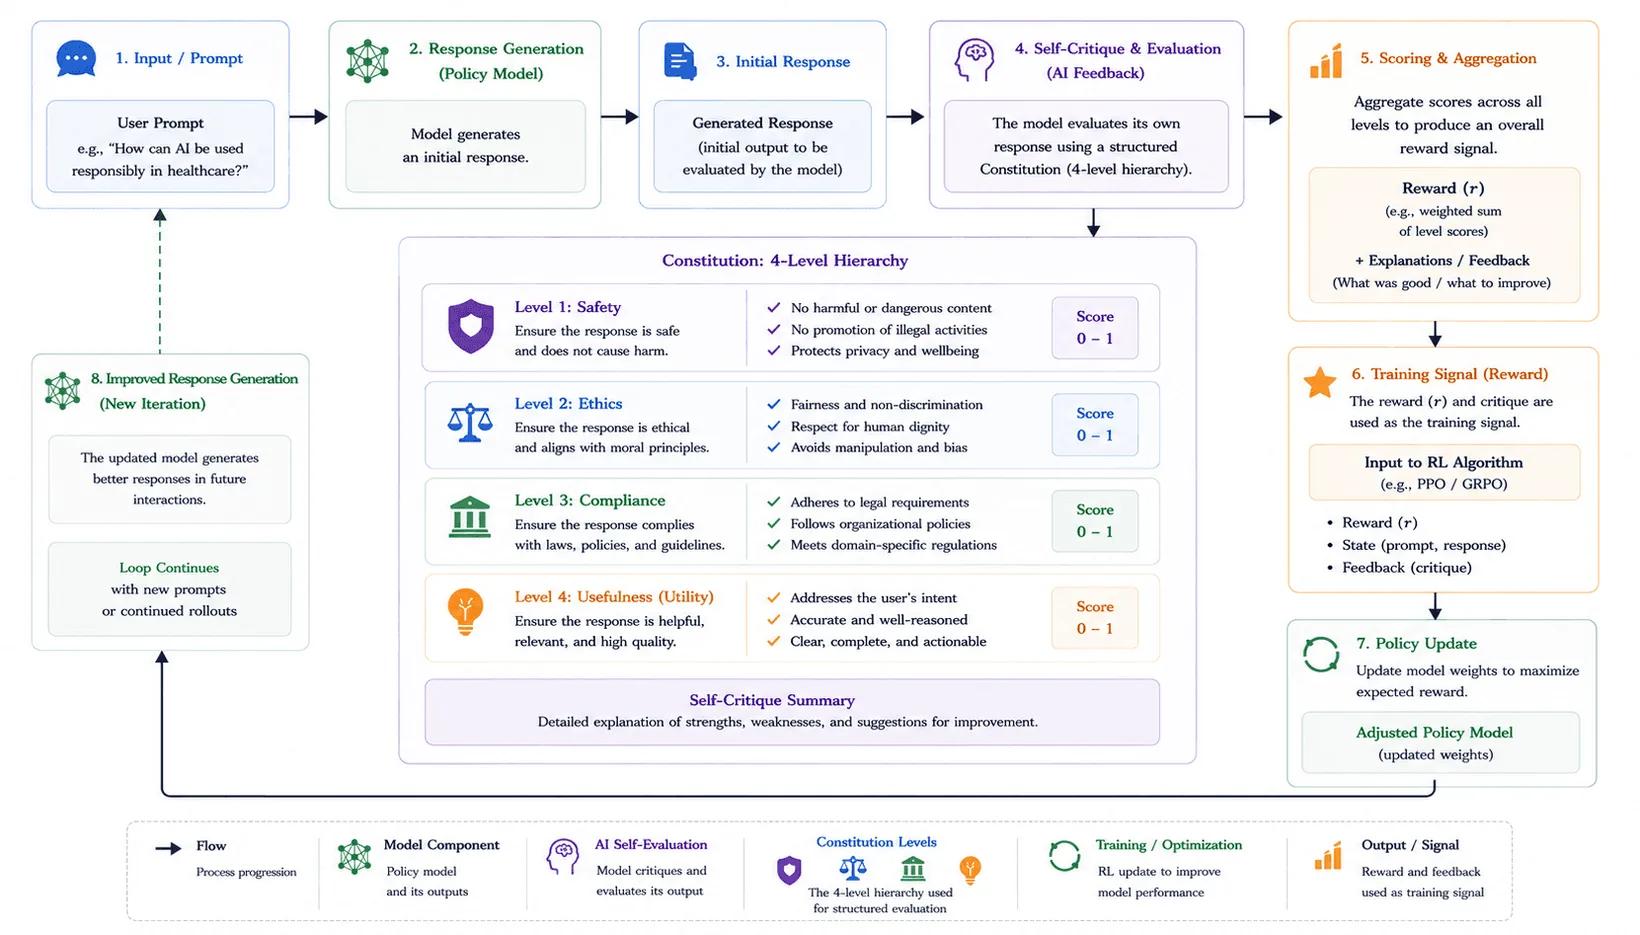
Claude 3.5およびClaude 4におけるAnthropicのアプローチは、Constitutional AI(憲法的AI)を軸としています。どちらの回答が優れているかの判断を何千人もの人間の作業者に頼る方法は、時間がかかり、偏りが生じやすく、有害なコンテンツを扱う際には負担も大きくなります。そこでAnthropicは、明文化されたルール群(「憲法」)に導かれるAIモデルを使っています。
AIフィードバックによる強化学習(RLAIF)と呼ばれるこの手法では、モデルに回答を生成させ、明示的なルール(人権や有用性の原則など)に基づいて自己批評させ、ルールに沿うよう出力を書き直させます。こうして磨き上げられた回答が、モデルの更新に使われます。このルールベースの手法は、従来の人間フィードバックによる手法と同等かそれ以上の成果を上げることが示されています。さらに重要なのは、何か月もかけて人間のデータを集めなくても、モデルの中核的な価値観が透明で、監査しやすく、すばやく更新できるようになる点です。
2026年1月下旬、Anthropicはこのフレームワークの大幅な更新となる「Claude's New Constitution」を公開しました。単純なルールベースのアプローチから、より理由に基づくアラインメント文書へと移行し、安全性、倫理、コンプライアンス、有用性を軸とした優先順位の階層を定めています。この憲法だけでアラインメントの問題が魔法のように解決するわけではありません。その役割は、学習と評価の過程で回答を生成・選別・順位付けする際に用いる批評の枠組みを定義することです。文書を公開したことで、Anthropicは自社のアラインメント哲学を検証・議論しやすいものにもしました。
Moonshot AI Kimi:検証できないタスクへのRLの拡張
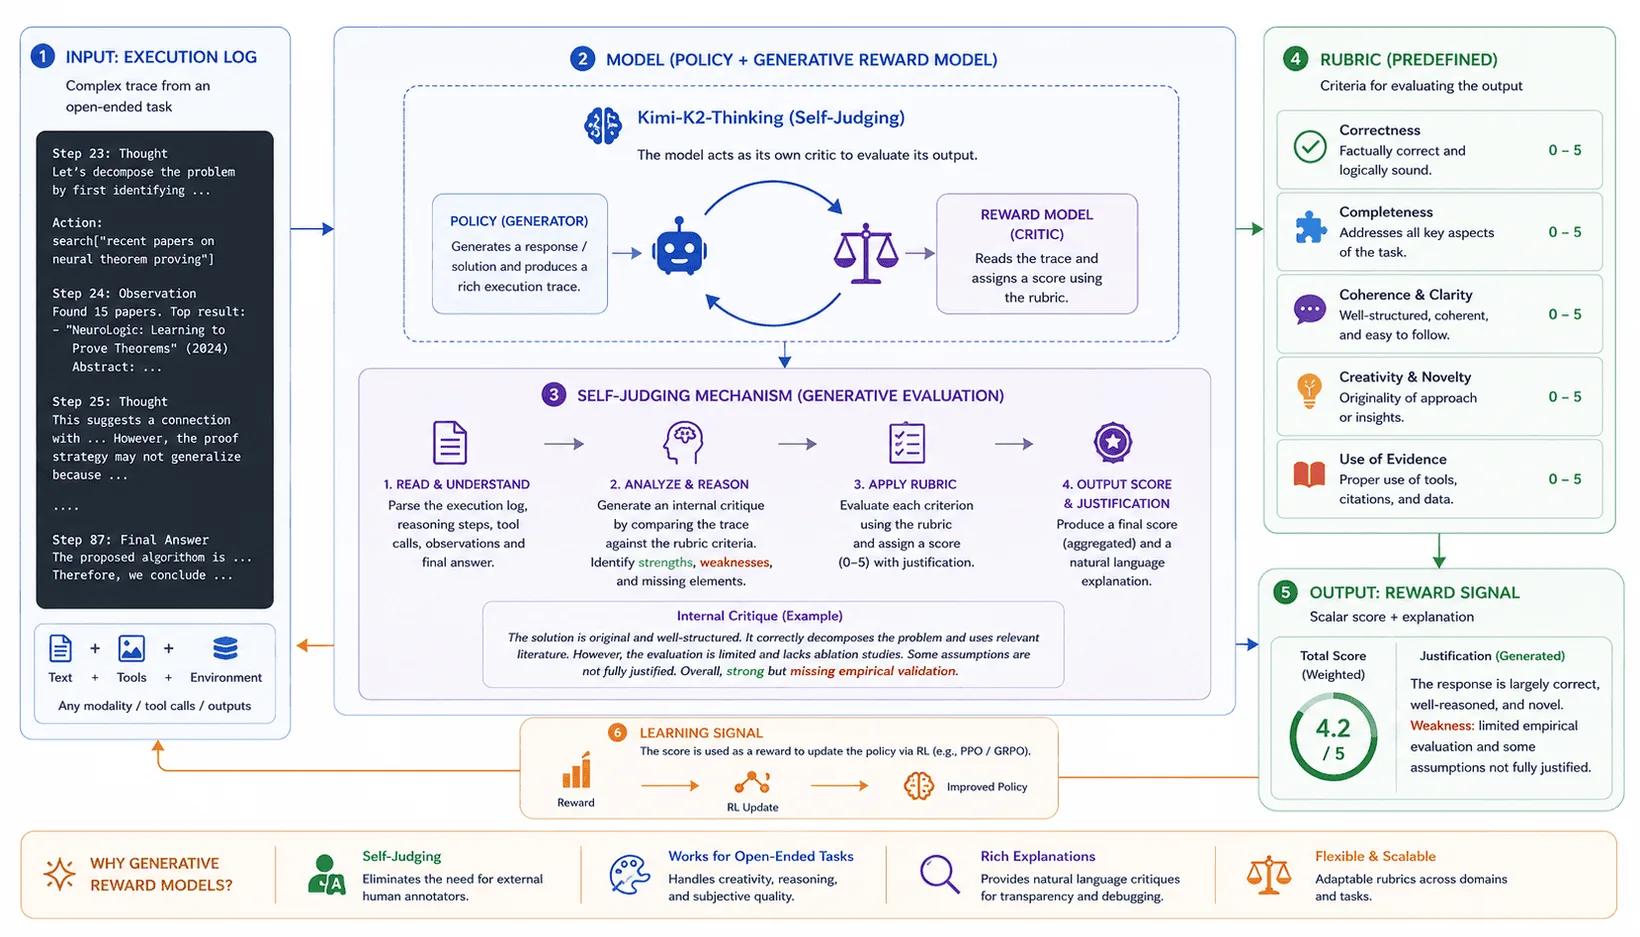
Moonshot AIはKimi k1.5とK2をリリースし、厳密な数学やコーディング以外の領域でRLが達成できることの限界を押し広げました。RLにとって長年の大きな課題は、創作文、検索結果の集約、複雑なレポート作成など、絶対的な「正解」や「不正解」が存在しない、検証できないタスクをどう評価するかでした。Moonshotは、生成型報酬モデル(GRM)を幅広いエージェント的な振る舞いに体系的に導入することで、この課題を解決しました。Kimiは単純なスカラー値のスコアではなく、LLMベースの「ログジャッジ」(例:Kimi-K2-Thinking)を活用します。このジャッジは自己批評のルーブリックを用いて自由形式の生成を評価し、たとえば実行ログがソフトウェアパッチによって障害パターンが解消されたことを証明しているかどうかを判断します。
さらにMoonshot AIは、RLの段階でコンテキストウィンドウを128kトークンまで拡張すると、モデルが自己回帰的な予測を通じて推論空間内で暗黙的な探索を自然に行えるようになることを発見しました。これにより、シンプルながら効果的なRLフレームワークが確立されました。膨大なコンテキストを活用して計画、内省、自己修正ができるため、KimiはMonte Carlo Tree Search(MCTS)や従来のProcess Reward Models(PRM)のような計算負荷の高いアーキテクチャ上の工夫を必要とせずに、数学、コーディング、視覚と言語の推論タスクで高い成果を上げています。
Mistral AI:Magistralと多言語推論
2025年初頭、Mistral AIは同社初のネイティブ推論モデルであるMagistralをリリースし、フロンティア推論の競争に参入しました。オープンソース版(Magistral Small、24Bパラメータ)と、より高性能なエンタープライズ版(Magistral Medium)の両方で提供され、ドメイン特化型かつ多言語の思考の連鎖に重点を置いています。
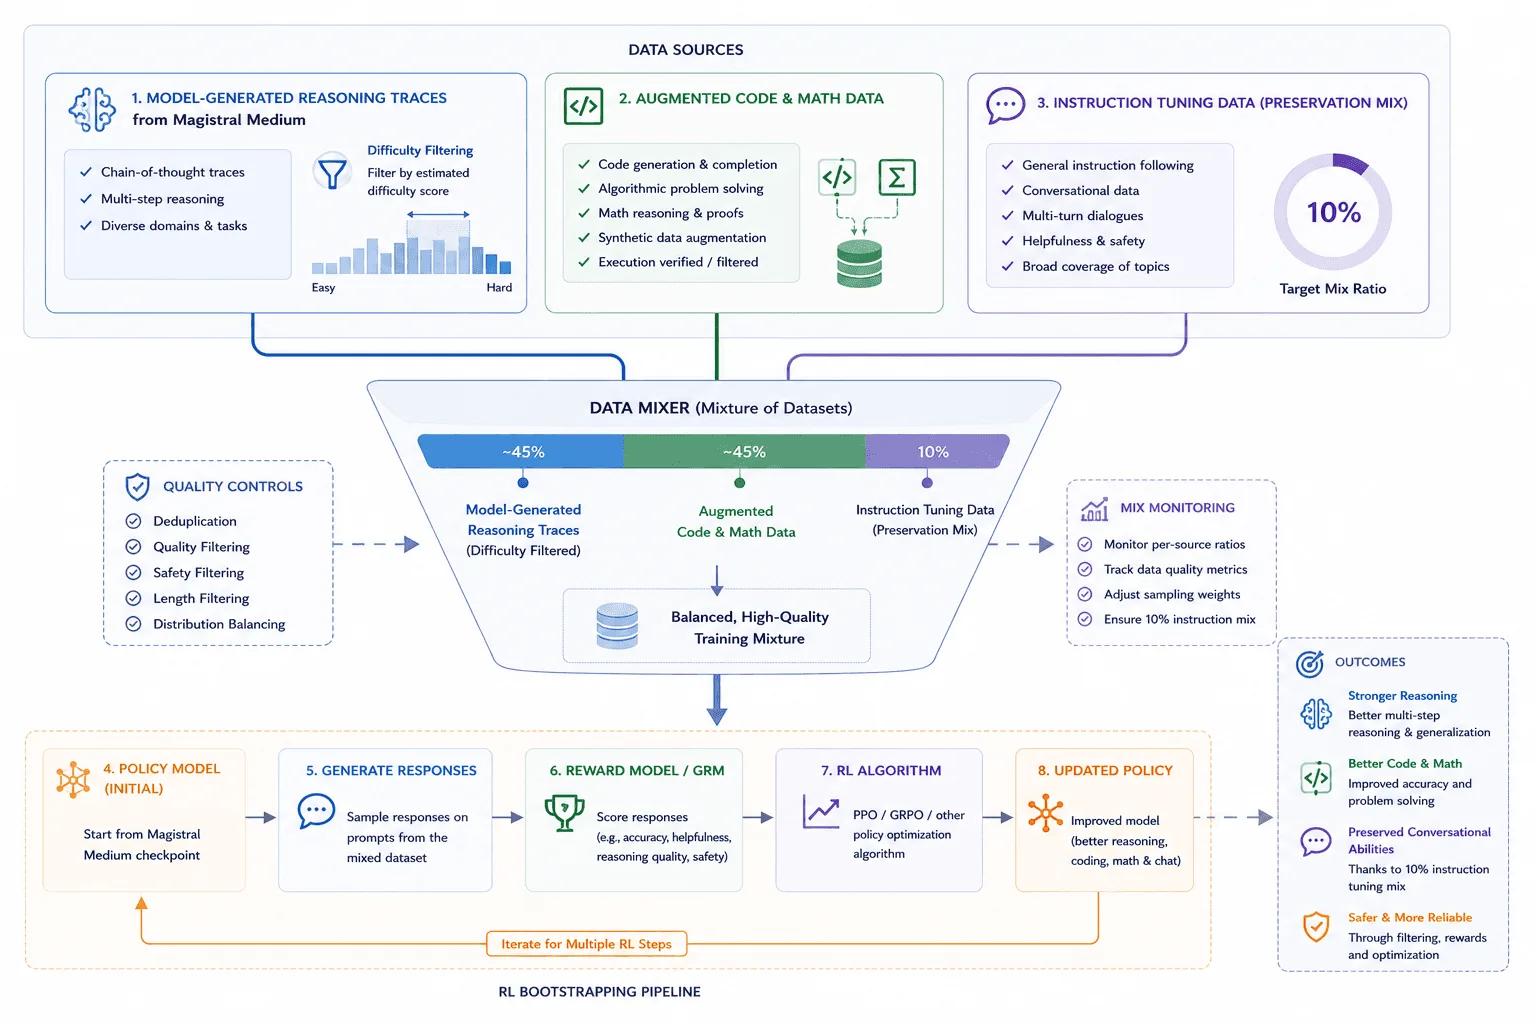
Mistralのアプローチは、より大規模なクローズドモデルからのトレース蒸留に全面的に依存するラボとは対照的です。Magistralは、Mistralのフロンティアモデルファミリーを推論向けに拡張したものとして発表され、その事後学習では強化学習が中心的な役割を担っています。非常に効率的なMagistral Smallを作るために、Mistralは高度なブートストラップ用パイプラインを活用しました。Mediumモデルから推論トレースを生成し、難易度が偏らないようにフィルタリングし、OpenThoughtsとOpenR1のサブセットでデータを拡充し、さらに一般的なインストラクションチューニングのデータを混ぜることで、推論以外の会話スキルが失われないようにしたのです。おそらく最もユニークな特長は、ネイティブな多言語戦略でしょう。このモデルは、推論トレースと最終回答の両方をユーザーが求める言語で生成するよう訓練されており、高度な推論が英語だけのものである必要はないことを示しています。
限界と未解決の課題
現代のRLスタックは強力ですが、推論の問題をきれいに解決するものではありません。第一の限界は報酬ハッキング(reward hacking)です。モデルが本来のタスクを解かずに報酬を満たす方法を見つけると、RLはその近道を強化してしまいます。評価者が決定論的なテストではなく別のモデルである場合、これは特に危険です。
第二の限界は、ベンチマークへの過剰適合です。数学、コーディング、推論のベンチマークは明確なフィードバックを与えてくれるため有用ですが、その明確さゆえに、ベンチマークに合わせた最適化もしやすくなります。モデルはベンチマークのスコアを伸ばしても、混沌とした現実のタスクで同じレベルの堅牢性を得られるとは限りません。
第三の限界は、検証可能な報酬が偏って分布していることです。コード、数学、構造化出力は多くの場合自動で確認できます。一方、自由度の高い研究、長文の執筆、プロダクト計画、科学的探究は、採点がはるかに困難です。こうしたタスクでは、ラボは今もルーブリック、モデルによる評価、人間によるレビュー、あるいは環境からの間接的なシグナルに頼っています。
コストの問題もあります。テスト時計算は、モデルにより積極的なサンプリング、修正、検証を行わせることで精度を高められますが、レイテンシと運用コストが増加します。そのため、最も強力な推論モードをあらゆる場面に展開するのは難しくなります。
最後に、隠れた思考の連鎖は監査上の問題を生みます。多くのフロンティアシステムは、長い内部推論トレースを直接公開せずに使っている可能性があります。これは安全性やユーザー体験の面では好ましい場合もありますが、外部の人がモデルがRLから実際に何を学んだのかを検証するのは難しくなります。
まとめ
OpenAI、DeepMind、Meta、DeepSeek、Mistral、Moonshot、Anthropicの事例は、フロンティアAIの開発が、静的な事前学習だけに頼る段階から、よりインタラクティブな事後学習スタックへと移行したことを示唆しています。検証可能な報酬、オンライン最適化、AIフィードバック、自己蒸留、ツール環境、テスト時計算が、いまやモデルの推論のあり方を共に形づくっています。
モデルはもはやインターネット上のパターンを記憶するだけではありません。最も強力なシステムは、数学の検算、コードのデバッグ、ツールの活用、計画の見直し、中間ステップの検証により多くの計算を費やすよう訓練され、促されています。強化学習はこの変化を支える唯一の要素ではありませんが、生の言語モデルを、探索し、検証し、自らの回答を改善できるシステムへと変える中心的なメカニズムの一つになっています。
参考文献
基礎:RLHF、DPO、AIフィードバック
Ouyang et al., 2022. Training language models to follow instructions with human feedback. SFT -> 報酬モデル -> PPOという古典的なアラインメントのパイプラインを確立したInstructGPTの論文です。
Bai et al., 2022. Constitutional AI: Harmlessness from AI Feedback. RLAIF/Constitutional AIに関するAnthropicの最初の論文です。
Rafailov et al., 2023. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. DPOの中核となる論文で、報酬モデルを明示的に学習しないオフライン選好最適化を理解するのに役立ちます。
Anthropic, 2023. Claude's Constitution. Claudeの憲法的な批評を導く原則の公開版です。
Anthropic, 2026. Claude's New Constitution. 更新された公開版の憲法で、ルールの列挙から、より広範な理由に基づくアラインメントへの移行を理解するための背景として有用です。
推論のためのRLと検証可能な報酬
OpenAI, 2024. Learning to Reason with LLMs. o1型の推論、RL学習、テスト時計算の考え方に関するOpenAIの一次資料です。
DeepSeek-AI, 2025. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. DeepSeek-R1、DeepSeek-R1-Zero、GRPO、RLVR型の推論学習に関する一次資料です。
Yue et al., 2025. Stable Reinforcement Learning for Efficient Reasoning. GRPO-$\lambda$を提案し、推論RLにおける長さペナルティの安定化について論じています。
Moonshot AI, 2025. Kimi k1.5: Scaling Reinforcement Learning with LLMs. Kimiの長文脈RLとスケーリング手法に関する一次資料です。
Label Studio, 2025. Reinforcement Learning from Verifiable Rewards. RLVRに関する二次的な解説です。概念をわかりやすく把握するのには役立ちますが、主要な根拠資料としては不十分です。
フロンティアモデルの事例
Meta AI, 2025. The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation. 軽量SFT、オンラインRL、DPOによる仕上げなど、Llama 4の事後学習に関する記述の一次資料です。
Mistral AI, 2025. Magistral. Mistralの推論モデルファミリー、多言語推論への注力、RL/事後学習の考え方に関する一次資料です。
Google DeepMind, 2026. Accelerating Mathematical and Scientific Discovery with Gemini Deep Think. Gemini Deep Thinkと科学的推論に関するDeepMindの一次資料です。
Feng et al., 2026. Towards Autonomous Mathematics Research. Gemini Deep Think上に構築された数学研究エージェントとしてAletheiaを紹介する研究論文です。
Feng et al., 2026. Aletheia tackles FirstProof autonomously. FirstProofチャレンジにおけるAletheiaの追加評価です。
Tehrani et al., 2026. Fine-Tuning GPT-5 for GPU Kernel Generation. 検証可能な報酬を用いたGPUカーネル生成のためのRLファインチューニングに関するMakoraの論文です。
Makora, 2026. We RL'd GPT-5 to Write Better Kernels. MakoraのGPUカーネル向けRLの取り組みに関連するブログ記事です。
参考になる背景資料と関連文献
Decode the Future, 2024. RLHF explained. 技術的な内容を抑えた入門を求める読者向けの、RLHFのわかりやすい解説です。
Le Wagon, 2025. OpenAI o1 and o3 explained: how thinking models work. 推論モデルの概念に関する二次的な概説です。直感的な理解には役立ちますが、モデルや論文の一次資料と比べると信頼性は劣ります。
