

L’apprentissage par renforcement dans les LLM de pointe : du RLHF aux récompenses vérifiables
 Toni Lopez Co-Founder at Karumi
Entre 2025 et 2026, l’architecture et les méthodes des grands modèles de langage (LLM) ont connu une profonde transformation. Jusque-là, construire un modèle de fondation reposait surtout sur un pré-entraînement massif à partir d’énormes volumes de données brutes, généralement suivi d’une phase d’alignement assez simple combinant fine-tuning supervisé (SFT) et apprentissage par renforcement à partir de retours humains (RLHF). Mais à mesure que les données d’entraînement de qualité disponibles sur Internet se raréfiaient et que le besoin d’une IA dotée de véritables capacités de raisonnement s’affirmait, l’industrie a dû changer d’approche.
Chercheurs comme entreprises technologiques consacrent désormais davantage d’attention et de puissance de calcul au post-entraînement interactif et au « test-time compute » (le fait d’accorder au modèle plus de temps pour traiter l’information et réfléchir avant de répondre). Dans ce nouveau paysage, l’apprentissage par renforcement (RL) n’est plus un simple outil pour ajuster le ton d’un modèle ou filtrer ses mauvaises réponses. Il est devenu l’un des principaux moteurs du post-entraînement, en particulier pour les modèles qui doivent planifier, vérifier leurs étapes intermédiaires, utiliser des outils et améliorer leurs réponses grâce à des chaînes de raisonnement plus longues.
L’état de l’art actuel, façonné par les modèles de pointe d’organisations comme OpenAI, Meta, Google DeepMind, Anthropic, DeepSeek, Moonshot AI et Mistral, révèle une grande diversité dans la manière d’appliquer les algorithmes d’optimisation de politique. L’industrie complète de plus en plus les modèles de récompense neuronaux par des systèmes de récompenses vérifiables, l’optimisation asynchrone des préférences, la critique par des modèles et les retours issus de l’environnement.
Ce rapport analyse la manière dont l’apprentissage par renforcement est appliqué dans les meilleurs modèles actuels.
Le « paradigme classique » : le RLHF avant 2025
Avant le grand tournant de 2025, la méthode de référence pour aligner les LLM s’inspirait largement d’InstructGPT d’OpenAI. Cette approche classique reposait sur l’apprentissage par renforcement à partir de retours humains (RLHF) et suivait un processus strict en trois étapes. D’abord, le modèle passait par un fine-tuning supervisé (SFT) sur des exemples rédigés par des annotateurs humains. Ensuite, un modèle de récompense (RM) distinct était entraîné sur des jeux de données de préférences humaines afin de prédire les réponses que les humains préféraient. Enfin, le modèle SFT était optimisé face à ce modèle de récompense grâce à la Proximal Policy Optimization (PPO), un algorithme qui met à jour la politique en cours d’exécution.
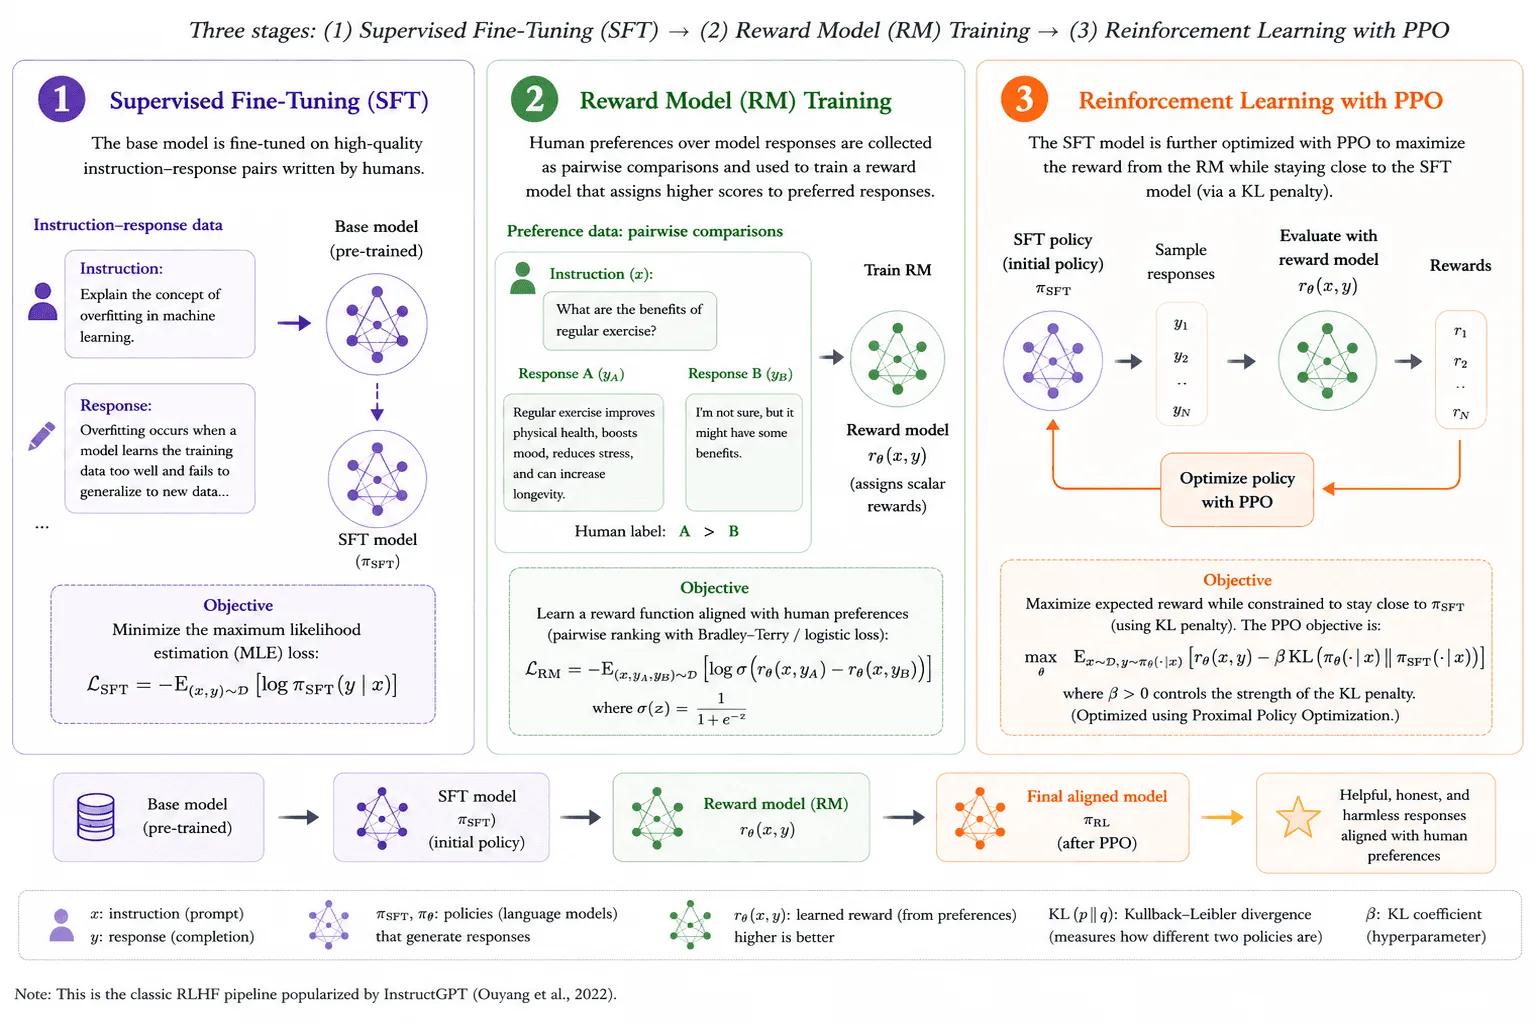
Si cette méthode fonctionnait bien pour ajuster le ton ou suivre des instructions simples, le RLHF classique présentait de sérieuses failles. Il souffrait de l’« alignment tax », un phénomène par lequel optimiser un modèle pour qu’il paraisse poli ou sûr dégradait activement ses capacités de raisonnement et ses compétences académiques. Par ailleurs, la PPO était réputée complexe et gourmande en mémoire, puisque plusieurs modèles (Actor, Critic, Reference et Reward) devaient tourner simultanément.
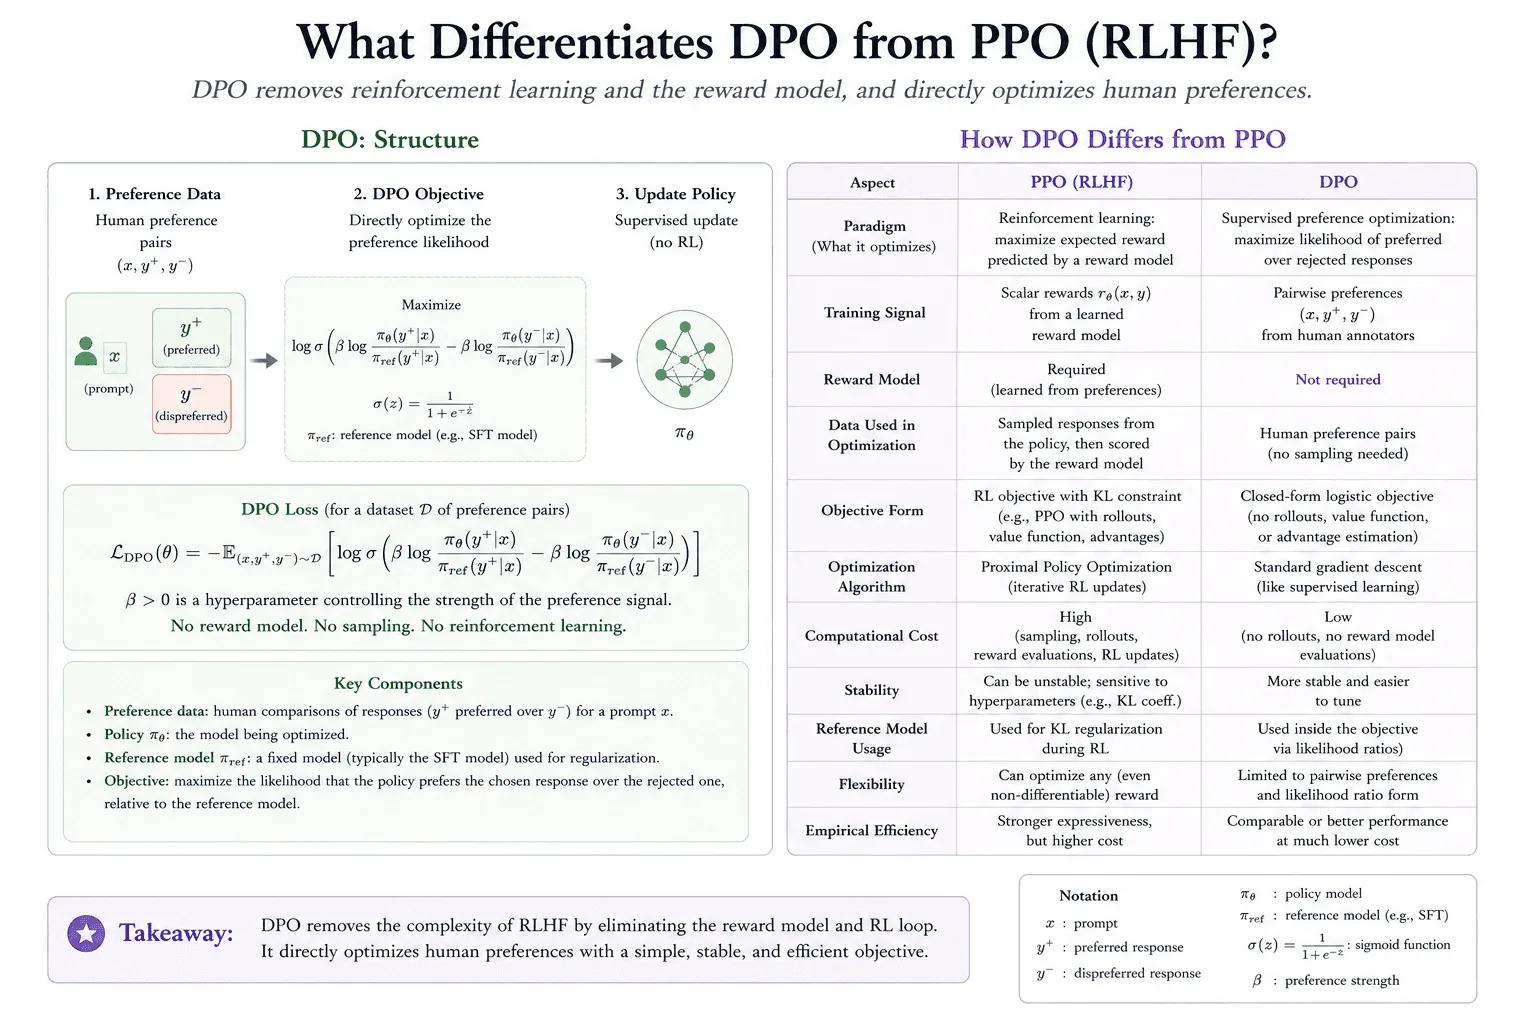
Fin 2023, la Direct Preference Optimization (DPO) a apporté la première grande simplification. La DPO a démontré mathématiquement que l’étape distincte de modélisation de la récompense pouvait être entièrement supprimée, la politique pouvant être optimisée directement à partir de jeux de données de préférences humaines. Toutefois, avant 2025, la DPO restait une méthode strictement « hors ligne ». La PPO comme la DPO dépendaient entièrement de données statiques annotées par des humains, si bien que les modèles ne pouvaient jamais vraiment dépasser les capacités de raisonnement humaines. Pour franchir ce plafond, l’industrie a dû se tourner vers les récompenses vérifiables et les méthodes « en ligne » que l’on connaît aujourd’hui.
De l’alignement sur les préférences aux récompenses vérifiables
Le principal changement dans le post-entraînement des LLM modernes ne tient pas simplement au fait que les entreprises utilisent « plus de RL ». Le changement de fond, c’est que le signal de récompense lui-même s’est diversifié. Les premiers RLHF optimisaient surtout ce que les humains préféraient : clarté, utilité, innocuité et ton conversationnel. C’était utile, mais cela ne donnait pas au modèle de moyen fiable de découvrir des réponses au-delà de ce que les humains pouvaient facilement juger.
Les systèmes de raisonnement modernes combinent plusieurs types de retours. Les récompenses fondées sur les préférences humaines restent importantes pour l’alignement et le style. La Direct Preference Optimization (DPO) simplifie ce processus en apprenant à partir de paires de préférences, sans boucle PPO complète. L’apprentissage par renforcement à partir de retours d’IA (RLAIF) remplace une partie des jugements humains par des critiques rédigées par une IA, souvent guidée par une constitution ou une grille d’évaluation. L’apprentissage par renforcement à partir de récompenses vérifiables (RLVR) va plus loin : il récompense les réponses qui peuvent être contrôlées par des règles, comme des solutions mathématiques, du code qui passe les tests ou des sorties structurées conformes à un format attendu.
On voit aussi émerger une nouvelle catégorie : les récompenses d’environnement. Au lieu de demander à un humain ou à un modèle de récompense si une réponse est bonne, le modèle agit au sein d’un système externe. Un compilateur peut vérifier si le code généré s’exécute. Des tests unitaires peuvent valider un correctif. Un vérificateur de théorèmes, un moteur de recherche, un navigateur ou un environnement d’utilisation d’outils peuvent fournir un retour plus ancré dans le réel qu’une simple étiquette de préférence.
Autre distinction importante : celle entre récompenses de résultat et récompenses de processus. Les récompenses de résultat ne jugent que la réponse finale : la démonstration a-t-elle abouti, le code a-t-il passé les tests, le nombre est-il correct ? Les récompenses de processus cherchent à évaluer les étapes intermédiaires du raisonnement. Les systèmes vérificateur-réviseur sont un moyen pratique d’approcher cette supervision du processus sans exiger que des humains annotent chaque étape à la main.
Cette distinction compte, car le RL à l’entraînement et le test-time compute sont liés sans être identiques. Le RL à l’entraînement modifie les poids du modèle. Le test-time compute donne au modèle un budget d’inférence plus important pour échantillonner, vérifier, réviser ou explorer avant de répondre. Les systèmes de raisonnement de pointe les plus performants combinent généralement les deux : le RL enseigne des comportements de raisonnement utiles, tandis que le calcul supplémentaire à l’inférence leur laisse l’espace nécessaire pour se déployer.
La révolution du raisonnement dans les modèles de pointe (2025-2026)
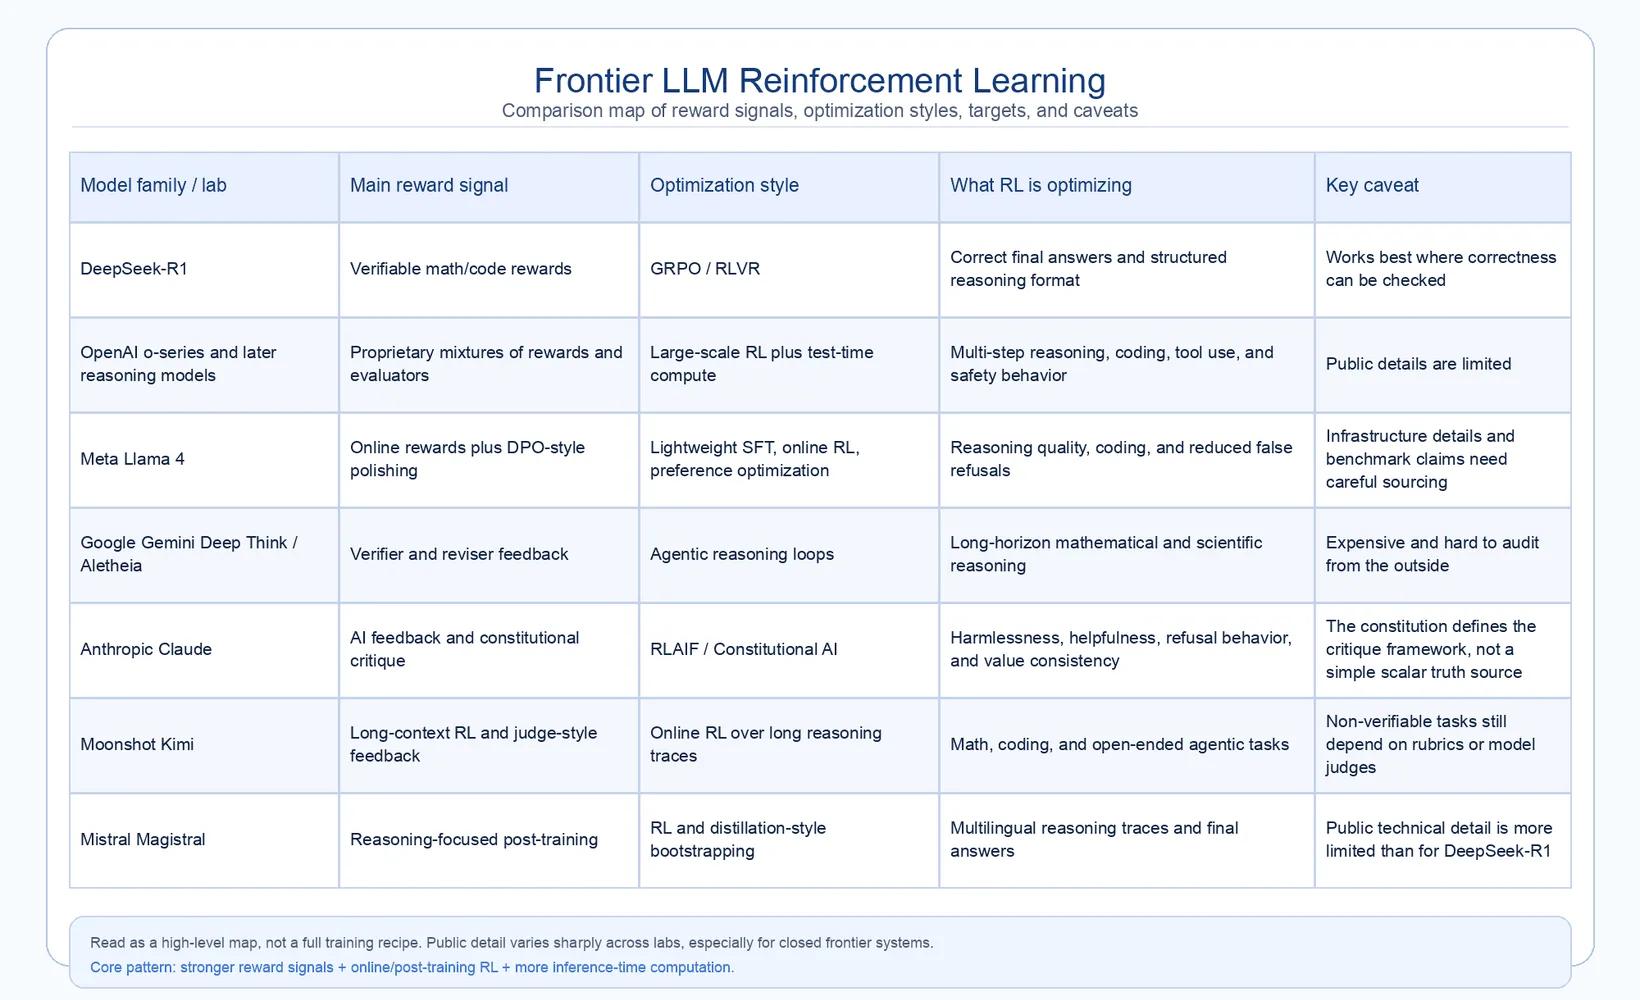
Les travaux récents suggèrent que les grands progrès dans la résolution de problèmes mathématiques complexes, la génération de code et l’analyse logique ne viennent pas simplement de modèles plus grands. Ils reposent aussi sur un post-entraînement plus solide, de meilleurs signaux de récompense et davantage de calcul à l’inférence. Chaque entreprise a abordé à sa manière le même défi fondamental : fournir un retour riche et stable à des modèles de langage gigantesques.
DeepSeek : récompenses vérifiables et GRPO
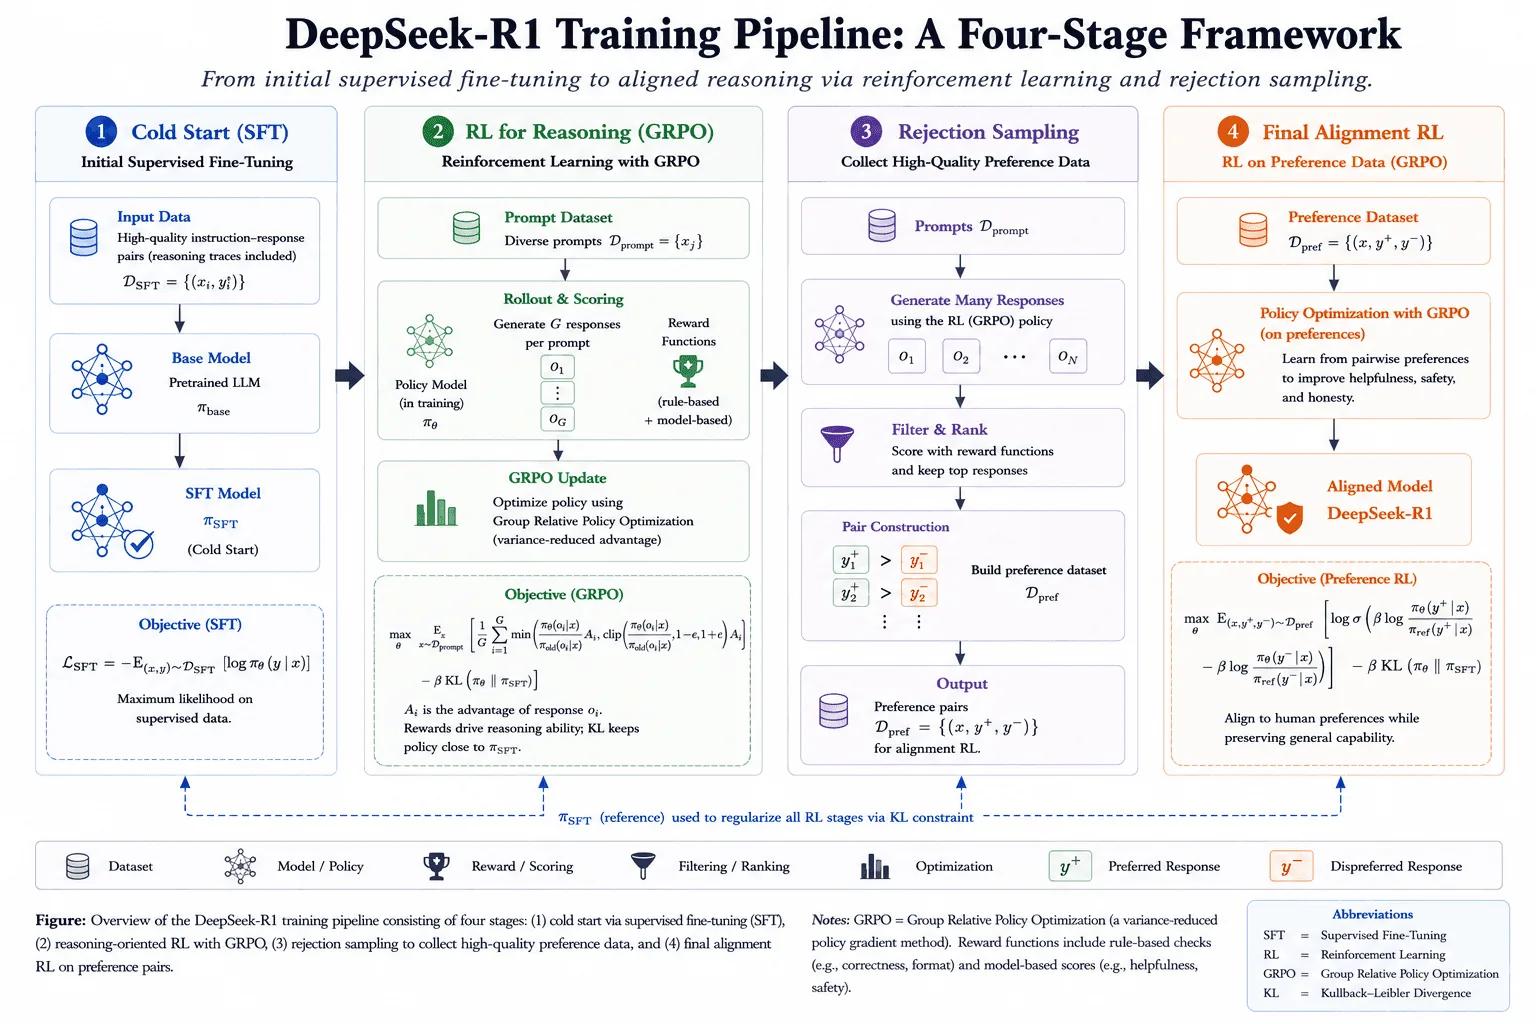
DeepSeek-R1 et son prédécesseur, DeepSeek-R1-Zero, ont largement popularisé le paradigme RLVR. Remettant en cause les méthodes traditionnelles en vigueur depuis InstructGPT, les chercheurs de DeepSeek ont montré avec R1-Zero que des capacités de raisonnement avancées peuvent émerger dans un modèle de base grâce à un apprentissage par renforcement à grande échelle, sans phase initiale de fine-tuning supervisé. En entraînant un modèle de 32 milliards de paramètres (Qwen-32B-Base) sur des dizaines de milliers d’étapes de RL, des comportements de réflexion structurée sont apparus spontanément, même s’ils étaient au départ un peu désordonnés et mélangeaient plusieurs langues.
Le pipeline final de DeepSeek-R1 a ensuite ajouté des données supervisées de démarrage à froid, de l’échantillonnage par rejet et des étapes d’alignement supplémentaires pour rendre le comportement plus lisible, plus stable et plus utile en pratique.
Pour stabiliser cet entraînement et passer à l’échelle jusqu’au modèle final DeepSeek-R1, l’équipe a utilisé un algorithme spécifique appelé Group Relative Policy Optimization (GRPO). Contrairement à l’ancien standard PPO, qui nécessitait un lourd modèle « Critic » pour calculer les scores de référence, GRPO est beaucoup plus léger. Il échantillonne un groupe de réponses différentes pour un même prompt et les note les unes par rapport aux autres.
On obtient ainsi un objectif qui pénalise fortement les mauvaises réponses et récompense les bonnes par rapport à leurs pairs, tout en limitant l’ampleur des mises à jour pour éviter l’oubli catastrophique. Cette efficacité a permis à DeepSeek de rivaliser avec d’immenses modèles propriétaires en n’utilisant qu’une fraction de la puissance de calcul habituelle.
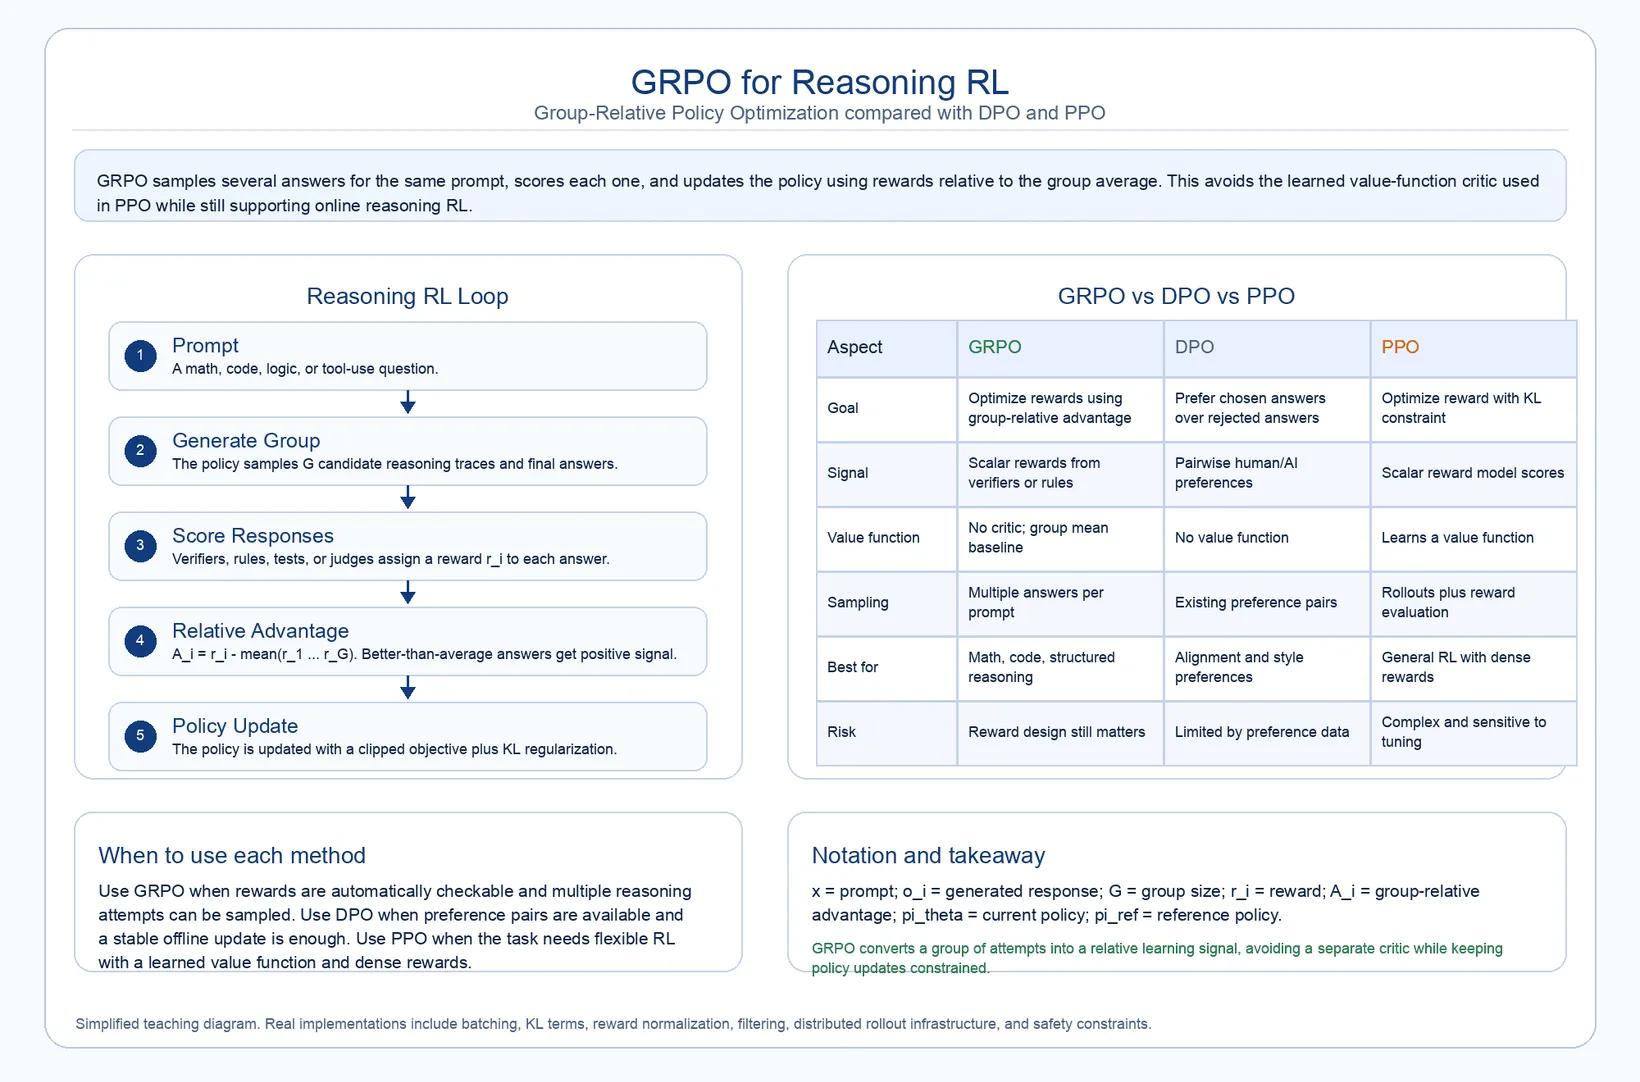
Le succès de GRPO tient en grande partie à l’apprentissage par renforcement à partir de récompenses vérifiables (RLVR). Plutôt que de s’appuyer sur des juges humains ou des modèles de récompense IA (qui peuvent facilement être trompés ou « hackés »), DeepSeek a utilisé des récompenses strictes fondées sur des règles. Les deux principales portent sur l’exactitude et le format. La récompense d’exactitude vérifie que la réponse finale est parfaitement correcte (comme un test unitaire réussi pour du code). La récompense de format oblige le modèle à placer son raisonnement interne dans des balises XML strictes, afin que la chaîne de pensée soit lisible et structurée.
Cette méthode a ensuite évolué vers GRPO-$\lambda$. Les chercheurs ont constaté que pénaliser strictement un modèle pour des réponses trop longues (afin de l’empêcher de réfléchir indéfiniment) provoquait des chutes brutales de précision en début d’entraînement. GRPO-$\lambda$ corrige ce problème en ajustant dynamiquement la pénalité. Si le modèle se trompe, il cesse temporairement de se soucier de la longueur afin de pouvoir chercher librement la solution. Cet ajustement astucieux a amélioré la précision sur des benchmarks exigeants comme AIME 2024 et GSM8K, tout en réduisant, de façon surprenante, la longueur moyenne des réponses de moitié.
OpenAI : raisonnement dynamique, Makora et sécurité
L’écosystème d’OpenAI, avec la série « o » puis ses modèles de raisonnement de pointe, a étendu l’apprentissage par renforcement à des domaines où les modèles doivent raisonner plus longtemps avant de répondre. OpenAI l’utilise non seulement pour la pensée abstraite, mais aussi pour écrire du code destiné aux accélérateurs matériels et renforcer la défense contre les cyberattaques. Le principe des modèles de raisonnement repose sur des lois d’échelle à deux dimensions : la précision d’un modèle peut s’améliorer à mesure que l’on consacre plus de puissance de calcul à l’entraînement RL, et à mesure qu’on lui laisse plus de temps pour raisonner lors des tests (test-time compute).
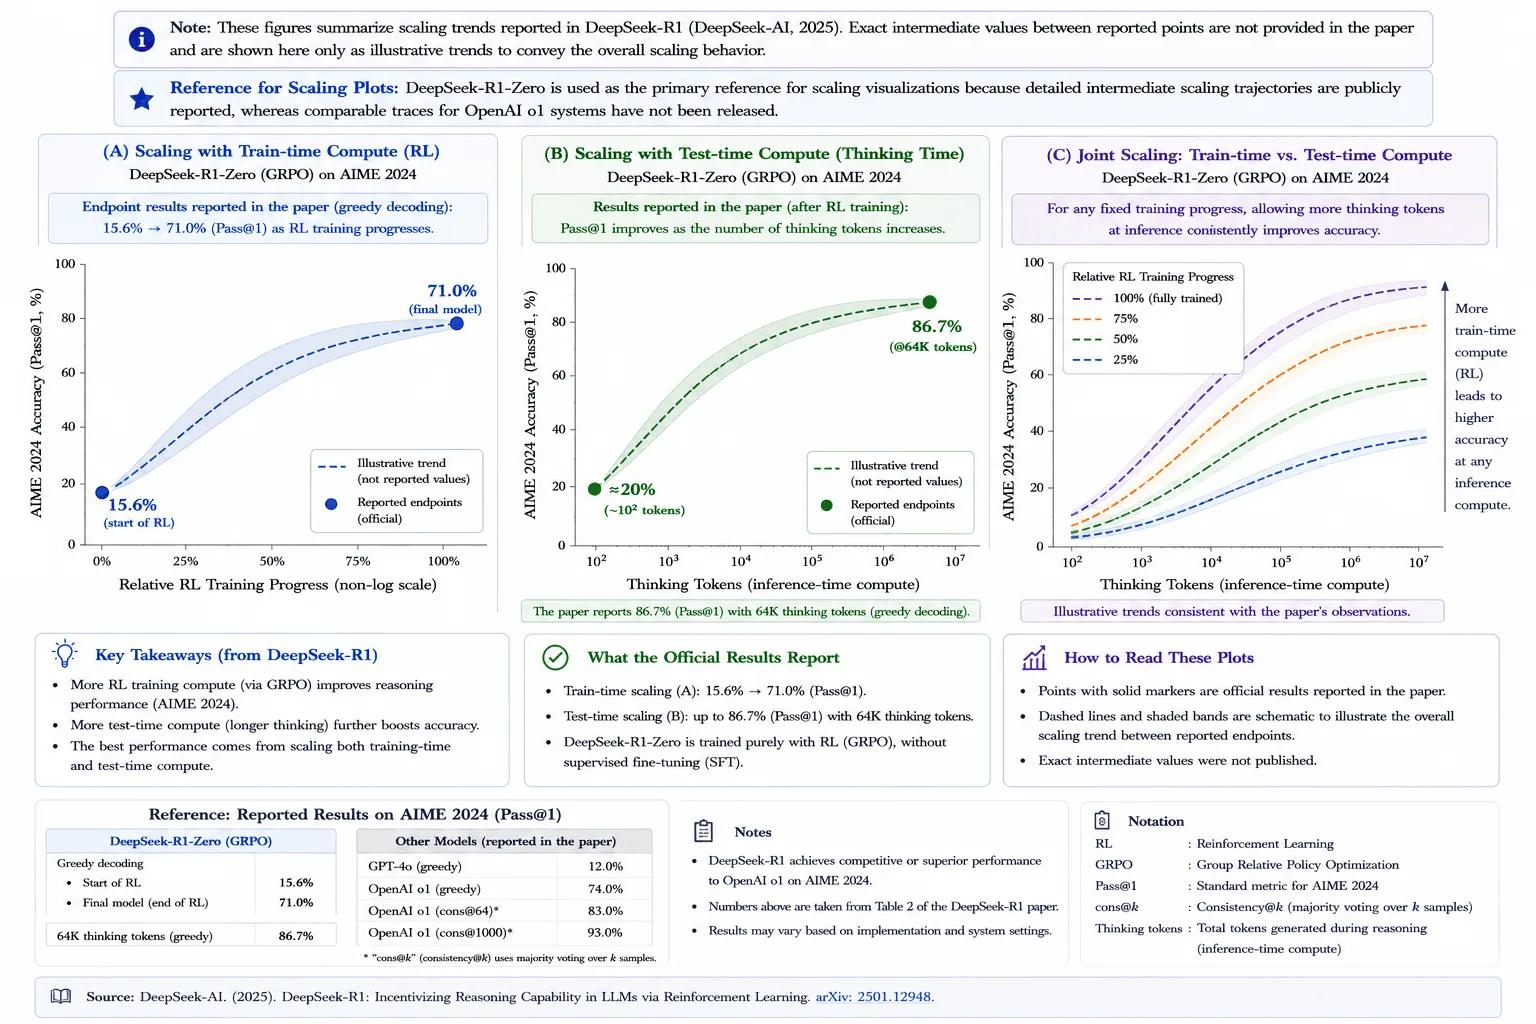
Cette figure utilise les courbes d’échelle de DeepSeek-R1-Zero comme indicateur public de l’idée générale de mise à l’échelle à l’entraînement et à l’inférence. OpenAI a décrit un comportement qualitatif similaire pour ses modèles de raisonnement, mais n’a pas publié de courbes intermédiaires aussi détaillées.
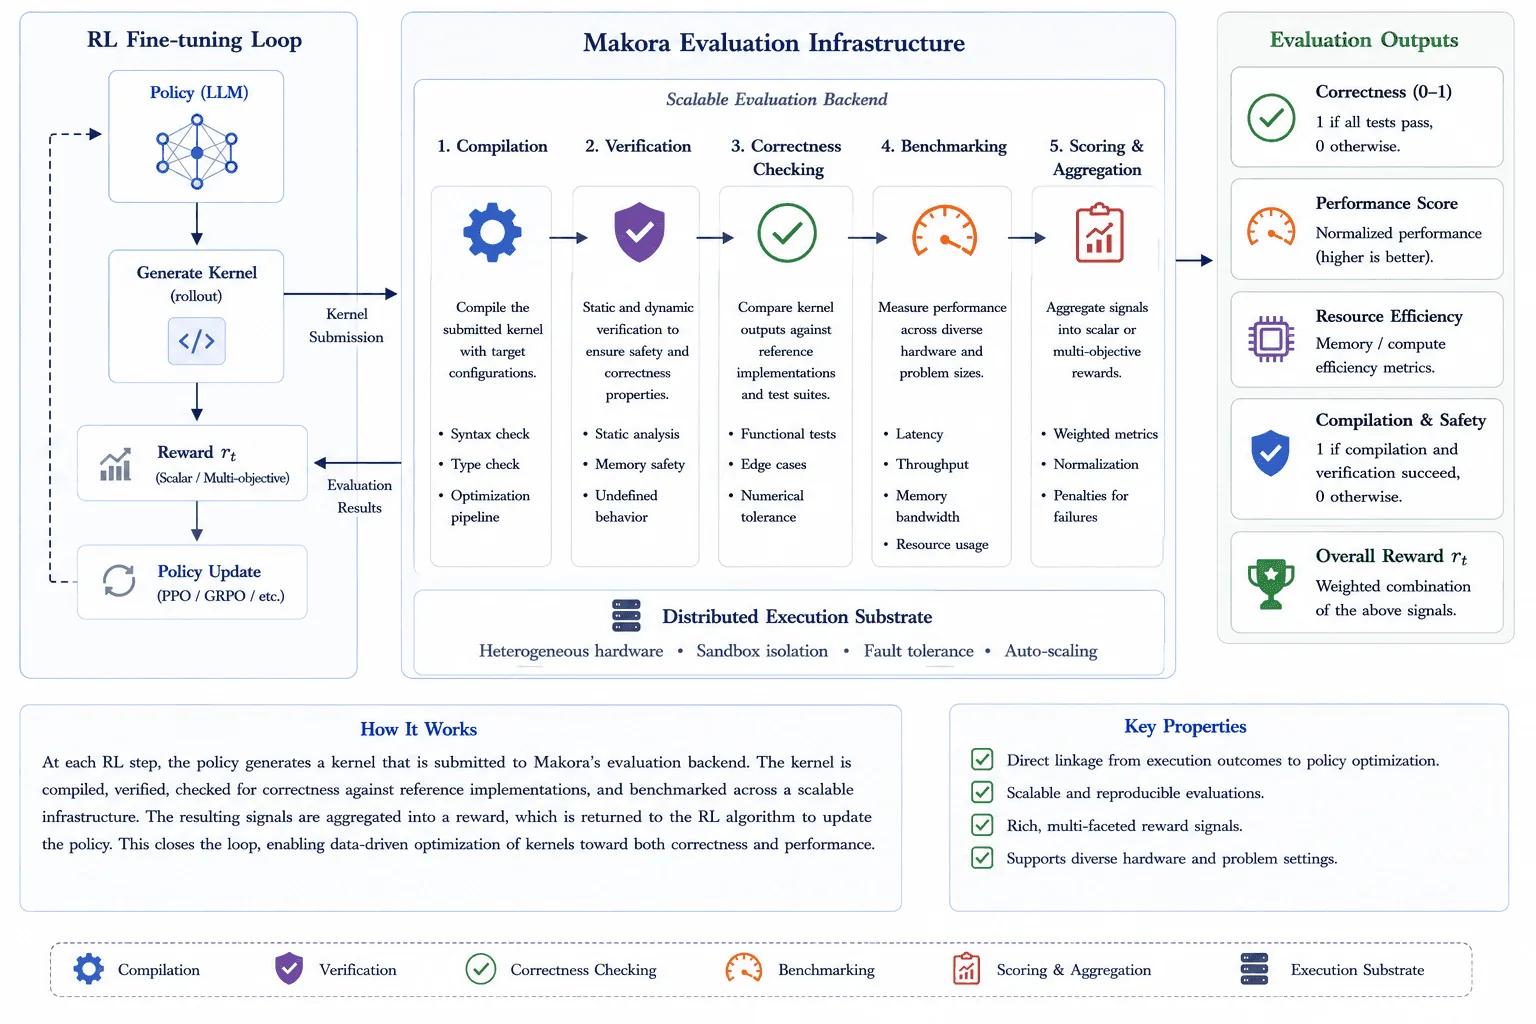
Les résultats publiés montrent pourquoi ce paradigme est devenu si influent. Sur les benchmarks de mathématiques et de sciences, le RL approfondi et le calcul supplémentaire à l’inférence semblent propulser les modèles de raisonnement bien au-delà des modèles conversationnels classiques. Mais l’application la plus intéressante est peut-être l’usage du RL dans des domaines très techniques où les données d’entraînement humaines sont rares, voire inexistantes. Grâce à un système d’évaluation appelé Makora, OpenAI a traité l’écriture de kernels (du code hautement optimisé pour le matériel) comme un pur problème de RL.
Le LLM propose un morceau de code, envoyé à un système backend qui le compile, vérifie qu’il fonctionne et mesure sa vitesse d’exécution. Plus il est rapide, plus la récompense est élevée. La boucle est ainsi bouclée directement entre les performances logicielles réelles et l’apprentissage du modèle. Cette technique a permis au modèle d’écrire du code deux fois plus rapide que les compilateurs standard dans la majorité des tests.
Meta Llama 4 : optimisation asynchrone et DPO allégée
L’approche de Meta avec sa famille Llama 4 (qui comprend Scout 17B, Maverick 17B et le modèle Behemoth 288B) illustre une autre manière de faire passer à l’échelle l’apprentissage par renforcement en ligne pour les modèles open source. Contrairement aux anciens modèles qui s’appuyaient sur d’énormes volumes de données supervisées, le post-entraînement annoncé pour Llama 4 repose sur un pipeline léger et ciblé : un peu de SFT allégé, suivi d’un RL en ligne intensif, puis une finition par Direct Preference Optimization (DPO).
La grande idée technique du post-entraînement de Llama 4 Maverick est son infrastructure RL asynchrone. Habituellement, des algorithmes comme PPO ou GRPO génèrent du texte et mettent à jour le modèle sur le même nœud serveur. Cela crée un goulot d’étranglement, car les GPU d’entraînement peuvent rester inactifs en attendant le calcul des récompenses. Meta explique avoir séparé la charge de travail pour que le calcul des récompenses s’exécute de façon indépendante, masquant ainsi le temps nécessaire à l’évaluation de récompenses complexes comme les tests de code.
Pendant cette phase, Meta met l’accent sur les prompts difficiles. Ensuite, la couche finale de DPO aide à peaufiner le ton et à réduire les cas où le modèle refuse à tort de répondre à une question sans risque. Llama 4 constitue ainsi un bon exemple de pile de post-entraînement hybride : du RL pour les comportements de raisonnement les plus exigeants, puis de l’optimisation des préférences pour le comportement face à l’utilisateur.
Google Gemini Deep Think : recherche autonome et Aletheia
L’écosystème de Google DeepMind, en particulier Gemini Deep Think et les agents de recherche associés, offre l’un des exemples les plus clairs d’apprentissage par renforcement appliqué au raisonnement scientifique à long horizon. Alors que de nombreux modèles optimisent des réponses uniques, les systèmes de type Deep Think organisent le raisonnement autour d’agents autonomes composés de plusieurs parties. L’exemple le plus avancé est l’agent mathématique Aletheia.
Aletheia ne s’appuie pas sur des langages de programmation formels pour démontrer des théorèmes : il fonctionne entièrement en anglais naturel. Il utilise une boucle de renforcement en trois volets : un Generator, un Verifier et un Reviser. Face à un théorème difficile, le modèle rédige des solutions possibles. Si le Verifier repère une petite erreur, il ne jette pas toute la réponse : il la transmet au Reviser pour corriger la logique. La réponse n’est abandonnée qu’en cas d’erreur majeure et irréparable. Aletheia peut aussi utiliser la recherche externe et la consultation de la littérature scientifique pour valider ses affirmations et éviter d’inventer de fausses citations.
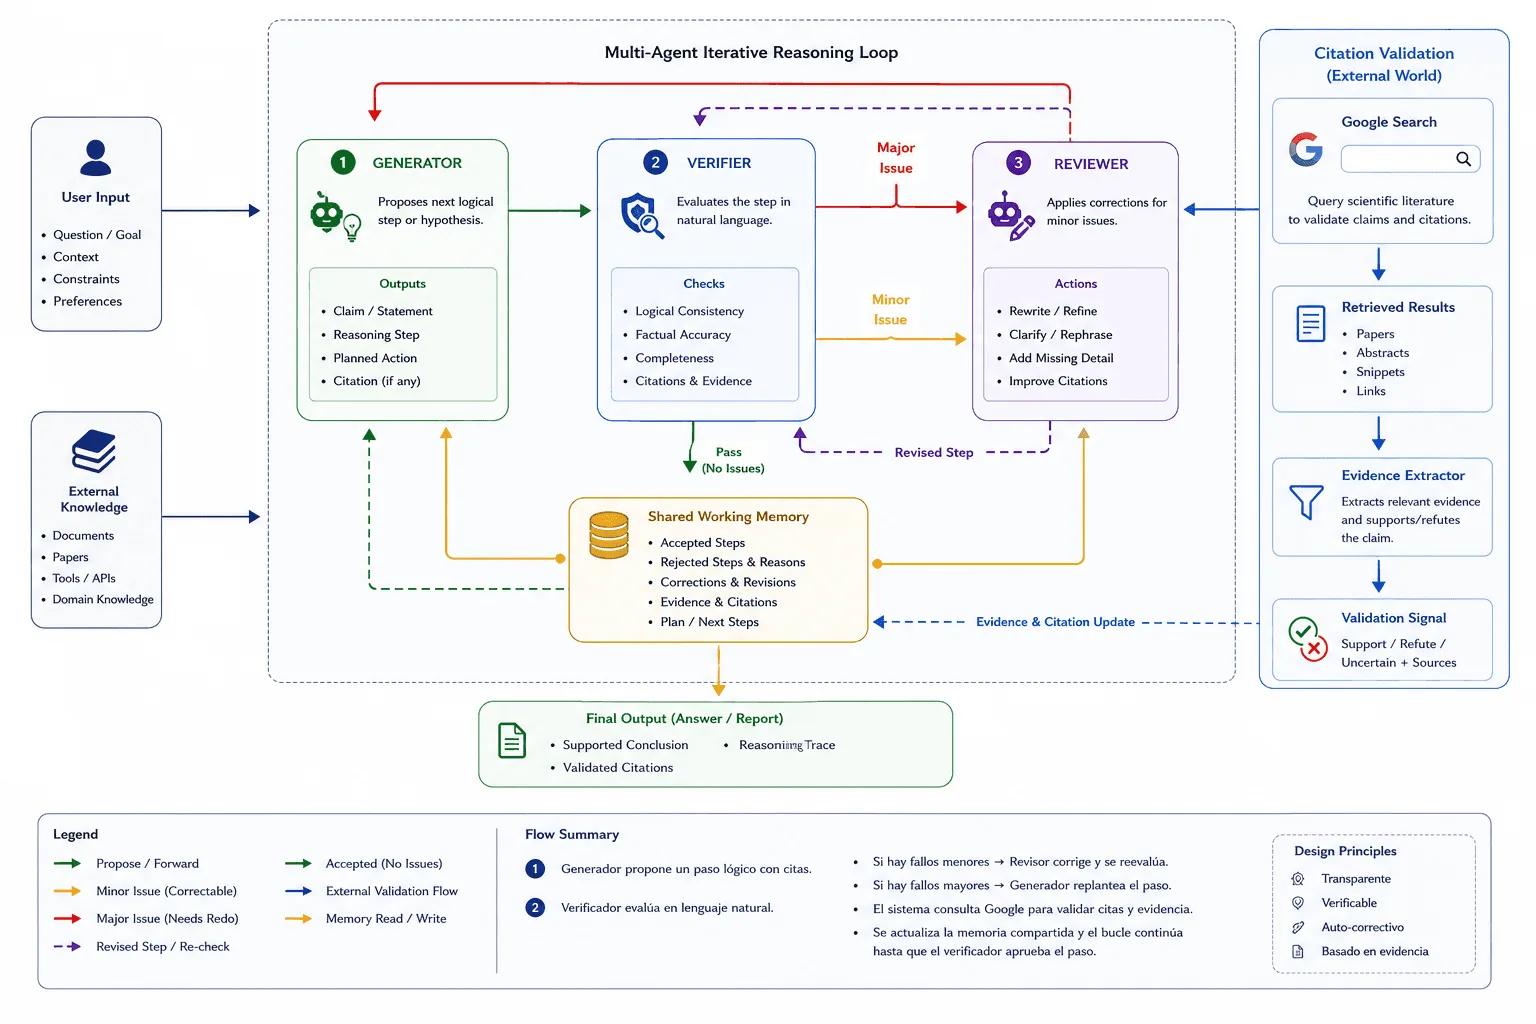
Les résultats publiés pour Aletheia suggèrent que les boucles vérificateur-réviseur peuvent hisser les systèmes de démonstration mathématique en langage naturel bien au-delà de la génération classique en une seule passe, notamment sur les benchmarks de démonstration difficiles. Plus impressionnant encore, Aletheia serait capable de produire des travaux de recherche mathématique substantiels et d’examiner des algorithmes de machine learning. Le point technique essentiel n’est pas seulement le score, mais la boucle : générer, vérifier, réviser, et seulement ensuite accepter la démonstration.
Anthropic Claude : constitutions formelles et RLAIF
L’approche d’Anthropic avec Claude 3.5 et Claude 4 est centrée sur l’IA constitutionnelle (Constitutional AI). Plutôt que de s’appuyer sur des milliers de travailleurs humains pour juger quelle réponse est la meilleure — un processus lent, biaisé et difficile face à des contenus toxiques —, Anthropic utilise un modèle d’IA guidé par un ensemble de règles écrites (une « constitution »).
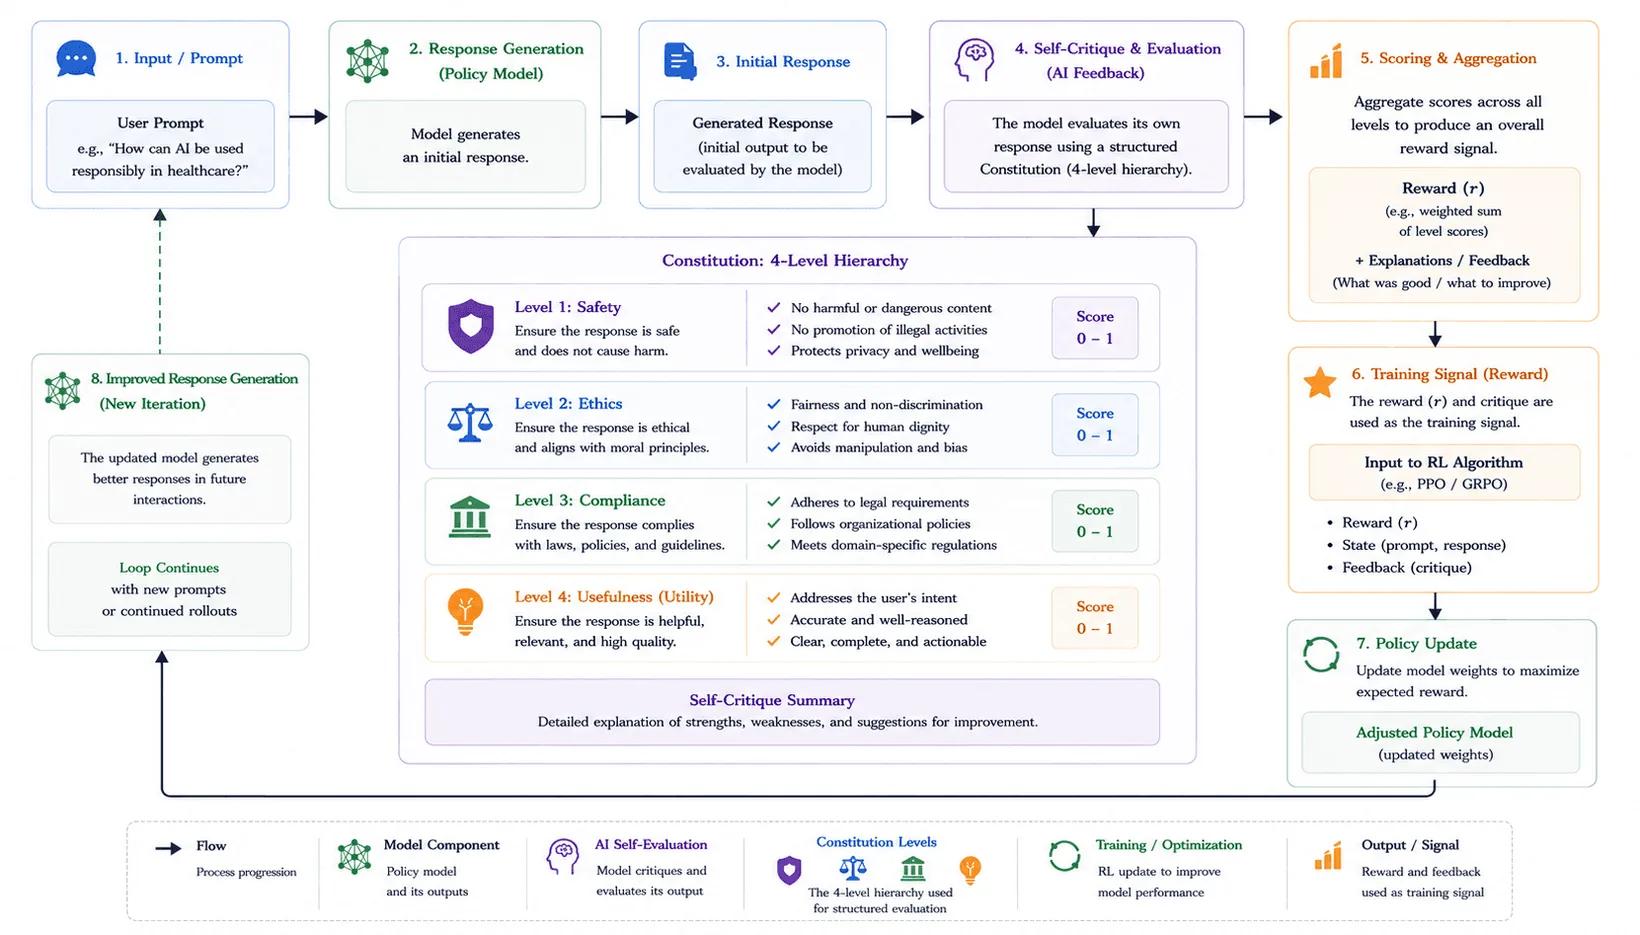
Cette méthode, appelée apprentissage par renforcement à partir de retours d’IA (RLAIF), oblige le modèle à générer une réponse, à se critiquer lui-même selon des règles explicites (comme les droits humains et des principes d’utilité) et à réécrire sa sortie pour s’y conformer. Ces réponses peaufinées servent ensuite à mettre à jour le modèle. Les résultats montrent que cette technique fondée sur des règles égale ou dépasse les méthodes classiques de retours humains. Surtout, elle garantit que les valeurs fondamentales du modèle sont transparentes, faciles à auditer et rapides à mettre à jour, sans passer des mois à collecter des données humaines.
Fin janvier 2026, Anthropic a publié une mise à jour majeure de ce cadre avec « Claude’s New Constitution ». Passant d’une approche fondée sur des règles simples à un document d’alignement davantage fondé sur le raisonnement, elle établit une hiérarchie de priorités autour de la sécurité, de l’éthique, de la conformité et de l’utilité. La constitution ne résout pas l’alignement comme par magie. Son rôle est de définir le cadre de critique utilisé pour générer, filtrer et classer les réponses pendant l’entraînement et l’évaluation. En rendant le document public, Anthropic a aussi rendu sa philosophie d’alignement plus facile à examiner et à débattre.
Moonshot AI Kimi : étendre le RL aux tâches non vérifiables
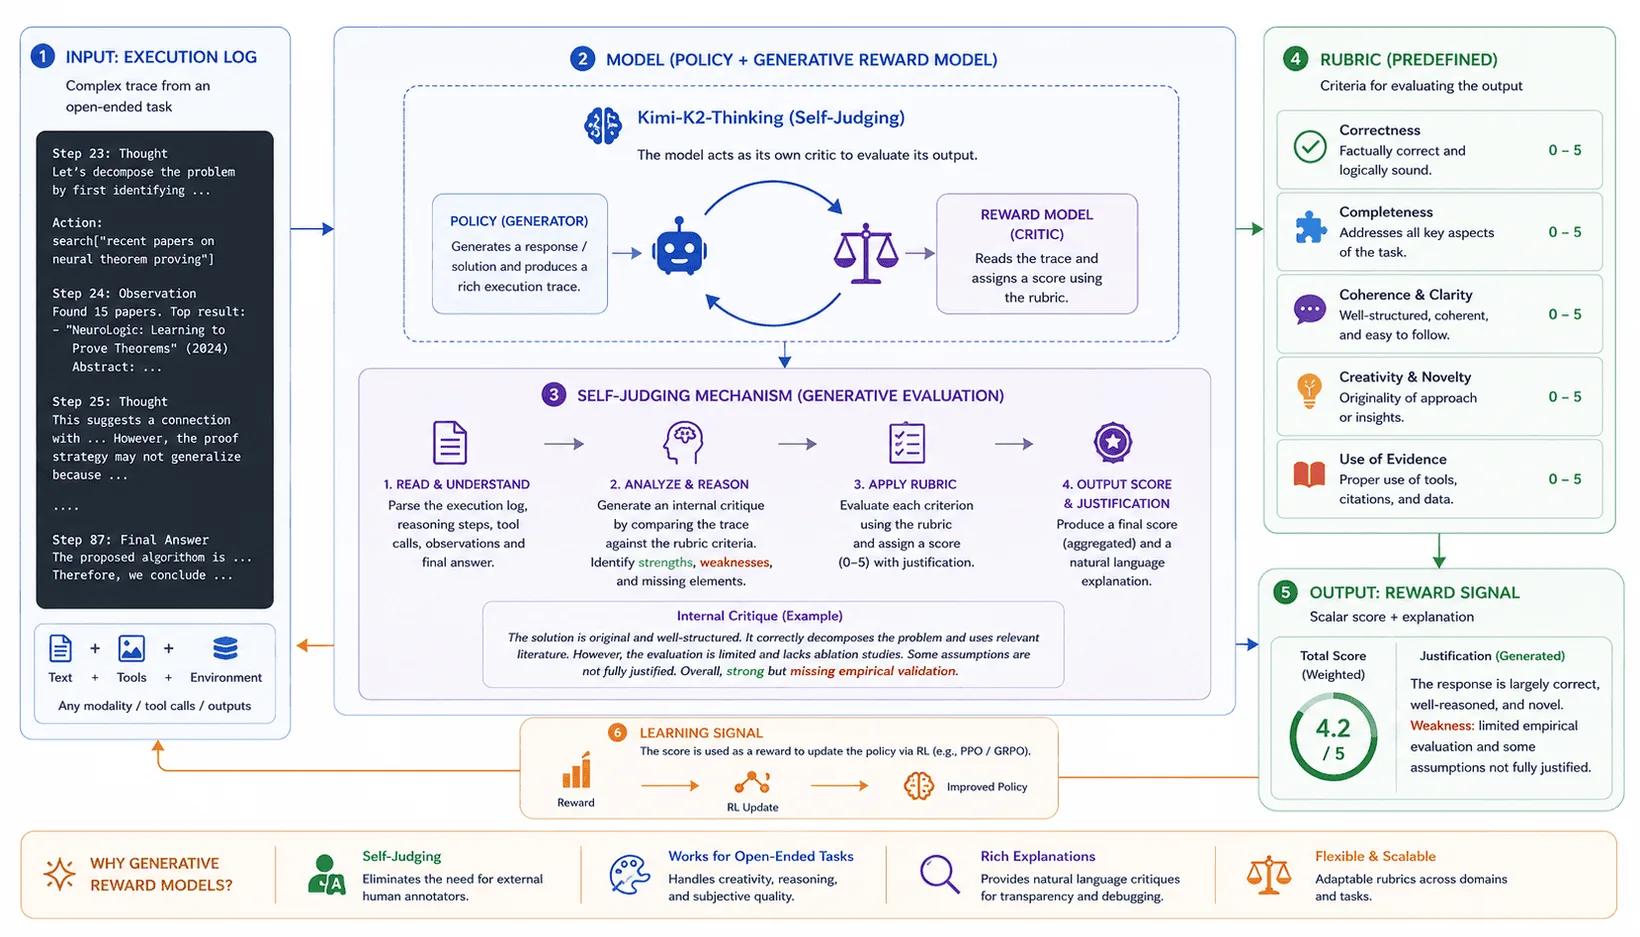
Moonshot AI a lancé Kimi k1.5 et K2, repoussant les limites de ce que le RL peut accomplir en dehors des mathématiques et du code. Historiquement, la principale difficulté du RL a été d’évaluer les tâches non vérifiables, comme l’écriture créative, l’agrégation de recherches ou la génération de rapports complexes, pour lesquelles il n’existe pas de « bonne » ou de « mauvaise » réponse absolue. Moonshot a résolu ce problème en déployant systématiquement des modèles de récompense génératifs (GRM) sur un large éventail de comportements agentiques. Au lieu de simples scores scalaires, Kimi s’appuie sur un « juge de logs » fondé sur un LLM (par exemple Kimi-K2-Thinking) qui utilise une grille d’autocritique pour évaluer la génération ouverte et décider, par exemple, si un journal d’exécution prouve qu’un correctif logiciel a bien éliminé un schéma de défaillance.
Moonshot AI a par ailleurs découvert qu’étendre la fenêtre de contexte à 128k tokens pendant la phase de RL permet naturellement au modèle d’effectuer des recherches implicites dans l’espace de raisonnement via ses prédictions autorégressives. Cela a donné naissance à un cadre de RL simple mais efficace. Comme le modèle peut exploiter un contexte massif pour planifier, réfléchir et se corriger, Kimi obtient de solides résultats en mathématiques, en code et en raisonnement vision-langage, sans recourir à des astuces architecturales coûteuses en calcul comme le Monte Carlo Tree Search (MCTS) ou les Process Reward Models (PRM) traditionnels.
Mistral AI : Magistral et raisonnement multilingue
Début 2025, Mistral AI est entré dans la course au raisonnement de pointe avec Magistral, son premier modèle de raisonnement natif. Disponible en version open source (Magistral Small, 24B paramètres) et en version entreprise plus puissante (Magistral Medium), il met fortement l’accent sur la chaîne de pensée spécialisée par domaine et multilingue.
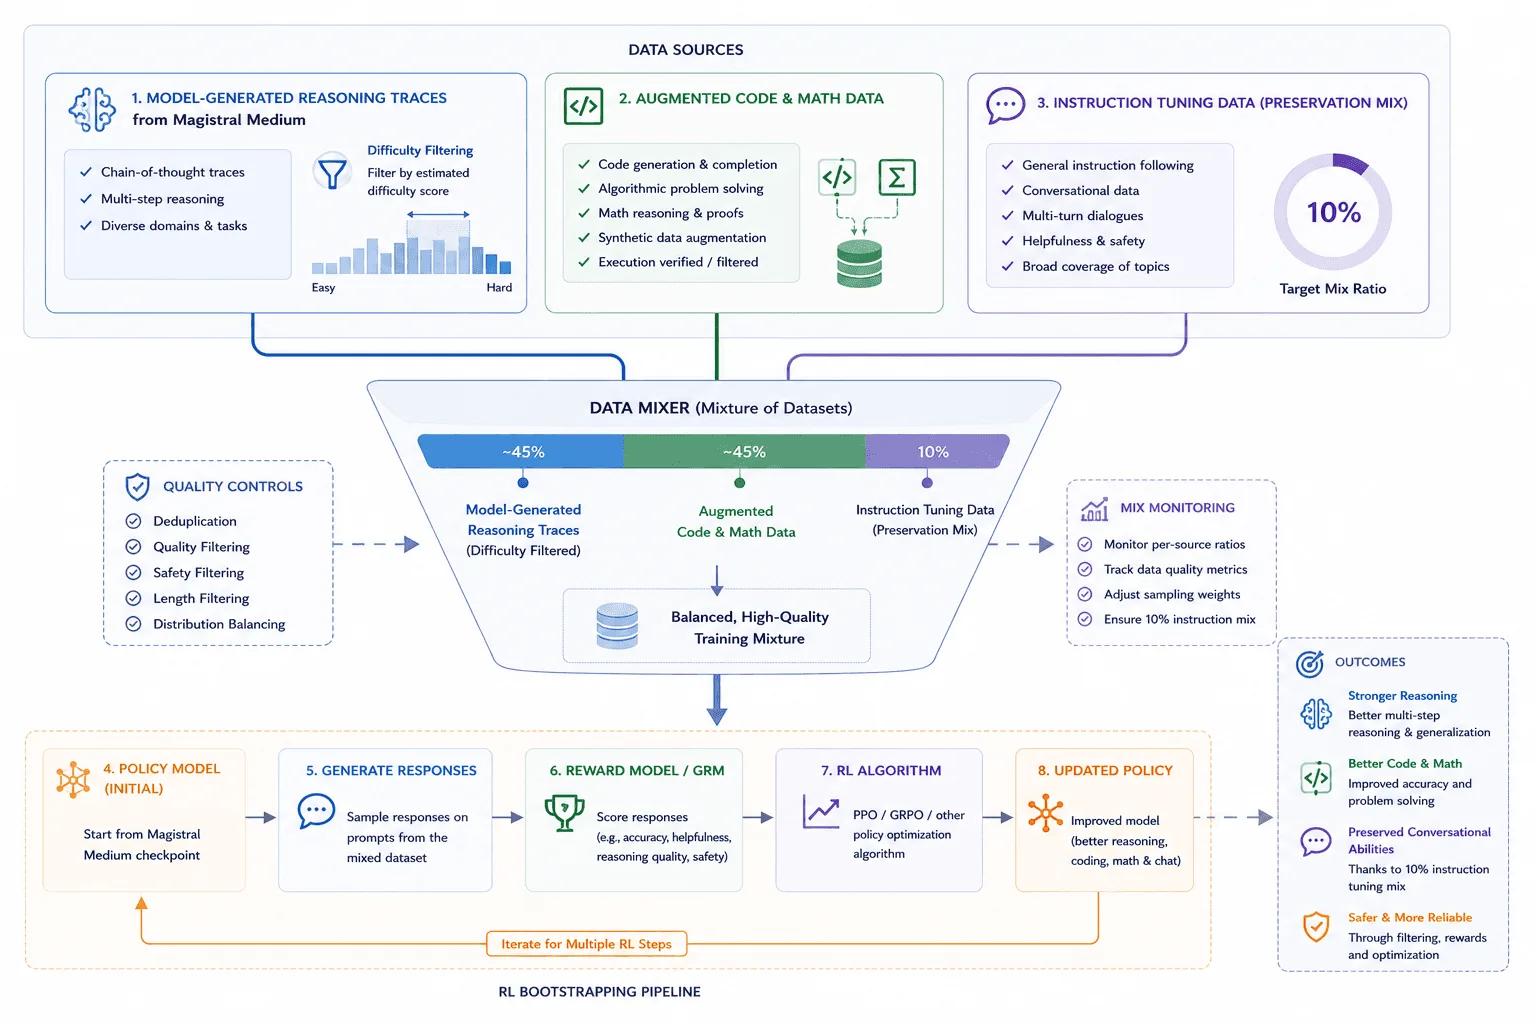
L’approche de Mistral contraste avec celle des laboratoires qui se contentent de distiller les traces de modèles fermés plus grands. Magistral a été présenté comme une extension de la famille de modèles de pointe de Mistral axée sur le raisonnement, l’apprentissage par renforcement jouant un rôle central dans son post-entraînement. Pour créer le très efficace Magistral Small, Mistral a utilisé un pipeline de bootstrapping sophistiqué : génération de traces de raisonnement à partir du modèle Medium, filtrage pour conserver un niveau de difficulté varié, enrichissement des données avec des sous-ensembles d’OpenThoughts et d’OpenR1, et ajout de données générales d’instruction tuning pour que le modèle conserve ses compétences conversationnelles hors raisonnement. Sa caractéristique la plus originale est sans doute sa stratégie multilingue native : le modèle est entraîné à générer à la fois ses traces de raisonnement et ses réponses finales dans la langue demandée par l’utilisateur, preuve qu’un raisonnement avancé n’a pas à se faire exclusivement en anglais.
Limites et questions ouvertes
La pile RL moderne est puissante, mais elle ne résout pas proprement la question du raisonnement. La première limite est le reward hacking. Si un modèle trouve un moyen de satisfaire la récompense sans résoudre la vraie tâche, le RL renforcera ce raccourci. C’est particulièrement dangereux lorsque l’évaluateur est un autre modèle plutôt qu’un test déterministe.
La deuxième limite est le surapprentissage des benchmarks. Les benchmarks de mathématiques, de code et de raisonnement sont utiles parce qu’ils fournissent un retour clair, mais cette même clarté les rend plus faciles à « optimiser ». Un modèle peut progresser sur un benchmark sans gagner autant en robustesse sur des tâches réelles plus désordonnées.
La troisième limite est que les récompenses vérifiables sont inégalement réparties. Le code, les mathématiques et les sorties structurées peuvent souvent être vérifiés automatiquement. La recherche ouverte, la rédaction longue, la planification produit et l’exploration scientifique sont bien plus difficiles à noter. Pour ces tâches, les laboratoires s’appuient encore sur des grilles d’évaluation, des modèles juges, la relecture humaine ou des signaux indirects issus de l’environnement.
Se pose aussi un problème de coût. Le test-time compute peut améliorer la précision en permettant au modèle d’échantillonner, de réviser et de vérifier de façon plus poussée, mais il augmente la latence et le coût de service. Les modes de raisonnement les plus puissants sont donc plus difficiles à déployer partout.
Enfin, la chaîne de pensée cachée pose un problème d’audit. De nombreux systèmes de pointe peuvent utiliser de longues traces de raisonnement internes sans les exposer directement. C’est un avantage pour la sécurité et l’expérience utilisateur, mais il devient plus difficile pour un observateur extérieur d’examiner ce que le modèle a réellement appris grâce au RL.
Conclusion
Les études de cas d’OpenAI, DeepMind, Meta, DeepSeek, Mistral, Moonshot et Anthropic suggèrent que le développement de l’IA de pointe est passé d’un pré-entraînement statique seul à une pile de post-entraînement plus interactive. Récompenses vérifiables, optimisation en ligne, retours d’IA, auto-distillation, environnements d’outils et test-time compute agissent désormais de concert pour façonner la manière dont les modèles raisonnent.
Les modèles ne se contentent plus de mémoriser des schémas issus d’Internet. Les systèmes les plus performants sont entraînés et incités à consacrer davantage de calcul à vérifier des calculs mathématiques, déboguer du code, utiliser des outils, réviser des plans et valider des étapes intermédiaires. L’apprentissage par renforcement n’est pas le seul ingrédient de cette évolution, mais il est devenu l’un des mécanismes centraux qui transforment des modèles de langage bruts en systèmes capables de chercher, de vérifier et d’améliorer leurs propres réponses.
Bibliographie
Fondements : RLHF, DPO et retours d’IA
Ouyang et al., 2022. Training language models to follow instructions with human feedback. L’article InstructGPT, qui a établi le pipeline d’alignement classique SFT -> modèle de récompense -> PPO.
Bai et al., 2022. Constitutional AI: Harmlessness from AI Feedback. L’article fondateur d’Anthropic sur le RLAIF et l’IA constitutionnelle.
Rafailov et al., 2023. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. L’article de référence sur la DPO, utile pour comprendre l’optimisation hors ligne des préférences sans entraînement explicite d’un modèle de récompense.
Anthropic, 2023. Claude's Constitution. Version publique des principes qui guident la critique constitutionnelle de Claude.
Anthropic, 2026. Claude's New Constitution. Constitution publique mise à jour, utile pour comprendre le passage de listes de règles à un alignement plus large fondé sur le raisonnement.
RL de raisonnement et récompenses vérifiables
OpenAI, 2024. Learning to Reason with LLMs. Source primaire d’OpenAI sur le raisonnement de type o1, l’entraînement RL et le test-time compute.
DeepSeek-AI, 2025. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. Source primaire sur DeepSeek-R1, DeepSeek-R1-Zero, GRPO et l’entraînement au raisonnement de type RLVR.
Yue et al., 2025. Stable Reinforcement Learning for Efficient Reasoning. Présente GRPO-$\lambda$ et traite de la stabilisation des pénalités de longueur dans le RL de raisonnement.
Moonshot AI, 2025. Kimi k1.5: Scaling Reinforcement Learning with LLMs. Source primaire sur l’approche de Kimi en matière de RL à long contexte et de mise à l’échelle.
Label Studio, 2025. Reinforcement Learning from Verifiable Rewards. Explication secondaire du RLVR ; utile comme introduction conceptuelle accessible, mais pas comme source de preuves principale.
Études de cas sur les modèles de pointe
Meta AI, 2025. The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation. Source primaire sur le post-entraînement de Llama 4, notamment le SFT allégé, le RL en ligne et la finition de type DPO.
Mistral AI, 2025. Magistral. Source primaire sur la famille de modèles de raisonnement de Mistral, son accent sur le raisonnement multilingue et son approche RL/post-entraînement.
Google DeepMind, 2026. Accelerating Mathematical and Scientific Discovery with Gemini Deep Think. Source primaire de DeepMind sur Gemini Deep Think et ses capacités de raisonnement scientifique.
Feng et al., 2026. Towards Autonomous Mathematics Research. Article de recherche décrivant Aletheia, un agent de recherche mathématique construit sur Gemini Deep Think.
Feng et al., 2026. Aletheia tackles FirstProof autonomously. Évaluation complémentaire d’Aletheia sur le challenge FirstProof.
Tehrani et al., 2026. Fine-Tuning GPT-5 for GPU Kernel Generation. Article de Makora sur le fine-tuning par RL pour la génération de kernels GPU avec récompenses vérifiables.
Makora, 2026. We RL'd GPT-5 to Write Better Kernels. Article de blog accompagnant les travaux de Makora sur le RL appliqué aux kernels GPU.
Contexte utile et lectures complémentaires
Decode the Future, 2024. RLHF explained. Une introduction accessible au RLHF pour les lecteurs qui souhaitent une approche moins technique.
Le Wagon, 2025. OpenAI o1 and o3 explained: how thinking models work. Présentation secondaire des concepts des modèles de raisonnement ; utile pour l’intuition, mais moins solide que les sources primaires (modèles et articles).
