

Aprendizaje por refuerzo en los LLM de frontera: del RLHF a las recompensas verificables
 Toni Lopez Co-Founder at Karumi
La arquitectura y los métodos detrás de los grandes modelos de lenguaje (LLM) vivieron una transformación profunda entre 2025 y 2026. Antes, construir un modelo fundacional significaba depender sobre todo de un preentrenamiento masivo con enormes cantidades de datos en bruto. Después solía venir una fase de alineación básica mediante ajuste fino supervisado (SFT) y aprendizaje por refuerzo a partir de retroalimentación humana (RLHF). Sin embargo, a medida que los datos de entrenamiento de calidad disponibles en internet empezaron a agotarse y creció la necesidad de una IA con verdaderas capacidades de razonamiento, la industria tuvo que cambiar de enfoque.
Tanto los investigadores como las empresas tecnológicas dedican ahora más atención y capacidad de cómputo al post-entrenamiento interactivo y al «test-time compute» (dar a los modelos más tiempo para procesar y pensar antes de responder). En este nuevo panorama, el aprendizaje por refuerzo (RL) ya no es solo una herramienta para ajustar el tono de un modelo o filtrar respuestas malas. Se ha convertido en uno de los motores principales del post-entrenamiento, sobre todo para modelos que necesitan planificar, verificar pasos intermedios, usar herramientas y mejorar sus respuestas mediante trazas de razonamiento más largas.
El estado del arte actual, marcado por los modelos de frontera de organizaciones como OpenAI, Meta, Google DeepMind, Anthropic, DeepSeek, Moonshot AI y Mistral, muestra una enorme variedad en la forma de aplicar los algoritmos de optimización de políticas. La industria complementa cada vez más los modelos de recompensa neuronales con sistemas de recompensas verificables, optimización asíncrona de preferencias, crítica basada en modelos y retroalimentación del entorno.
Este informe analiza cómo se aplica el aprendizaje por refuerzo en los principales modelos actuales.
El «paradigma clásico»: RLHF antes de 2025
Antes del gran cambio de 2025, la forma estándar de alinear los LLM estaba muy influida por InstructGPT de OpenAI. Este enfoque clásico se basaba en el aprendizaje por refuerzo a partir de retroalimentación humana (RLHF) y seguía un proceso estricto de tres pasos. Primero, el modelo pasaba por un ajuste fino supervisado (SFT) con ejemplos redactados por anotadores humanos. Segundo, se entrenaba un modelo de recompensa (RM) independiente con conjuntos de datos de preferencias humanas para predecir qué respuestas gustaban más a las personas. Por último, el modelo SFT se optimizaba frente a ese modelo de recompensa mediante Proximal Policy Optimization (PPO), un algoritmo que actualiza la política mientras se ejecuta.
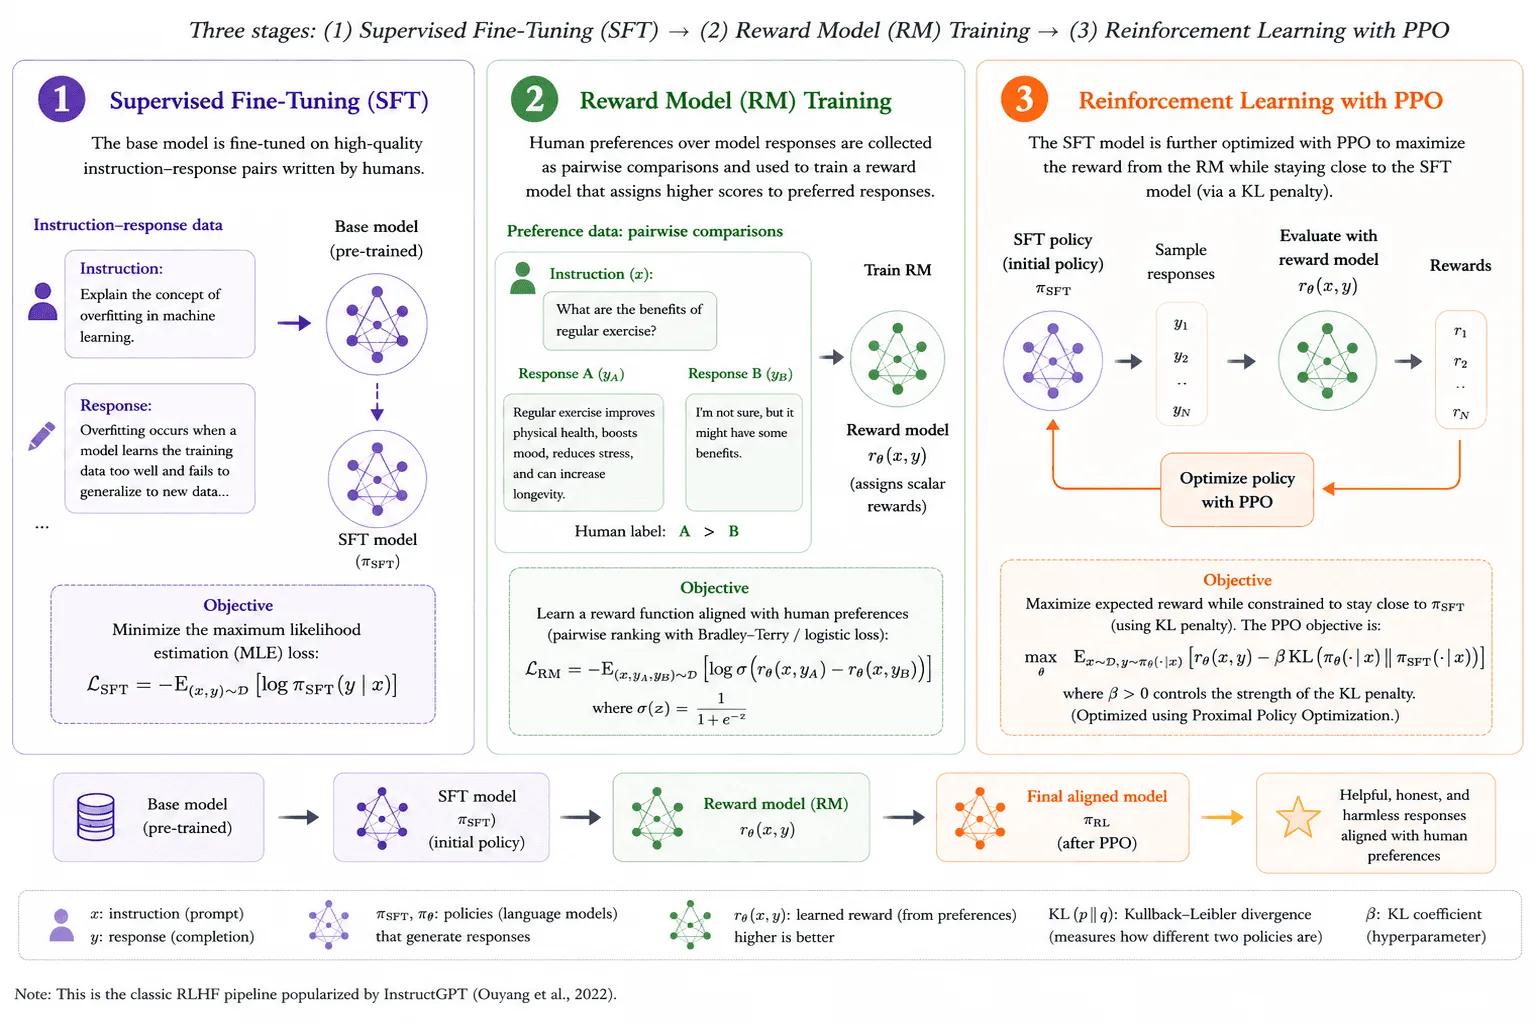
Aunque funcionaba bien para ajustar el tono y seguir instrucciones sencillas, el RLHF clásico tenía fallos importantes. Sufría la llamada «alignment tax», un problema por el que optimizar un modelo para que sonara educado o seguro perjudicaba activamente su capacidad de razonamiento y sus competencias académicas. Además, PPO era famoso por su complejidad y su enorme consumo de memoria, ya que varios modelos (Actor, Critic, Reference y Reward) tenían que ejecutarse a la vez.
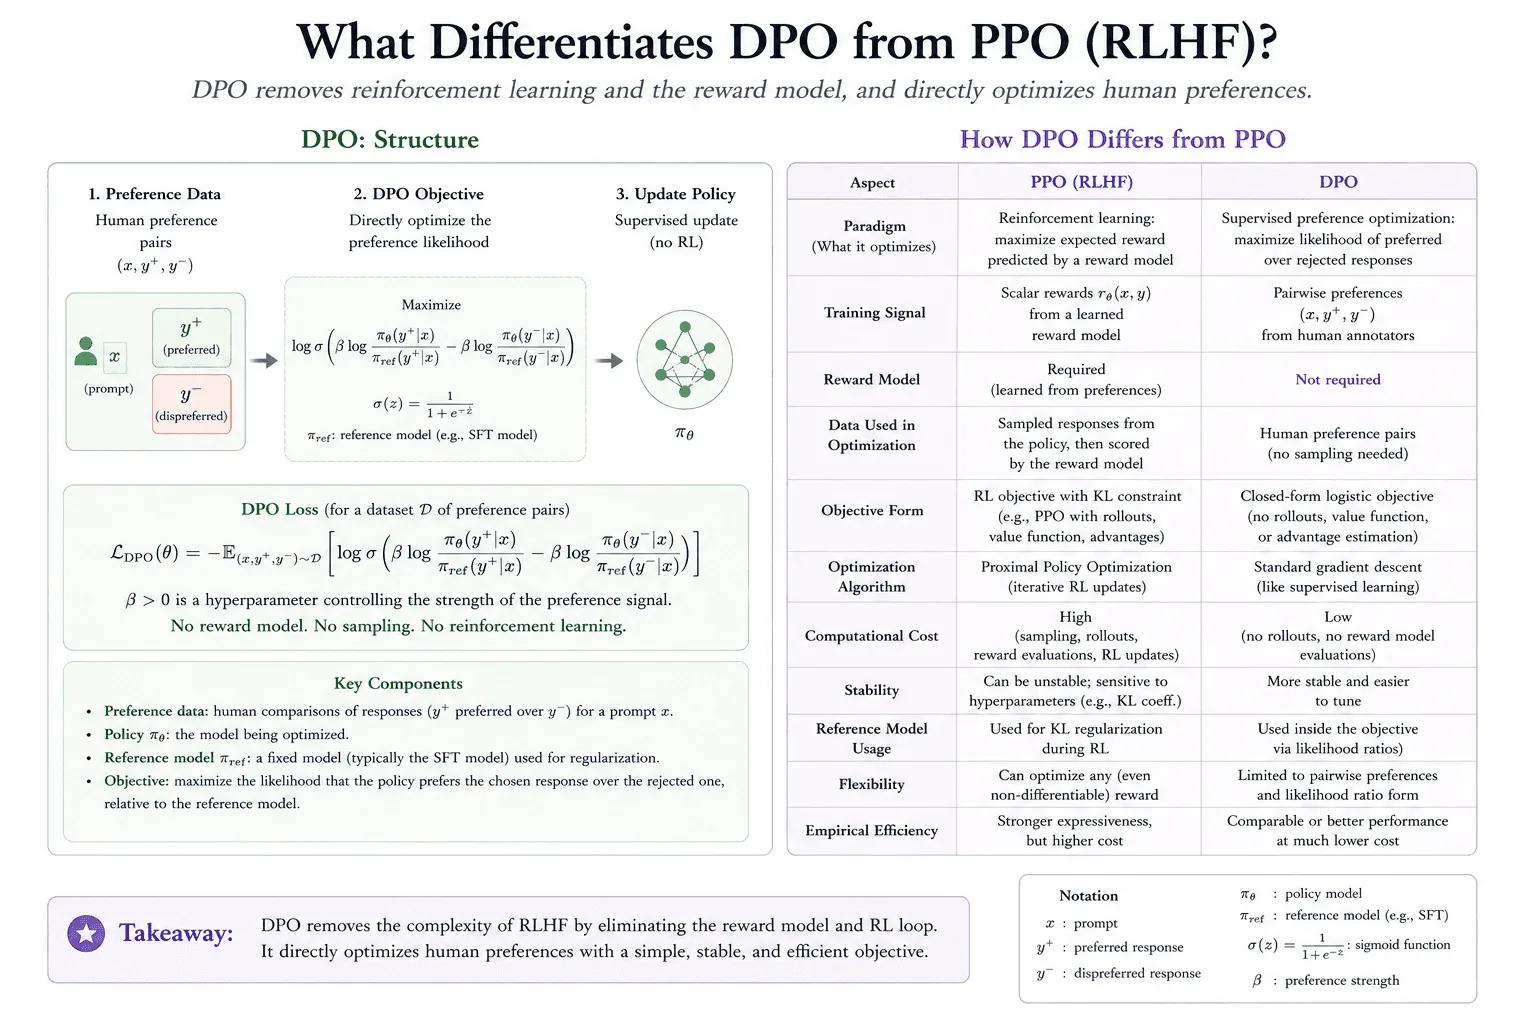
A finales de 2023, Direct Preference Optimization (DPO) introdujo la primera gran simplificación. DPO demostró matemáticamente que el paso independiente de modelado de recompensas podía omitirse por completo, de modo que la política se optimizaba directamente a partir de conjuntos de datos de preferencias humanas. Sin embargo, antes de 2025 DPO era un método estrictamente «offline». Tanto PPO como DPO dependían por completo de datos estáticos anotados por humanos, lo que impedía que los modelos superaran de verdad las capacidades de razonamiento humanas. Para romper ese techo, la industria tuvo que avanzar hacia las recompensas verificables y los métodos «online» que vemos hoy.
De la alineación por preferencias a las recompensas verificables
El mayor cambio en el post-entrenamiento de los LLM modernos no es simplemente que las empresas usen «más RL». El cambio de fondo es que la propia señal de recompensa se ha diversificado. Los primeros RLHF optimizaban sobre todo lo que preferían las personas: claridad, utilidad, inocuidad y tono conversacional. Era útil, pero no le daba al modelo una forma fiable de descubrir respuestas más allá de lo que los humanos podían juzgar con facilidad.
Los sistemas de razonamiento modernos combinan varios tipos de retroalimentación. Las recompensas basadas en preferencias humanas siguen siendo importantes para la alineación y el estilo. Direct Preference Optimization (DPO) simplifica esto aprendiendo de pares de preferencias sin ejecutar un ciclo PPO completo. El aprendizaje por refuerzo a partir de retroalimentación de IA (RLAIF) sustituye parte de los juicios humanos por críticas escritas por una IA, a menudo guiadas por una constitución o una rúbrica. El aprendizaje por refuerzo a partir de recompensas verificables (RLVR) va más allá: recompensa respuestas que pueden comprobarse mediante reglas, como soluciones matemáticas, código que pasa las pruebas o salidas estructuradas que cumplen un formato esperado.
También está creciendo una categoría de recompensas del entorno. En lugar de preguntar a una persona o a un modelo de recompensa si una respuesta es buena, el modelo actúa dentro de un sistema externo. Un compilador puede comprobar si el código generado se ejecuta. Las pruebas unitarias pueden verificar un parche. Un verificador de teoremas, un sistema de búsqueda, un navegador o un entorno de uso de herramientas pueden aportar una retroalimentación más sólida que una etiqueta de preferencia.
Otra distinción importante es la que separa las recompensas de resultado de las recompensas de proceso. Las recompensas de resultado solo juzgan la respuesta final: ¿se completó la demostración, pasó el código, coincide el número? Las recompensas de proceso intentan evaluar los pasos intermedios del razonamiento. Los sistemas verificador-revisor son una forma práctica de aproximar la supervisión del proceso sin exigir que las personas etiqueten cada paso a mano.
Esta distinción importa porque el RL durante el entrenamiento y el test-time compute están relacionados, pero no son lo mismo. El RL durante el entrenamiento modifica los pesos del modelo. El test-time compute le da al modelo más presupuesto de inferencia para muestrear, verificar, revisar o buscar antes de responder. Los sistemas de razonamiento de frontera más potentes suelen combinar ambos: el RL enseña comportamientos de razonamiento útiles y el cómputo adicional en inferencia les da espacio para desarrollarse.
La revolución del razonamiento en los modelos de frontera (2025-2026)
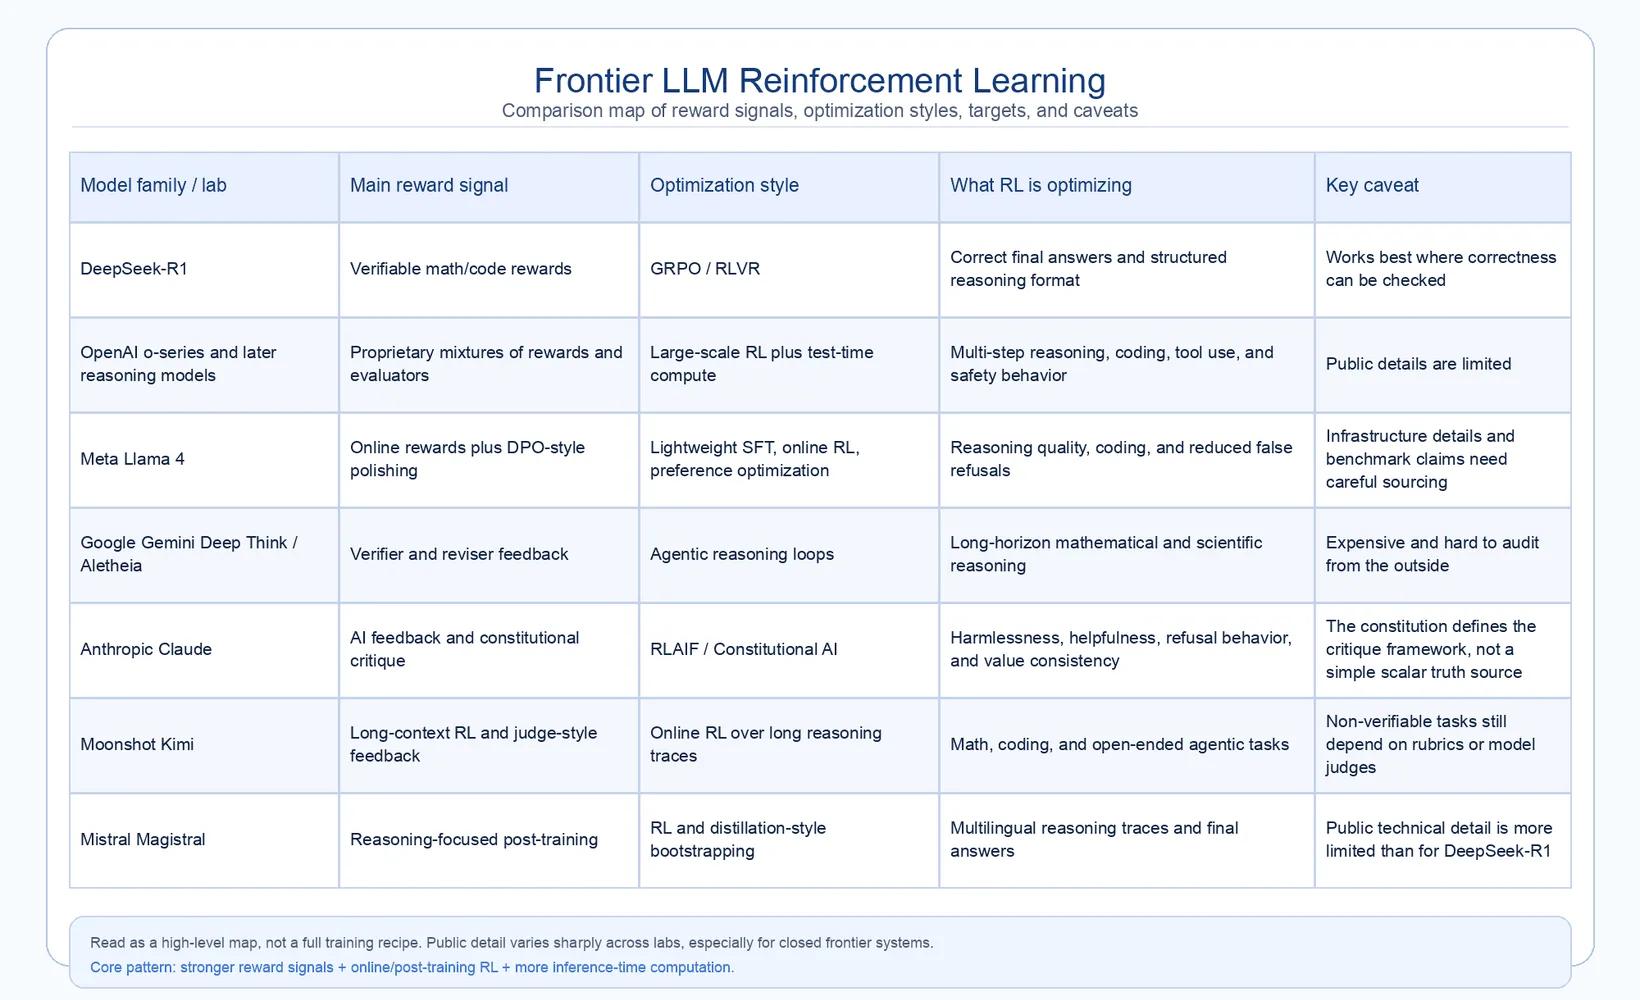
Investigaciones recientes sugieren que los grandes saltos en la resolución de problemas matemáticos complejos, la generación de código y el análisis lógico no se deben simplemente a modelos más grandes. También dependen de un post-entrenamiento más sólido, mejores señales de recompensa y más cómputo en inferencia. Cada empresa ha abordado a su manera el mismo reto de fondo: proporcionar retroalimentación rica y estable a modelos de lenguaje gigantescos.
DeepSeek: recompensas verificables y GRPO
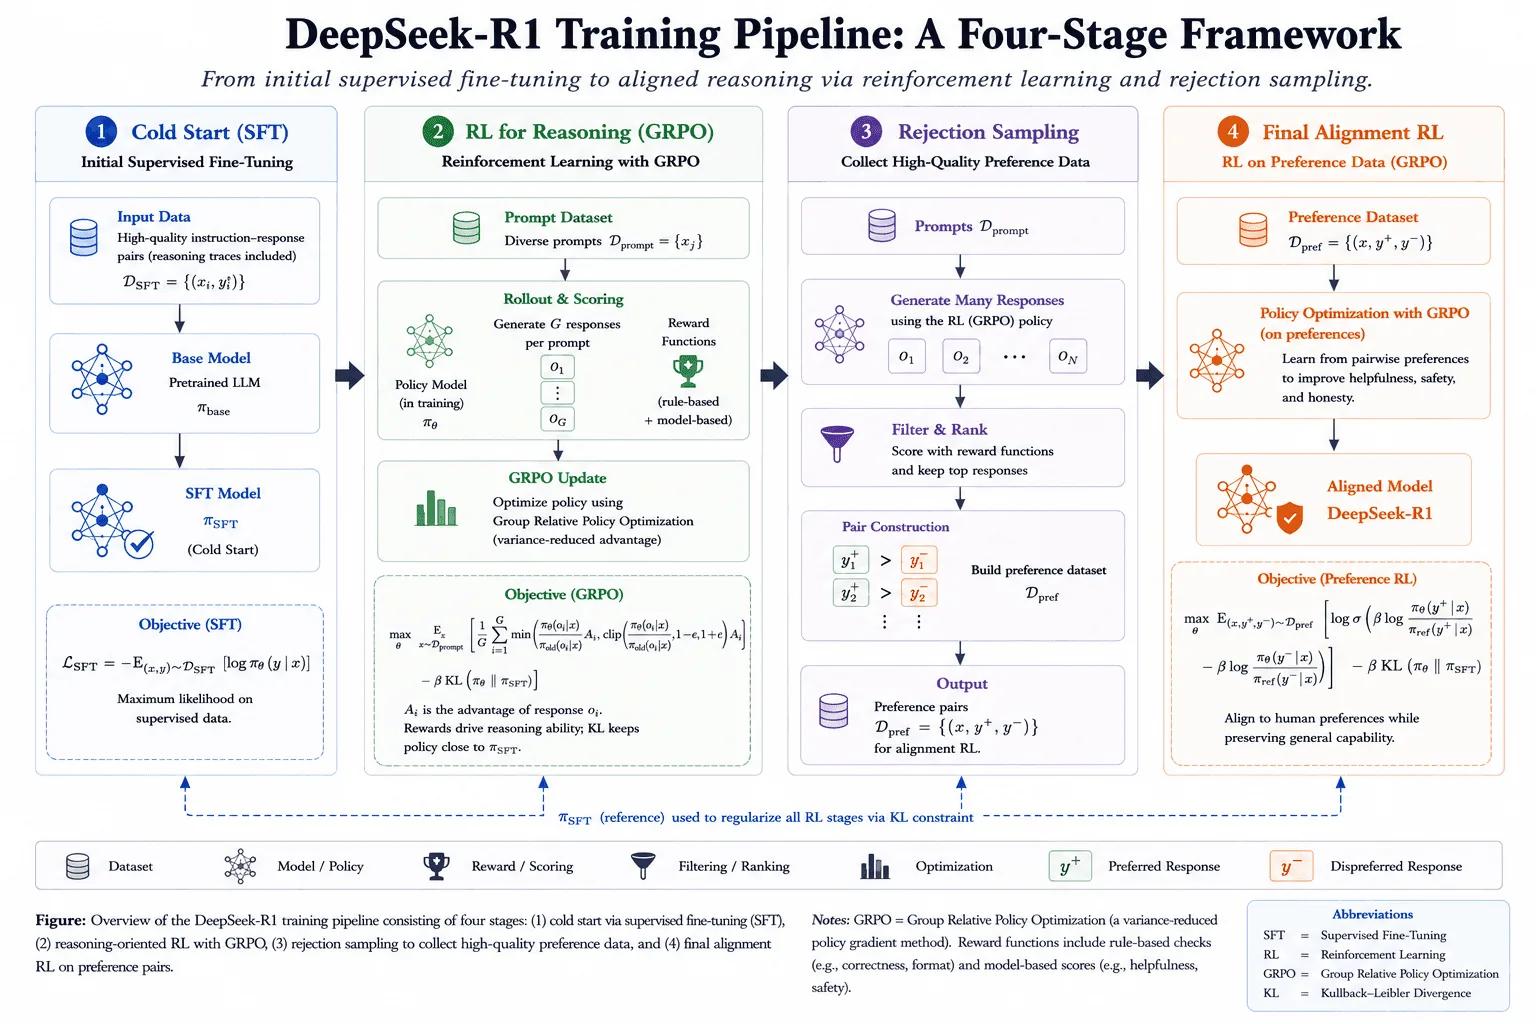
DeepSeek-R1 y su predecesor, DeepSeek-R1-Zero, dieron gran visibilidad al paradigma RLVR. Desafiando los métodos tradicionales usados desde InstructGPT, los investigadores de DeepSeek demostraron con R1-Zero que las capacidades de razonamiento avanzadas pueden surgir en un modelo base mediante aprendizaje por refuerzo a gran escala, sin una fase inicial de ajuste fino supervisado. Al entrenar un modelo de 32.000 millones de parámetros (Qwen-32B-Base) durante decenas de miles de pasos de RL, surgieron de forma espontánea comportamientos de pensamiento estructurado, aunque al principio eran algo desordenados y mezclaban distintos idiomas.
El pipeline final de DeepSeek-R1 añadió después datos supervisados de arranque en frío, muestreo por rechazo y etapas adicionales de alineación para que el comportamiento fuera más legible, estable y útil en la práctica.
Para estabilizar este entrenamiento y escalar hasta el modelo final DeepSeek-R1, el equipo utilizó un algoritmo específico llamado Group Relative Policy Optimization (GRPO). A diferencia del antiguo estándar PPO, que necesitaba un pesado modelo «Critic» para calcular las puntuaciones de referencia, GRPO es mucho más ligero. Muestrea un grupo de respuestas distintas para el mismo prompt y las puntúa comparándolas entre sí.
Así se obtiene un objetivo que penaliza con fuerza las malas respuestas y recompensa las buenas en relación con las demás, a la vez que mantiene las actualizaciones bajo control para evitar el olvido catastrófico. Esta eficiencia permitió a DeepSeek competir con enormes modelos propietarios usando solo una fracción del cómputo habitual.
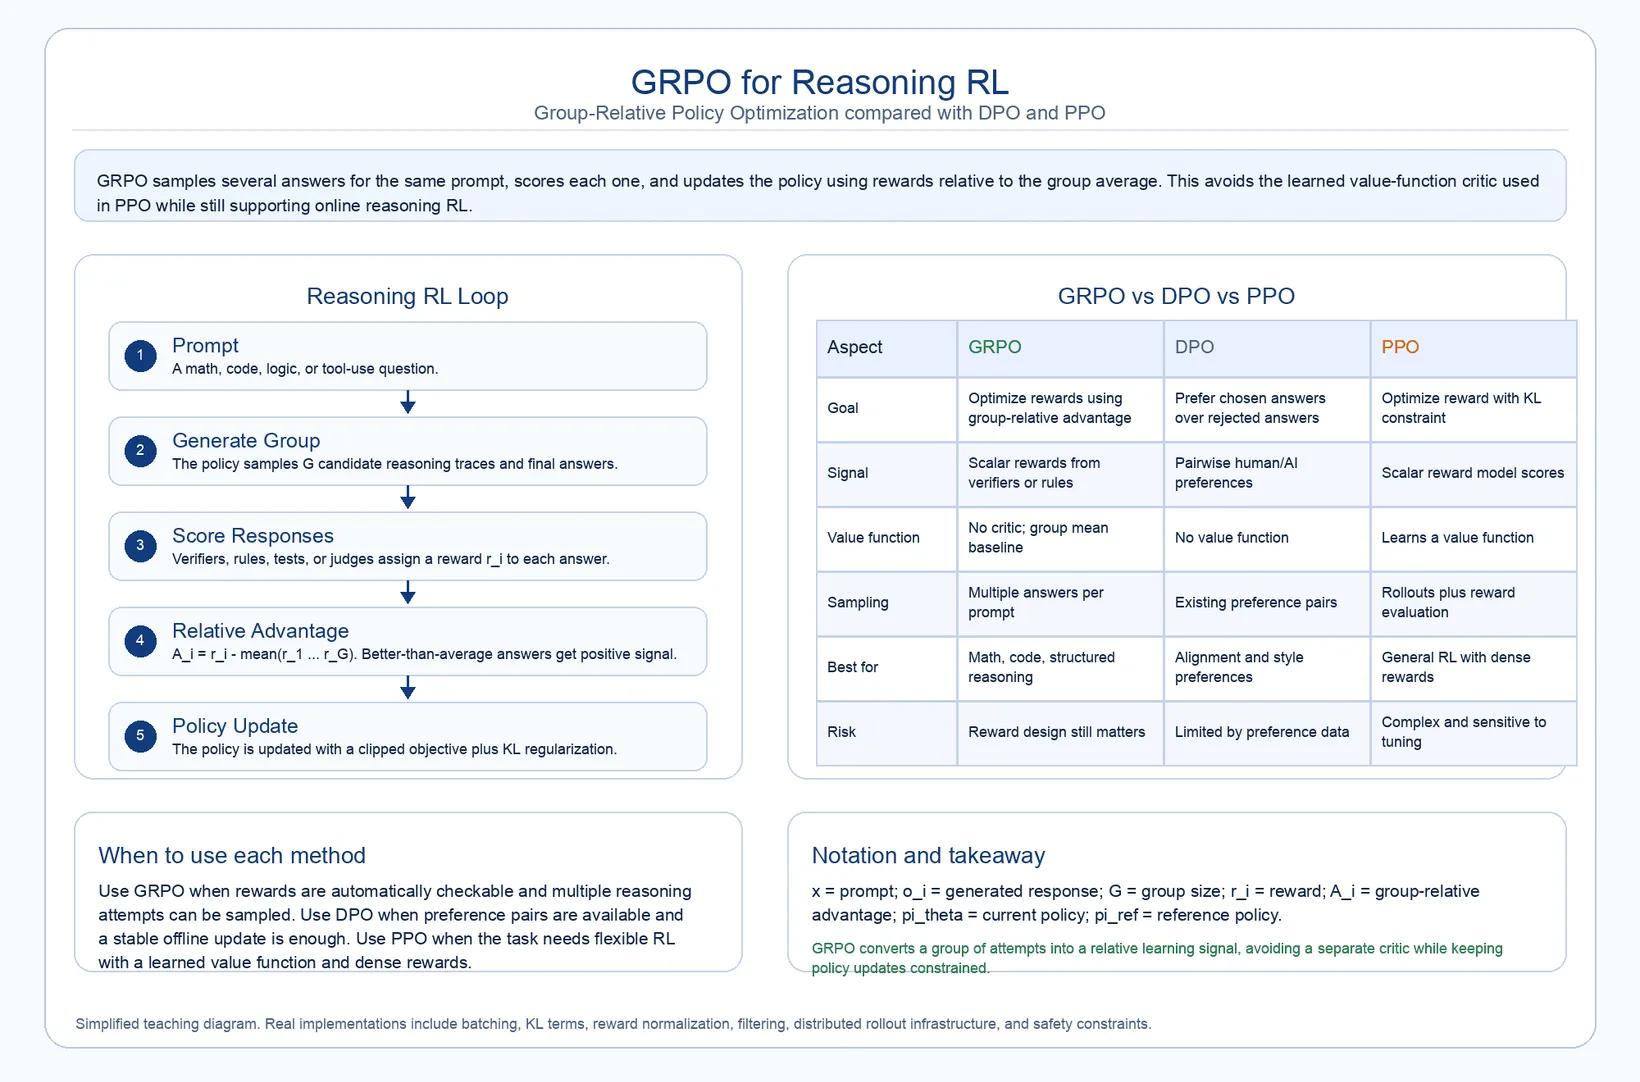
El éxito de GRPO se debe en gran parte al uso del aprendizaje por refuerzo a partir de recompensas verificables (RLVR). En lugar de depender de evaluadores humanos o de modelos de recompensa de IA (que pueden engañarse o «hackearse» con facilidad), DeepSeek utilizó recompensas estrictas basadas en reglas. Las dos principales son de exactitud y de formato. La recompensa de exactitud comprueba si la respuesta final es perfectamente correcta (como que el código pase una prueba unitaria). La recompensa de formato obliga al modelo a colocar su proceso de pensamiento interno dentro de etiquetas XML estrictas, de modo que la cadena de pensamiento sea legible y estructurada.
Este método evolucionó más tarde hacia GRPO-$\lambda$. Los investigadores observaron que penalizar estrictamente a un modelo por escribir respuestas largas (para evitar que pensara sin fin) provocaba caídas bruscas de precisión al inicio del entrenamiento. GRPO-$\lambda$ lo soluciona ajustando la penalización de forma dinámica. Si el modelo se equivoca en las preguntas, deja temporalmente de preocuparse por la longitud para poder buscar la solución con libertad. Este ajuste inteligente mejoró la precisión en benchmarks exigentes como AIME 2024 y GSM8K y, sorprendentemente, redujo a la mitad la longitud media de las respuestas.
OpenAI: razonamiento dinámico, Makora y seguridad
El ecosistema de OpenAI, con la serie «o» y sus posteriores modelos de razonamiento de frontera, ha llevado el aprendizaje por refuerzo a ámbitos en los que los modelos necesitan razonar durante más tiempo antes de responder. Lo usan no solo para el pensamiento abstracto, sino también para escribir código para aceleradores de hardware y mejorar la defensa frente a ciberataques. La idea central de los modelos de razonamiento se basa en leyes de escalado bidimensionales: la precisión de un modelo puede mejorar a medida que se dedica más cómputo al entrenamiento con RL y a medida que se le da más tiempo para razonar durante las pruebas (test-time compute).
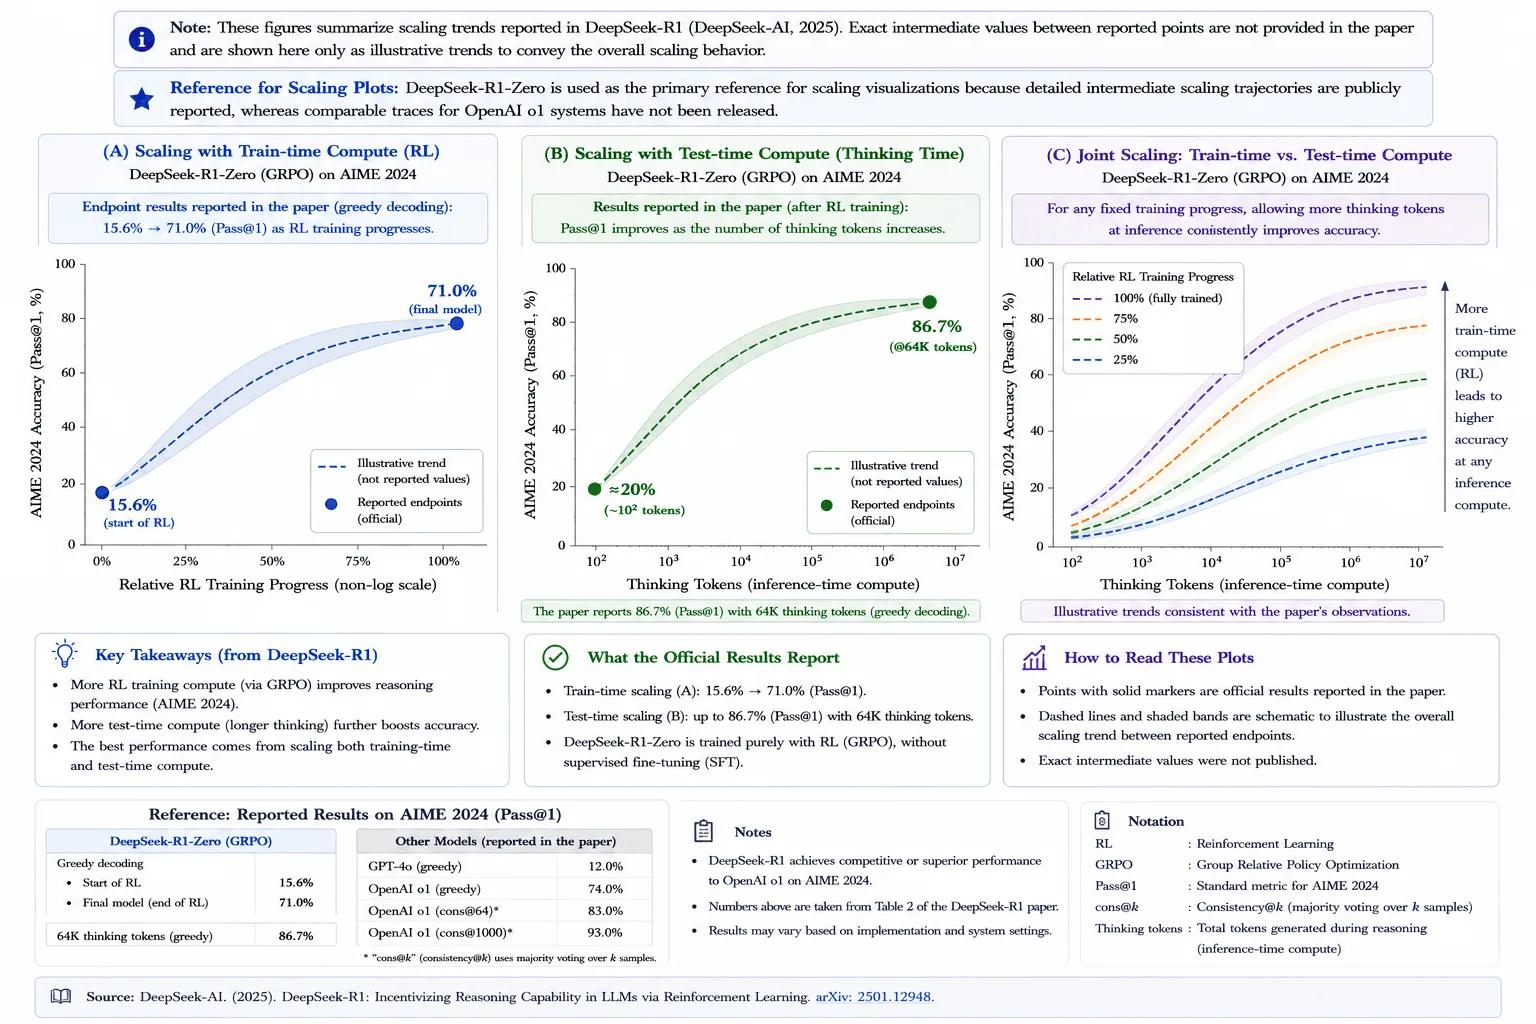
Esta figura usa las curvas de escalado de DeepSeek-R1-Zero como referencia pública de la idea general de escalado en entrenamiento y en inferencia. OpenAI ha descrito un comportamiento cualitativo similar en sus modelos de razonamiento, pero no ha publicado curvas intermedias igual de detalladas.
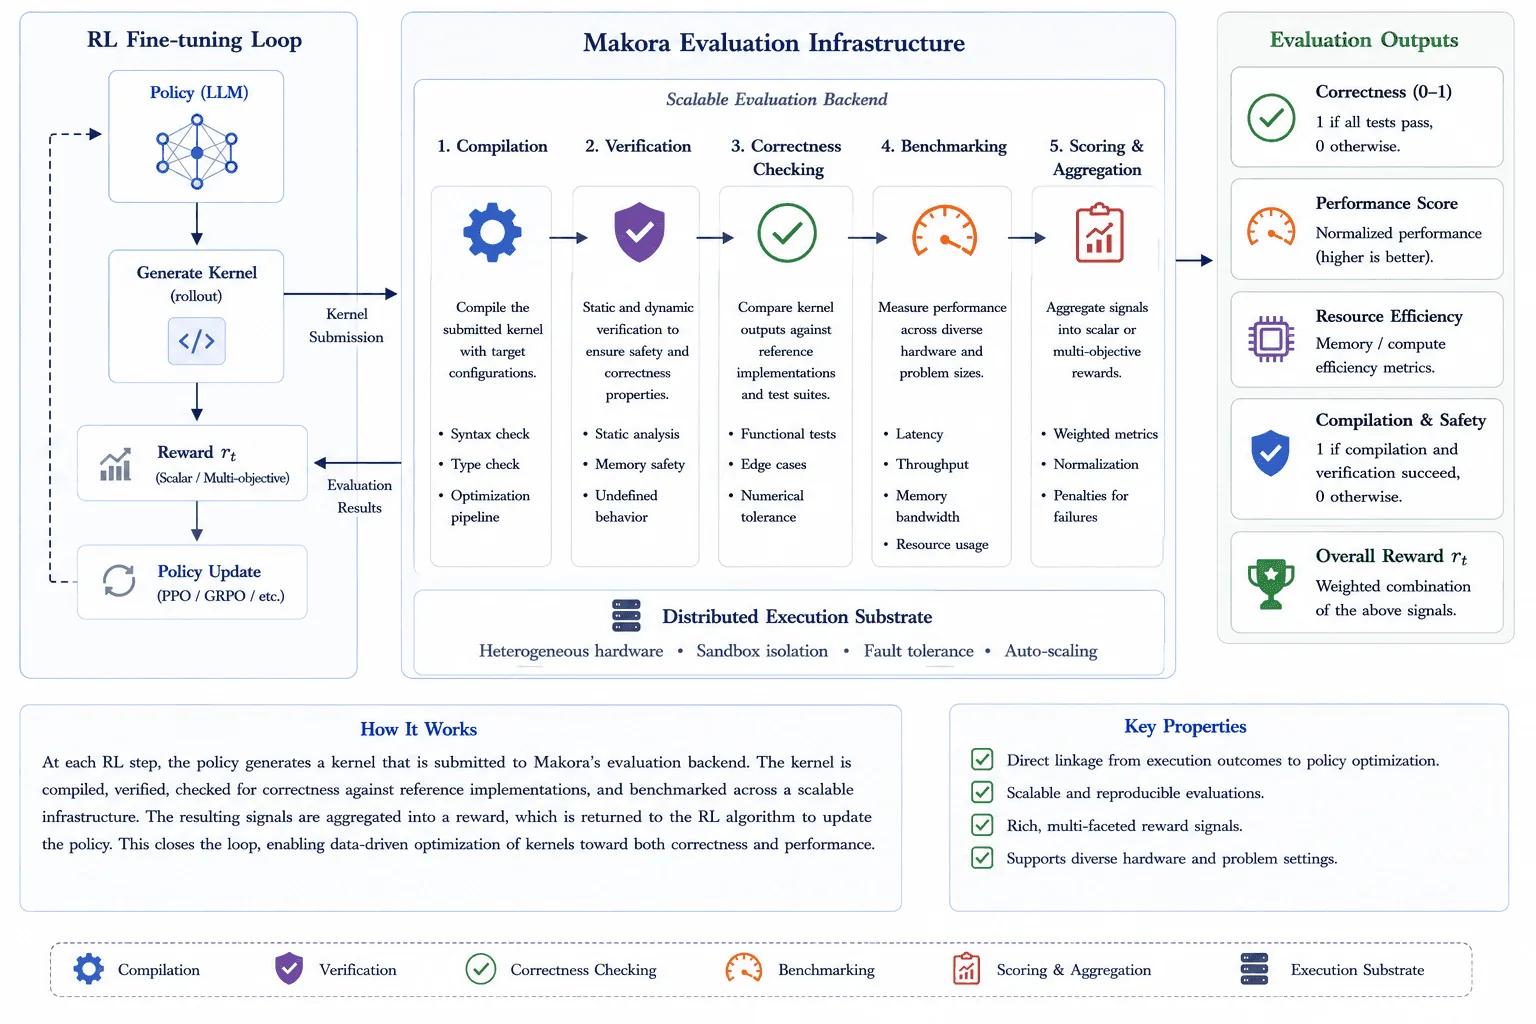
Los resultados publicados muestran por qué este paradigma se volvió tan influyente. En benchmarks de matemáticas y ciencias, el RL intensivo y el cómputo adicional en inferencia parecen llevar a los modelos de razonamiento mucho más allá de los modelos de chat convencionales. Pero quizá la aplicación más interesante sea el uso de RL en campos muy técnicos donde apenas hay datos de entrenamiento humanos. Mediante un sistema de evaluación llamado Makora, OpenAI trató la escritura de kernels (código altamente optimizado para hardware) como un problema puro de RL.
El LLM escribe una propuesta de código que se envía a un sistema backend que la compila, comprueba si funciona y mide su velocidad de ejecución. Cuanto más rápido se ejecuta, mayor es la recompensa. Así se cerró el ciclo directamente entre el rendimiento real del software y el aprendizaje del modelo. Esta técnica permitió al modelo escribir código dos veces más rápido que los compiladores estándar en la mayoría de las pruebas.
Meta Llama 4: optimización asíncrona y DPO ligero
El enfoque de Meta con su familia Llama 4 (que incluye Scout 17B, Maverick 17B y el modelo Behemoth 288B) muestra otra forma de escalar el aprendizaje por refuerzo online en modelos open source. A diferencia de modelos anteriores que dependían de enormes cantidades de datos supervisados, el post-entrenamiento descrito para Llama 4 utiliza un pipeline ágil y específico: un poco de SFT ligero, seguido de RL online intensivo y un pulido final con Direct Preference Optimization (DPO).
La gran idea técnica del post-entrenamiento de Llama 4 Maverick es su infraestructura de RL asíncrona. Normalmente, algoritmos como PPO o GRPO generan texto y actualizan el modelo en el mismo nodo del servidor. Esto crea un cuello de botella, porque las GPU de entrenamiento pueden quedarse inactivas mientras esperan a que se calculen las recompensas. Meta explica que divide la carga de trabajo para que el cálculo de recompensas se ejecute de forma independiente, ocultando el tiempo que lleva evaluar recompensas complejas como las pruebas de código.
Durante esta fase, Meta hace hincapié en los prompts difíciles. Después, la capa final de DPO ayuda a pulir el tono y a reducir los casos en que el modelo se niega por error a responder una pregunta inofensiva. Esto convierte a Llama 4 en un buen ejemplo de stack de post-entrenamiento híbrido: RL para los comportamientos de razonamiento más exigentes y, después, optimización de preferencias para el comportamiento de cara al usuario.
Google Gemini Deep Think: investigación autónoma y Aletheia
El ecosistema de Google DeepMind, en concreto Gemini Deep Think y los agentes de investigación relacionados, es uno de los ejemplos más claros de aprendizaje por refuerzo aplicado al razonamiento científico de largo horizonte. Mientras muchos modelos optimizan respuestas individuales, los sistemas del estilo de Deep Think plantean el razonamiento en torno a agentes autónomos compuestos por varias partes. El ejemplo más avanzado es el agente matemático Aletheia.
Aletheia no depende de lenguajes de programación formales para demostrar teoremas; trabaja por completo en inglés natural. Utiliza un ciclo de refuerzo con tres partes: un Generator, un Verifier y un Reviser. Ante un teorema difícil, el modelo redacta posibles soluciones. Si el Verifier detecta un pequeño error, no descarta toda la respuesta, sino que la pasa al Reviser para corregir la lógica. La respuesta solo se descarta si hay un error grave e irreparable. Aletheia también puede usar búsqueda externa y consulta de literatura científica para validar sus afirmaciones y no inventarse citas.
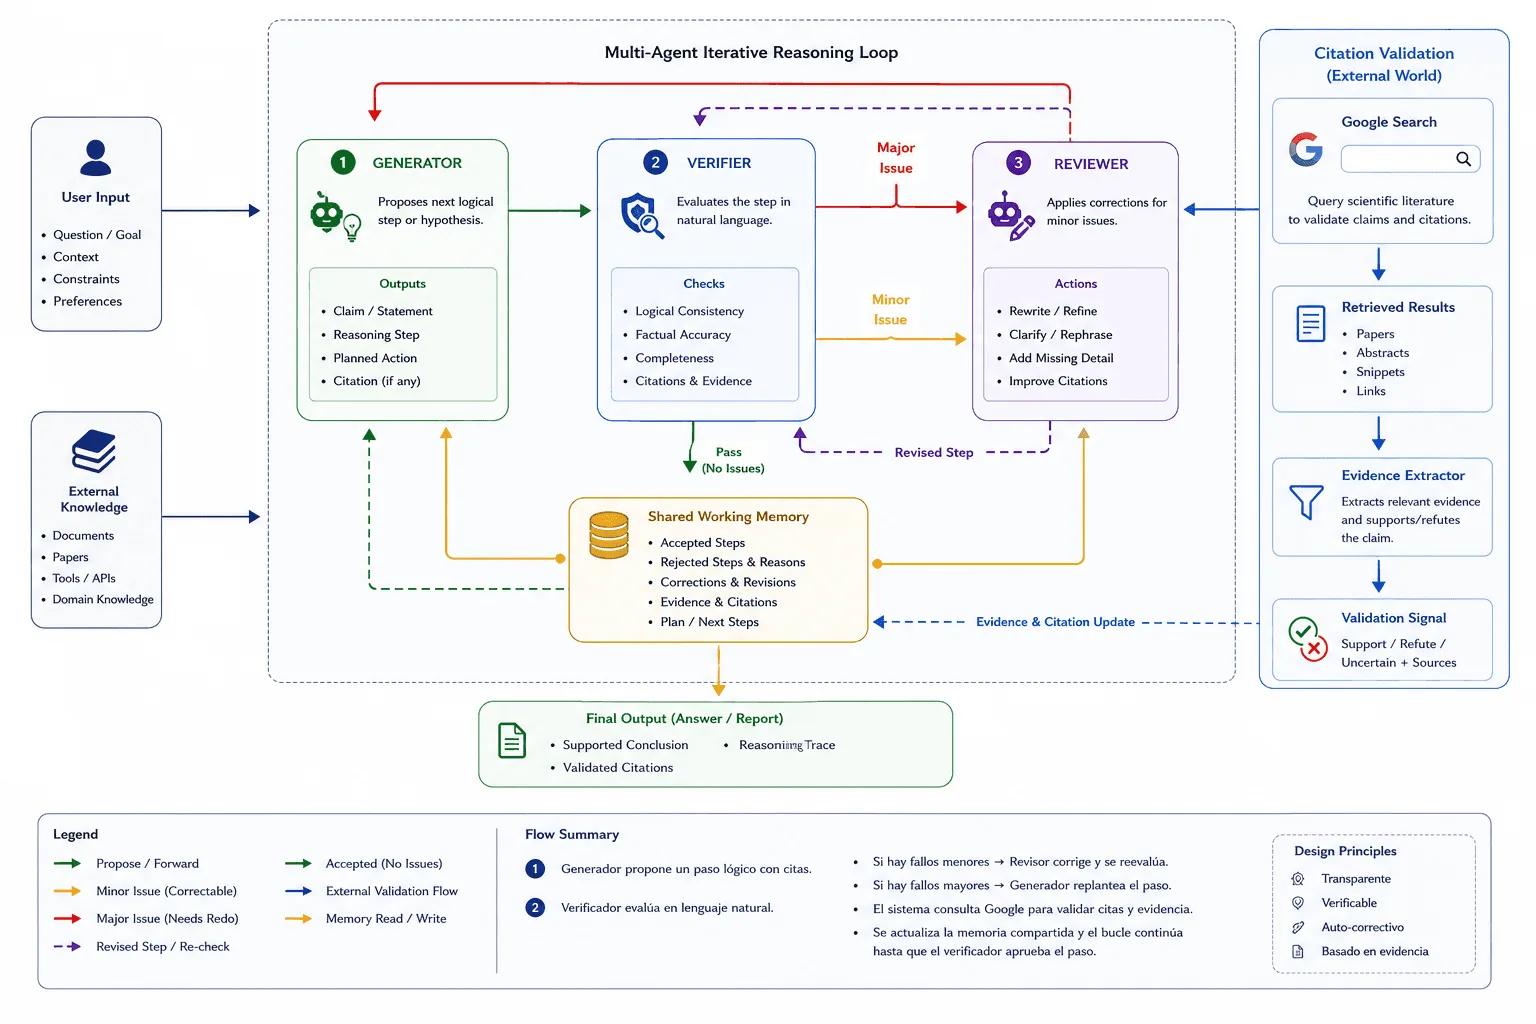
Los resultados publicados de Aletheia sugieren que los ciclos verificador-revisor pueden llevar los sistemas de demostración matemática en lenguaje natural mucho más allá de la generación convencional de una sola pasada, especialmente en benchmarks de demostración difíciles. Más impresionante aún, se ha descrito a Aletheia como capaz de producir resultados de investigación matemática sustanciales y de inspeccionar algoritmos de machine learning. Lo importante desde el punto de vista técnico no es solo la puntuación, sino el ciclo: generar, verificar, revisar y solo entonces aceptar la demostración.
Anthropic Claude: constituciones formales y RLAIF
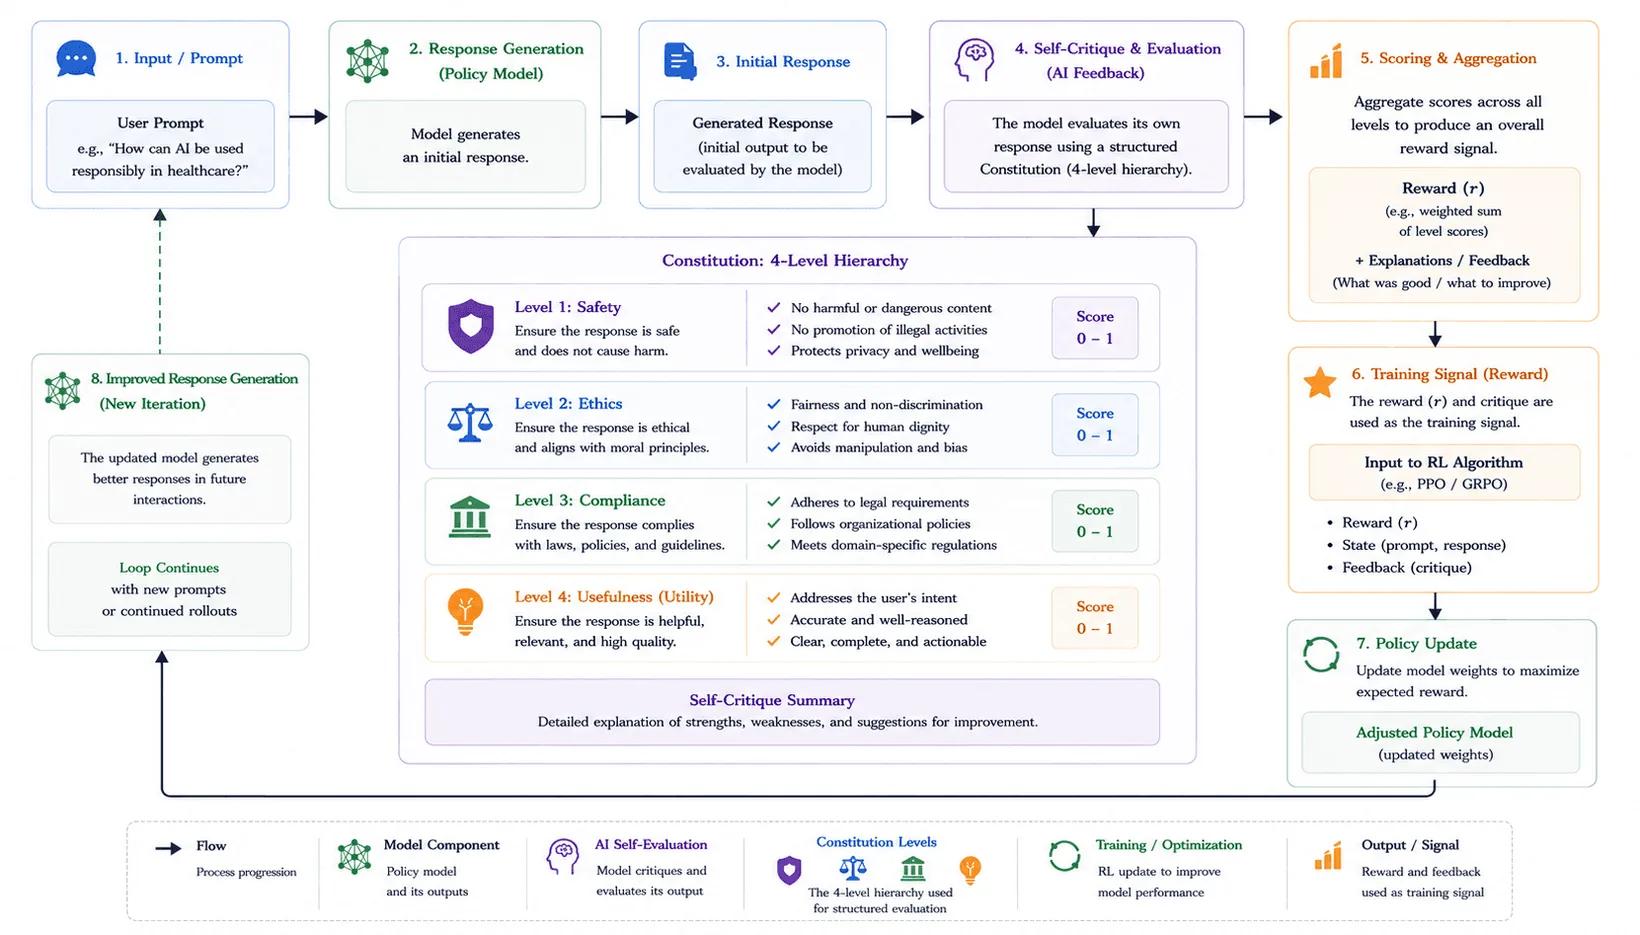
El enfoque de Anthropic con Claude 3.5 y Claude 4 se centra en la IA constitucional (Constitutional AI). En lugar de depender de miles de trabajadores humanos para decidir qué respuesta es mejor —un proceso lento, sesgado y difícil cuando se trata de contenido tóxico—, Anthropic utiliza un modelo de IA guiado por un conjunto de reglas escritas (una «constitución»).
Este método, llamado aprendizaje por refuerzo a partir de retroalimentación de IA (RLAIF), obliga al modelo a generar una respuesta, criticarse a sí mismo según reglas explícitas (como los derechos humanos y principios de utilidad) y reescribir su salida para cumplirlas. Estas respuestas pulidas se usan después para actualizar el modelo. La evidencia muestra que esta técnica basada en reglas iguala o supera a los métodos clásicos de retroalimentación humana. Y, sobre todo, garantiza que los valores fundamentales del modelo sean transparentes, fáciles de auditar y rápidos de actualizar sin pasar meses recopilando datos humanos.
A finales de enero de 2026, Anthropic publicó una actualización importante de este marco: «Claude’s New Constitution». Al pasar de un enfoque simple basado en reglas a un documento de alineación más basado en el razonamiento, establece una jerarquía de prioridades en torno a la seguridad, la ética, el cumplimiento normativo y la utilidad. La constitución no resuelve la alineación por arte de magia. Su función es definir el marco de crítica que se usa para generar, filtrar y clasificar respuestas durante el entrenamiento y la evaluación. Al hacer público el documento, Anthropic también hizo que su filosofía de alineación fuera más fácil de examinar y debatir.
Moonshot AI Kimi: escalar el RL a tareas no verificables
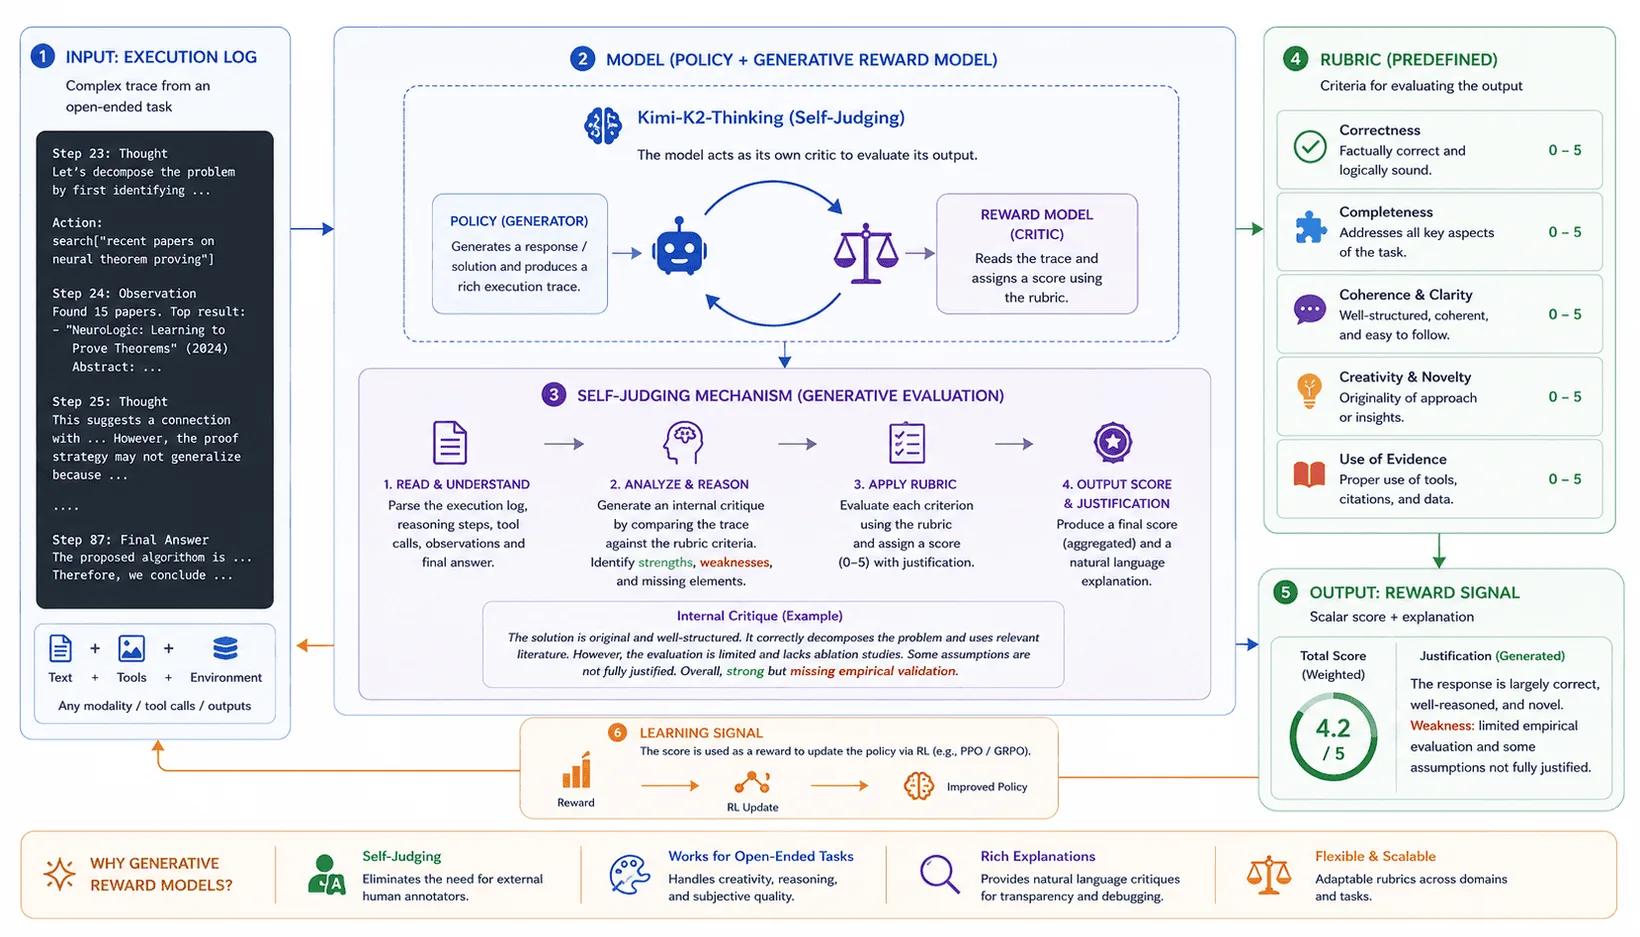
Moonshot AI lanzó Kimi k1.5 y K2, ampliando los límites de lo que el RL puede lograr fuera de las matemáticas y la programación. Históricamente, el principal reto del RL ha sido evaluar tareas no verificables, como la escritura creativa, la agregación de búsquedas o la generación de informes complejos, donde no existe una respuesta absolutamente «correcta» o «incorrecta». Moonshot lo resolvió desplegando de forma sistemática modelos de recompensa generativos (GRM) en una amplia gama de comportamientos agénticos. En lugar de simples puntuaciones escalares, Kimi se apoya en un «juez de logs» basado en un LLM (por ejemplo, Kimi-K2-Thinking) que utiliza una rúbrica de autocrítica para evaluar la generación abierta y decidir, por ejemplo, si un registro de ejecución demuestra que un parche de software eliminó con éxito un patrón de fallo.
Además, Moonshot AI descubrió que ampliar la ventana de contexto a 128k tokens durante la fase de RL permite de forma natural que el modelo realice búsquedas implícitas en el espacio de razonamiento mediante predicciones autorregresivas. Así se estableció un marco de RL sencillo pero eficaz. Como el modelo puede aprovechar un contexto enorme para planificar, reflexionar y corregirse, Kimi obtiene resultados sólidos en matemáticas, programación y razonamiento visión-lenguaje sin necesidad de trucos arquitectónicos costosos en cómputo como Monte Carlo Tree Search (MCTS) o los Process Reward Models (PRM) tradicionales.
Mistral AI: Magistral y razonamiento multilingüe
A principios de 2025, Mistral AI entró en la carrera del razonamiento de frontera con el lanzamiento de Magistral, su primer modelo de razonamiento nativo. Disponible tanto en versión open source (Magistral Small, 24B parámetros) como en una versión empresarial más potente (Magistral Medium), pone el foco en la cadena de pensamiento multilingüe y específica de cada dominio.
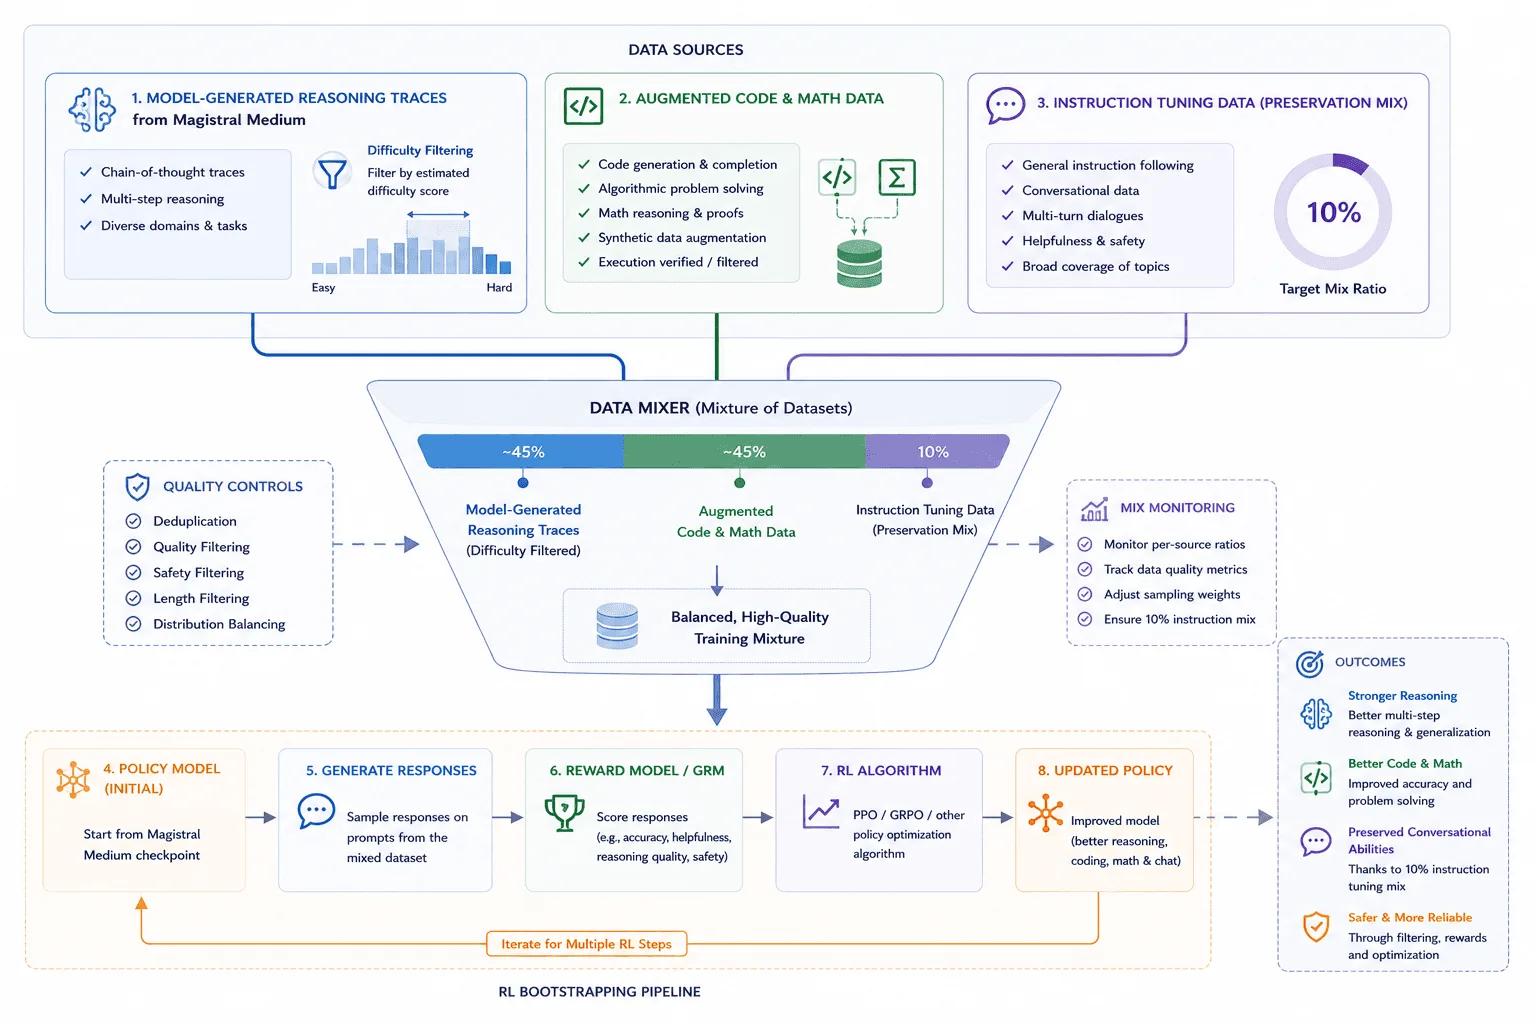
El enfoque de Mistral contrasta con el de los laboratorios que dependen por completo de destilar trazas de modelos cerrados más grandes. Magistral se presentó como una extensión centrada en el razonamiento de la familia de modelos de frontera de Mistral, con el aprendizaje por refuerzo como pieza central de su post-entrenamiento. Para crear el eficientísimo Magistral Small, Mistral utilizó un sofisticado pipeline de bootstrapping: generó trazas de razonamiento con el modelo Medium, las filtró para mantener un nivel de dificultad variado, amplió los datos con subconjuntos de OpenThoughts y OpenR1 e incorporó datos generales de instruction tuning para que el modelo no perdiera sus habilidades conversacionales ajenas al razonamiento. Quizá su rasgo más singular sea su estrategia multilingüe nativa: el modelo está entrenado para generar tanto las trazas de razonamiento como las respuestas finales en el idioma que pide el usuario, lo que demuestra que el razonamiento avanzado no tiene por qué ser exclusivamente en inglés.
Limitaciones y problemas abiertos
El stack de RL moderno es potente, pero no es una solución limpia para el razonamiento. La primera limitación es el reward hacking. Si un modelo encuentra la manera de satisfacer la recompensa sin resolver la tarea real, el RL reforzará ese atajo. Esto es especialmente peligroso cuando el evaluador es otro modelo en lugar de una prueba determinista.
La segunda limitación es el sobreajuste a los benchmarks. Los benchmarks de matemáticas, programación y razonamiento son útiles porque ofrecen una retroalimentación clara, pero esa misma claridad hace que sea más fácil optimizar específicamente para ellos. Un modelo puede mejorar en un benchmark sin ganar el mismo nivel de robustez en tareas reales más caóticas.
La tercera limitación es que las recompensas verificables están distribuidas de forma desigual. El código, las matemáticas y las salidas estructuradas suelen poder comprobarse automáticamente. La investigación abierta, la escritura extensa, la planificación de producto y la exploración científica son mucho más difíciles de puntuar. Para estas tareas, los laboratorios siguen dependiendo de rúbricas, modelos jueces, revisión humana o señales indirectas del entorno.
También hay un problema de costes. El test-time compute puede mejorar la precisión al permitir que el modelo muestree, revise y verifique de forma más intensiva, pero aumenta la latencia y el coste de servicio. Por eso es más difícil desplegar en todas partes los modos de razonamiento más potentes.
Por último, la cadena de pensamiento oculta plantea un problema de auditoría. Muchos sistemas de frontera pueden usar largas trazas de razonamiento internas sin mostrarlas directamente. Eso puede ser positivo para la seguridad y la experiencia de usuario, pero dificulta que terceros examinen lo que el modelo aprendió realmente del RL.
Conclusión
Los casos de estudio de OpenAI, DeepMind, Meta, DeepSeek, Mistral, Moonshot y Anthropic sugieren que el desarrollo de la IA de frontera ha pasado de depender solo del preentrenamiento estático a un stack de post-entrenamiento más interactivo. Las recompensas verificables, la optimización online, la retroalimentación de IA, la autodestilación, los entornos de herramientas y el test-time compute trabajan ahora juntos para moldear cómo razonan los modelos.
Los modelos ya no se limitan a memorizar patrones de internet. Los sistemas más potentes se entrenan y se orientan para dedicar más cómputo a comprobar cálculos matemáticos, depurar código, usar herramientas, revisar planes y validar pasos intermedios. El aprendizaje por refuerzo no es el único ingrediente de este cambio, pero se ha convertido en uno de los mecanismos centrales que transforman modelos de lenguaje en bruto en sistemas capaces de buscar, verificar y mejorar sus propias respuestas.
Bibliografía
Fundamentos: RLHF, DPO y retroalimentación de IA
Ouyang et al., 2022. Training language models to follow instructions with human feedback. El artículo de InstructGPT que estableció el pipeline de alineación clásico SFT -> modelo de recompensa -> PPO.
Bai et al., 2022. Constitutional AI: Harmlessness from AI Feedback. El artículo original de Anthropic sobre RLAIF e IA constitucional.
Rafailov et al., 2023. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. El artículo de referencia sobre DPO, útil para entender la optimización de preferencias offline sin entrenar explícitamente un modelo de recompensa.
Anthropic, 2023. Claude's Constitution. Versión pública de los principios que guían la crítica constitucional de Claude.
Anthropic, 2026. Claude's New Constitution. Constitución pública actualizada y contexto útil para entender el paso de listas de reglas a una alineación más amplia basada en el razonamiento.
RL para razonamiento y recompensas verificables
OpenAI, 2024. Learning to Reason with LLMs. Fuente primaria de OpenAI sobre el razonamiento al estilo o1, el entrenamiento con RL y el enfoque de test-time compute.
DeepSeek-AI, 2025. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. Fuente primaria sobre DeepSeek-R1, DeepSeek-R1-Zero, GRPO y el entrenamiento de razonamiento al estilo RLVR.
Yue et al., 2025. Stable Reinforcement Learning for Efficient Reasoning. Presenta GRPO-$\lambda$ y analiza cómo estabilizar las penalizaciones por longitud en el RL de razonamiento.
Moonshot AI, 2025. Kimi k1.5: Scaling Reinforcement Learning with LLMs. Fuente primaria sobre el RL de contexto largo y el enfoque de escalado de Kimi.
Label Studio, 2025. Reinforcement Learning from Verifiable Rewards. Explicación secundaria de RLVR; útil como visión conceptual accesible, no como fuente principal de evidencia.
Casos de estudio de modelos de frontera
Meta AI, 2025. The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation. Fuente primaria sobre el post-entrenamiento de Llama 4, incluidos el SFT ligero, el RL online y el pulido al estilo DPO.
Mistral AI, 2025. Magistral. Fuente primaria sobre la familia de modelos de razonamiento de Mistral, su enfoque en el razonamiento multilingüe y su planteamiento de RL y post-entrenamiento.
Google DeepMind, 2026. Accelerating Mathematical and Scientific Discovery with Gemini Deep Think. Fuente primaria de DeepMind sobre Gemini Deep Think y sus capacidades de razonamiento científico.
Feng et al., 2026. Towards Autonomous Mathematics Research. Artículo de investigación que describe Aletheia como un agente de investigación matemática basado en Gemini Deep Think.
Feng et al., 2026. Aletheia tackles FirstProof autonomously. Evaluación posterior de Aletheia en el desafío FirstProof.
Tehrani et al., 2026. Fine-Tuning GPT-5 for GPU Kernel Generation. Artículo de Makora sobre el ajuste fino con RL para generar kernels de GPU con recompensas verificables.
Makora, 2026. We RL'd GPT-5 to Write Better Kernels. Artículo de blog complementario sobre el trabajo de Makora con RL aplicado a kernels de GPU.
Contexto útil y lecturas complementarias
Decode the Future, 2024. RLHF explained. Introducción accesible al RLHF para quienes buscan un enfoque menos técnico.
Le Wagon, 2025. OpenAI o1 and o3 explained: how thinking models work. Visión general secundaria de los conceptos de los modelos de razonamiento; útil para la intuición, pero menos sólida que las fuentes primarias de modelos y artículos.
