

Reinforcement Learning in Frontier-LLMs: Von RLHF zu verifizierbaren Rewards
 Toni Lopez Co-Founder at Karumi
Architektur und Methoden hinter Large Language Models (LLMs) haben sich zwischen 2025 und 2026 grundlegend gewandelt. Früher bedeutete der Bau eines Foundation Models vor allem massives Pre-Training mit riesigen Mengen an Rohdaten. Darauf folgte meist eine einfache Alignment-Phase mit Supervised Fine-Tuning (SFT) und Reinforcement Learning from Human Feedback (RLHF). Als jedoch hochwertige Trainingsdaten im Internet knapp wurden und der Bedarf an KI mit echten Reasoning-Fähigkeiten wuchs, musste die Branche umdenken.
Forschende wie Tech-Unternehmen richten ihren Fokus und ihre Rechenleistung inzwischen stärker auf interaktives Post-Training und „Test-Time Compute“ (also darauf, Modellen mehr Zeit zum Verarbeiten und Nachdenken zu geben, bevor sie antworten). In dieser neuen Landschaft ist Reinforcement Learning (RL) nicht mehr nur ein Werkzeug, um den Ton eines Modells anzupassen oder schlechte Ausgaben herauszufiltern. Es ist zu einem der wichtigsten Motoren des Post-Trainings geworden – insbesondere für Modelle, die planen, Zwischenergebnisse prüfen, Tools nutzen und ihre Antworten über längere Reasoning-Traces verbessern müssen.
Der aktuelle Stand der Technik, geprägt von Frontier-Modellen von Organisationen wie OpenAI, Meta, Google DeepMind, Anthropic, DeepSeek, Moonshot AI und Mistral, zeigt eine enorme Vielfalt bei der Anwendung von Policy-Optimierungsalgorithmen. Die Branche ergänzt neuronale Reward-Modelle zunehmend durch verifizierbare Reward-Systeme, asynchrone Präferenzoptimierung, modellbasierte Kritik und Feedback aus der Umgebung.
Dieser Bericht zeigt, wie Reinforcement Learning in den führenden Modellen von heute eingesetzt wird.
Das „klassische Paradigma“: RLHF vor 2025
Vor dem großen Umbruch 2025 war der Standardansatz für das Alignment von LLMs stark von OpenAIs InstructGPT geprägt. Dieser klassische Ansatz basierte auf Reinforcement Learning from Human Feedback (RLHF) und folgte einem strikten dreistufigen Prozess. Zunächst durchlief das Modell ein Supervised Fine-Tuning (SFT) mit Beispielen, die von menschlichen Annotatoren verfasst wurden. Dann wurde ein separates Reward-Modell (RM) auf Datensätzen menschlicher Präferenzen trainiert, um vorherzusagen, welche Antworten Menschen am besten gefielen. Schließlich wurde das SFT-Modell mithilfe von Proximal Policy Optimization (PPO), einem Algorithmus, der die Policy während der Ausführung aktualisiert, gegen dieses Reward-Modell optimiert.
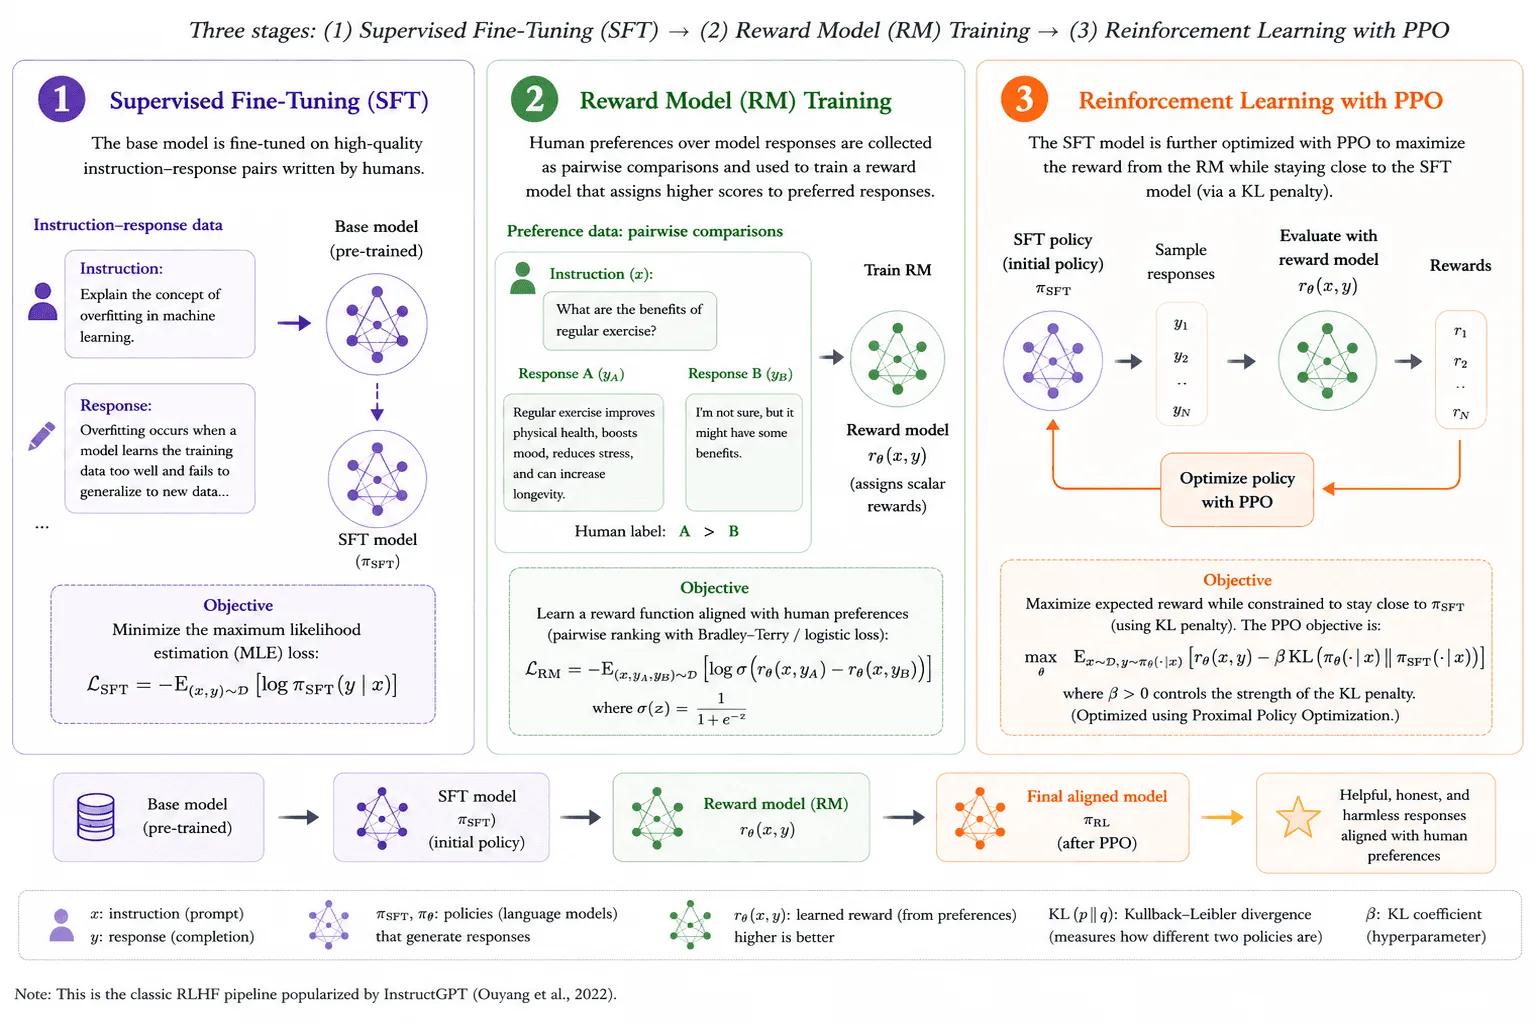
Für einfache Tonanpassungen und das Befolgen simpler Anweisungen funktionierte das gut, doch klassisches RLHF hatte gravierende Schwächen. Es litt unter der sogenannten „Alignment Tax“: Wurde ein Modell darauf optimiert, höflich oder sicher zu klingen, verschlechterten sich seine grundlegenden Reasoning- und Fachkompetenzen spürbar. Zudem war PPO berüchtigt komplex und extrem speicherhungrig, da mehrere Modelle (Actor, Critic, Reference und Reward) gleichzeitig laufen mussten.
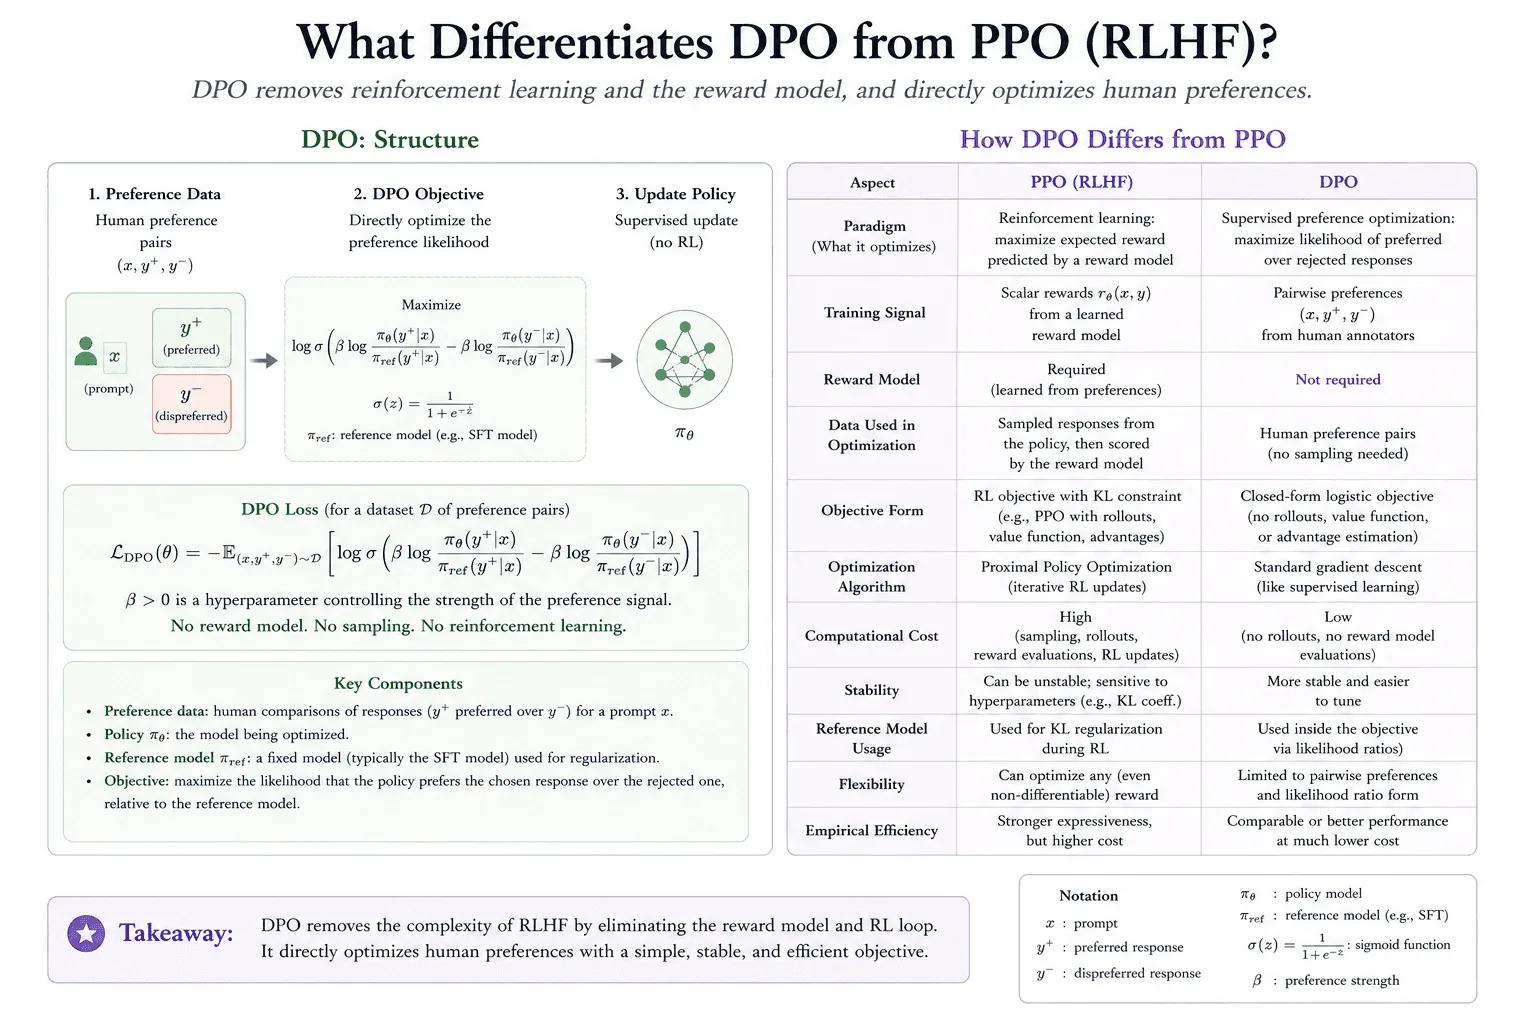
Ende 2023 brachte Direct Preference Optimization (DPO) die erste große Vereinfachung. DPO wies mathematisch nach, dass der separate Schritt der Reward-Modellierung komplett entfallen kann und sich die Policy direkt aus Datensätzen menschlicher Präferenzen optimieren lässt. Vor 2025 war DPO jedoch eine rein „Offline“-Methode. Sowohl PPO als auch DPO stützten sich ausschließlich auf statische, von Menschen annotierte Daten – die Modelle konnten menschliche Reasoning-Fähigkeiten also nie wirklich übertreffen. Um diese Grenze zu durchbrechen, musste sich die Branche verifizierbaren Rewards und den heutigen „Online“-Methoden zuwenden.
Vom Präferenz-Alignment zu verifizierbaren Rewards
Die größte Veränderung im modernen LLM-Post-Training besteht nicht einfach darin, dass Unternehmen „mehr RL“ einsetzen. Entscheidend ist, dass das Reward-Signal selbst vielfältiger geworden ist. Frühes RLHF optimierte vor allem auf das, was Menschen bevorzugten: Klarheit, Hilfsbereitschaft, Harmlosigkeit und Gesprächston. Das war nützlich, gab dem Modell aber keinen verlässlichen Weg, Antworten jenseits dessen zu finden, was Menschen leicht beurteilen konnten.
Moderne Reasoning-Systeme kombinieren mehrere Arten von Feedback. Rewards auf Basis menschlicher Präferenzen bleiben für Alignment und Stil wichtig. Direct Preference Optimization (DPO) vereinfacht dies, indem sie aus Präferenzpaaren lernt, ohne eine vollständige PPO-Schleife zu durchlaufen. Reinforcement Learning from AI Feedback (RLAIF) ersetzt einen Teil der menschlichen Bewertungen durch KI-generierte Kritiken, oft gesteuert durch eine Verfassung oder ein Bewertungsraster. Reinforcement Learning from Verifiable Rewards (RLVR) geht noch weiter: Es belohnt Antworten, die sich anhand von Regeln überprüfen lassen – etwa mathematische Lösungen, Code, der Tests besteht, oder strukturierte Ausgaben, die einem erwarteten Format entsprechen.
Hinzu kommt eine wachsende Klasse von Umgebungs-Rewards. Statt einen Menschen oder ein Reward-Modell zu fragen, ob eine Antwort gut ist, agiert das Modell innerhalb eines externen Systems. Ein Compiler kann prüfen, ob generierter Code läuft. Unit-Tests können einen Patch verifizieren. Ein Theorembeweiser, ein Suchsystem, ein Browser oder eine Tool-Umgebung liefern Feedback, das fundierter ist als ein Präferenzlabel.
Eine weitere wichtige Unterscheidung ist die zwischen Outcome-Rewards und Process-Rewards. Outcome-Rewards bewerten nur die finale Antwort: Wurde der Beweis vollendet, hat der Code die Tests bestanden, stimmt die Zahl? Process-Rewards versuchen, die Zwischenschritte des Reasonings zu bewerten. Verifier-Reviser-Systeme sind ein praktischer Weg, Prozessüberwachung näherungsweise umzusetzen, ohne dass Menschen jeden Schritt von Hand annotieren müssen.
Diese Unterscheidung ist wichtig, weil RL während des Trainings und Test-Time Compute zwar verwandt, aber nicht identisch sind. RL im Training verändert die Gewichte des Modells. Test-Time Compute gibt dem Modell mehr Inferenzbudget, um vor der Antwort zu sampeln, zu prüfen, zu überarbeiten oder zu suchen. Die stärksten Frontier-Reasoning-Systeme kombinieren in der Regel beides: RL vermittelt nützliche Reasoning-Verhaltensweisen, zusätzliche Rechenleistung bei der Inferenz gibt diesen Verhaltensweisen Raum, sich zu entfalten.
Die Reasoning-Revolution in Frontier-Modellen (2025–2026)
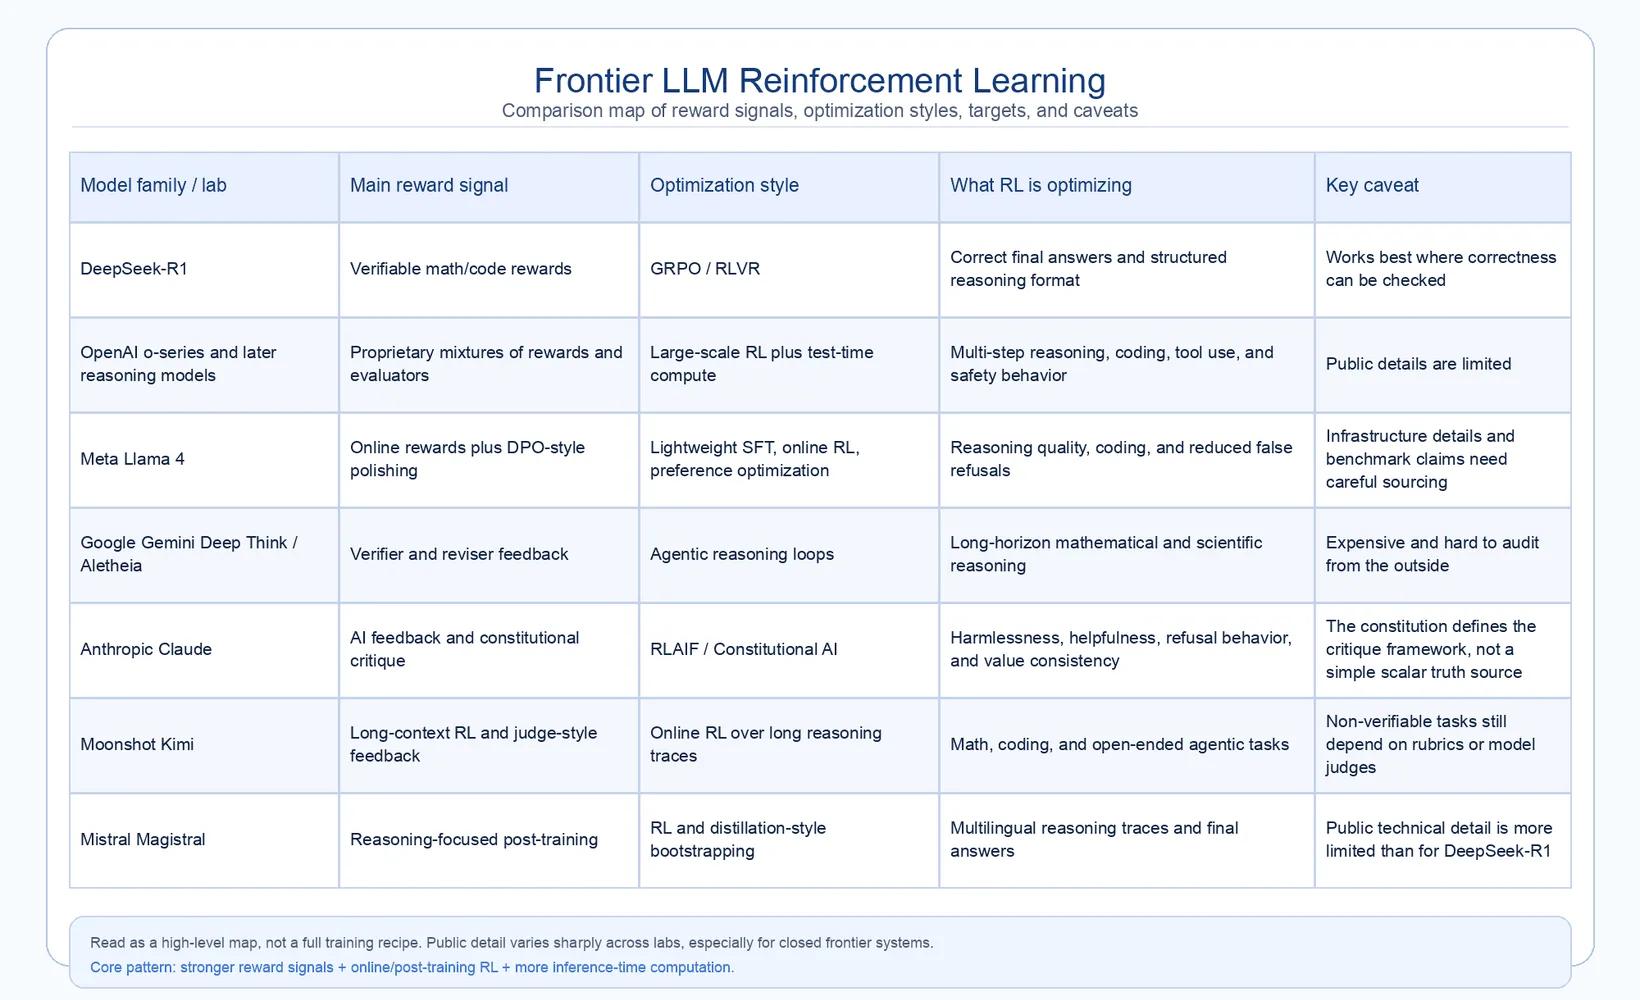
Aktuelle Forschung legt nahe, dass die großen Sprünge beim Lösen komplexer Mathematikaufgaben, beim Generieren von Code und bei logischer Analyse nicht einfach von größeren Modellen kommen. Sie hängen ebenso von stärkerem Post-Training, besseren Reward-Signalen und mehr Rechenleistung bei der Inferenz ab. Die verschiedenen Unternehmen sind dieselbe Kernherausforderung – riesigen Sprachmodellen reichhaltiges und stabiles Feedback zu geben – jeweils auf ihre eigene Weise angegangen.
DeepSeek: Verifizierbare Rewards und GRPO
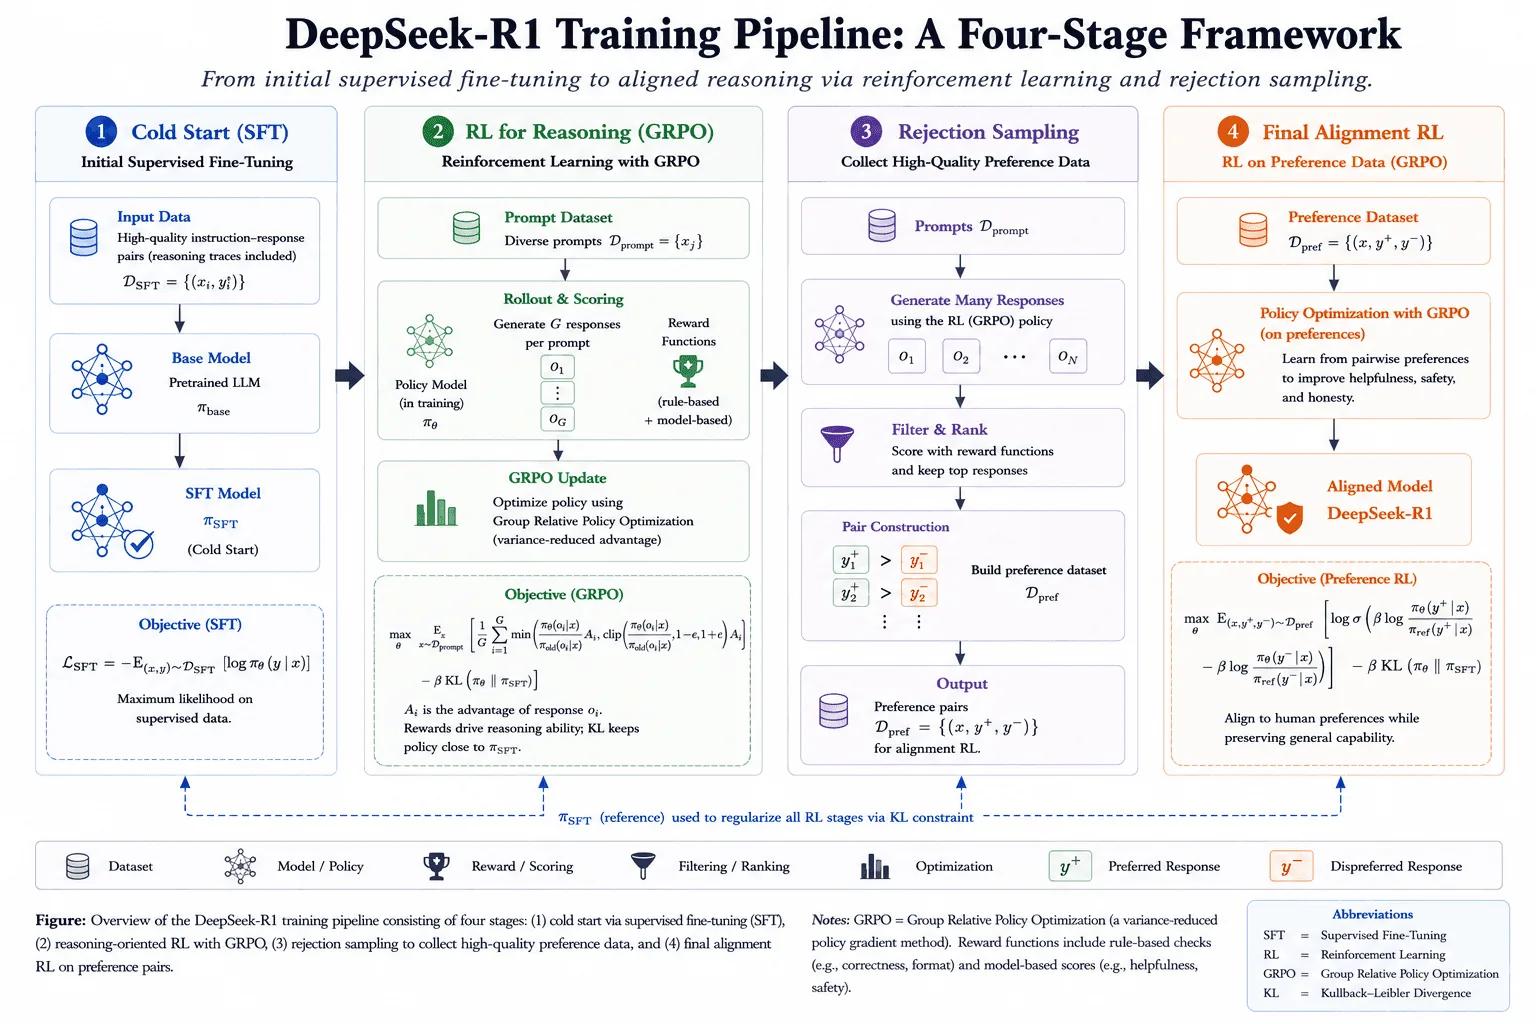
DeepSeek-R1 und sein Vorgänger DeepSeek-R1-Zero haben das RLVR-Paradigma weithin bekannt gemacht. Entgegen den seit InstructGPT etablierten Methoden zeigten die DeepSeek-Forschenden mit R1-Zero, dass fortgeschrittene Reasoning-Fähigkeiten in einem Basismodell durch großskaliges Reinforcement Learning entstehen können – ganz ohne vorgeschaltete Supervised-Fine-Tuning-Phase. Beim Training eines Modells mit 32 Milliarden Parametern (Qwen-32B-Base) über Zehntausende RL-Schritte entstanden spontan strukturierte Denkmuster, auch wenn diese anfangs etwas chaotisch waren und verschiedene Sprachen vermischten.
Die finale DeepSeek-R1-Pipeline ergänzte anschließend Cold-Start-Daten für das Supervised Training, Rejection Sampling und weitere Alignment-Stufen, um das Verhalten lesbarer, stabiler und in der Praxis nützlicher zu machen.
Um dieses Training zu stabilisieren und bis zum finalen DeepSeek-R1-Modell zu skalieren, setzte das Team einen speziellen Algorithmus namens Group Relative Policy Optimization (GRPO) ein. Anders als der alte PPO-Standard, der ein schweres „Critic“-Modell zur Berechnung der Baseline-Scores benötigte, ist GRPO deutlich schlanker. Es sampelt eine Gruppe unterschiedlicher Antworten auf denselben Prompt und bewertet sie relativ zueinander.
So entsteht ein Optimierungsziel, das schlechte Antworten im Vergleich zu den übrigen stark bestraft und gute belohnt, während die Updates begrenzt bleiben, um katastrophales Vergessen zu vermeiden. Dank dieser Effizienz konnte DeepSeek mit riesigen proprietären Modellen konkurrieren – mit nur einem Bruchteil der üblichen Rechenleistung.
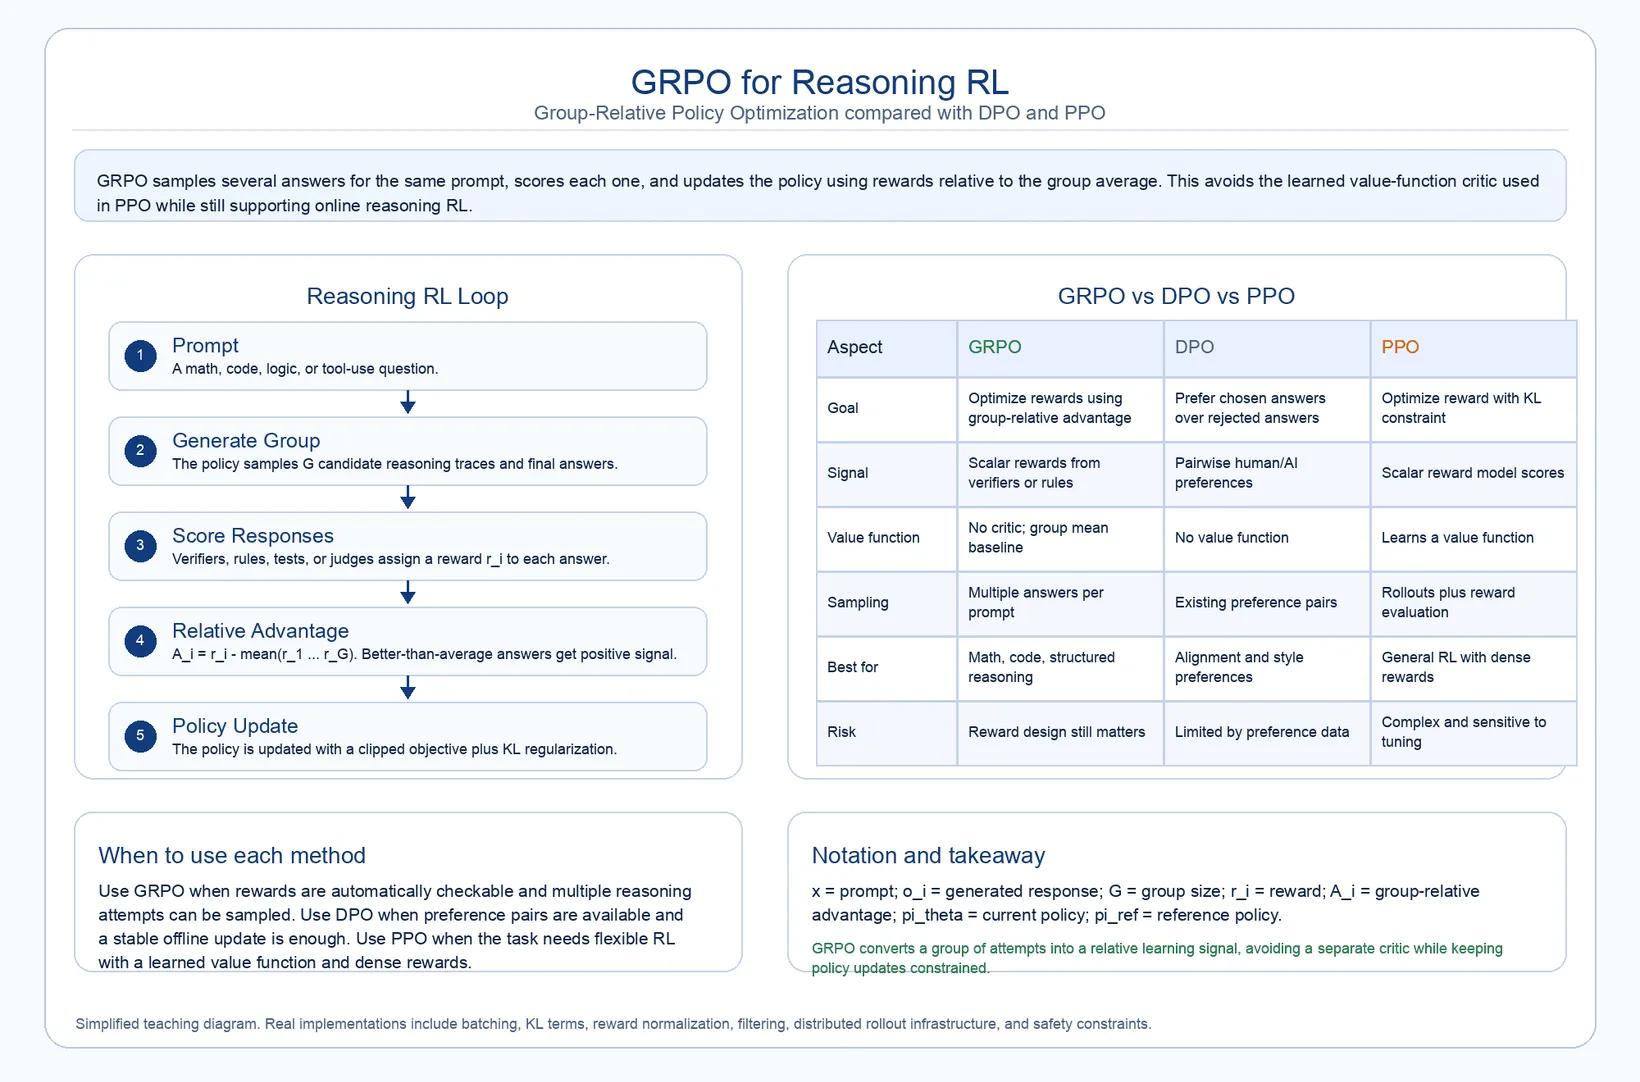
Der Erfolg von GRPO beruht vor allem auf Reinforcement Learning from Verifiable Rewards (RLVR). Statt sich auf menschliche Bewerter oder KI-Reward-Modelle zu verlassen (die sich leicht austricksen oder „hacken“ lassen), nutzte DeepSeek strikte, regelbasierte Rewards. Die beiden wichtigsten betreffen Korrektheit und Format. Der Korrektheits-Reward prüft, ob die finale Antwort exakt stimmt (etwa ob Code einen Unit-Test besteht). Der Format-Reward zwingt das Modell, seinen internen Denkprozess in strikte XML-Tags zu setzen, damit die Chain-of-Thought lesbar und strukturiert bleibt.
Diese Methode wurde später zu GRPO-$\lambda$ weiterentwickelt. Forschende stellten fest, dass eine strikte Bestrafung langer Antworten (um endloses Nachdenken zu verhindern) früh im Training zu plötzlichen Genauigkeitseinbrüchen führte. GRPO-$\lambda$ behebt das, indem die Strafe dynamisch angepasst wird: Liegt das Modell bei Fragen falsch, spielt die Länge vorübergehend keine Rolle, sodass es frei nach der Lösung suchen kann. Diese clevere Anpassung verbesserte die Genauigkeit auf anspruchsvollen Benchmarks wie AIME 2024 und GSM8K – und halbierte überraschenderweise gleichzeitig die durchschnittliche Antwortlänge.
OpenAI: Dynamisches Reasoning, Makora und Sicherheit
Das OpenAI-Ökosystem mit der „o“-Serie und späteren Frontier-Reasoning-Modellen hat Reinforcement Learning in Bereiche vorangetrieben, in denen Modelle vor der Antwort länger nachdenken müssen. OpenAI nutzt es nicht nur für abstraktes Denken, sondern auch zum Schreiben von Code für Hardwarebeschleuniger und zur besseren Abwehr von Cyberangriffen. Die Kernidee hinter Reasoning-Modellen beruht auf zweidimensionalen Skalierungsgesetzen: Die Genauigkeit eines Modells kann steigen, je mehr Rechenleistung ins RL-Training fließt und je mehr Zeit ihm beim Testen zum Nachdenken bleibt (Test-Time Compute).
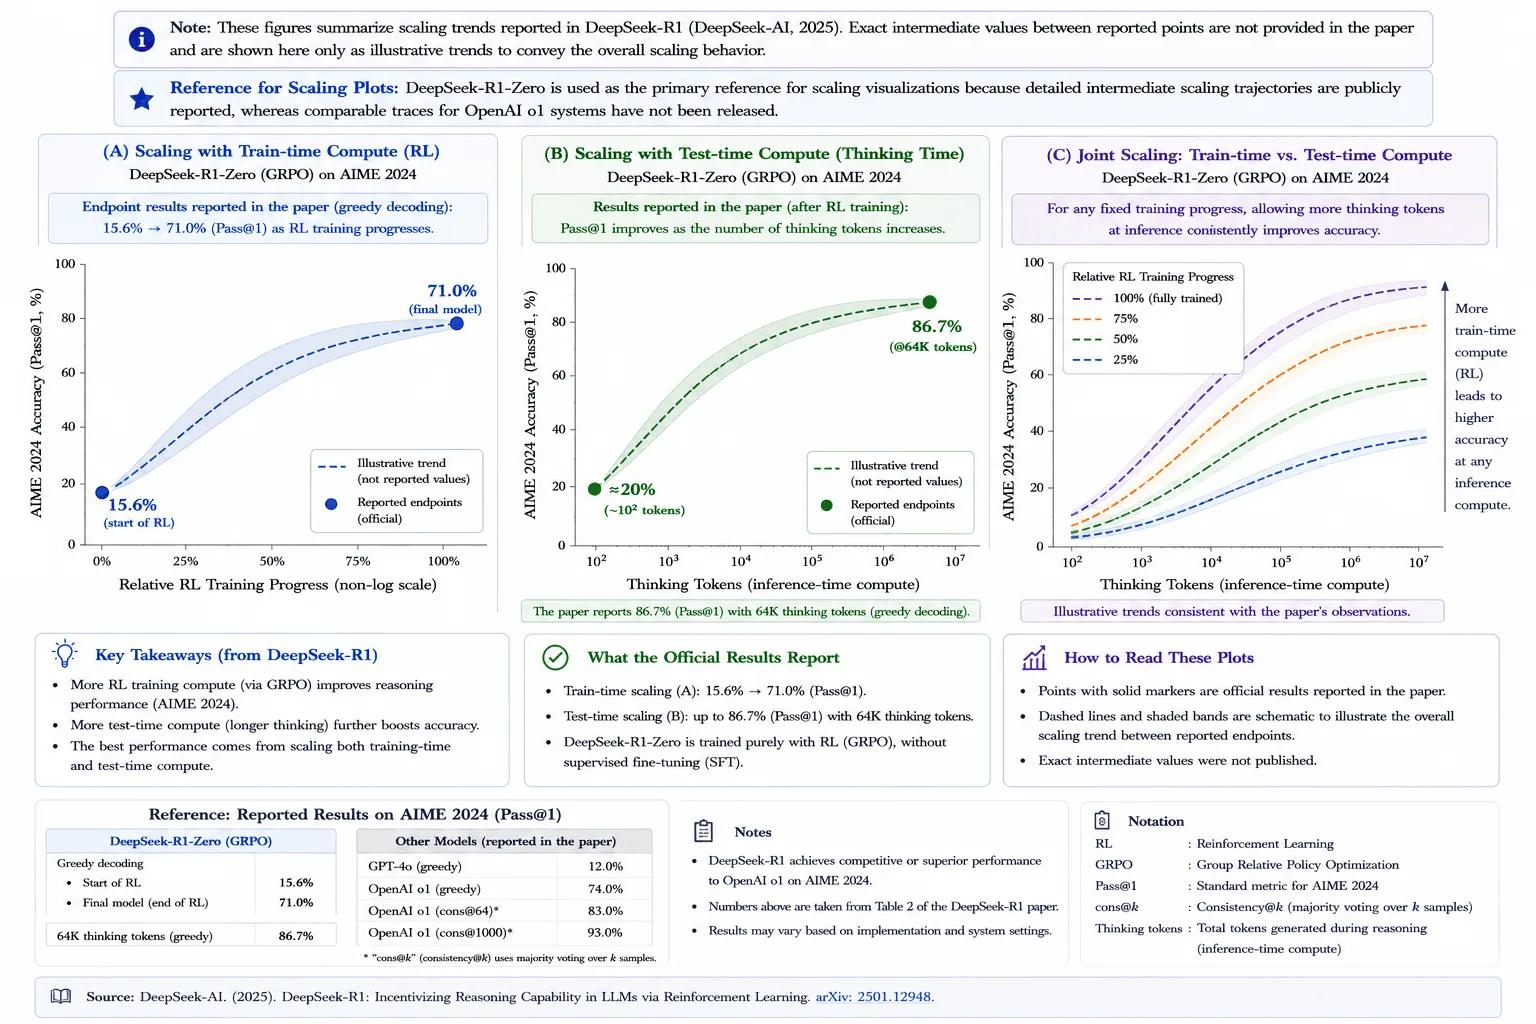
Diese Abbildung verwendet die Skalierungskurven von DeepSeek-R1-Zero als öffentlich verfügbaren Stellvertreter für die allgemeine Idee der Skalierung zur Trainings- und Testzeit. OpenAI hat für seine Reasoning-Modelle ein qualitativ ähnliches Verhalten beschrieben, aber keine vergleichbar detaillierten Zwischenkurven veröffentlicht.
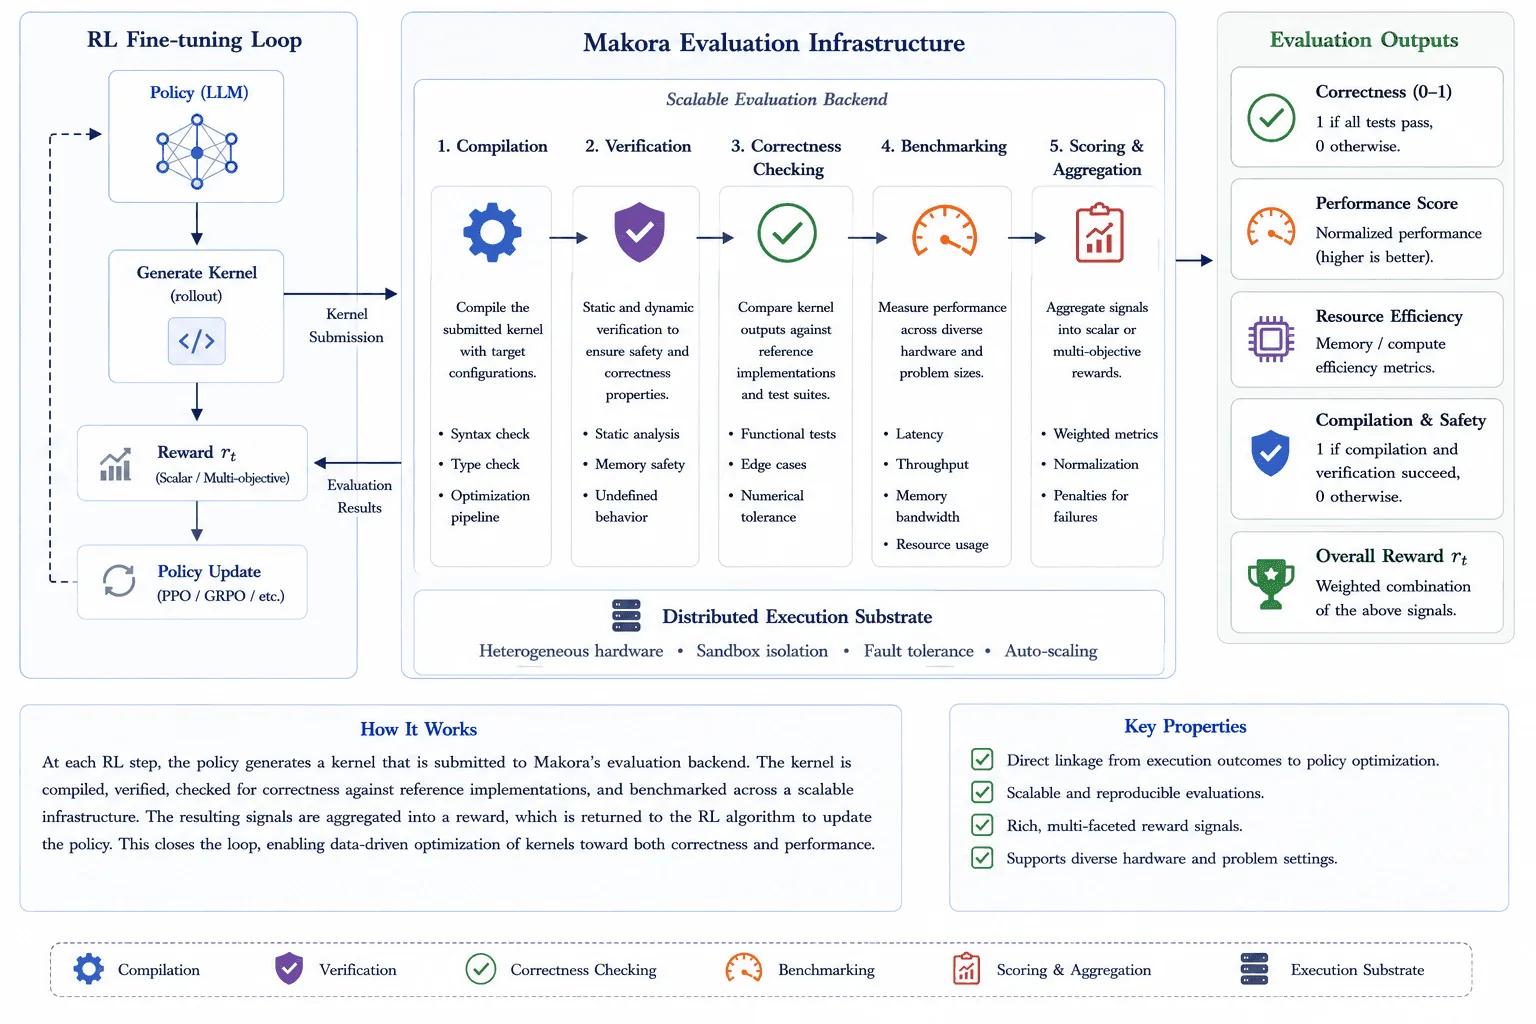
Die veröffentlichten Ergebnisse zeigen, warum dieses Paradigma so einflussreich wurde. Auf Mathematik- und Wissenschafts-Benchmarks scheinen intensives RL und zusätzliche Rechenleistung bei der Inferenz Reasoning-Modelle weit über gewöhnliche Chat-Modelle hinauszuheben. Die vielleicht spannendste Anwendung ist jedoch der Einsatz von RL in hochtechnischen Bereichen, in denen kaum oder gar keine menschlichen Trainingsdaten verfügbar sind. Mit einem Evaluierungssystem namens Makora behandelte OpenAI das Schreiben von Code-Kernels (hochoptimiertem Code für Hardware) als reines RL-Problem.
Das LLM schreibt einen Codevorschlag, der an ein Backend-System geschickt wird. Dieses kompiliert ihn, prüft, ob er funktioniert, und misst, wie schnell er läuft. Je schneller der Code, desto höher der Reward. So wurde der Kreis zwischen realer Softwareperformance und dem Lernen des Modells direkt geschlossen. Mit dieser Technik schrieb das Modell in der Mehrheit der Tests Code, der doppelt so schnell war wie der von Standard-Compilern.
Meta Llama 4: Asynchrone Optimierung und schlankes DPO
Metas Ansatz mit der Llama-4-Familie (Scout 17B, Maverick 17B und das Modell Behemoth 288B) zeigt einen anderen Weg, Online-Reinforcement-Learning für Open-Source-Modelle zu skalieren. Anders als ältere Modelle, die auf enorme Mengen überwachter Daten setzten, nutzt das berichtete Post-Training von Llama 4 eine schlanke, zielgerichtete Pipeline: ein wenig leichtgewichtiges SFT, gefolgt von intensivem Online-RL und abschließendem Feinschliff mit Direct Preference Optimization (DPO).
Die zentrale technische Idee im Post-Training von Llama 4 Maverick ist seine asynchrone RL-Infrastruktur. Normalerweise generieren Algorithmen wie PPO oder GRPO Text und aktualisieren das Modell auf demselben Serverknoten. Das erzeugt einen Engpass, weil die Trainings-GPUs untätig warten, bis die Rewards berechnet sind. Meta beschreibt, wie die Arbeitslast aufgeteilt wird, sodass die Reward-Berechnung unabhängig läuft – und die Zeit für die Auswertung komplexer Rewards wie Code-Tests verborgen bleibt.
In dieser Phase setzt Meta gezielt auf schwierige Prompts. Anschließend hilft die finale DPO-Schicht, den Ton zu verfeinern und Fälle zu reduzieren, in denen das Modell fälschlicherweise die Antwort auf eine harmlose Frage verweigert. Damit ist Llama 4 ein gutes Beispiel für einen hybriden Post-Training-Stack: RL für anspruchsvolleres Reasoning, danach Präferenzoptimierung für das nutzerseitige Verhalten.
Google Gemini Deep Think: Autonome Forschung und Aletheia
Das Ökosystem von Google DeepMind, insbesondere Gemini Deep Think und die zugehörigen Forschungsagenten, ist eines der deutlichsten Beispiele für Reinforcement Learning im wissenschaftlichen Reasoning mit langem Horizont. Während viele Modelle einzelne Antworten optimieren, organisieren Deep-Think-artige Systeme das Reasoning über autonome, mehrteilige Agenten. Das fortschrittlichste Beispiel ist der Mathematik-Agent Aletheia.
Aletheia nutzt für mathematische Beweise keine formalen Programmiersprachen, sondern arbeitet vollständig in natürlichem Englisch. Das System verwendet eine dreiteilige Reinforcement-Schleife: einen Generator, einen Verifier und einen Reviser. Bei einem schwierigen Theorem schreibt das Modell mögliche Lösungen aus. Entdeckt der Verifier einen kleinen Fehler, wird nicht gleich die ganze Antwort verworfen – stattdessen korrigiert der Reviser die Logik. Verworfen wird eine Antwort nur bei einem massiven, nicht behebbaren Fehler. Aletheia kann außerdem externe Suche und wissenschaftliche Literaturrecherche nutzen, um Aussagen zu validieren und keine erfundenen Zitate zu produzieren.
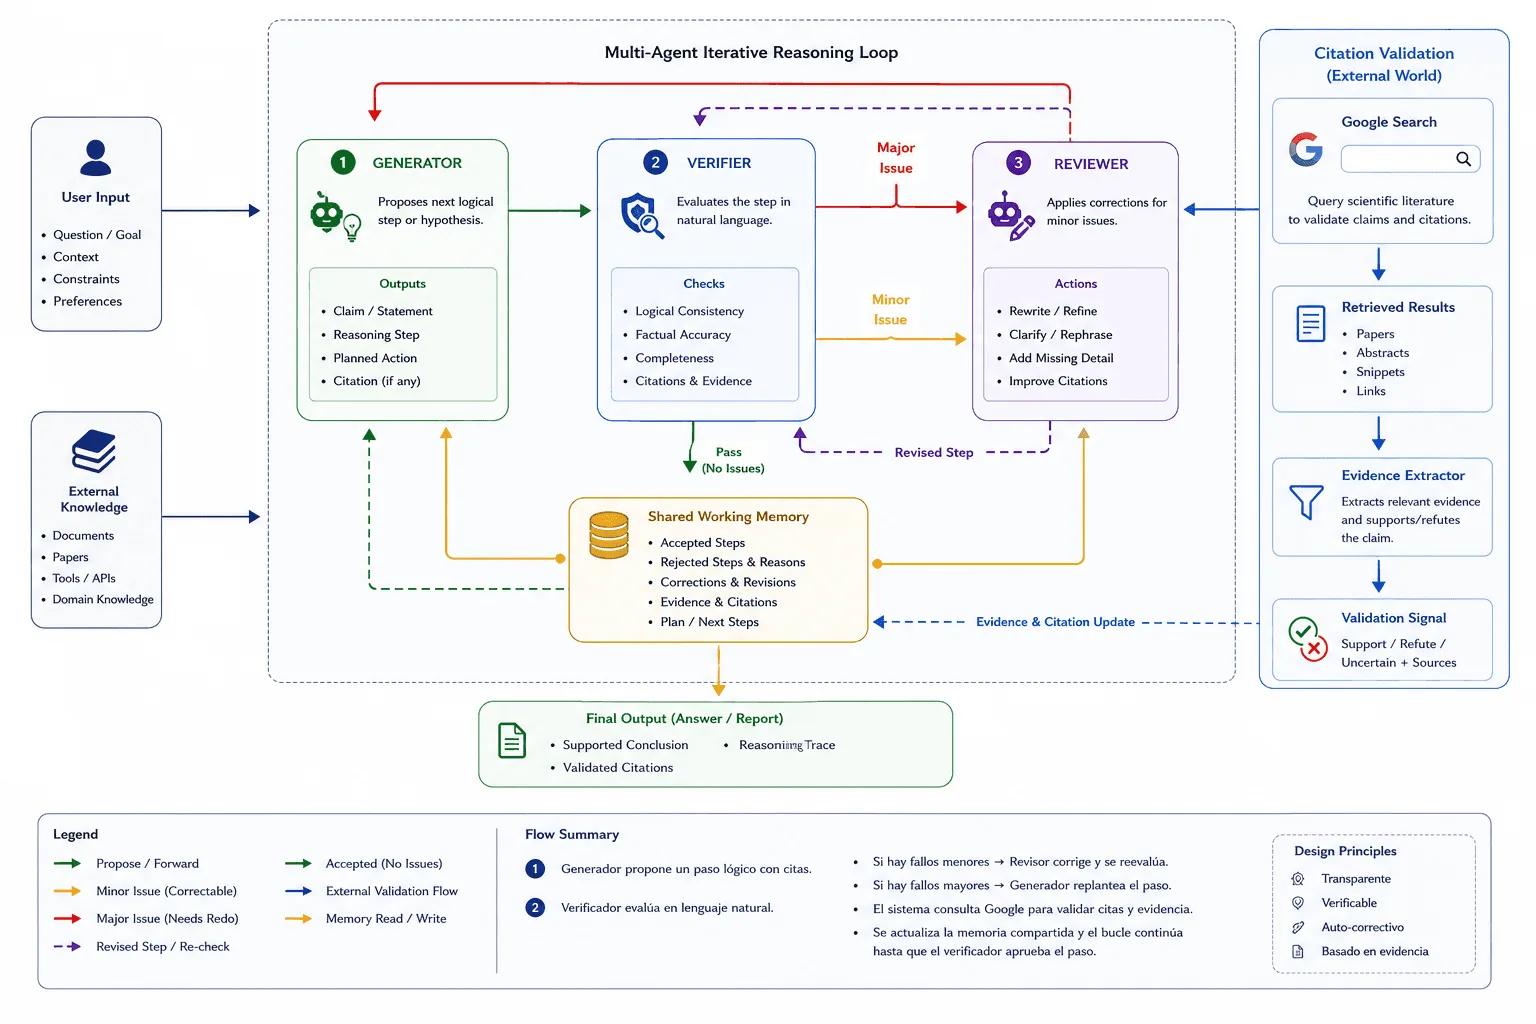
Die berichteten Ergebnisse von Aletheia deuten darauf hin, dass Verifier-Reviser-Schleifen natürlichsprachliche mathematische Beweissysteme weit über die gewöhnliche Generierung in einem Durchgang hinausbringen können – vor allem auf schwierigen Beweis-Benchmarks. Noch beeindruckender: Aletheia soll in der Lage sein, substanzielle mathematische Forschungsergebnisse zu erzeugen und Machine-Learning-Algorithmen zu untersuchen. Der entscheidende technische Punkt ist nicht nur der Score, sondern die Schleife: generieren, verifizieren, überarbeiten – und erst dann den Beweis akzeptieren.
Anthropic Claude: Formale Verfassungen und RLAIF
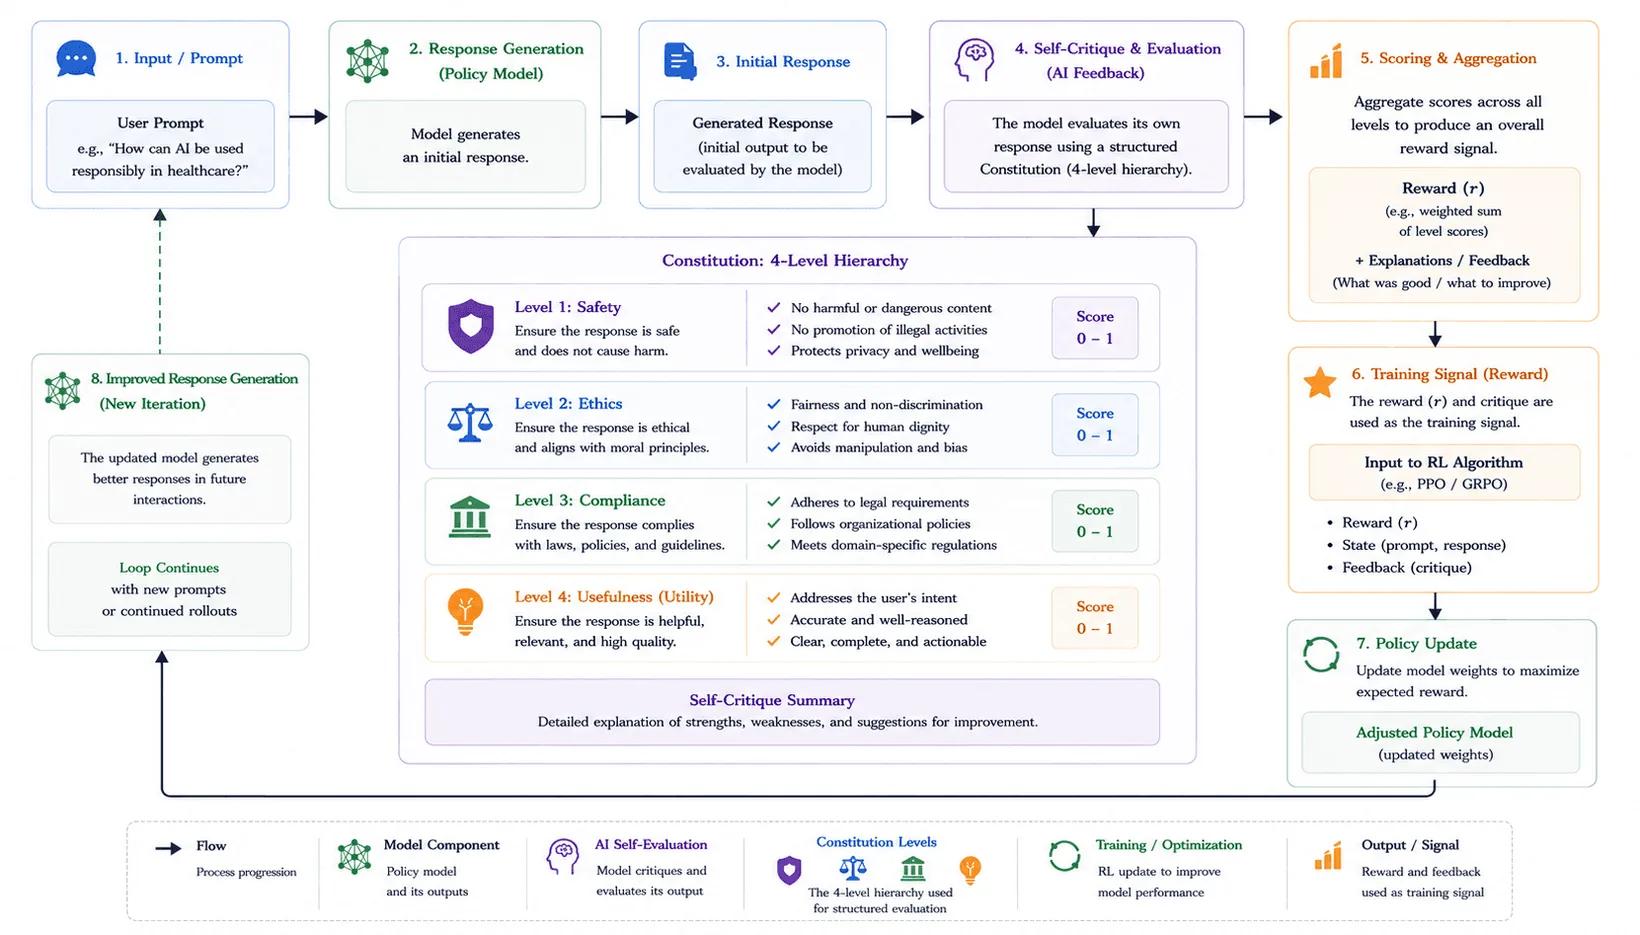
Anthropics Ansatz bei Claude 3.5 und Claude 4 setzt auf Constitutional AI. Statt Tausende menschliche Bewerter entscheiden zu lassen, welche Antwort besser ist – ein langsamer, voreingenommener und bei toxischen Inhalten belastender Prozess –, nutzt Anthropic ein KI-Modell, das sich an einem schriftlich festgelegten Regelwerk (einer „Verfassung“) orientiert.
Bei dieser Methode, Reinforcement Learning from AI Feedback (RLAIF), generiert das Modell eine Antwort, kritisiert sich anhand expliziter Regeln (etwa Menschenrechte und Nützlichkeitsprinzipien) selbst und schreibt seine Ausgabe so um, dass sie den Regeln entspricht. Diese überarbeiteten Antworten dienen dann zur Aktualisierung des Modells. Die Evidenz zeigt, dass diese regelbasierte Technik klassische Human-Feedback-Methoden erreicht oder übertrifft. Vor allem sorgt sie dafür, dass die Grundwerte des Modells transparent, leicht auditierbar und schnell aktualisierbar sind – ohne monatelanges Sammeln menschlicher Daten.
Ende Januar 2026 veröffentlichte Anthropic ein umfassendes Update dieses Frameworks: „Claude’s New Constitution“. Mit dem Wechsel von einem einfachen regelbasierten Ansatz zu einem stärker begründungsbasierten Alignment-Dokument legt es eine Prioritätenhierarchie rund um Sicherheit, Ethik, Compliance und Hilfsbereitschaft fest. Die Verfassung löst das Alignment-Problem nicht auf magische Weise. Ihre Aufgabe ist es, den Kritikrahmen zu definieren, mit dem Antworten während Training und Evaluierung generiert, gefiltert und gerankt werden. Durch die Veröffentlichung hat Anthropic seine Alignment-Philosophie zudem leichter überprüfbar und diskutierbar gemacht.
Moonshot AI Kimi: RL für nicht verifizierbare Aufgaben skalieren
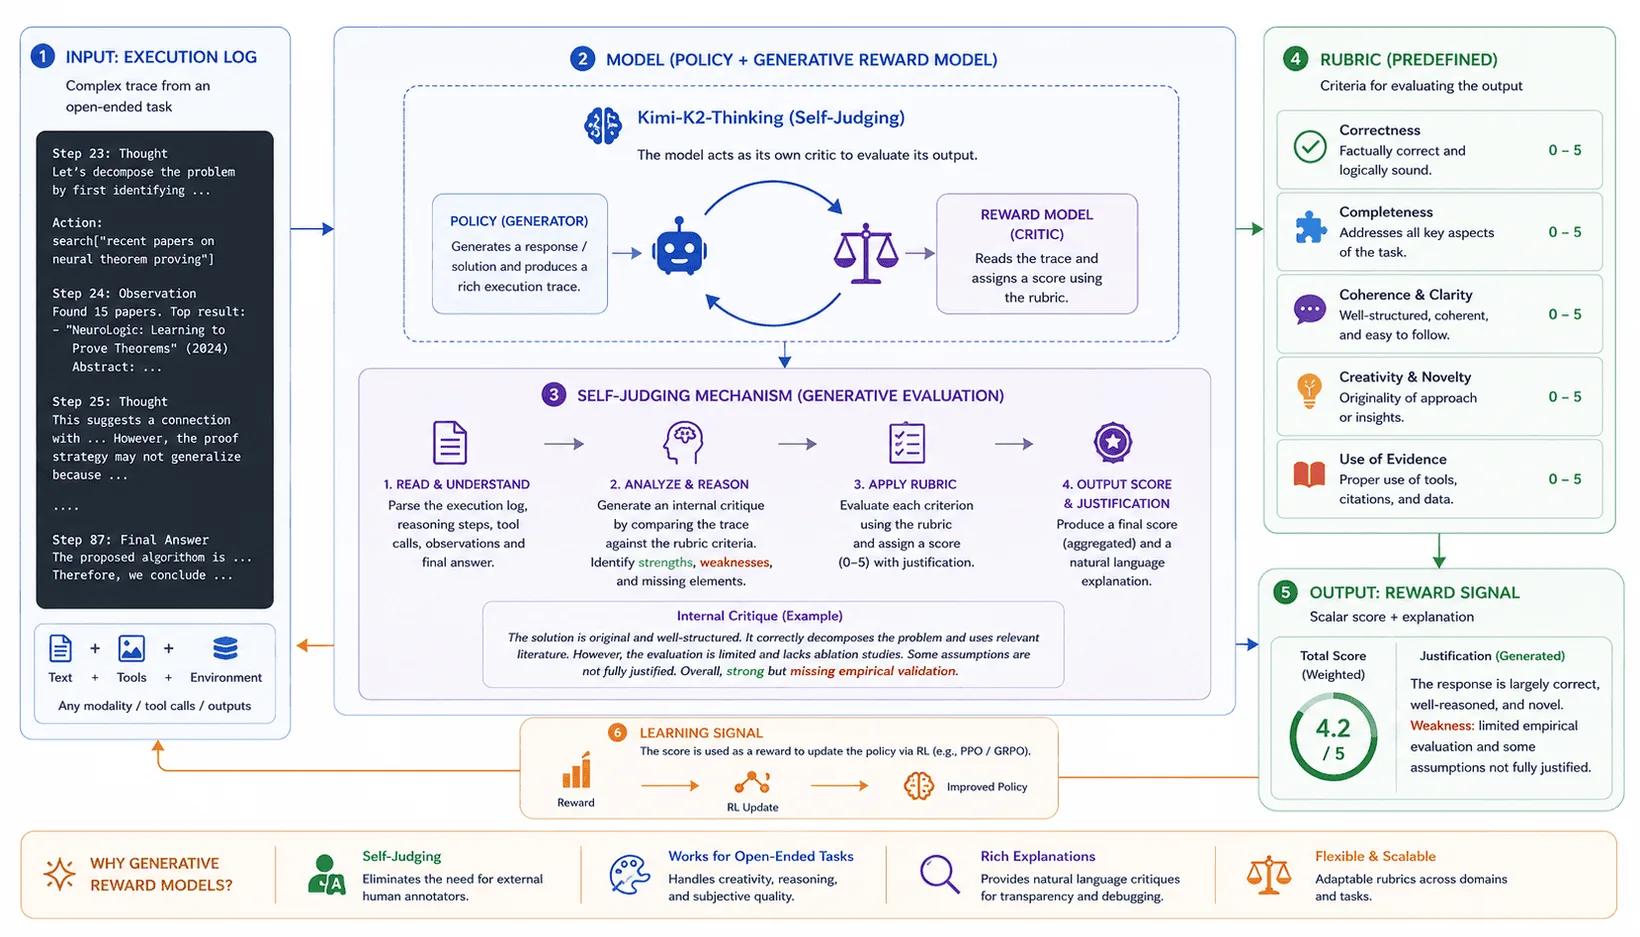
Moonshot AI brachte Kimi k1.5 und K2 auf den Markt und verschob damit die Grenzen dessen, was RL jenseits von Mathematik und Programmierung leisten kann. Die größte Herausforderung für RL war lange die Bewertung nicht verifizierbarer Aufgaben – etwa kreatives Schreiben, das Zusammenführen von Suchergebnissen oder die Erstellung komplexer Berichte –, bei denen es keine absolut „richtige“ oder „falsche“ Antwort gibt. Moonshot löste das, indem es Generative Reward Models (GRMs) systematisch über ein breites Spektrum agentischer Verhaltensweisen hinweg einsetzte. Statt einfacher skalarer Scores nutzt Kimi einen LLM-basierten „Log-Judge“ (z. B. Kimi-K2-Thinking), der offene Generierungen anhand eines Selbstkritik-Rasters bewertet und beispielsweise entscheidet, ob ein Ausführungslog belegt, dass ein Software-Patch ein Fehlermuster tatsächlich beseitigt hat.
Darüber hinaus stellte Moonshot AI fest, dass die Erweiterung des Kontextfensters auf 128k Tokens während der RL-Phase es dem Modell ganz natürlich ermöglicht, über autoregressive Vorhersagen implizite Suchen im Reasoning-Raum durchzuführen. Daraus entstand ein einfaches, aber wirkungsvolles RL-Framework. Weil das Modell den riesigen Kontext zum Planen, Reflektieren und Selbstkorrigieren nutzen kann, erzielt Kimi starke Ergebnisse bei Mathematik-, Coding- und Vision-Language-Reasoning-Aufgaben – ohne rechenintensive Architekturkniffe wie Monte Carlo Tree Search (MCTS) oder klassische Process Reward Models (PRMs).
Mistral AI: Magistral und mehrsprachiges Reasoning
Anfang 2025 stieg Mistral AI mit Magistral, seinem ersten nativen Reasoning-Modell, in das Rennen um Frontier-Reasoning ein. Das Modell erschien sowohl als Open-Source-Version (Magistral Small, 24B Parameter) als auch als leistungsstärkere Enterprise-Version (Magistral Medium) und legt einen klaren Schwerpunkt auf domänenspezifische und mehrsprachige Chain-of-Thought.
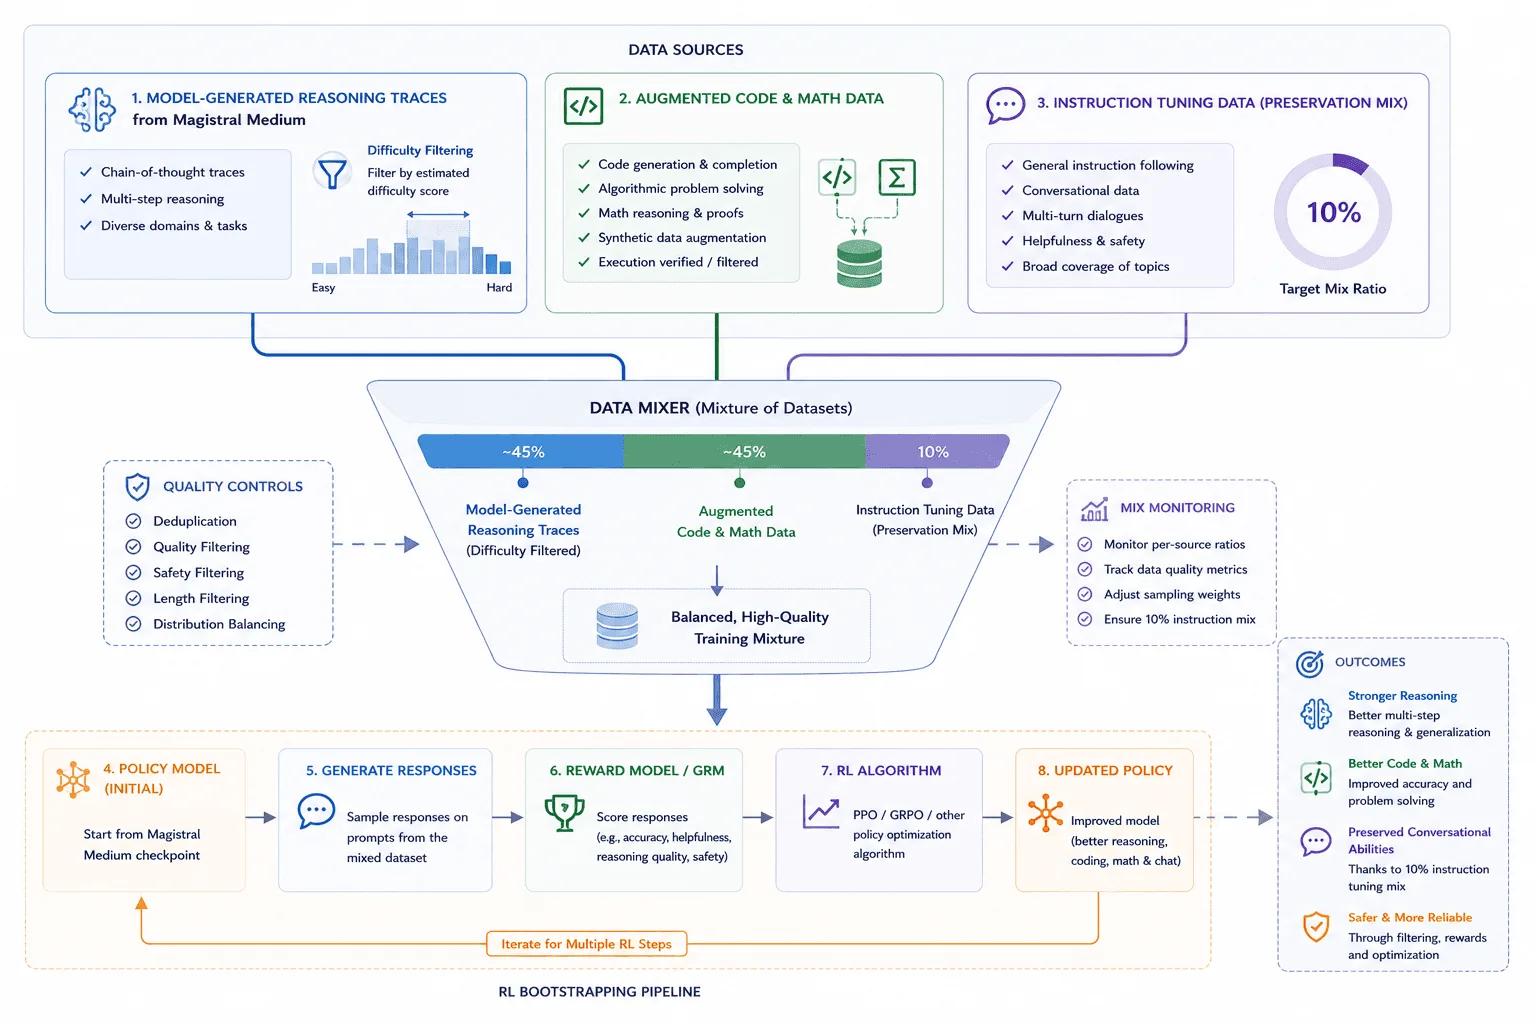
Mistrals Ansatz unterscheidet sich von Labs, die vollständig auf die Destillation von Traces aus größeren, geschlossenen Modellen setzen. Magistral wurde als reasoning-orientierte Erweiterung von Mistrals Frontier-Modellfamilie vorgestellt, wobei Reinforcement Learning eine zentrale Rolle im Post-Training spielt. Für das hocheffiziente Magistral Small nutzte Mistral eine ausgefeilte Bootstrapping-Pipeline: Reasoning-Traces wurden mit dem Medium-Modell generiert, so gefiltert, dass ein gemischter Schwierigkeitsgrad erhalten blieb, mit Teilmengen aus OpenThoughts und OpenR1 angereichert und mit allgemeinen Instruction-Tuning-Daten kombiniert, damit das Modell seine Gesprächsfähigkeiten jenseits des Reasonings nicht verliert. Das vielleicht markanteste Merkmal ist die native Mehrsprachigkeit: Das Modell ist darauf trainiert, sowohl seine Reasoning-Traces als auch die finalen Antworten in der vom Nutzer gewünschten Sprache zu erzeugen – ein Beleg dafür, dass fortgeschrittenes Reasoning nicht ausschließlich auf Englisch stattfinden muss.
Grenzen und offene Fragen
Der moderne RL-Stack ist leistungsfähig, aber keine saubere Lösung für Reasoning. Die erste Grenze ist Reward Hacking: Findet ein Modell einen Weg, den Reward zu erfüllen, ohne die eigentliche Aufgabe zu lösen, verstärkt RL genau diese Abkürzung. Besonders gefährlich ist das, wenn der Bewerter ein anderes Modell ist statt eines deterministischen Tests.
Die zweite Grenze ist Benchmark-Overfitting. Mathematik-, Coding- und Reasoning-Benchmarks sind nützlich, weil sie klares Feedback liefern – doch genau diese Klarheit macht es auch leichter, gezielt auf sie hin zu optimieren. Ein Modell kann sich auf einem Benchmark verbessern, ohne bei unübersichtlichen Aufgaben aus der Praxis im gleichen Maß robuster zu werden.
Die dritte Grenze: Verifizierbare Rewards sind ungleich verteilt. Code, Mathematik und strukturierte Ausgaben lassen sich oft automatisch prüfen. Offene Forschung, lange Texte, Produktplanung und wissenschaftliche Exploration sind dagegen viel schwerer zu bewerten. Für solche Aufgaben stützen sich Labs weiterhin auf Bewertungsraster, Modell-Judges, menschliche Reviews oder indirekte Signale aus der Umgebung.
Hinzu kommt ein Kostenproblem. Test-Time Compute kann die Genauigkeit verbessern, indem das Modell intensiver sampelt, überarbeitet und prüft – erhöht aber Latenz und Betriebskosten. Deshalb lassen sich die stärksten Reasoning-Modi nur schwer flächendeckend einsetzen.
Schließlich wirft verborgene Chain-of-Thought ein Audit-Problem auf. Viele Frontier-Systeme nutzen möglicherweise lange interne Reasoning-Traces, ohne sie direkt offenzulegen. Das kann für Sicherheit und Nutzererlebnis von Vorteil sein, erschwert es Außenstehenden aber, nachzuvollziehen, was das Modell durch RL tatsächlich gelernt hat.
Fazit
Die Fallstudien zu OpenAI, DeepMind, Meta, DeepSeek, Mistral, Moonshot und Anthropic legen nahe, dass sich die Entwicklung von Frontier-KI von rein statischem Pre-Training hin zu einem interaktiveren Post-Training-Stack verlagert hat. Verifizierbare Rewards, Online-Optimierung, KI-Feedback, Selbstdestillation, Tool-Umgebungen und Test-Time Compute wirken heute zusammen, um zu prägen, wie Modelle denken.
Modelle lernen nicht mehr nur Muster aus dem Internet auswendig. Die stärksten Systeme werden darauf trainiert und angeleitet, mehr Rechenleistung in das Prüfen von Mathematik, das Debuggen von Code, die Nutzung von Tools, das Überarbeiten von Plänen und die Validierung von Zwischenschritten zu investieren. Reinforcement Learning ist nicht die einzige Zutat dieses Wandels, aber es ist zu einem der zentralen Mechanismen geworden, die rohe Sprachmodelle in Systeme verwandeln, die suchen, verifizieren und ihre eigenen Antworten verbessern können.
Literaturverzeichnis
Grundlagen: RLHF, DPO und KI-Feedback
Ouyang et al., 2022. Training language models to follow instructions with human feedback. Das InstructGPT-Paper, das die klassische Alignment-Pipeline SFT -> Reward-Modell -> PPO etablierte.
Bai et al., 2022. Constitutional AI: Harmlessness from AI Feedback. Anthropics ursprüngliches Paper zu RLAIF bzw. Constitutional AI.
Rafailov et al., 2023. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Das zentrale DPO-Paper – hilfreich, um Offline-Präferenzoptimierung ohne explizites Reward-Modell-Training zu verstehen.
Anthropic, 2023. Claude's Constitution. Öffentliche Fassung der Prinzipien, die Claudes konstitutionelle Kritik steuern.
Anthropic, 2026. Claude's New Constitution. Aktualisierte öffentliche Verfassung und hilfreicher Kontext für den Wandel von Regellisten hin zu einem breiteren, begründungsbasierten Alignment.
Reasoning-RL und verifizierbare Rewards
OpenAI, 2024. Learning to Reason with LLMs. Primärquelle von OpenAI zu Reasoning im Stil von o1, RL-Training und Test-Time Compute.
DeepSeek-AI, 2025. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. Primärquelle zu DeepSeek-R1, DeepSeek-R1-Zero, GRPO und Reasoning-Training im Stil von RLVR.
Yue et al., 2025. Stable Reinforcement Learning for Efficient Reasoning. Stellt GRPO-$\lambda$ vor und behandelt die Stabilisierung von Längenstrafen im Reasoning-RL.
Moonshot AI, 2025. Kimi k1.5: Scaling Reinforcement Learning with LLMs. Primärquelle zu Kimis Long-Context-RL und Skalierungsansatz.
Label Studio, 2025. Reinforcement Learning from Verifiable Rewards. Sekundäre Erklärung von RLVR; nützlich als leicht zugänglicher konzeptioneller Überblick, nicht als Hauptquelle für Belege.
Fallstudien zu Frontier-Modellen
Meta AI, 2025. The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation. Primärquelle zu den Post-Training-Angaben für Llama 4, darunter leichtgewichtiges SFT, Online-RL und DPO-Feinschliff.
Mistral AI, 2025. Magistral. Primärquelle zu Mistrals Reasoning-Modellfamilie, dem Fokus auf mehrsprachiges Reasoning und dem RL-/Post-Training-Ansatz.
Google DeepMind, 2026. Accelerating Mathematical and Scientific Discovery with Gemini Deep Think. Primärquelle von DeepMind zu Gemini Deep Think und seinen Fähigkeiten im wissenschaftlichen Reasoning.
Feng et al., 2026. Towards Autonomous Mathematics Research. Forschungspaper, das Aletheia als auf Gemini Deep Think basierenden Agenten für mathematische Forschung beschreibt.
Feng et al., 2026. Aletheia tackles FirstProof autonomously. Nachfolgende Evaluierung von Aletheia in der FirstProof-Challenge.
Tehrani et al., 2026. Fine-Tuning GPT-5 for GPU Kernel Generation. Makora-Paper zum RL-Fine-Tuning für die Generierung von GPU-Kernels mit verifizierbaren Rewards.
Makora, 2026. We RL'd GPT-5 to Write Better Kernels. Begleitender Blogbeitrag zur RL-Arbeit von Makora an GPU-Kernels.
Hilfreicher Hintergrund und weiterführende Literatur
Decode the Future, 2024. RLHF explained. Leicht zugänglicher Hintergrund zu RLHF für alle, die einen weniger technischen Einstieg suchen.
Le Wagon, 2025. OpenAI o1 and o3 explained: how thinking models work. Sekundärer Überblick über Konzepte von Reasoning-Modellen; hilfreich für ein intuitives Verständnis, aber weniger belastbar als Primärquellen zu Modellen und Papers.
