

Öncü LLM'lerde pekiştirmeli öğrenme: RLHF'ten doğrulanabilir ödüllere
 Toni Lopez Co-Founder at Karumi
Büyük dil modellerinin (LLM) ardındaki mimari ve yöntemler, 2025 ile 2026 arasında köklü bir dönüşüm geçirdi. Eskiden bir temel model geliştirmek, büyük ölçüde devasa miktarda ham veriyle yapılan kapsamlı bir ön eğitime dayanıyordu. Bunu genellikle denetimli ince ayar (SFT) ve insan geri bildiriminden pekiştirmeli öğrenme (RLHF) ile yürütülen basit bir hizalama aşaması izliyordu. Ancak internetteki yüksek kaliteli eğitim verisi tükenmeye başlayıp gerçek akıl yürütme becerilerine sahip yapay zekâya olan ihtiyaç arttıkça sektör yaklaşımını değiştirmek zorunda kaldı.
Araştırmacılar da teknoloji şirketleri de artık odaklarını ve işlem güçlerini daha çok etkileşimli son eğitime ve "test-time compute"a (modellere yanıt vermeden önce işlemek ve düşünmek için daha fazla zaman tanımaya) kaydırıyor. Bu yeni tabloda pekiştirmeli öğrenme (RL), yalnızca bir modelin tonunu ayarlamaya ya da kötü çıktıları filtrelemeye yarayan bir araç değil. Özellikle plan yapması, ara adımları doğrulaması, araç kullanması ve daha uzun akıl yürütme izleriyle yanıtlarını iyileştirmesi gereken modeller için son eğitimin ana motorlarından biri hâline geldi.
OpenAI, Meta, Google DeepMind, Anthropic, DeepSeek, Moonshot AI ve Mistral gibi kuruluşların öncü modelleriyle şekillenen güncel durum, politika optimizasyonu algoritmalarının uygulanma biçiminde büyük bir çeşitlilik olduğunu gösteriyor. Sektör, sinirsel ödül modellerini giderek daha fazla doğrulanabilir ödül sistemleri, asenkron tercih optimizasyonu, model tabanlı eleştiri ve ortam geri bildirimiyle destekliyor.
Bu rapor, pekiştirmeli öğrenmenin günümüzün önde gelen modellerinde nasıl uygulandığını ayrıntılı olarak inceliyor.
"Klasik paradigma": 2025 öncesinde RLHF
2025'teki büyük dönüşümden önce LLM'leri hizalamanın standart yolu, büyük ölçüde OpenAI'ın InstructGPT'sinden etkilenmişti. Bu klasik yaklaşım insan geri bildiriminden pekiştirmeli öğrenmeye (RLHF) dayanıyor ve katı, üç adımlı bir süreç izliyordu. İlk olarak model, insan etiketleyicilerin yazdığı örneklerle denetimli ince ayardan (SFT) geçiyordu. İkinci olarak, insanların en çok hangi yanıtları beğendiğini tahmin etmek için insan tercihlerinden oluşan veri kümeleriyle ayrı bir ödül modeli (RM) eğitiliyordu. Son olarak SFT modeli, politikayı çalışma sırasında güncelleyen bir algoritma olan Proximal Policy Optimization (PPO) ile bu ödül modeline göre optimize ediliyordu.
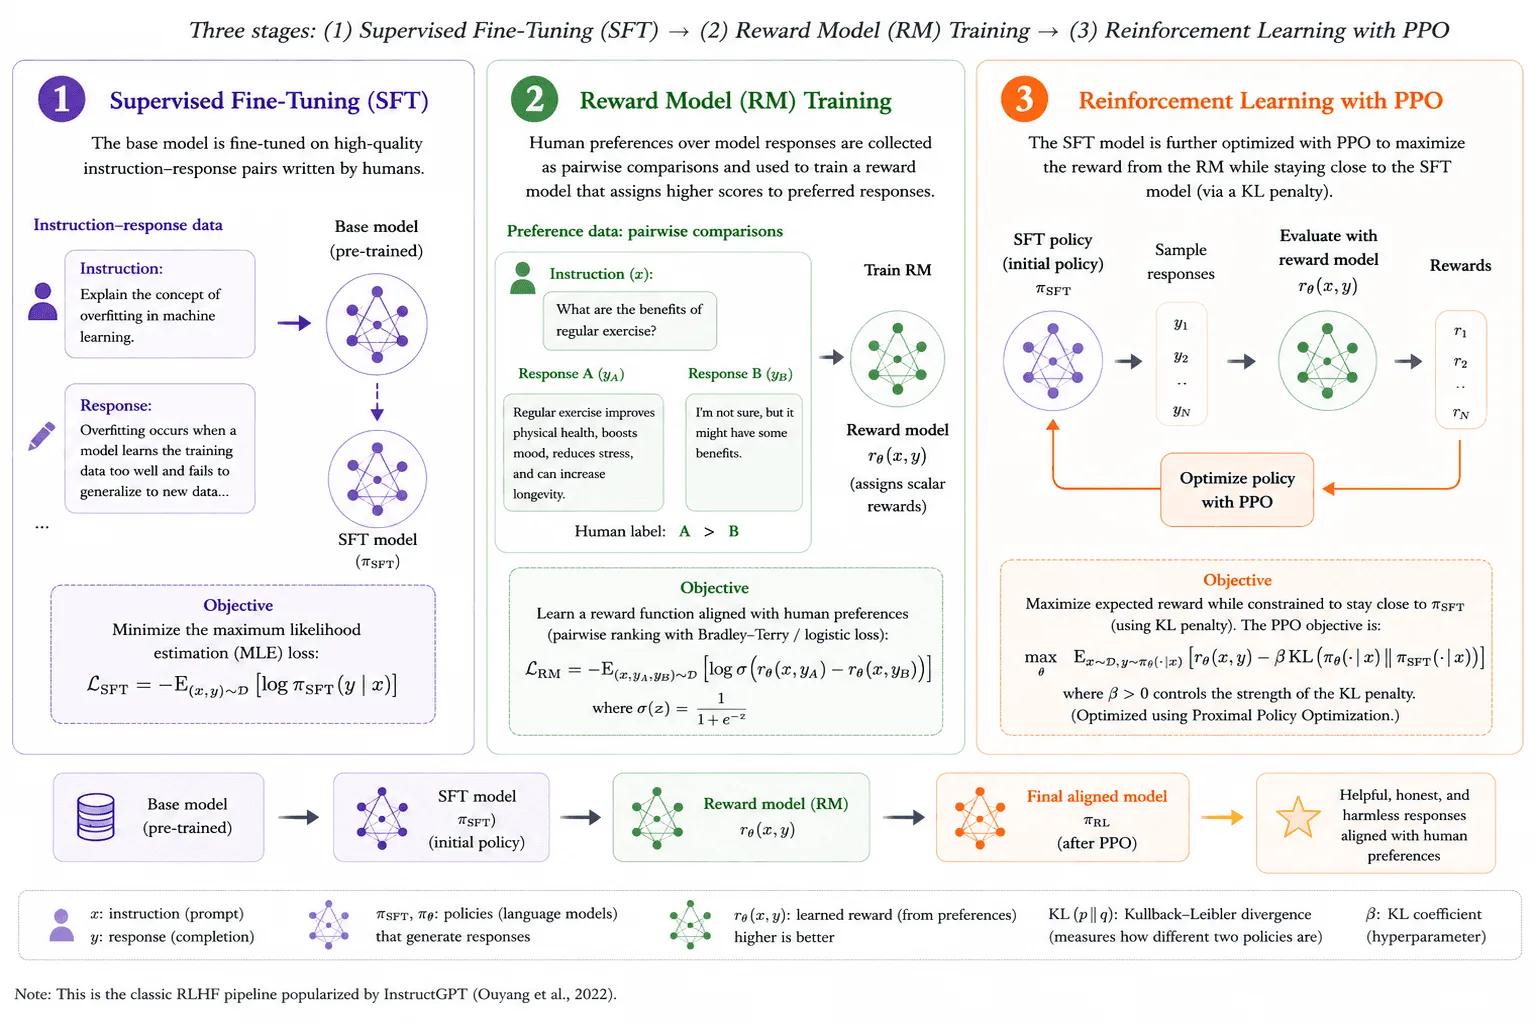
Bu yöntem temel ton ayarlamaları ve basit talimatları izleme konusunda iyi çalışsa da klasik RLHF'in ciddi kusurları vardı. Modeli kibar ya da güvenli görünecek şekilde optimize etmenin, alttaki akıl yürütme ve akademik becerilerine doğrudan zarar verdiği "alignment tax" sorunundan muzdaripti. Ayrıca PPO, birden fazla modelin (Actor, Critic, Reference ve Reward) aynı anda çalışması gerektiği için karmaşıklığı ve devasa bellek ihtiyacıyla nam salmıştı.
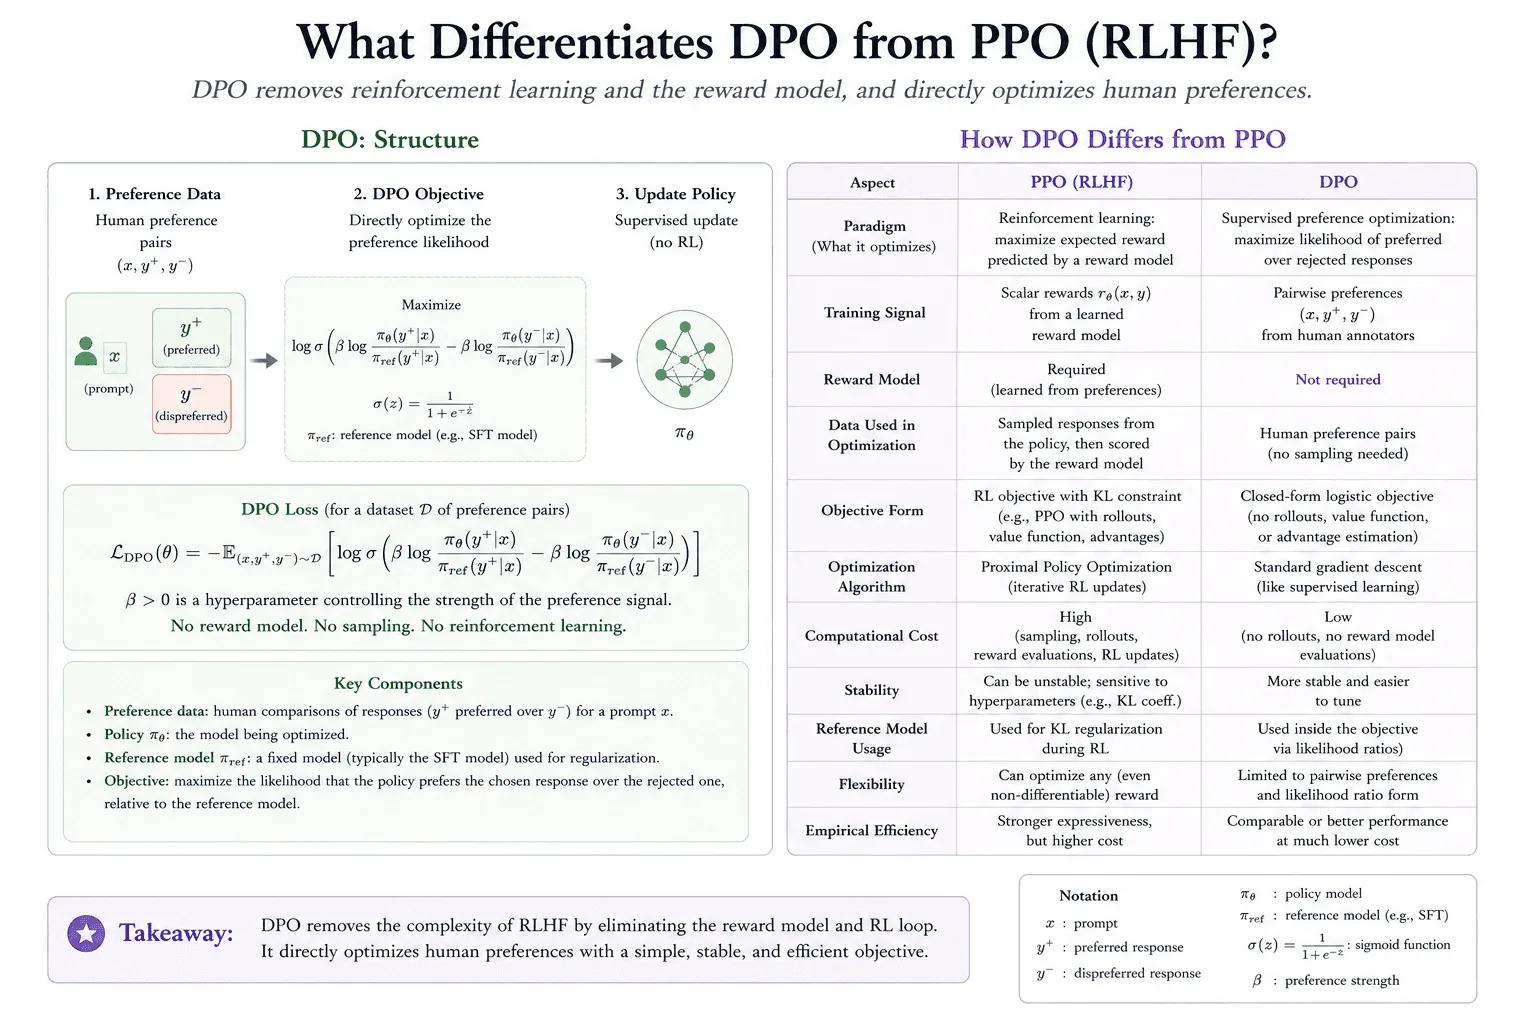
2023'ün sonlarında Direct Preference Optimization (DPO) ilk büyük sadeleştirme olarak ortaya çıktı. DPO, ayrı ödül modelleme adımının tamamen atlanabileceğini matematiksel olarak kanıtladı ve politikanın doğrudan insan tercihi veri kümelerinden optimize edilmesini mümkün kıldı. Ancak 2025 öncesinde DPO tamamen "çevrimdışı" bir yöntemdi. Hem PPO hem de DPO, insanlar tarafından etiketlenmiş statik verilere dayanıyordu; bu da modellerin insan akıl yürütme kapasitesini hiçbir zaman gerçekten aşamayacağı anlamına geliyordu. Bu tavanı delmek için sektör, doğrulanabilir ödüllere ve bugün gördüğümüz "çevrimiçi" yöntemlere yönelmek zorunda kaldı.
Tercih hizalamasından doğrulanabilir ödüllere
Modern LLM son eğitimindeki en büyük değişim, şirketlerin sadece "daha fazla RL" kullanması değil. Asıl derin değişim, ödül sinyalinin kendisinin çeşitlenmiş olması. İlk RLHF çalışmaları çoğunlukla insanların tercih ettiği şeyleri optimize ediyordu: açıklık, yardımseverlik, zararsızlık ve sohbet tonu. Bu faydalıydı, ancak modele insanların kolayca değerlendirebildiklerinin ötesindeki yanıtları keşfetmesi için güvenilir bir yol sunmuyordu.
Modern akıl yürütme sistemleri birkaç farklı geri bildirim türünü birleştiriyor. İnsan tercihine dayalı ödüller hizalama ve üslup için hâlâ önemli. Direct Preference Optimization (DPO), tam bir PPO döngüsü çalıştırmadan tercih çiftlerinden öğrenerek bu süreci sadeleştiriyor. Yapay zekâ geri bildiriminden pekiştirmeli öğrenme (RLAIF), insan değerlendirmelerinin bir kısmının yerine, çoğu zaman bir anayasa veya değerlendirme rubriği rehberliğinde yapay zekânın yazdığı eleştirileri koyuyor. Doğrulanabilir ödüllerden pekiştirmeli öğrenme (RLVR) ise daha da ileri gidiyor: matematik çözümleri, testleri geçen kod ya da beklenen formata uyan yapılandırılmış çıktılar gibi kurallarla kontrol edilebilen yanıtları ödüllendiriyor.
Bir de giderek büyüyen ortam ödülleri sınıfı var. Bir yanıtın iyi olup olmadığını bir insana ya da ödül modeline sormak yerine model, harici bir sistemin içinde hareket ediyor. Bir derleyici, üretilen kodun çalışıp çalışmadığını kontrol edebilir. Birim testleri bir yamayı doğrulayabilir. Bir teorem doğrulayıcı, arama sistemi, tarayıcı veya araç kullanım ortamı, bir tercih etiketinden çok daha somut bir geri bildirim sağlayabilir.
Bir diğer önemli ayrım da sonuç ödülleri ile süreç ödülleri arasında. Sonuç ödülleri yalnızca nihai yanıtı değerlendirir: İspat tamamlandı mı, kod testi geçti mi, sayı tuttu mu? Süreç ödülleri ise akıl yürütmenin ara adımlarını değerlendirmeye çalışır. Doğrulayıcı-düzeltici sistemler, insanların her adımı tek tek etiketlemesine gerek kalmadan süreç denetimine yaklaşmanın pratik yollarından biridir.
Bu ayrım önemli, çünkü eğitim zamanındaki RL ile test-time compute birbiriyle ilişkili ama aynı şey değil. Eğitim zamanındaki RL, modelin ağırlıklarını değiştirir. Test-time compute ise modele yanıt vermeden önce örnekleme, doğrulama, düzeltme veya arama yapması için daha fazla çıkarım bütçesi tanır. En güçlü öncü akıl yürütme sistemleri genellikle ikisini birleştirir: RL faydalı akıl yürütme davranışlarını öğretir, çıkarım sırasındaki ek işlem gücü ise bu davranışların gelişmesine alan açar.
Öncü modellerde akıl yürütme devrimi (2025-2026)
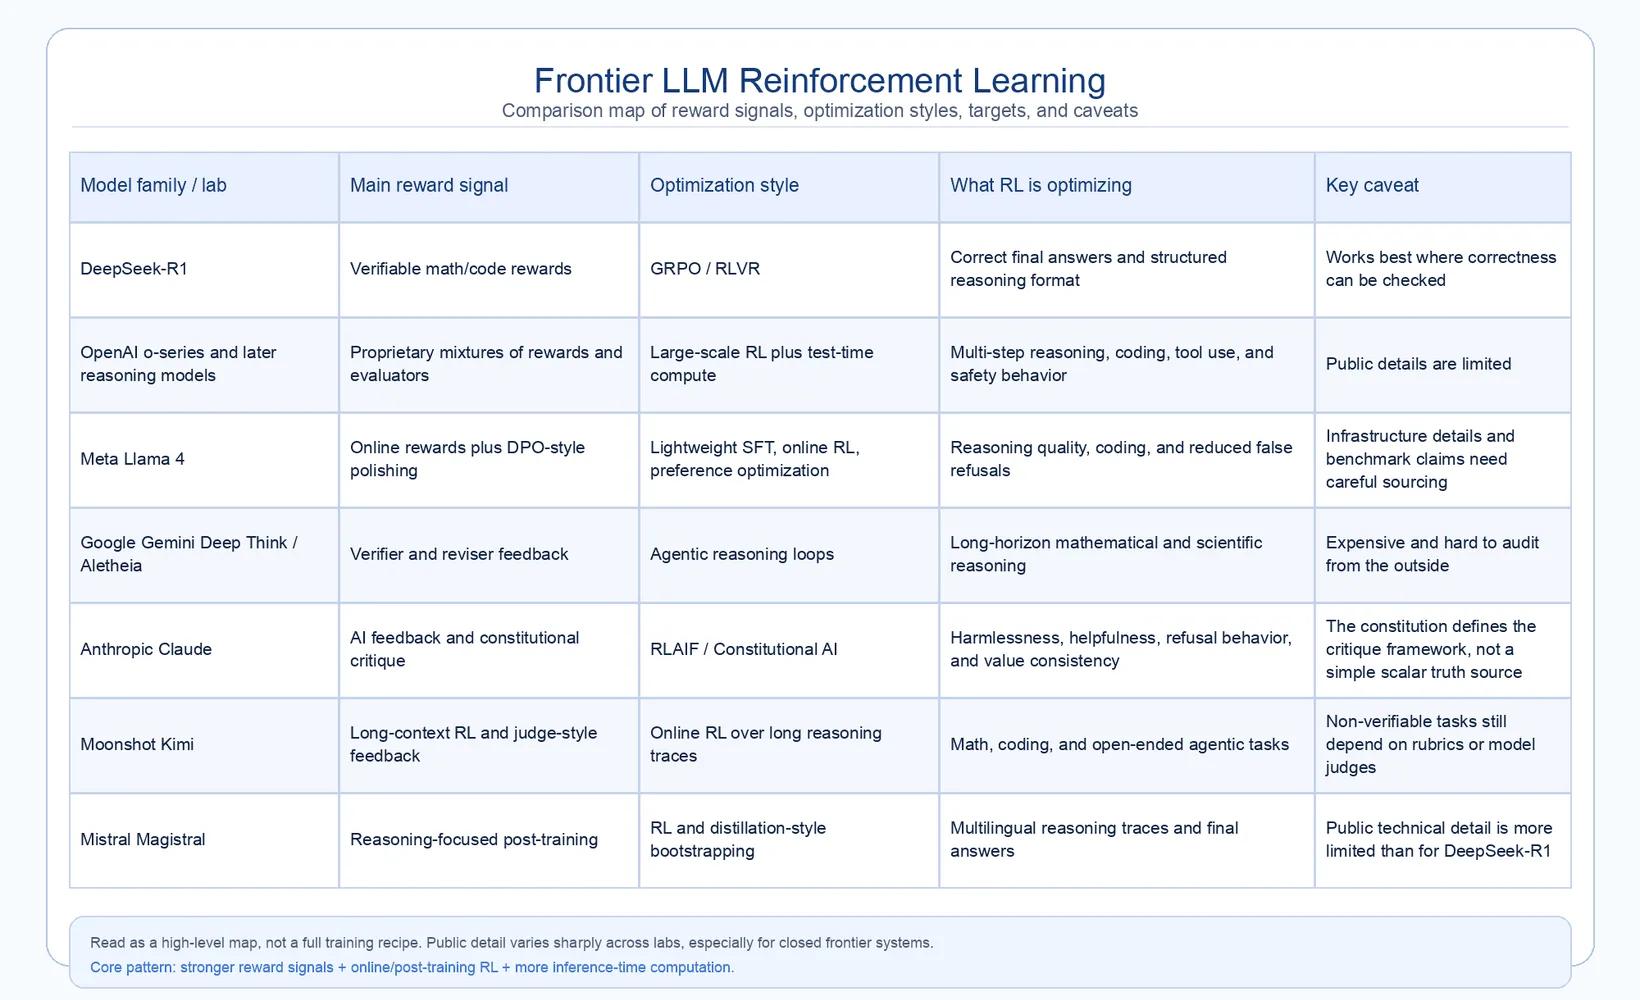
Son araştırmalar, karmaşık matematik problemlerini çözme, kod üretme ve mantıksal analizdeki büyük sıçramaların yalnızca modelleri büyütmekten kaynaklanmadığını gösteriyor. Bu sıçramalar daha güçlü son eğitime, daha iyi ödül sinyallerine ve çıkarım sırasında daha fazla işlem gücüne de bağlı. Farklı şirketler aynı temel zorluğa, yani devasa dil modellerine zengin ve istikrarlı geri bildirim sağlamaya, kendilerine özgü yollarla yaklaştı.
DeepSeek: doğrulanabilir ödüller ve GRPO
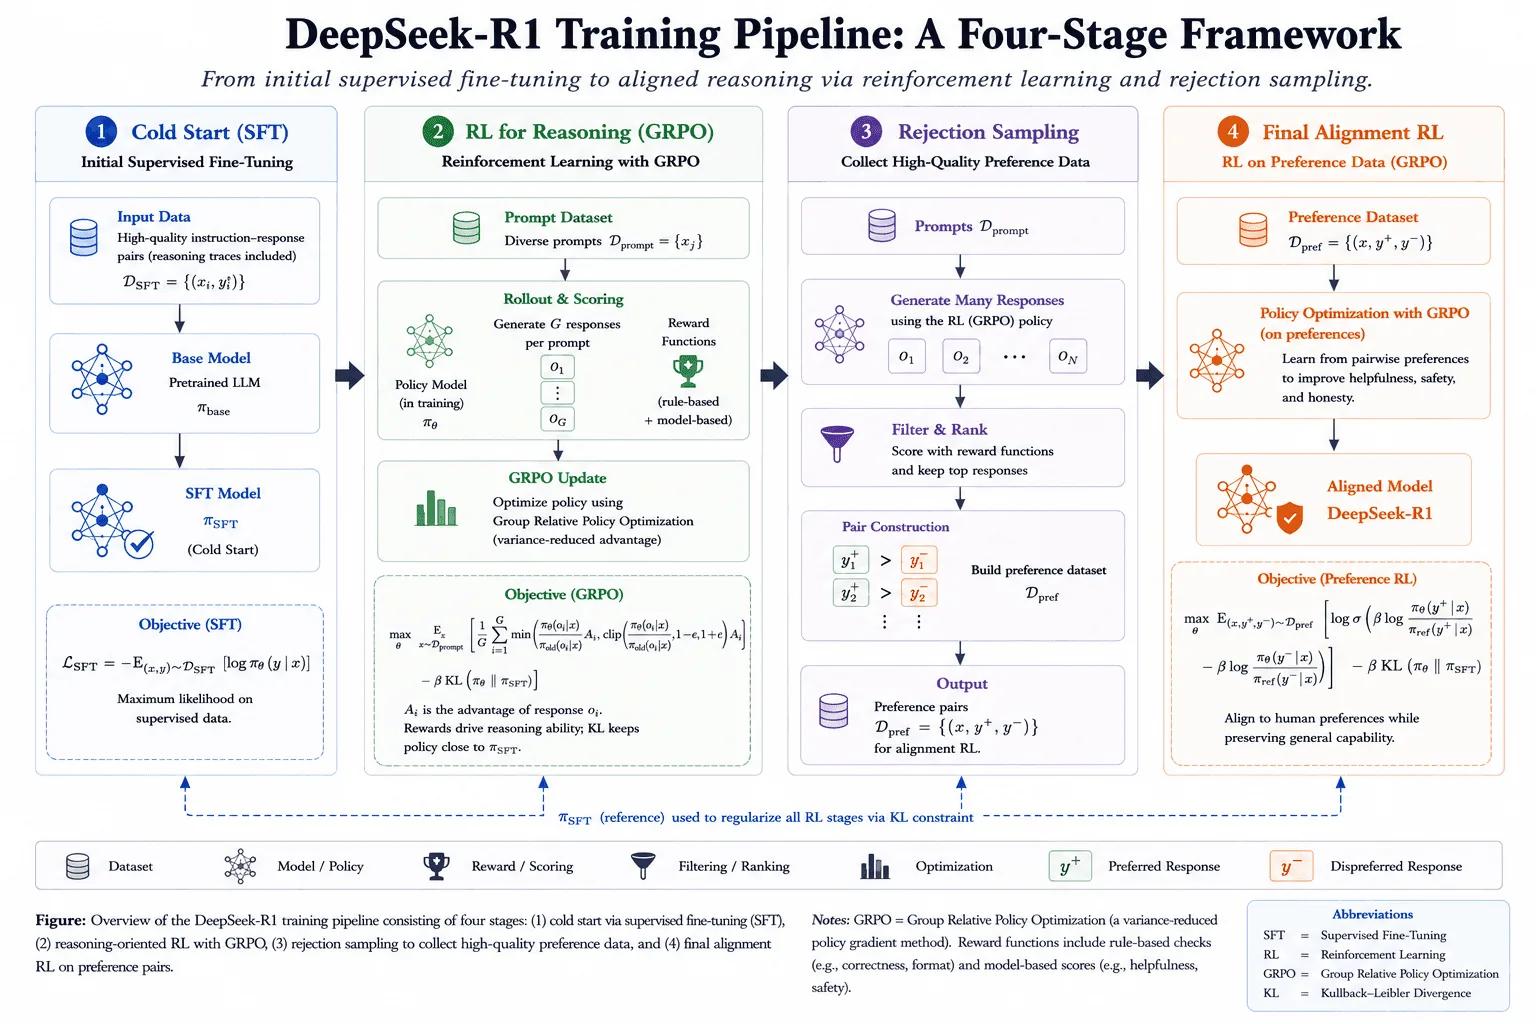
DeepSeek-R1 ve selefi DeepSeek-R1-Zero, RLVR paradigmasını geniş kitlelere tanıttı. InstructGPT'den bu yana kullanılan geleneksel yöntemlere meydan okuyan DeepSeek araştırmacıları, R1-Zero ile ileri düzey akıl yürütme becerilerinin, başlangıçta denetimli ince ayar aşaması olmadan, büyük ölçekli pekiştirmeli öğrenme yoluyla bir temel modelde ortaya çıkabileceğini gösterdi. 32 milyar parametreli bir modeli (Qwen-32B-Base) on binlerce RL adımı boyunca eğittiklerinde, başlangıçta biraz dağınık olsa ve farklı dilleri karıştırsa da yapılandırılmış düşünme davranışları kendiliğinden ortaya çıktı.
Nihai DeepSeek-R1 hattına daha sonra davranışı daha okunabilir, istikrarlı ve pratikte kullanışlı hâle getirmek için soğuk başlangıç denetimli verisi, ret örneklemesi ve ek hizalama aşamaları eklendi.
Bu eğitimi istikrarlı hâle getirmek ve nihai DeepSeek-R1 modeline kadar ölçeklendirmek için ekip, Group Relative Policy Optimization (GRPO) adlı özel bir algoritma kullandı. Referans puanları hesaplamak için ağır bir "Critic" modeline ihtiyaç duyan eski PPO standardının aksine GRPO çok daha hafiftir. Aynı prompt için bir grup farklı yanıt örnekler ve bunları birbirine göre puanlar.
Bu da kötü yanıtları diğerlerine kıyasla sert biçimde cezalandıran, iyi yanıtları ise ödüllendiren bir hedef oluştururken, felaket düzeyinde unutmayı önlemek için güncellemeleri kontrol altında tutar. Bu verimlilik sayesinde DeepSeek, olağan işlem gücünün yalnızca küçük bir kısmıyla devasa tescilli modellerle rekabet edebildi.
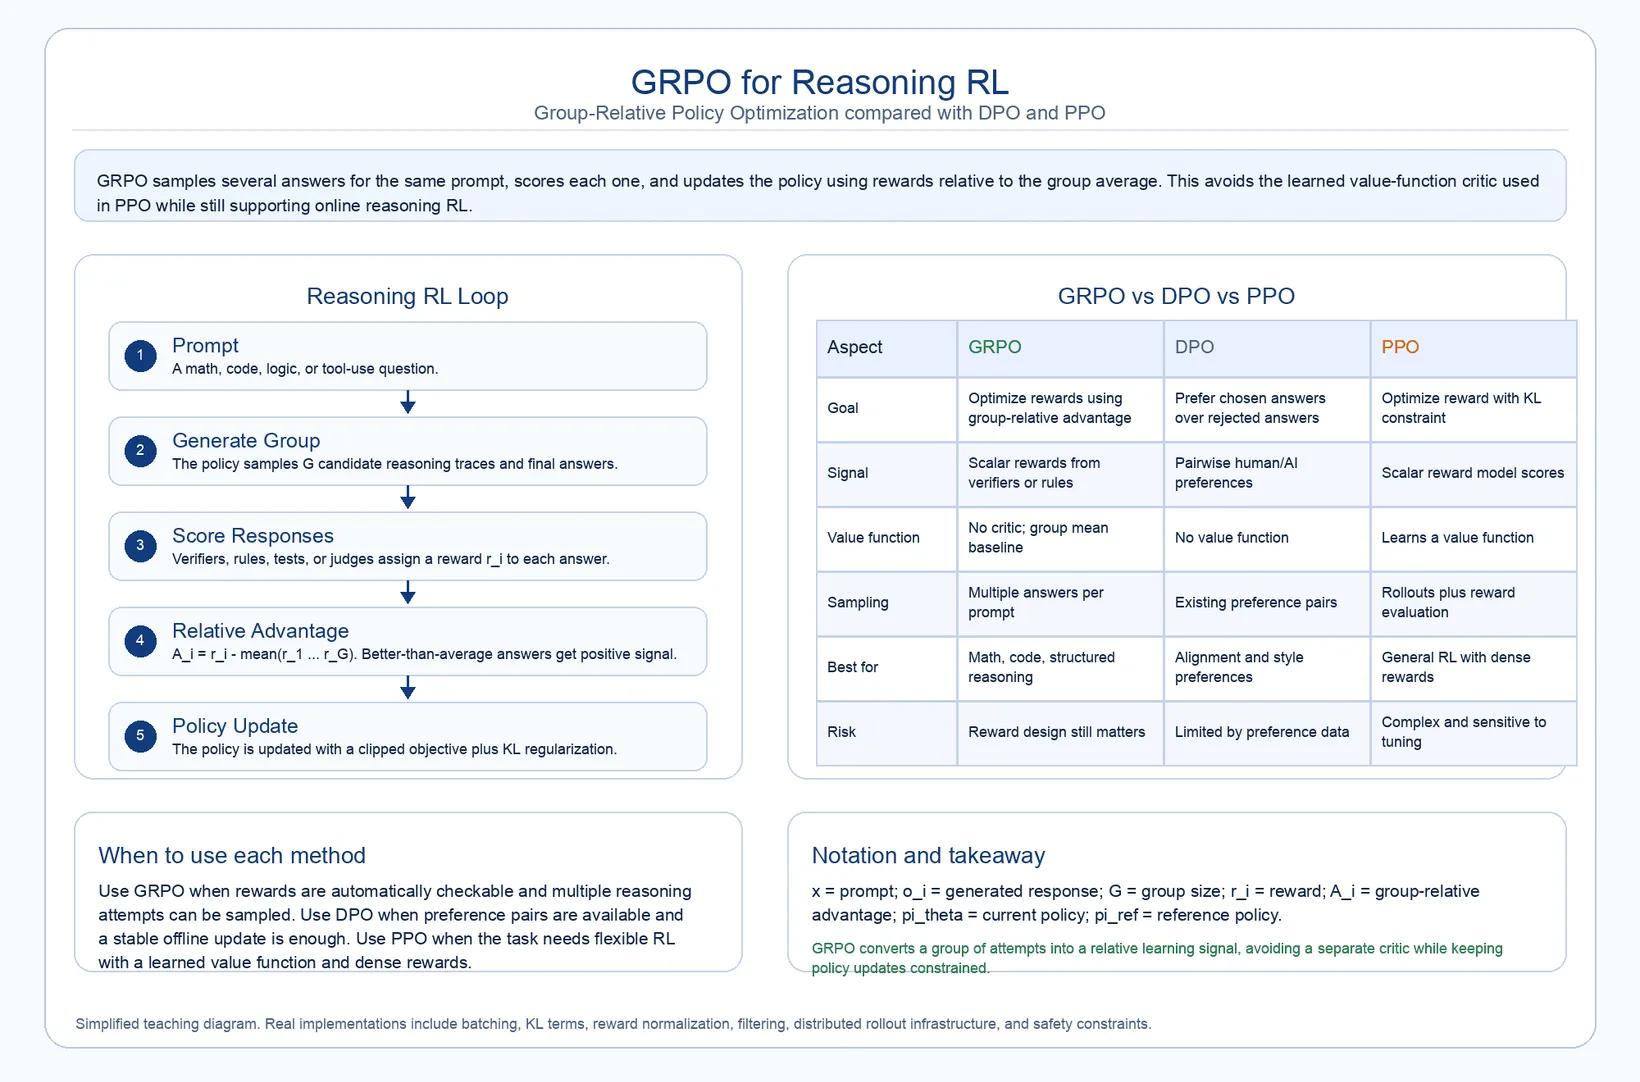
GRPO'nun başarısı büyük ölçüde doğrulanabilir ödüllerden pekiştirmeli öğrenmenin (RLVR) kullanılmasından kaynaklanıyor. DeepSeek, insan değerlendiricilere ya da kolayca kandırılabilen veya "hack'lenebilen" yapay zekâ ödül modellerine güvenmek yerine katı, kurala dayalı ödüller kullandı. İki ana ödül doğruluk ve format üzerine kurulu. Doğruluk ödülü, nihai yanıtın tamamen doğru olup olmadığını kontrol eder (kod için bir birim testini geçmek gibi). Format ödülü ise modeli iç düşünme sürecini katı XML etiketlerinin içine yazmaya zorlayarak düşünce zincirinin okunabilir ve yapılandırılmış olmasını sağlar.
Bu yöntem daha sonra GRPO-$\lambda$'ya evrildi. Araştırmacılar, modeli uzun yanıtlar yazdığı için katı biçimde cezalandırmanın (sonsuza kadar düşünmesini engellemek amacıyla) eğitimin başlarında doğrulukta ani düşüşlere yol açtığını fark etti. GRPO-$\lambda$ bu sorunu cezayı dinamik olarak ayarlayarak çözüyor. Model soruları yanlış yanıtlıyorsa, çözümü özgürce arayabilmesi için uzunluğu geçici olarak önemsemiyor. Bu akıllı ayarlama, AIME 2024 ve GSM8K gibi zorlu benchmark'larda doğruluğu artırırken şaşırtıcı biçimde ortalama yanıt uzunluğunu da yarıya indirdi.
OpenAI: dinamik akıl yürütme, Makora ve güvenlik
"o" serisini ve sonraki öncü akıl yürütme modellerini kapsayan OpenAI ekosistemi, pekiştirmeli öğrenmeyi modellerin yanıt vermeden önce daha uzun süre akıl yürütmesi gereken alanlara taşıdı. OpenAI bunu yalnızca soyut düşünme için değil, donanım hızlandırıcıları için kod yazmak ve siber saldırılara karşı savunmayı güçlendirmek için de kullanıyor. Akıl yürütme modellerinin ardındaki temel fikir iki boyutlu ölçekleme yasalarına dayanıyor: Bir modelin doğruluğu, RL eğitimine daha fazla işlem gücü harcandıkça ve test sırasında akıl yürütmeye daha fazla zaman tanındıkça (test-time compute) artabilir.
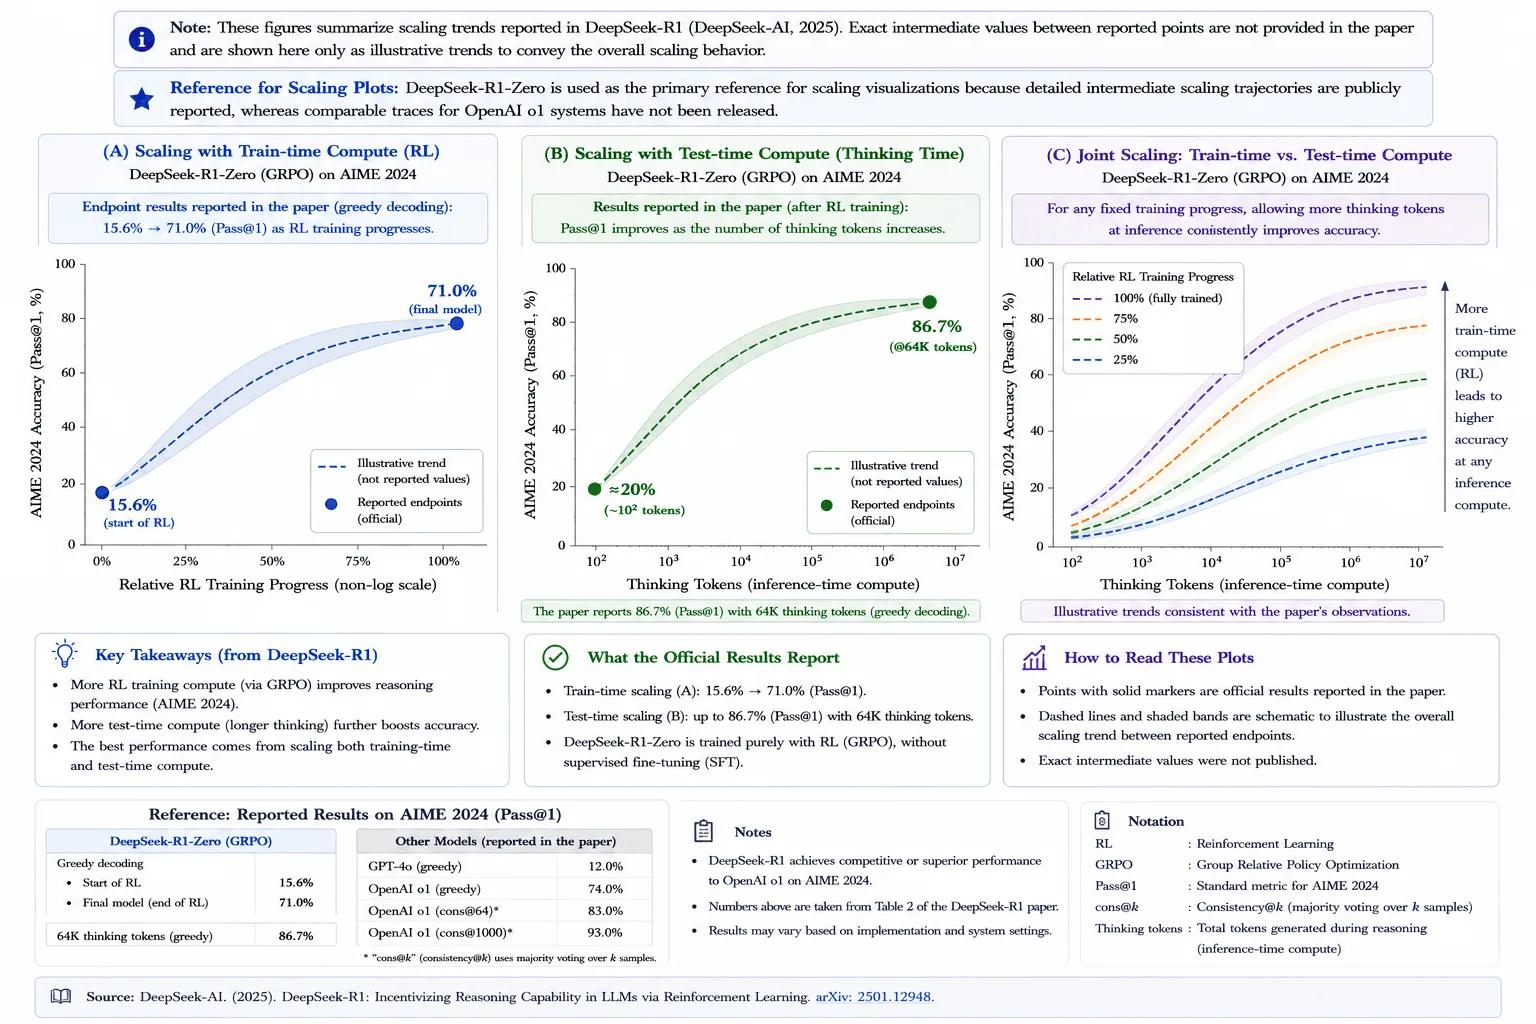
Bu şekil, eğitim zamanı ve test zamanı ölçekleme fikrinin genel bir kamuya açık göstergesi olarak DeepSeek-R1-Zero ölçekleme eğrilerini kullanıyor. OpenAI, akıl yürütme modelleri için niteliksel olarak benzer bir davranış tarif etti, ancak aynı ayrıntıda ara ölçekleme eğrileri yayımlamadı.
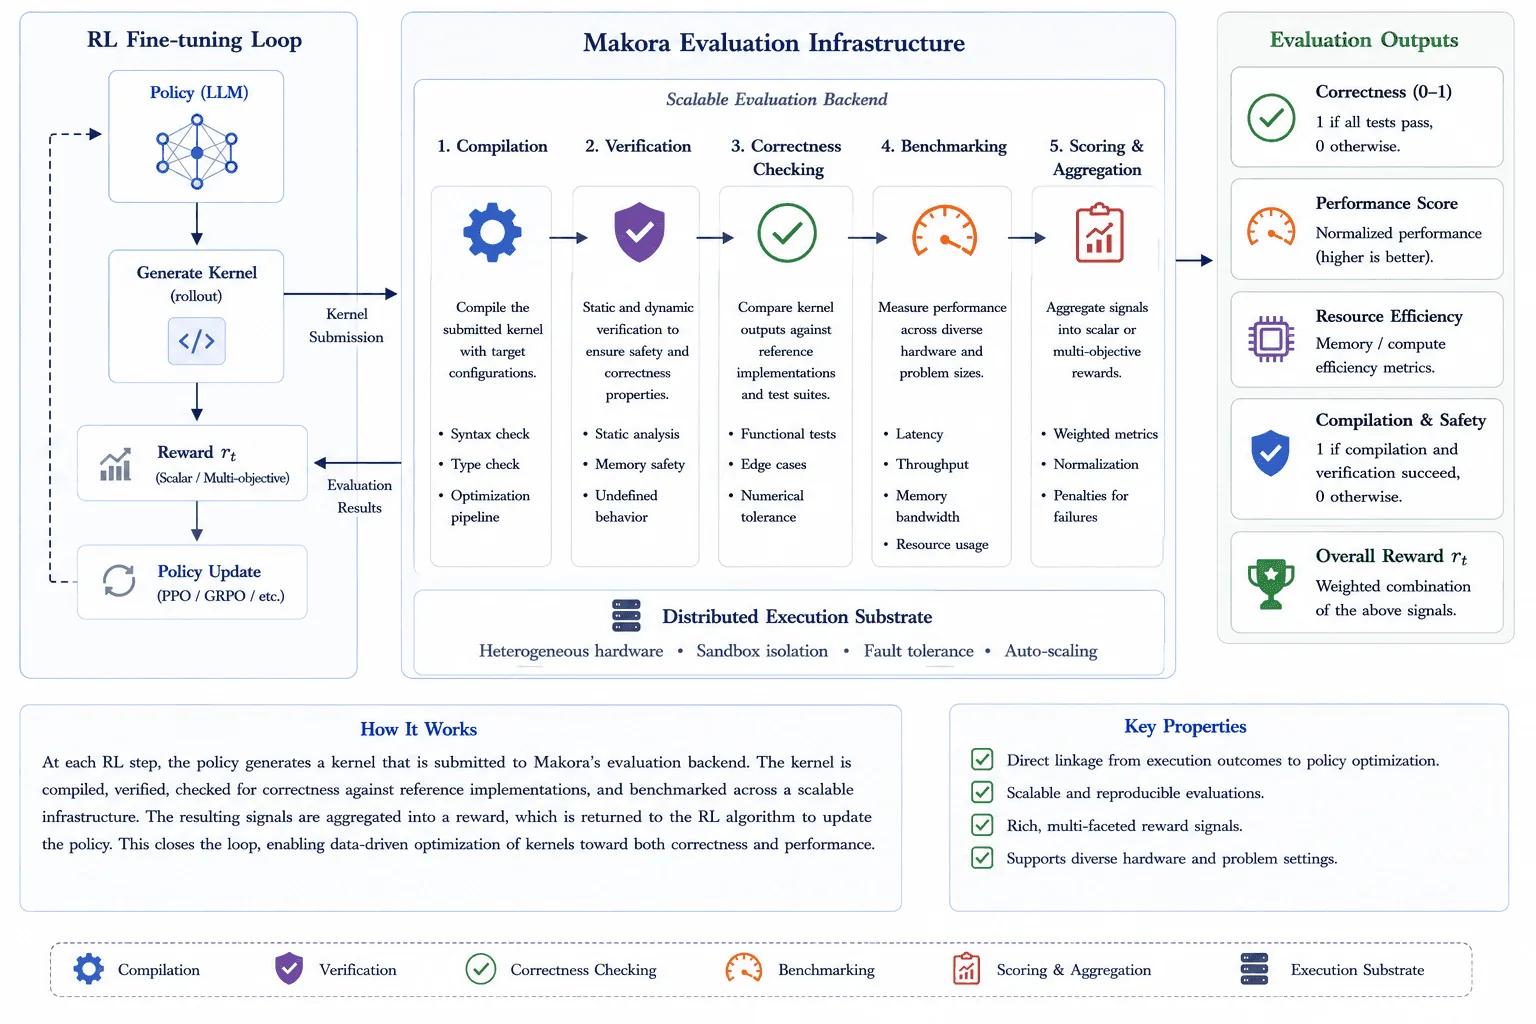
Paylaşılan sonuçlar, bu paradigmanın neden bu kadar etkili olduğunu gösteriyor. Matematik ve bilim benchmark'larında yoğun RL ve çıkarım sırasındaki ek işlem gücü, akıl yürütme modellerini sıradan sohbet modellerinin çok ötesine taşıyor gibi görünüyor. Ancak belki de en ilginç uygulama, RL'in insan eğitim verisinin çok az olduğu ya da hiç bulunmadığı son derece teknik alanlarda kullanılması. OpenAI, Makora adlı bir değerlendirme sistemiyle kernel yazımını (donanım için yüksek düzeyde optimize edilmiş kod) saf bir RL problemi olarak ele aldı.
LLM bir kod önerisi yazar; bu kod, onu derleyen, çalışıp çalışmadığını kontrol eden ve ne kadar hızlı çalıştığını ölçen bir arka uç sistemine gönderilir. Kod ne kadar hızlı çalışırsa ödül o kadar yüksek olur. Böylece gerçek dünyadaki yazılım performansı ile modelin öğrenmesi arasındaki döngü doğrudan kapandı. Bu teknik, testlerin çoğunda modelin standart derleyicilerden iki kat daha hızlı kod yazmasını sağladı.
Meta Llama 4: asenkron optimizasyon ve hafif DPO
Meta'nın Llama 4 ailesiyle (Scout 17B, Maverick 17B ve Behemoth 288B modelini içeriyor) benimsediği yaklaşım, açık kaynak modellerde çevrimiçi pekiştirmeli öğrenmeyi ölçeklendirmenin farklı bir yolunu gösteriyor. Büyük miktarda denetimli veriye dayanan eski modellerin aksine, Llama 4'ün açıklanan son eğitimi yalın ve hedefli bir hat kullanıyor: biraz hafif SFT, ardından yoğun çevrimiçi RL ve son olarak Direct Preference Optimization (DPO) ile cilalama.
Llama 4 Maverick'in son eğitimindeki büyük teknik fikir, asenkron RL altyapısı. Normalde PPO veya GRPO gibi algoritmalar metni üretir ve modeli aynı sunucu düğümünde günceller. Bu bir darboğaz yaratır, çünkü eğitim GPU'ları ödüllerin hesaplanmasını beklerken boşta kalabilir. Meta, iş yükünü böldüğünü ve ödül hesaplamasının bağımsız olarak çalıştığını anlatıyor; böylece kod testleri gibi karmaşık ödülleri değerlendirmek için gereken süre gizlenmiş oluyor.
Bu aşamada Meta zor prompt'lara ağırlık veriyor. Ardından son DPO katmanı, tonu iyileştirmeye ve modelin güvenli bir soruyu yanlışlıkla yanıtlamayı reddettiği durumları azaltmaya yardımcı oluyor. Bu da Llama 4'ü hibrit bir son eğitim yığınına güzel bir örnek hâline getiriyor: daha zorlu akıl yürütme davranışları için RL, ardından kullanıcıya dönük davranış için tercih optimizasyonu.
Google Gemini Deep Think: otonom araştırma ve Aletheia
Google DeepMind ekosistemi, özellikle de Gemini Deep Think ve ilgili araştırma ajanları, pekiştirmeli öğrenmenin uzun vadeli bilimsel akıl yürütmeye uygulanmasının en net örneklerinden birini sunuyor. Pek çok model tek bir yanıtı optimize ederken Deep Think tarzı sistemler akıl yürütmeyi otonom ve çok parçalı ajanlar etrafında kurguluyor. En gelişmiş örnek ise matematik ajanı Aletheia.
Aletheia, matematiği kanıtlamak için katı programlama dillerine dayanmıyor; tamamen doğal İngilizce ile çalışıyor. Üç parçalı bir pekiştirme döngüsü kullanıyor: bir Generator, bir Verifier ve bir Reviser. Zor bir teorem verildiğinde model olası çözümleri yazıyor. Verifier küçük bir hata fark ederse yanıtın tamamını çöpe atmıyor; mantığı düzeltmesi için Reviser'a aktarıyor. Yanıt yalnızca büyük ve düzeltilemez bir hata varsa tamamen reddediliyor. Aletheia ayrıca iddiaları doğrulamak ve uydurma kaynaklar üretmemek için harici arama ve bilimsel literatür taramasından da yararlanabiliyor.
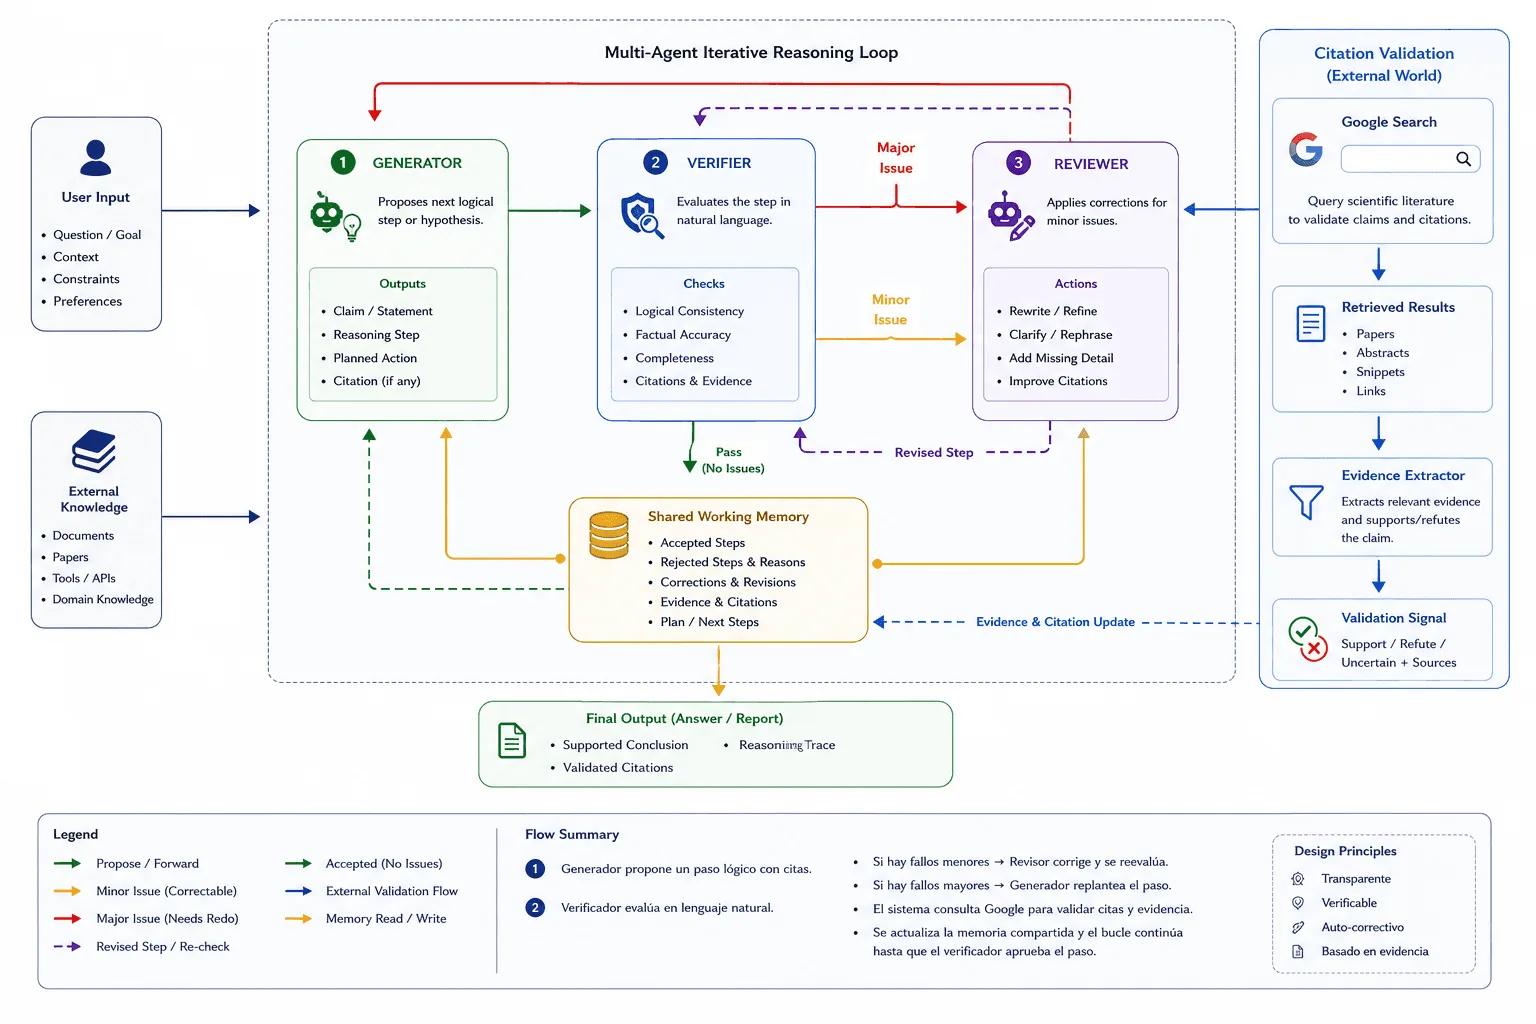
Aletheia'nın paylaşılan sonuçları, doğrulayıcı-düzeltici döngülerinin doğal dildeki matematiksel ispat sistemlerini, özellikle zorlu ispat benchmark'larında, sıradan tek geçişli üretimin çok ötesine taşıyabileceğini gösteriyor. Daha da etkileyicisi, Aletheia'nın kapsamlı matematiksel araştırma çıktıları üretebildiği ve makine öğrenimi algoritmalarını inceleyebildiği belirtiliyor. Buradaki önemli teknik nokta yalnızca puan değil, döngünün kendisi: üret, doğrula, düzelt ve ispatı ancak ondan sonra kabul et.
Anthropic Claude: resmî anayasalar ve RLAIF
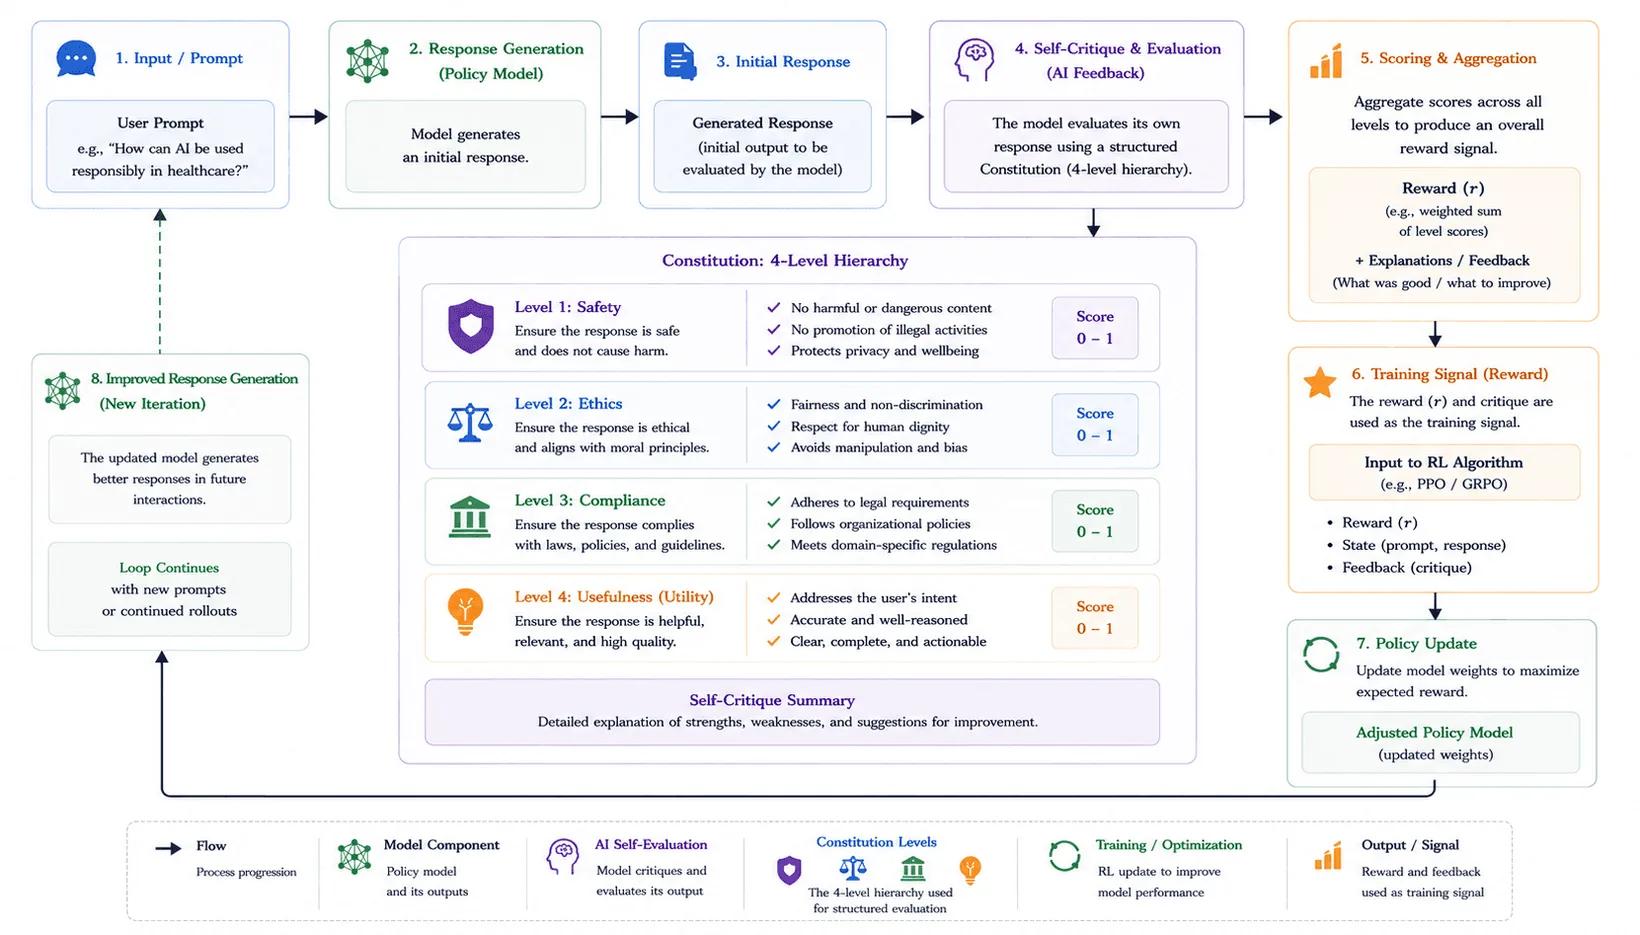
Anthropic'in Claude 3.5 ve Claude 4 ile benimsediği yaklaşım, Anayasal Yapay Zekâya (Constitutional AI) odaklanıyor. Hangi yanıtın daha iyi olduğuna karar vermek için binlerce insan çalışana güvenmek yavaş, yanlı ve toksik içerikle uğraşırken zorlu bir süreç. Bunun yerine Anthropic, yazılı bir kurallar dizisinin (bir "anayasa") yönlendirdiği bir yapay zekâ modeli kullanıyor.
Yapay zekâ geri bildiriminden pekiştirmeli öğrenme (RLAIF) adı verilen bu yöntem, modeli bir yanıt üretmeye, açık kurallara (insan hakları ve fayda ilkeleri gibi) dayanarak kendini eleştirmeye ve çıktısını bu kurallara uyacak şekilde yeniden yazmaya zorluyor. Bu şekilde iyileştirilmiş yanıtlar daha sonra modeli güncellemek için kullanılıyor. Kanıtlar, bu kurala dayalı tekniğin klasik insan geri bildirimi yöntemlerine denk ya da onlardan üstün olduğunu gösteriyor. Daha da önemlisi, aylarca insan verisi toplamaya gerek kalmadan modelin temel değerlerinin şeffaf, kolay denetlenebilir ve hızla güncellenebilir olmasını sağlıyor.
Ocak 2026'nın sonlarında Anthropic, "Claude's New Constitution"ı yayımlayarak bu çerçevede büyük bir güncelleme yaptı. Basit, kurala dayalı bir yaklaşımdan gerekçeye dayalı bir hizalama belgesine geçen bu anayasa; güvenlik, etik, uyumluluk ve yardımseverlik etrafında bir öncelik hiyerarşisi belirliyor. Anayasa, hizalama sorununu tek başına sihirli bir şekilde çözmüyor. Görevi, eğitim ve değerlendirme sırasında yanıtları üretmek, filtrelemek ve sıralamak için kullanılan eleştiri çerçevesini tanımlamak. Anthropic, belgeyi kamuya açarak hizalama felsefesinin incelenmesini ve tartışılmasını da kolaylaştırdı.
Moonshot AI Kimi: RL'i doğrulanamayan görevlere ölçeklendirmek
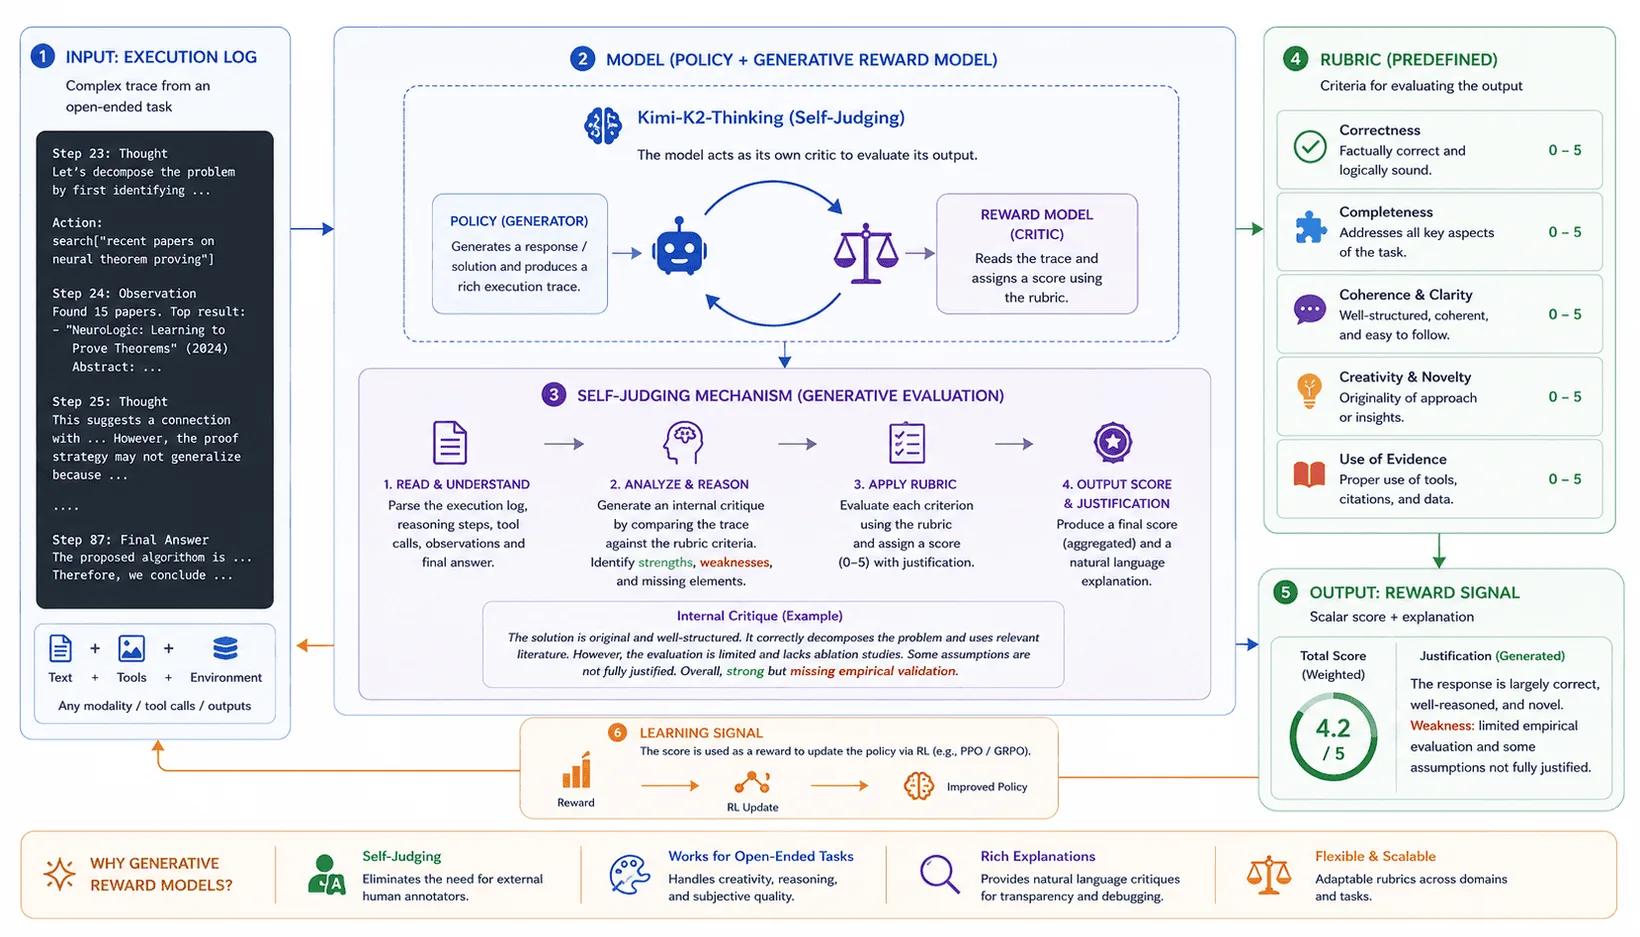
Moonshot AI, Kimi k1.5 ve K2'yi piyasaya sürerek RL'in katı matematik ve kodlamanın dışında neler başarabileceğinin sınırlarını zorladı. RL'in tarihsel olarak en büyük zorluğu, yaratıcı yazarlık, arama sonuçlarını derleme ya da karmaşık rapor üretimi gibi mutlak bir "doğru" ya da "yanlış" yanıtın bulunmadığı, doğrulanamayan görevleri değerlendirmek oldu. Moonshot bu sorunu, üretken ödül modellerini (GRM) geniş bir ajan tabanlı davranış yelpazesinde sistematik olarak kullanarak çözdü. Kimi, basit skaler puanlar yerine, açık uçlu üretimi değerlendirmek için bir öz eleştiri rubriği kullanan LLM tabanlı bir "log yargıcı"ndan (ör. Kimi-K2-Thinking) yararlanıyor; örneğin bir çalıştırma kaydının, bir yazılım yamasının bir hata örüntüsünü başarıyla ortadan kaldırdığını kanıtlayıp kanıtlamadığına karar veriyor.
Ayrıca Moonshot AI, RL aşamasında bağlam penceresini 128k token'a çıkarmanın, modelin otoregresif tahminler aracılığıyla akıl yürütme uzayında örtük aramalar yapmasını doğal olarak mümkün kıldığını keşfetti. Bu da basit ama etkili bir RL çerçevesi ortaya koydu. Model devasa bağlamı plan yapmak, düşünmek ve kendini düzeltmek için kullanabildiğinden Kimi; Monte Carlo Tree Search (MCTS) veya geleneksel Process Reward Models (PRM) gibi işlem açısından ağır mimari hilelere ihtiyaç duymadan matematik, kodlama ve görsel-dil akıl yürütme görevlerinde güçlü sonuçlar elde ediyor.
Mistral AI: Magistral ve çok dilli akıl yürütme
2025'in başlarında Mistral AI, ilk yerel akıl yürütme modeli Magistral'ı piyasaya sürerek öncü akıl yürütme yarışına katıldı. Hem açık kaynak (Magistral Small, 24B parametre) hem de daha güçlü bir kurumsal sürüm (Magistral Medium) olarak yayımlanan model, alana özgü ve çok dilli düşünce zincirine güçlü bir şekilde odaklanıyor.
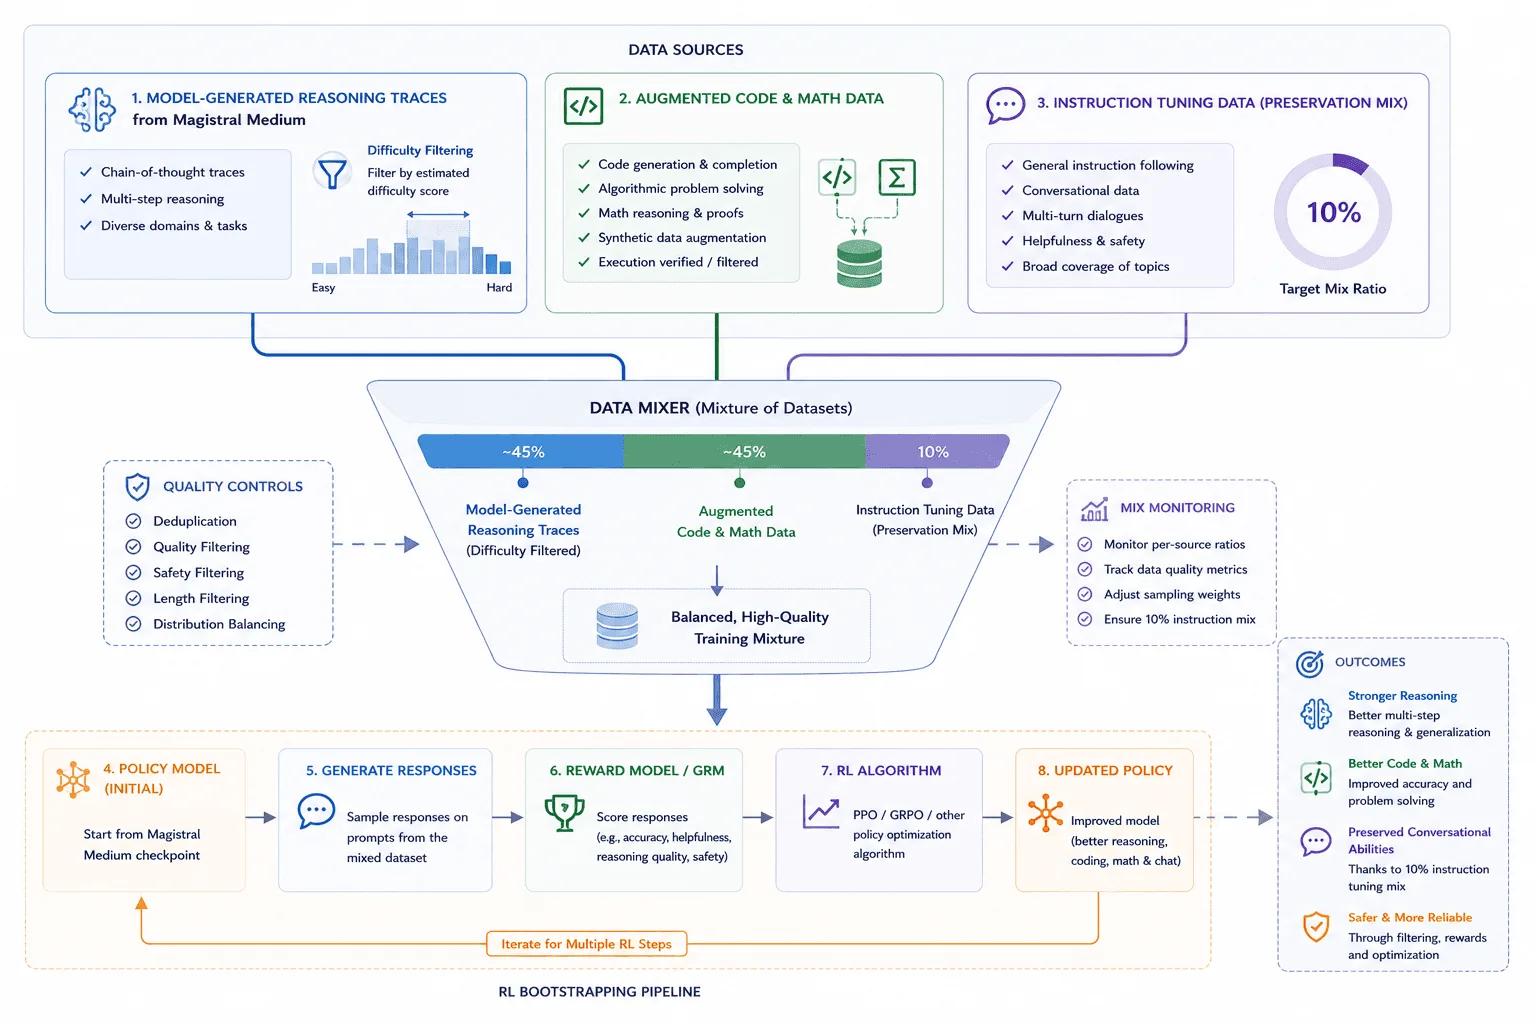
Mistral'in yaklaşımı, tamamen daha büyük ve kapalı modellerden iz damıtmaya dayanan laboratuvarlarınkinden farklı. Magistral, Mistral'in öncü model ailesinin akıl yürütmeye odaklı bir uzantısı olarak tanıtıldı ve son eğitiminde pekiştirmeli öğrenme merkezi bir rol oynadı. Son derece verimli Magistral Small'u oluşturmak için Mistral gelişmiş bir bootstrapping hattı kullandı: Medium modelinden akıl yürütme izleri üretti, karma bir zorluk seviyesini korumak için bunları filtreledi, verileri OpenThoughts ve OpenR1 alt kümeleriyle zenginleştirdi ve modelin akıl yürütme dışındaki sohbet becerilerini kaybetmemesi için genel instruction tuning verileri ekledi. Belki de en özgün özelliği yerel çok dilli stratejisi: Model, hem akıl yürütme izlerini hem de nihai yanıtlarını kullanıcının istediği dilde üretecek şekilde eğitildi; bu da ileri düzey akıl yürütmenin yalnızca İngilizce olmak zorunda olmadığını gösteriyor.
Sınırlamalar ve açık sorunlar
Modern RL yığını güçlü, ancak akıl yürütme için kusursuz bir çözüm değil. İlk sınırlama reward hacking. Bir model, gerçek görevi çözmeden ödülü karşılamanın bir yolunu bulursa RL bu kestirmeyi pekiştirir. Bu durum, değerlendirici deterministik bir test yerine başka bir model olduğunda özellikle tehlikeli.
İkinci sınırlama benchmark'lara aşırı uyum. Matematik, kodlama ve akıl yürütme benchmark'ları net geri bildirim sağladıkları için faydalı; ancak aynı netlik, onlara göre optimizasyon yapmayı da kolaylaştırıyor. Bir model, karmaşık gerçek dünya görevlerinde aynı düzeyde sağlamlık kazanmadan bir benchmark'ta gelişme gösterebilir.
Üçüncü sınırlama, doğrulanabilir ödüllerin eşit dağılmamış olması. Kod, matematik ve yapılandırılmış çıktılar çoğu zaman otomatik olarak kontrol edilebiliyor. Açık uçlu araştırma, uzun metin yazımı, ürün planlama ve bilimsel keşif ise çok daha zor puanlanıyor. Bu görevler için laboratuvarlar hâlâ rubriklere, yargıç modellere, insan incelemesine veya dolaylı ortam sinyallerine başvuruyor.
Bir de maliyet sorunu var. Test-time compute, modelin daha yoğun şekilde örnekleme, düzeltme ve doğrulama yapmasına izin vererek doğruluğu artırabilir, ancak gecikmeyi ve sunum maliyetini yükseltir. Bu da en güçlü akıl yürütme modlarının her yerde kullanıma sunulmasını zorlaştırıyor.
Son olarak, gizli düşünce zinciri bir denetim sorunu yaratıyor. Pek çok öncü sistem, uzun iç akıl yürütme izlerini doğrudan göstermeden kullanıyor olabilir. Bu, güvenlik ve kullanıcı deneyimi açısından iyi olabilir; ancak dışarıdan bakanların modelin RL'den gerçekte ne öğrendiğini incelemesini zorlaştırıyor.
Sonuç
OpenAI, DeepMind, Meta, DeepSeek, Mistral, Moonshot ve Anthropic vaka incelemeleri, öncü yapay zekâ geliştirmenin yalnızca statik ön eğitimden daha etkileşimli bir son eğitim yığınına doğru kaydığını gösteriyor. Doğrulanabilir ödüller, çevrimiçi optimizasyon, yapay zekâ geri bildirimi, öz damıtma, araç ortamları ve test-time compute artık modellerin nasıl akıl yürüttüğünü birlikte şekillendiriyor.
Modeller artık yalnızca internetteki kalıpları ezberlemiyor. En güçlü sistemler, matematiği kontrol etmek, kodda hata ayıklamak, araç kullanmak, planları gözden geçirmek ve ara adımları doğrulamak için daha fazla işlem gücü harcayacak şekilde eğitiliyor ve yönlendiriliyor. Pekiştirmeli öğrenme bu dönüşümün tek bileşeni değil; ancak ham dil modellerini arama yapabilen, doğrulayabilen ve kendi yanıtlarını iyileştirebilen sistemlere dönüştüren temel mekanizmalardan biri hâline geldi.
Kaynakça
Temeller: RLHF, DPO ve yapay zekâ geri bildirimi
Ouyang et al., 2022. Training language models to follow instructions with human feedback. Klasik SFT -> ödül modeli -> PPO hizalama hattını ortaya koyan InstructGPT makalesi.
Bai et al., 2022. Constitutional AI: Harmlessness from AI Feedback. Anthropic'in RLAIF / Anayasal Yapay Zekâ üzerine orijinal makalesi.
Rafailov et al., 2023. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Açık bir ödül modeli eğitimi olmadan çevrimdışı tercih optimizasyonunu anlamak için faydalı, temel DPO makalesi.
Anthropic, 2023. Claude's Constitution. Claude tarzı anayasal eleştiriye yön veren ilkelerin kamuya açık sürümü.
Anthropic, 2026. Claude's New Constitution. Güncellenmiş kamuya açık anayasa; kural listelerinden daha kapsamlı, gerekçeye dayalı hizalamaya geçişi anlamak için faydalı bir bağlam.
Akıl yürütme için RL ve doğrulanabilir ödüller
OpenAI, 2024. Learning to Reason with LLMs. o1 tarzı akıl yürütme, RL eğitimi ve test-time compute yaklaşımı için OpenAI'ın birincil kaynağı.
DeepSeek-AI, 2025. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. DeepSeek-R1, DeepSeek-R1-Zero, GRPO ve RLVR tarzı akıl yürütme eğitimi için birincil kaynak.
Yue et al., 2025. Stable Reinforcement Learning for Efficient Reasoning. GRPO-$\lambda$'yı tanıtıyor ve akıl yürütme RL'inde uzunluk cezalarının istikrarlı hâle getirilmesini ele alıyor.
Moonshot AI, 2025. Kimi k1.5: Scaling Reinforcement Learning with LLMs. Kimi'nin uzun bağlamlı RL ve ölçekleme yaklaşımı için birincil kaynak.
Label Studio, 2025. Reinforcement Learning from Verifiable Rewards. RLVR'ın ikincil bir açıklaması; anlaşılır bir kavramsal genel bakış olarak faydalı, ancak ana kanıt kaynağı olarak değil.
Öncü model vaka incelemeleri
Meta AI, 2025. The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation. Hafif SFT, çevrimiçi RL ve DPO tarzı cilalama dahil, Llama 4'ün son eğitimine dair iddialar için birincil kaynak.
Mistral AI, 2025. Magistral. Mistral'in akıl yürütme model ailesi, çok dilli akıl yürütme odağı ve RL/son eğitim yaklaşımı için birincil kaynak.
Google DeepMind, 2026. Accelerating Mathematical and Scientific Discovery with Gemini Deep Think. Gemini Deep Think ve bilimsel akıl yürütmeye dair iddialar için DeepMind'ın birincil kaynağı.
Feng et al., 2026. Towards Autonomous Mathematics Research. Aletheia'yı Gemini Deep Think üzerine kurulu bir matematik araştırma ajanı olarak tanımlayan araştırma makalesi.
Feng et al., 2026. Aletheia tackles FirstProof autonomously. Aletheia'nın FirstProof yarışmasındaki performansına dair takip değerlendirmesi.
Tehrani et al., 2026. Fine-Tuning GPT-5 for GPU Kernel Generation. Doğrulanabilir ödüllerle GPU kernel üretimi için RL ince ayarı üzerine Makora makalesi.
Makora, 2026. We RL'd GPT-5 to Write Better Kernels. Makora'nın GPU kernel'leri üzerine RL çalışmasına eşlik eden blog yazısı.
Faydalı arka plan ve ek okumalar
Decode the Future, 2024. RLHF explained. Daha az teknik bir giriş arayan okurlar için RLHF'e dair anlaşılır bir arka plan.
Le Wagon, 2025. OpenAI o1 and o3 explained: how thinking models work. Akıl yürütme modeli kavramlarına ikincil bir genel bakış; sezgi kazanmak için faydalı, ancak birincil model ve makale kaynaklarından daha zayıf.
