

前沿大模型中的强化学习:从 RLHF 到可验证奖励
 Toni Lopez Co-Founder at Karumi
2025 年至 2026 年间,大语言模型(LLM)背后的架构与方法经历了一场深刻变革。过去,构建一个基础模型主要依赖基于海量原始数据的大规模预训练,随后通常再通过监督微调(SFT)和基于人类反馈的强化学习(RLHF)完成一个相对基础的对齐阶段。然而,随着互联网上的高质量训练数据逐渐枯竭,市场对具备真正推理能力的 AI 的需求不断增长,整个行业不得不调整思路。
如今,研究人员和科技公司都将更多精力与算力投向交互式后训练和“测试时计算”(test-time compute,即给模型更多时间在作答前进行处理和思考)。在这一新格局下,强化学习(RL)不再只是调整模型语气或过滤不良输出的工具,而是已成为后训练的核心引擎之一,尤其适用于需要规划、校验中间结果、调用工具,并通过更长推理轨迹不断改进答案的模型。
当前的技术前沿由 OpenAI、Meta、Google DeepMind、Anthropic、DeepSeek、Moonshot AI 和 Mistral 等机构的前沿模型所塑造,各家在策略优化算法的应用方式上呈现出极大的多样性。行业正越来越多地以可验证奖励系统、异步偏好优化、基于模型的评审以及环境反馈,来补充神经奖励模型。
本报告将深入剖析强化学习在当今顶尖模型中的应用方式。
“经典范式”:2025 年之前的 RLHF
在 2025 年的重大转折之前,对齐 LLM 的标准做法在很大程度上受到 OpenAI InstructGPT 的影响。这种经典方法以基于人类反馈的强化学习(RLHF)为基础,遵循严格的三步流程:首先,用人类标注员编写的示例对模型进行监督微调(SFT);其次,基于人类偏好数据集单独训练一个奖励模型(RM),用于预测人类最喜欢哪些回答;最后,使用近端策略优化(Proximal Policy Optimization,PPO)——一种在运行过程中更新策略的算法——让 SFT 模型针对该奖励模型进行优化。
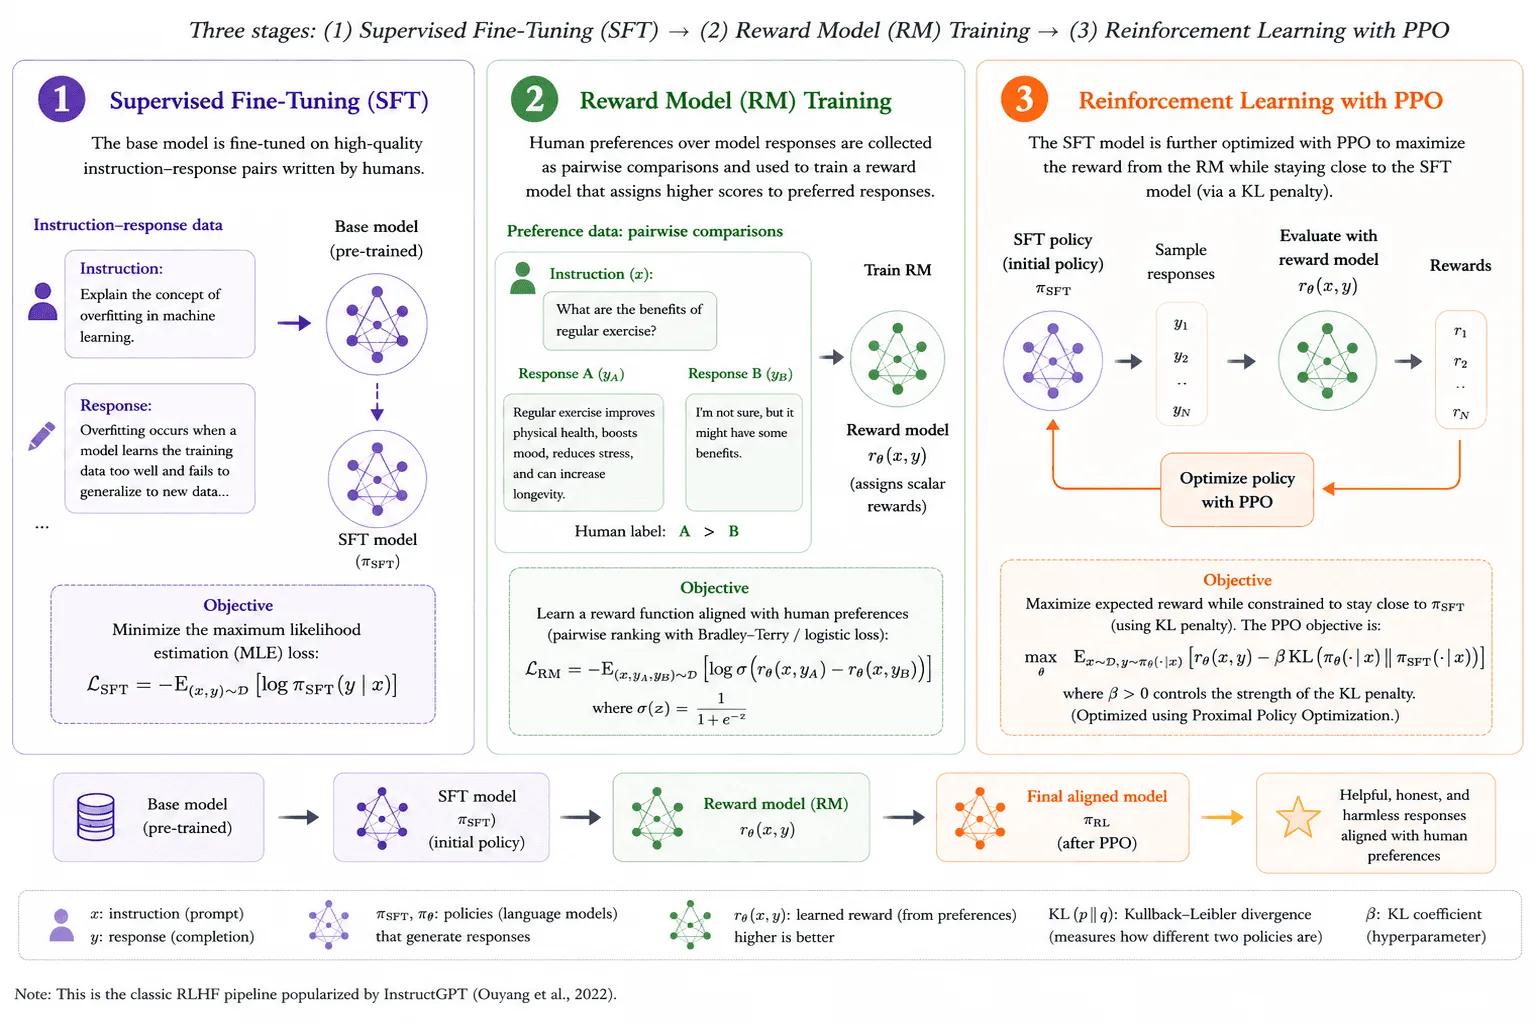
尽管这种方法在基础的语气调整和简单指令遵循上效果不错,但经典 RLHF 存在严重缺陷。它会带来所谓的“对齐税”(alignment tax):为了让模型听起来更礼貌或更安全而进行的优化,反而会明显削弱其底层的推理能力和学术能力。此外,PPO 以复杂著称,而且内存开销巨大,因为需要同时运行多个模型(Actor、Critic、Reference 和 Reward)。
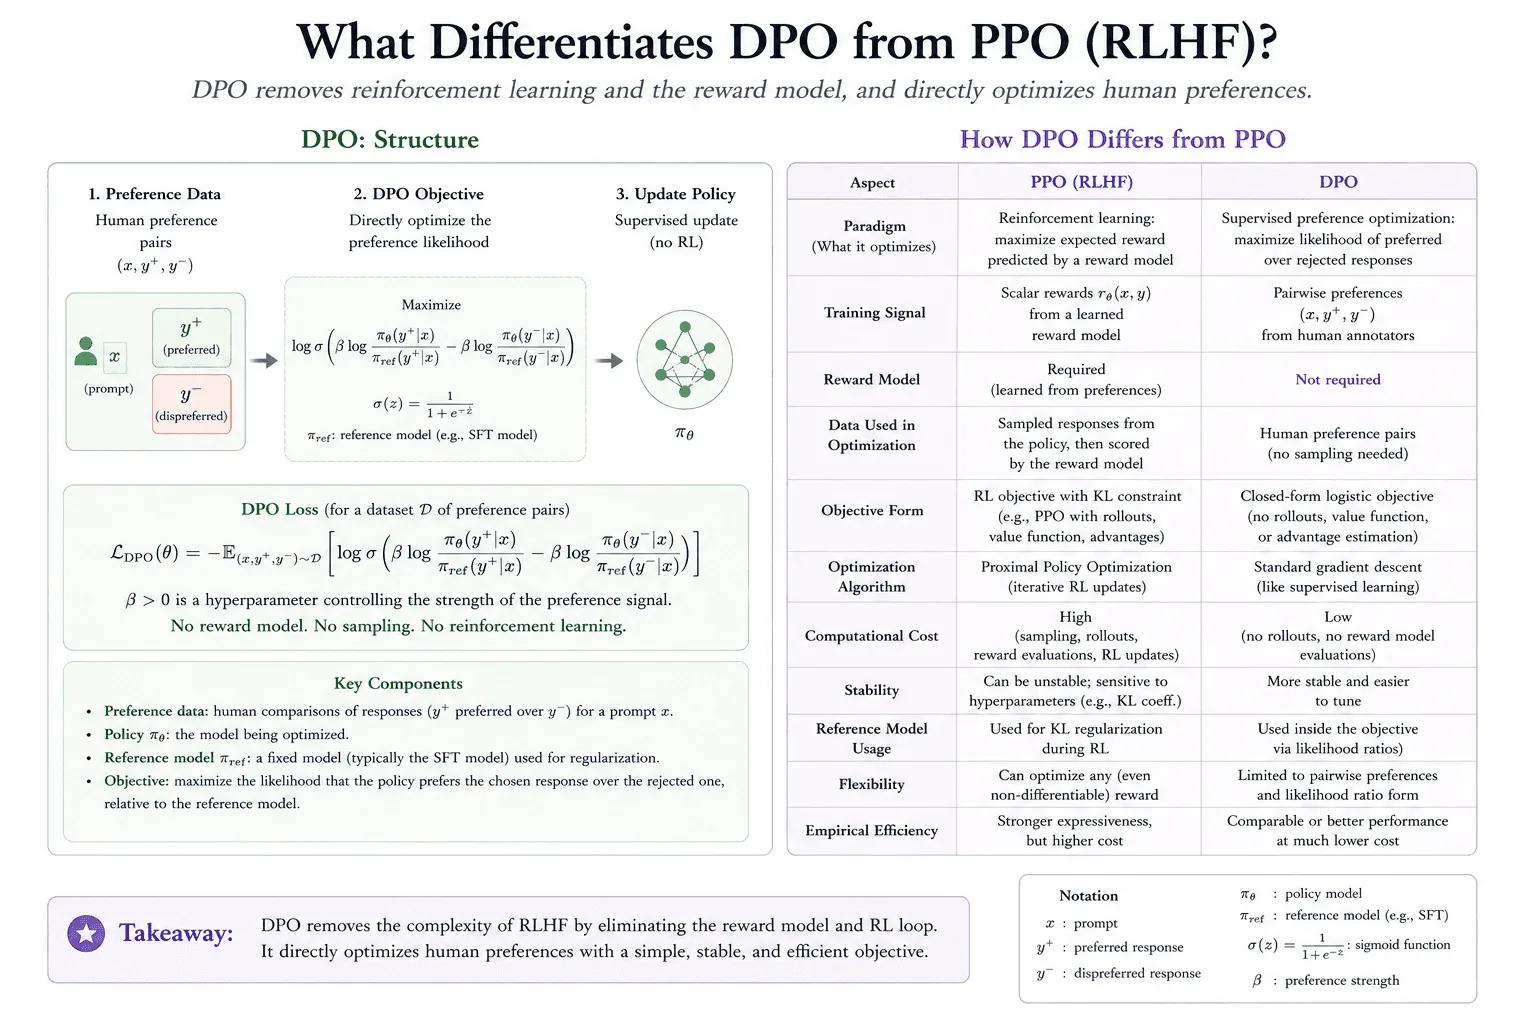
2023 年底,直接偏好优化(Direct Preference Optimization,DPO)带来了第一次重大简化。DPO 从数学上证明,可以完全跳过单独的奖励建模步骤,直接基于人类偏好数据集优化策略。然而,2025 年之前的 DPO 严格来说是一种“离线”方法。PPO 和 DPO 都完全依赖静态的人工标注数据,这意味着模型永远无法真正超越人类的推理能力。为了突破这一天花板,行业不得不转向可验证奖励,以及我们今天看到的“在线”方法。
从偏好对齐到可验证奖励
现代 LLM 后训练最大的变化,并不只是各家公司用上了“更多 RL”。更深层的变化在于,奖励信号本身变得更加多元。早期的 RLHF 主要针对人类的偏好进行优化:清晰、有用、无害以及对话语气。这固然有价值,却无法为模型提供一种可靠的途径,去发现超出人类能轻松判断范围的答案。
现代推理系统会结合多种反馈。基于人类偏好的奖励在对齐和风格上依然重要。直接偏好优化(DPO)通过从偏好对中学习来简化这一过程,无需运行完整的 PPO 循环。基于 AI 反馈的强化学习(RLAIF)则用 AI 撰写的评审意见取代部分人类判断,这些评审通常以一部“宪法”或评分细则为指导。基于可验证奖励的强化学习(RLVR)更进一步:它奖励那些可以用规则检验的答案,例如数学解答、能通过测试的代码,或符合预期格式的结构化输出。
此外,还有一类日益重要的环境奖励。模型不再去询问人类或奖励模型某个回答好不好,而是直接在外部系统中行动。编译器可以检查生成的代码能否运行,单元测试可以验证补丁是否有效。定理检查器、搜索系统、浏览器或工具使用环境,都能提供比偏好标签更扎实的反馈。
另一个重要区分是结果奖励与过程奖励。结果奖励只评判最终答案:证明是否完成?代码是否通过?数字是否吻合?过程奖励则试图评估推理的中间步骤。“验证器–修订器”系统是一种近似实现过程监督的实用方法,无需人工逐步标注每一个步骤。
这一区分之所以重要,是因为训练时的 RL 与测试时计算相互关联,但并不相同。训练时的 RL 会改变模型的权重;测试时计算则为模型提供更多推理预算,让它在作答前进行采样、验证、修订或搜索。最强的前沿推理系统通常两者兼用:RL 教会模型有用的推理行为,而推理阶段的额外算力则为这些行为提供充分施展的空间。
前沿模型的推理革命(2025–2026)
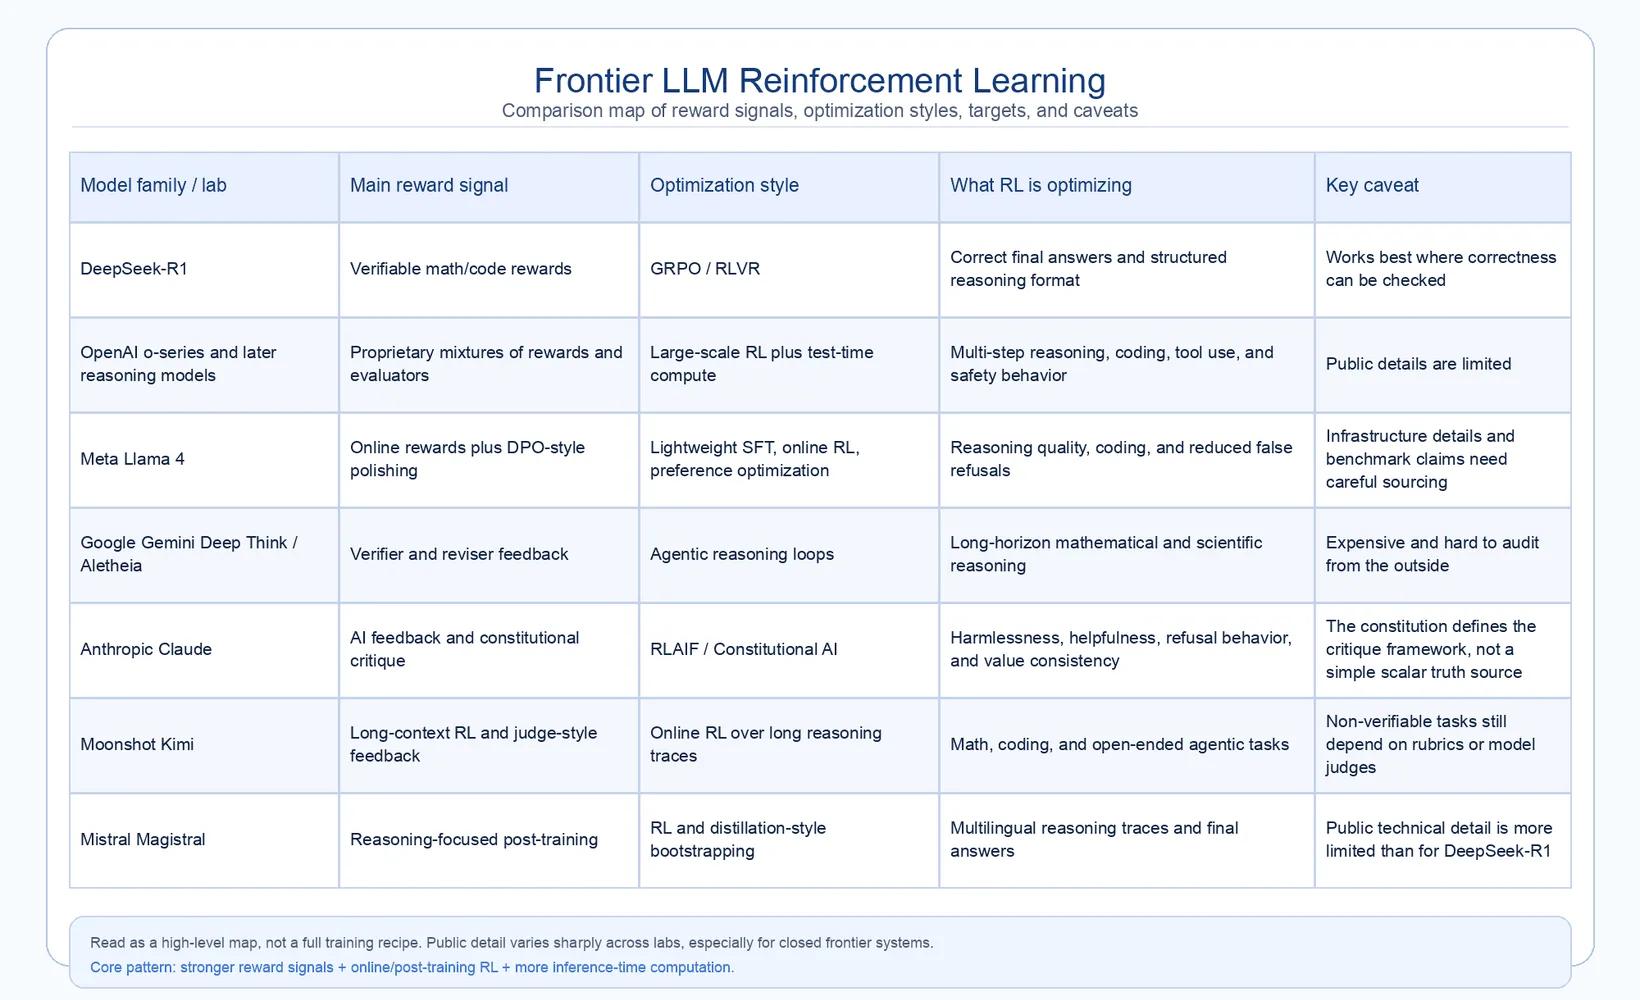
近期研究表明,模型在解决复杂数学问题、生成代码和逻辑分析方面的重大飞跃,并不仅仅来自规模的扩大,还取决于更强的后训练、更好的奖励信号以及推理阶段更多的计算。面对同一个核心挑战——如何为超大规模语言模型提供丰富而稳定的反馈——各家公司给出了各具特色的答案。
DeepSeek:可验证奖励与 GRPO
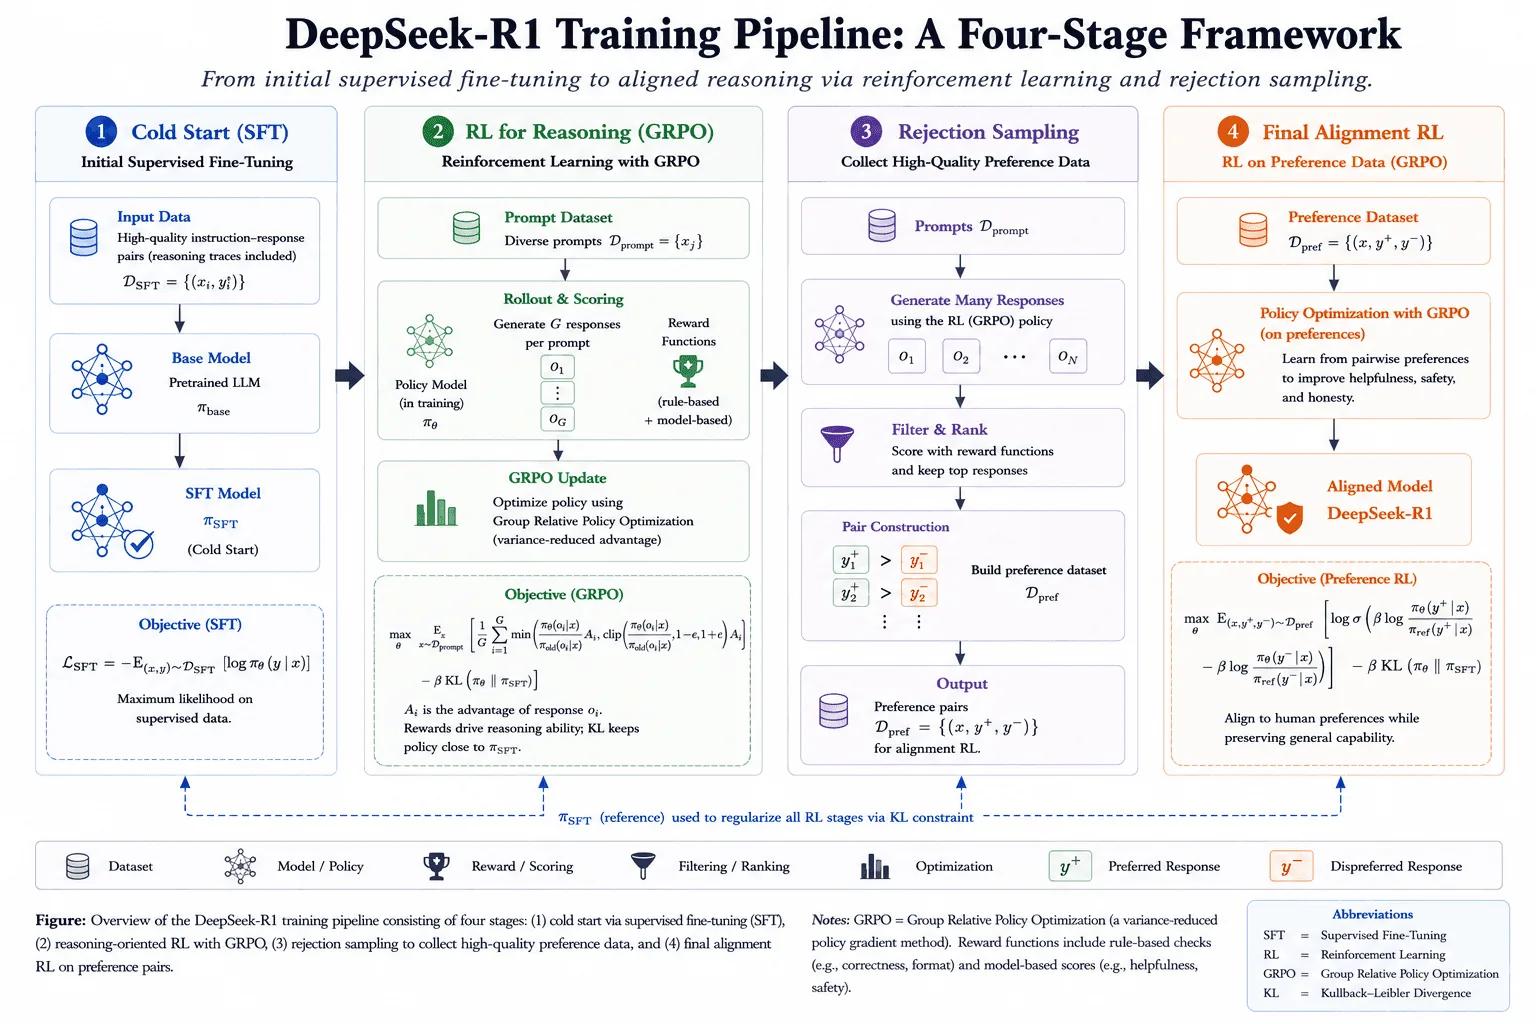
DeepSeek-R1 及其前身 DeepSeek-R1-Zero 让 RLVR 范式广为人知。DeepSeek 的研究人员挑战了自 InstructGPT 以来沿用的传统方法,通过 R1-Zero 证明:即便没有初始的监督微调阶段,只靠大规模强化学习,基础模型也能涌现出高级推理能力。他们用数万步 RL 训练了一个 320 亿参数的模型(Qwen-32B-Base),结构化的思考行为随之自发出现——尽管起初略显杂乱,还会混用多种语言。
随后,最终的 DeepSeek-R1 流水线又加入了冷启动监督数据、拒绝采样以及额外的对齐阶段,使模型行为更易读、更稳定,在实际应用中也更有用。
为了稳定训练并扩展到最终的 DeepSeek-R1 模型,团队采用了一种名为组相对策略优化(Group Relative Policy Optimization,GRPO)的特定算法。旧的 PPO 标准需要一个庞大的“Critic”模型来计算基线分数,而 GRPO 则轻量得多:它针对同一个 prompt 采样一组不同的回答,并让这些回答相互比较打分。
由此形成的优化目标会相对于同组其他回答,重罚差的回答、奖励好的回答,同时限制更新幅度,以避免灾难性遗忘。凭借这种效率,DeepSeek 仅用常规算力的一小部分,便能与庞大的闭源模型同台竞争。
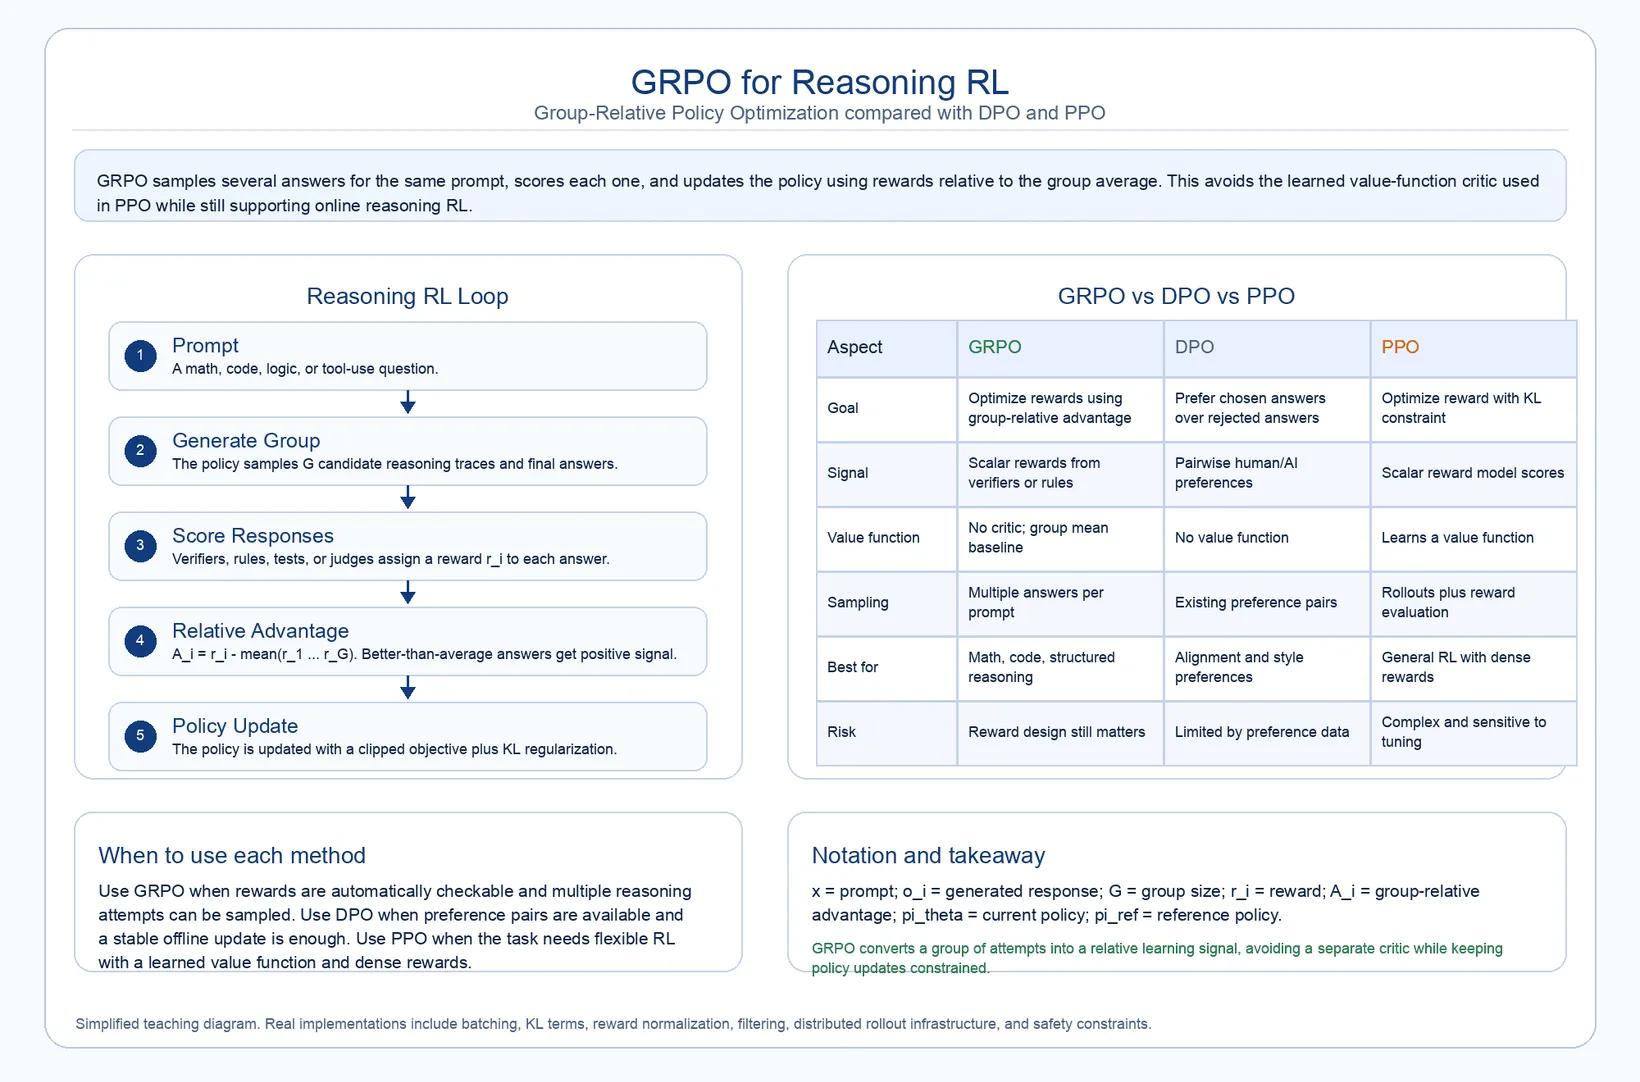
GRPO 的成功在很大程度上得益于基于可验证奖励的强化学习(RLVR)。DeepSeek 没有依赖人类评审或 AI 奖励模型(后者很容易被欺骗或“攻破”),而是采用了严格的基于规则的奖励,主要包括准确性奖励和格式奖励两类。准确性奖励检查最终答案是否完全正确(例如代码是否通过单元测试);格式奖励则强制模型把内部思考过程写在严格的 XML 标签内,确保思维链清晰可读、结构分明。
该方法后来演进为 GRPO-$\lambda$。研究人员发现,严格惩罚模型输出过长的答案(以防其无休止地思考)会导致训练早期准确率骤降。GRPO-$\lambda$ 通过动态调整惩罚解决了这一问题:当模型答错时,它会暂时不再在意长度,让模型能够自由地探索解法。这一巧妙调整提升了模型在 AIME 2024 和 GSM8K 等高难度基准上的准确率,同时出人意料地将平均回答长度缩短了一半。
OpenAI:动态推理、Makora 与安全
OpenAI 的生态——包括“o”系列以及后续的前沿推理模型——将强化学习推向了需要模型在作答前进行更长时间推理的领域。OpenAI 不仅将其用于抽象思考,还用于为硬件加速器编写代码、增强对网络攻击的防御。推理模型背后的核心理念依托于二维扩展定律:在 RL 训练中投入的算力越多,以及测试时给予模型的推理时间越长(测试时计算),模型的准确率就越可能提升。
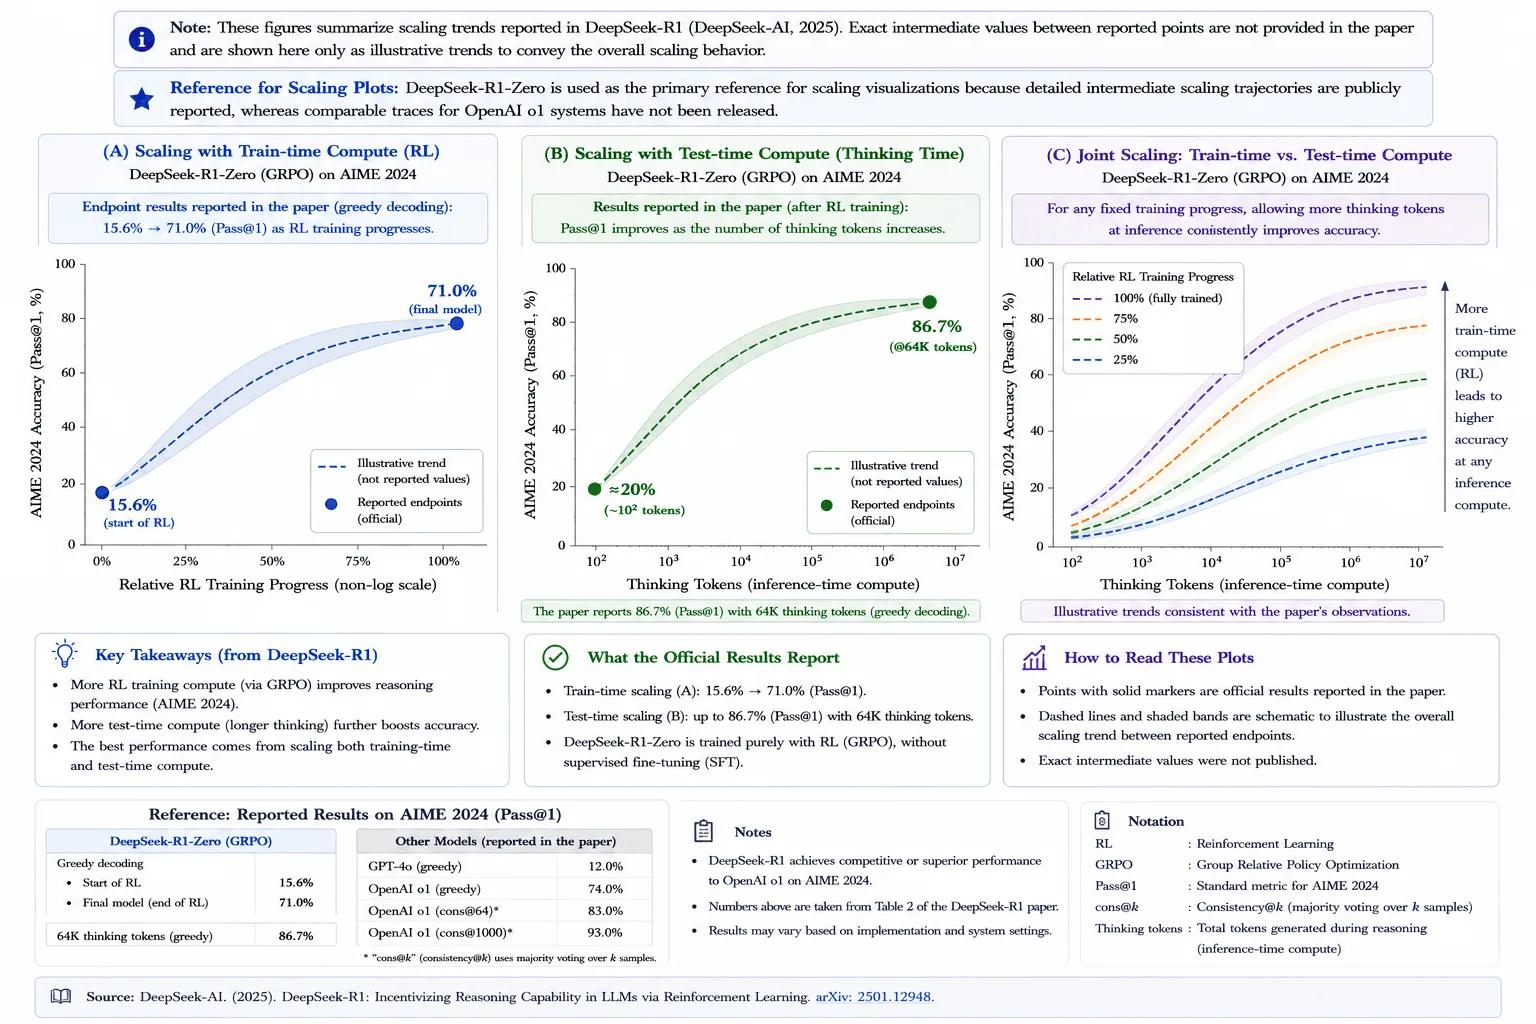
此图使用 DeepSeek-R1-Zero 的扩展曲线,作为说明训练时/测试时扩展这一通用理念的公开参照。OpenAI 曾描述其推理模型存在定性上相似的行为,但并未公开同等详细的中间扩展曲线。
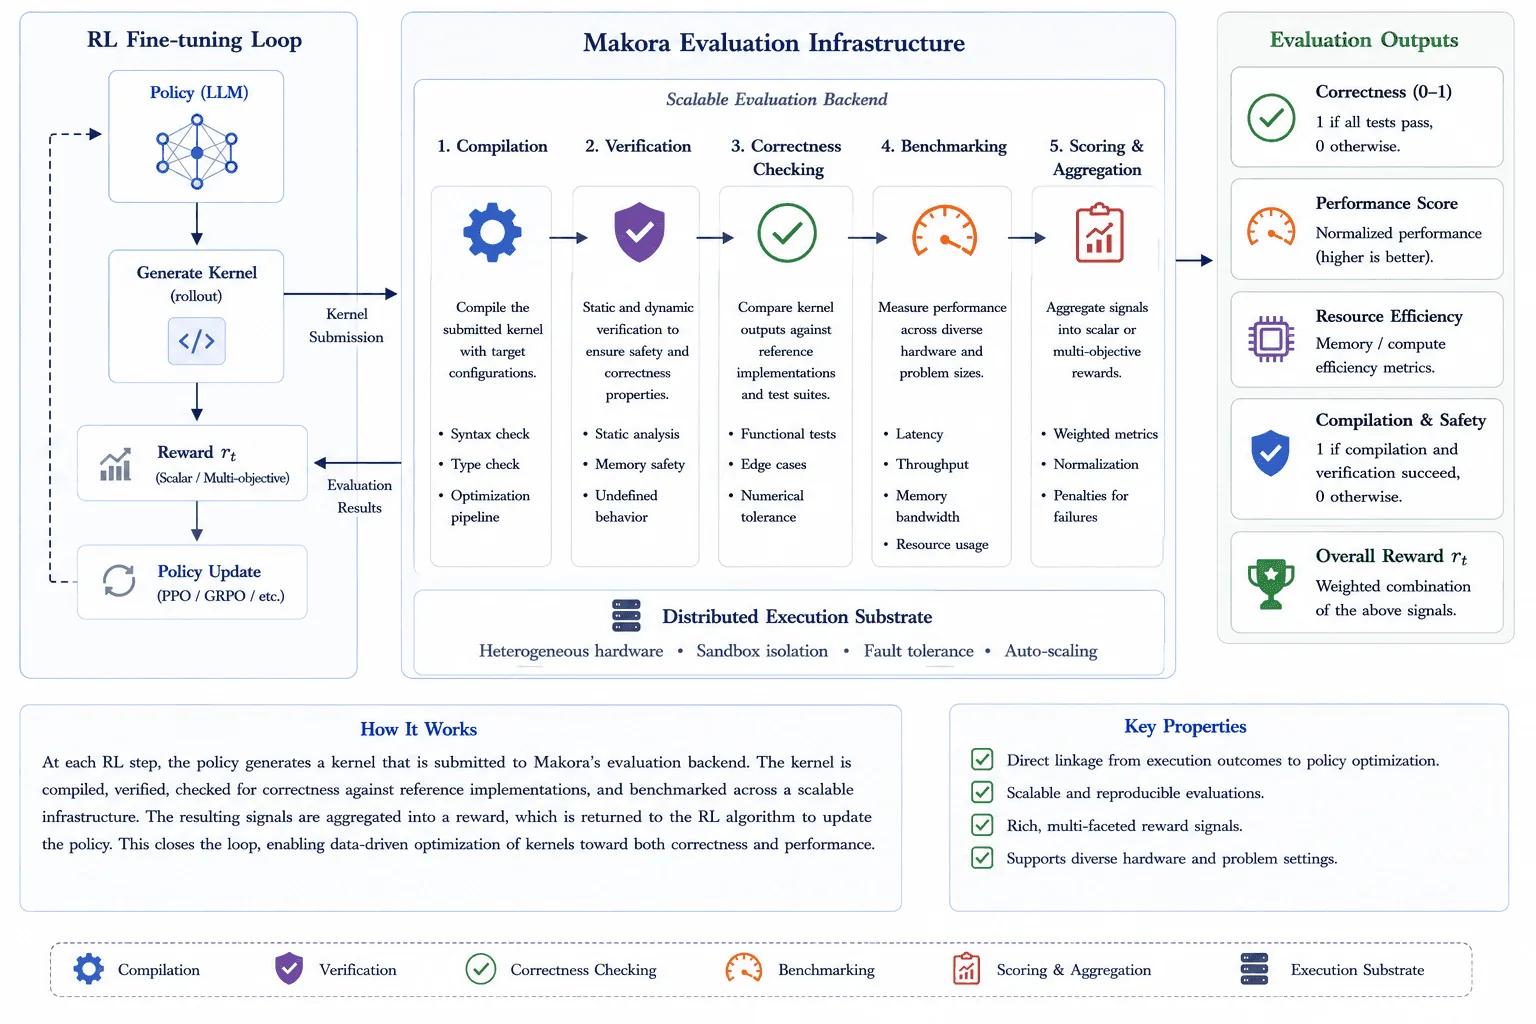
公开的结果说明了这一范式为何如此有影响力。在数学和科学基准上,深度 RL 加上推理阶段的额外计算,似乎让推理模型远远超越了普通的对话模型。但最有意思的应用,或许是在几乎没有人类训练数据的高度专业领域中使用 RL。借助名为 Makora 的评估系统,OpenAI 将编写内核代码(为硬件高度优化的代码)视为一个纯粹的 RL 问题。
LLM 先写出一段候选代码,发送到后端系统进行编译、检查能否正常运行,并测量运行速度。运行越快,奖励越高。这样一来,真实世界的软件性能与模型的学习之间形成了直接闭环。借助这一技术,模型在大多数测试中写出的代码比标准编译器快一倍。
Meta Llama 4:异步优化与轻量 DPO
Meta 在 Llama 4 系列(包括 Scout 17B、Maverick 17B 和 Behemoth 288B 模型)上的做法,展示了为开源模型扩展在线强化学习的另一条路径。与过去依赖海量监督数据的模型不同,据披露,Llama 4 的后训练采用了一条精简而有针对性的流水线:少量轻量 SFT,随后是大量在线 RL,最后用直接偏好优化(DPO)进行打磨。
Llama 4 Maverick 后训练的一大技术亮点是其异步 RL 基础设施。通常,PPO 或 GRPO 等算法会在同一个服务器节点上生成文本并更新模型,这会形成瓶颈:训练用 GPU 在等待奖励计算时可能处于空闲状态。Meta 介绍称,他们对工作负载进行了拆分,让奖励计算独立运行,从而掩盖了评估代码测试等复杂奖励所需的时间。
在这一阶段,Meta 着重使用高难度 prompt。之后,最终的 DPO 层帮助打磨语气,并减少模型错误拒答安全问题的情况。这使 Llama 4 成为混合式后训练栈的一个典型案例:用 RL 塑造更难的推理行为,再用偏好优化打磨面向用户的表现。
Google Gemini Deep Think:自主研究与 Aletheia
Google DeepMind 的生态,特别是 Gemini Deep Think 及相关研究智能体,是强化学习应用于长周期科学推理最清晰的案例之一。许多模型优化的是单次回答,而 Deep Think 类系统则围绕由多个部分组成的自主智能体来组织推理。其中最先进的例子,是数学智能体 Aletheia。
Aletheia 证明数学问题时不依赖严格的形式化编程语言,而是完全使用自然英语。它采用由三部分组成的强化循环:Generator(生成器)、Verifier(验证器)和 Reviser(修订器)。面对一个难题定理时,模型会写出可能的解法。如果 Verifier 发现一个小错误,它不会直接丢弃整个答案,而是交给 Reviser 修正逻辑。只有出现严重且无法修复的错误时,答案才会被废弃。Aletheia 还能借助外部搜索和科学文献检索来验证论断,避免编造虚假引用。
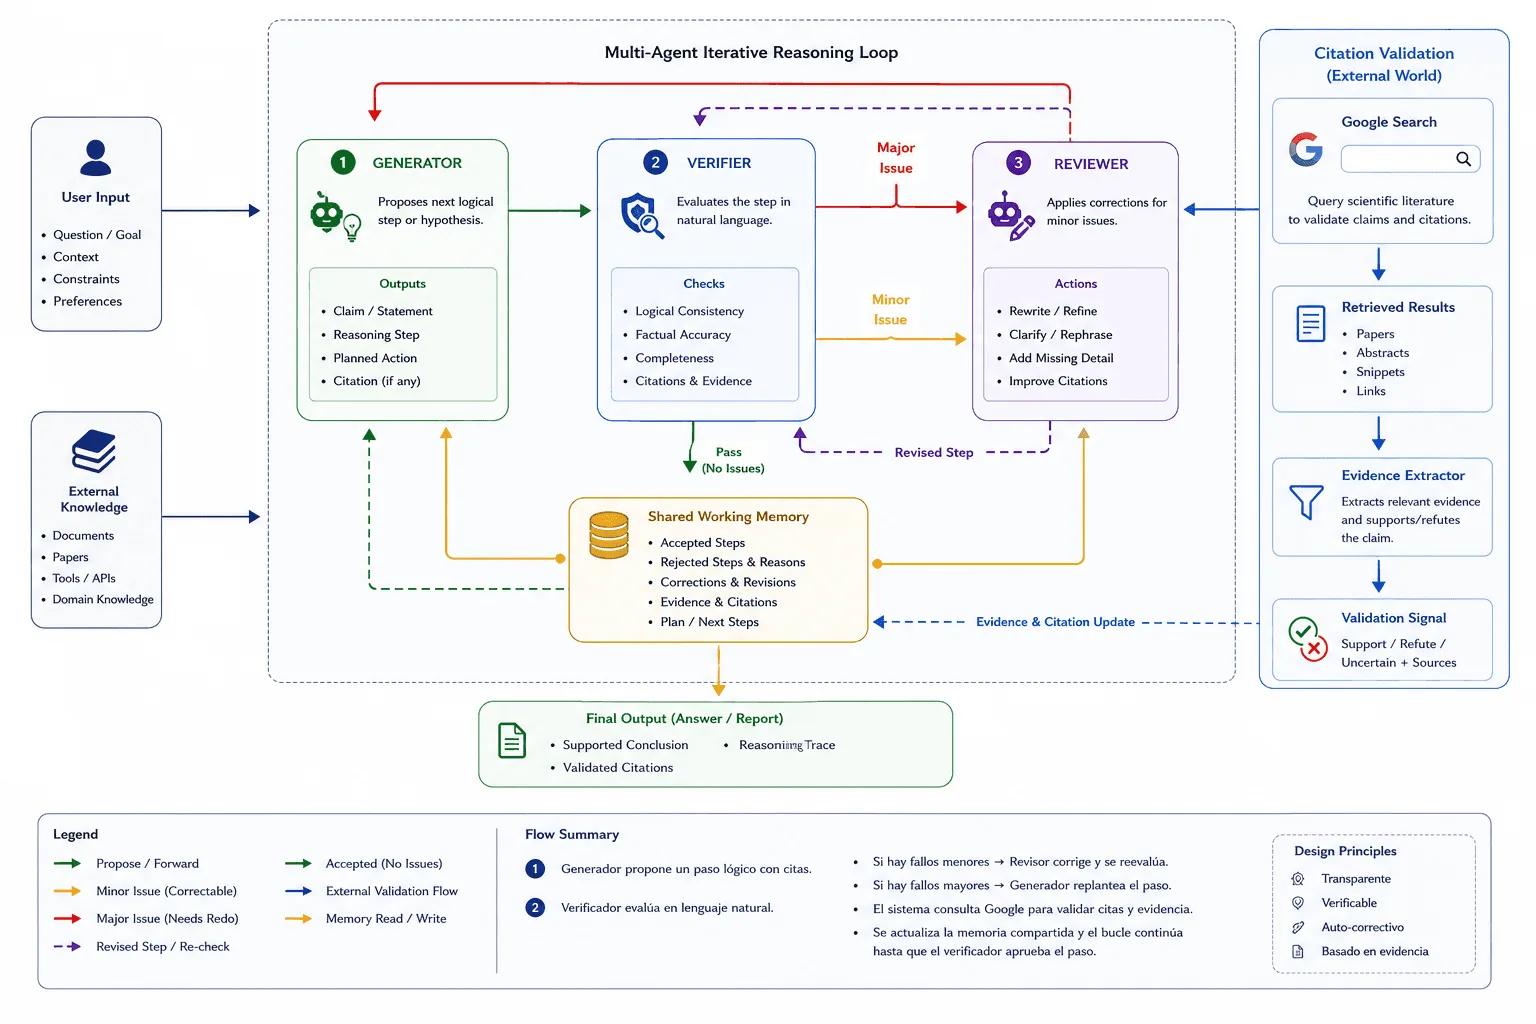
Aletheia 公布的结果表明,验证器–修订器循环可以让自然语言数学证明系统远超普通的单次生成,在高难度证明基准上尤为明显。更令人印象深刻的是,据称 Aletheia 能够产出有分量的数学研究成果,并对机器学习算法进行审查。关键的技术要点不只是分数,而是这个循环本身:生成、验证、修订,然后才接受证明。
Anthropic Claude:正式宪法与 RLAIF
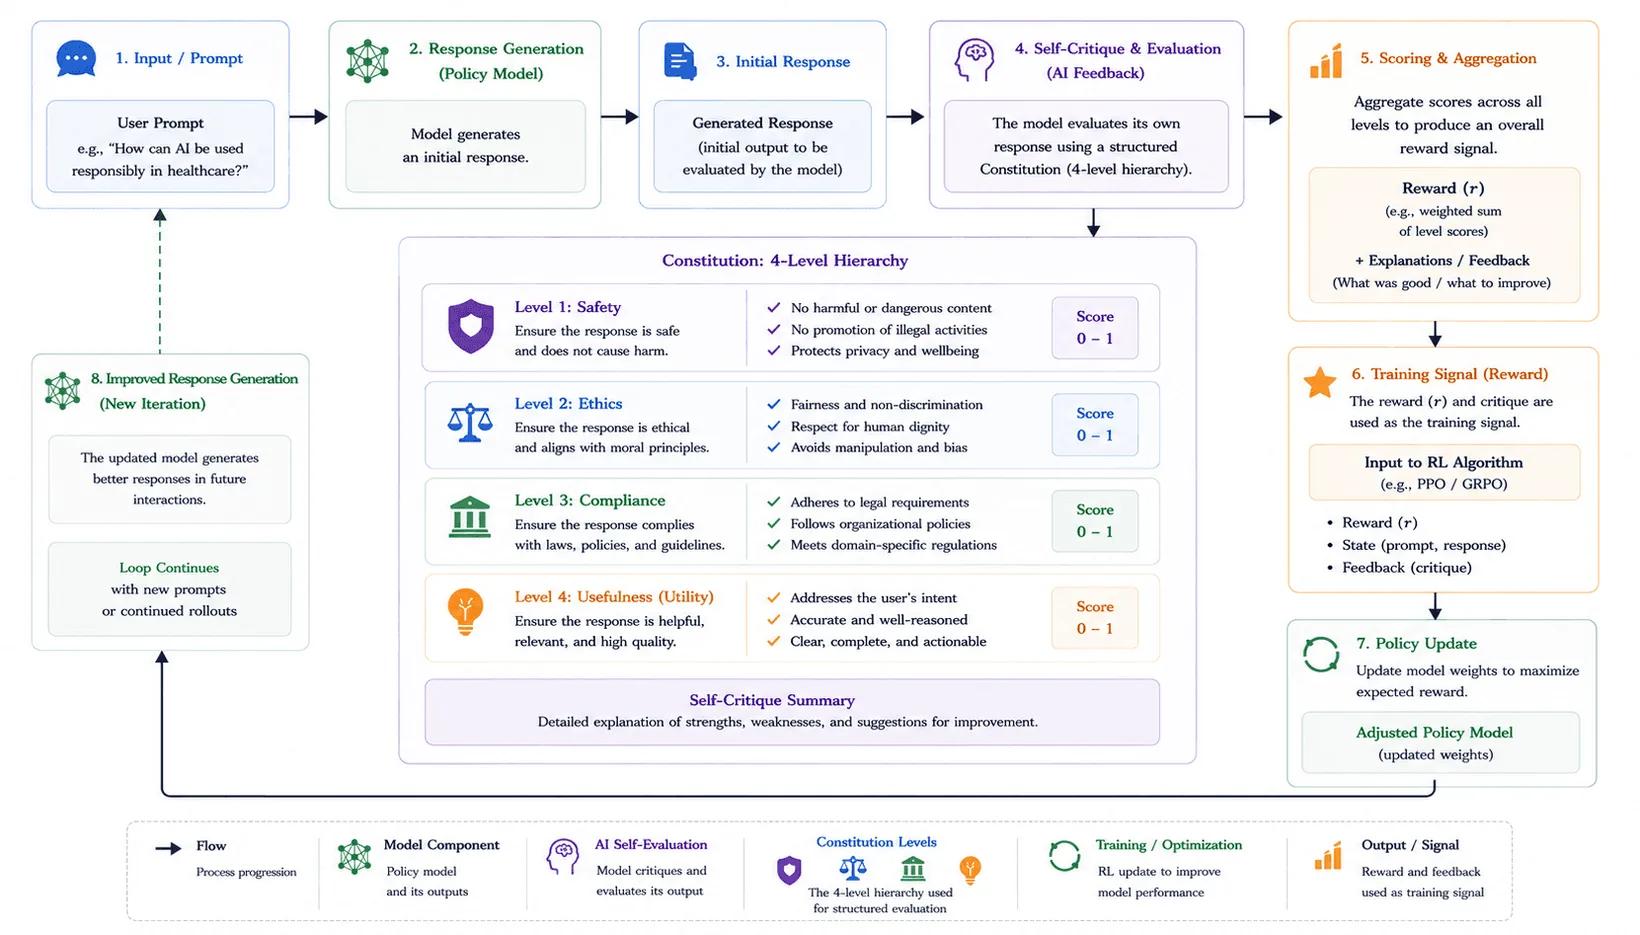
Anthropic 在 Claude 3.5 和 Claude 4 上的做法聚焦于宪法式 AI(Constitutional AI)。依靠成千上万名人工评审来判断哪个回答更好,不仅速度慢、容易带有偏见,而且在处理有害内容时十分困难。因此,Anthropic 改用一个由成文规则(即一部“宪法”)指导的 AI 模型。
这种方法被称为基于 AI 反馈的强化学习(RLAIF):它要求模型先生成回答,再依据明确的规则(如人权和效用原则)进行自我评审,并改写输出使其符合规则。这些打磨后的回答随后被用于更新模型。有证据显示,这种基于规则的技术可以达到甚至超越经典的人类反馈方法。更重要的是,它确保模型的核心价值观透明、易于审计,并且可以快速更新,而无需花费数月收集人类数据。
2026 年 1 月下旬,Anthropic 发布了这一框架的重大更新——“Claude's New Constitution”。它从简单的基于规则的方法,转向更注重说理的对齐文件,围绕安全、伦理、合规和有用性确立了优先级层次。宪法本身并不能神奇地解决对齐问题,它的作用是定义评审框架,用于在训练和评估过程中生成、筛选和排序回答。通过公开这份文件,Anthropic 也让外界更容易审视和讨论其对齐理念。
Moonshot AI Kimi:将 RL 扩展到不可验证任务
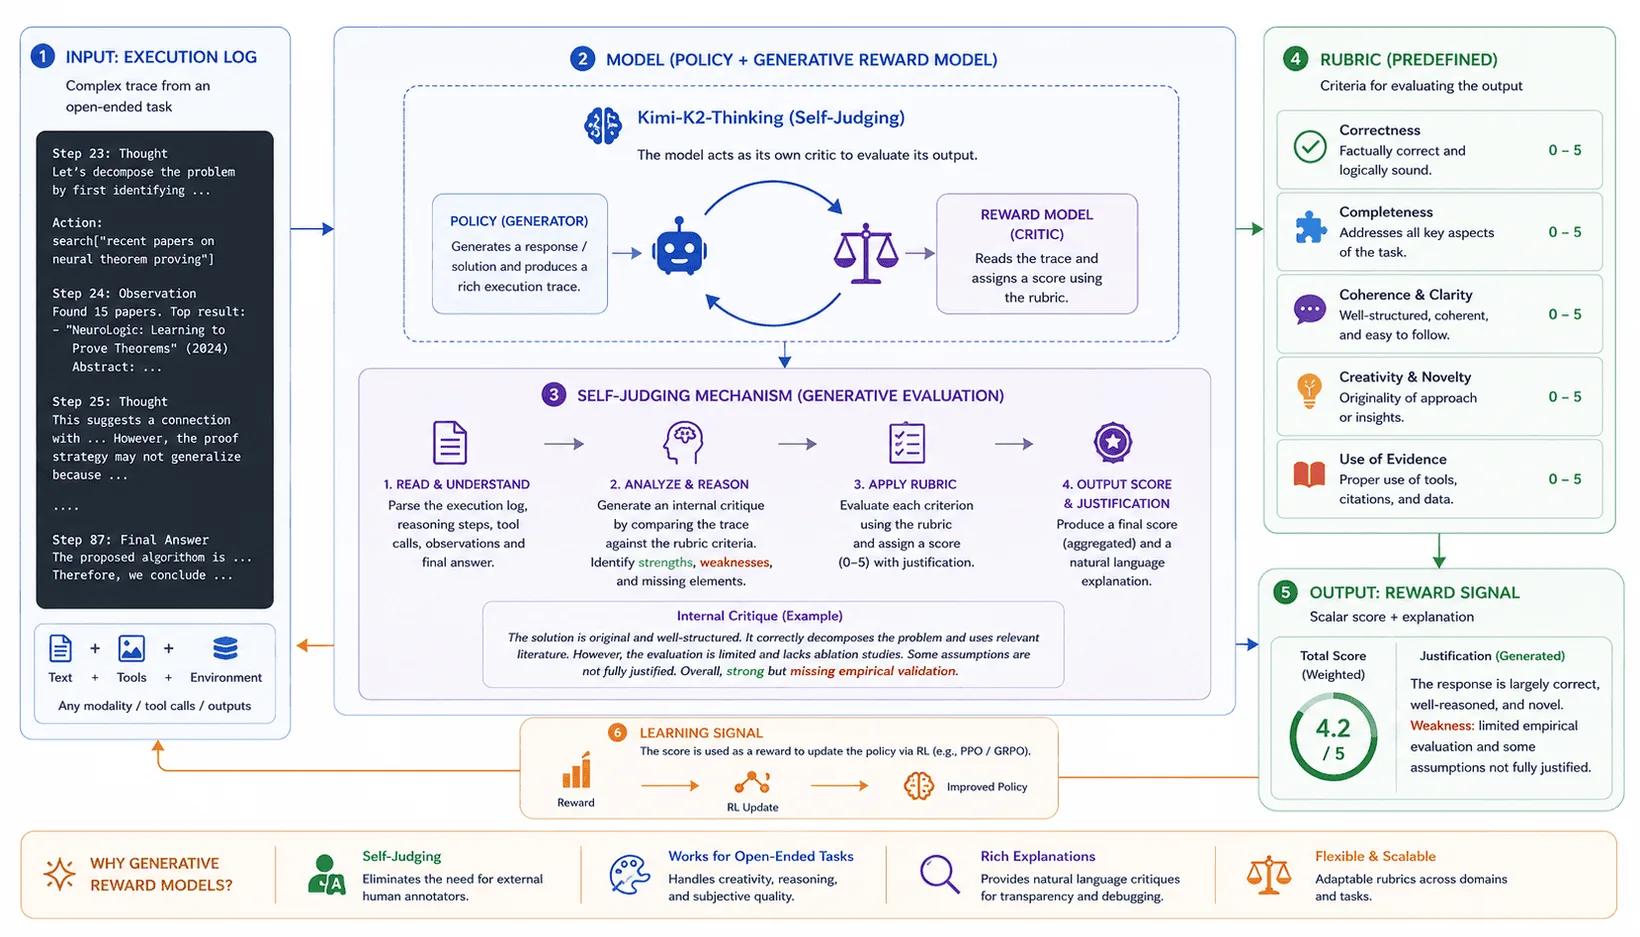
Moonshot AI 推出了 Kimi k1.5 和 K2,拓展了 RL 在严格的数学和编程之外所能达到的边界。长期以来,RL 面临的主要挑战是如何评估不可验证的任务,例如创意写作、搜索结果聚合或复杂报告生成——这些任务并不存在绝对的“对”或“错”。Moonshot 的解决之道,是在广泛的智能体行为中系统性地部署生成式奖励模型(GRM)。Kimi 不再使用简单的标量分数,而是借助一个基于 LLM 的“日志评审”(例如 Kimi-K2-Thinking),用自我评审细则来评估开放式生成内容,例如判断某份执行日志能否证明一个软件补丁成功消除了某种故障模式。
此外,Moonshot AI 发现,在 RL 阶段将上下文窗口扩展到 128k token,可以让模型自然地通过自回归预测在推理空间中进行隐式搜索。由此形成了一个简单却有效的 RL 框架。由于模型可以利用超长上下文来规划、反思和自我纠错,Kimi 在数学、编程和视觉-语言推理任务上都取得了出色成绩,而无需借助蒙特卡洛树搜索(MCTS)或传统过程奖励模型(PRM)等计算开销巨大的架构技巧。
Mistral AI:Magistral 与多语言推理
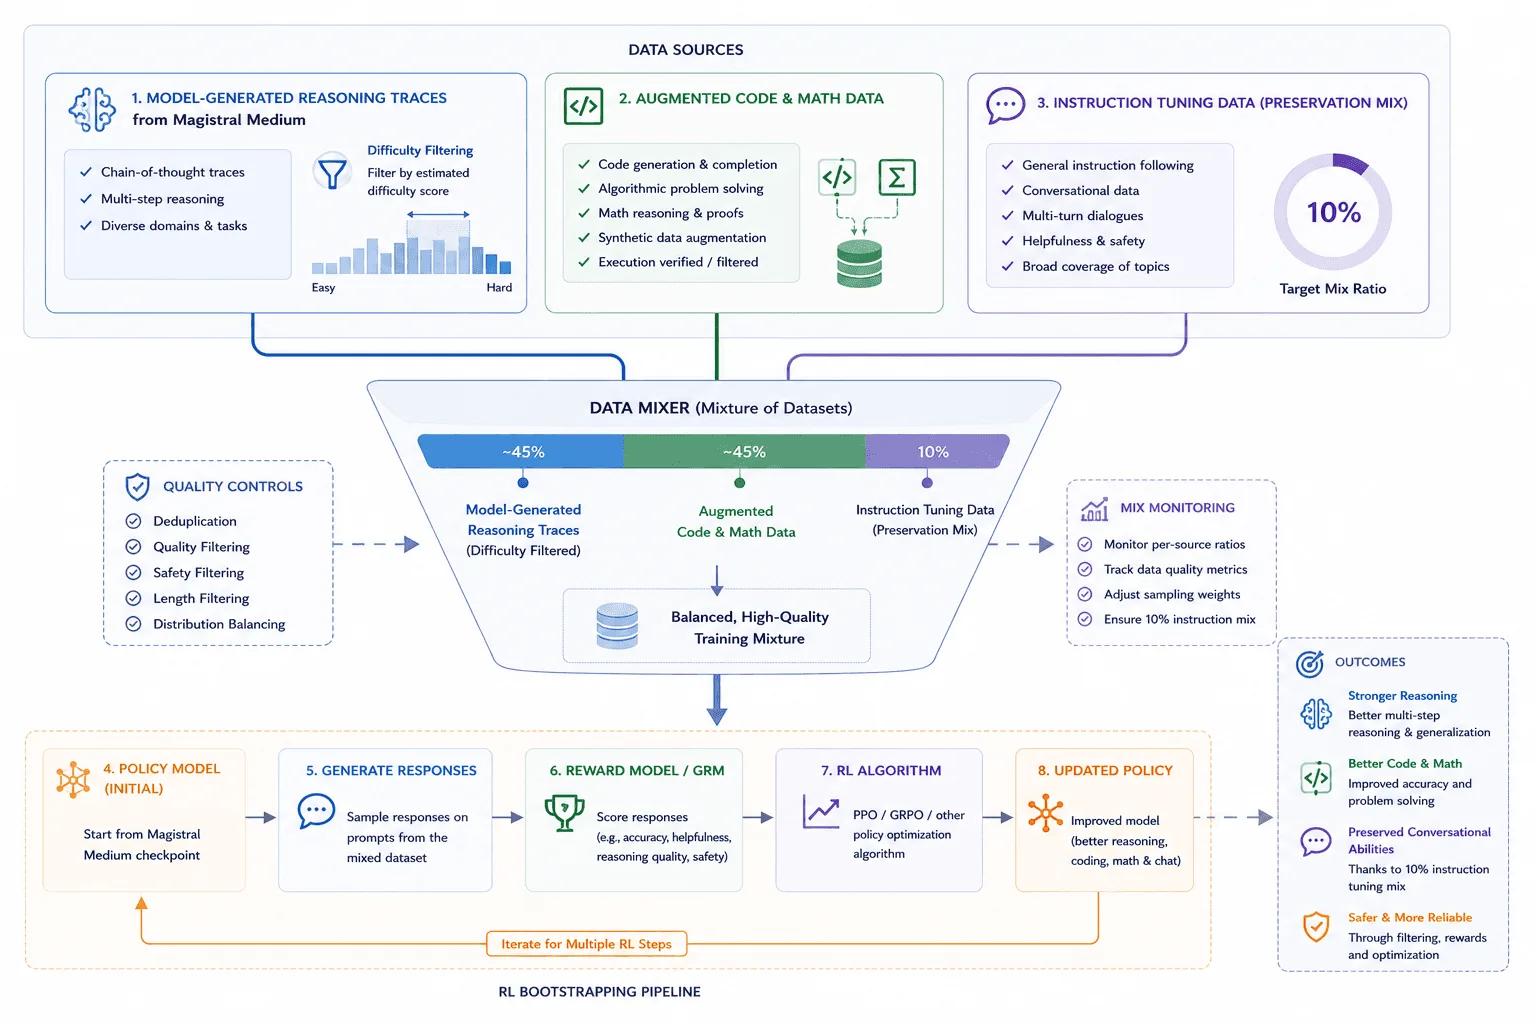
2025 年初,Mistral AI 发布了其首个原生推理模型 Magistral,正式加入前沿推理竞赛。该模型同时提供开源版本(Magistral Small,240 亿参数)和性能更强的企业版本(Magistral Medium),重点聚焦特定领域和多语言的思维链。
与完全依赖从更大的闭源模型中蒸馏推理轨迹的实验室不同,Mistral 采取了另一种思路。Magistral 被定位为 Mistral 前沿模型家族中专注推理的扩展,强化学习在其后训练中扮演核心角色。为了打造高效的 Magistral Small,Mistral 采用了一套精细的自举(bootstrapping)流水线:先用 Medium 模型生成推理轨迹,再进行筛选以保持难度的多样性,接着用 OpenThoughts 和 OpenR1 的数据子集进行扩充,并混入通用指令微调数据,确保模型不会丧失非推理类的对话能力。它最独特的特点或许是原生多语言策略:模型经过训练,能用用户指定的语言同时生成推理轨迹和最终回答,这表明高级推理并不一定只能用英语完成。
局限与待解问题
现代 RL 技术栈虽然强大,但并不能干净利落地解决推理问题。第一个局限是奖励欺骗(reward hacking)。如果模型找到了不解决真实任务也能满足奖励的方法,RL 就会强化这条捷径。当评估者是另一个模型而非确定性测试时,这种风险尤其突出。
第二个局限是对基准的过拟合。数学、编程和推理基准之所以有用,是因为它们提供了清晰的反馈,但同样的清晰也让针对它们的优化变得更容易。模型可能在某个基准上有所提升,却无法在纷繁复杂的真实任务中获得同等的稳健性。
第三个局限是可验证奖励分布不均。代码、数学和结构化输出通常可以自动检验,而开放式研究、长篇写作、产品规划和科学探索则难以打分得多。对于这类任务,各实验室仍需依赖评分细则、模型评审、人工审核或间接的环境信号。
此外还有成本问题。测试时计算可以让模型更充分地采样、修订和验证,从而提升准确率,但也会增加延迟和服务成本。这使得最强的推理模式难以在所有场景中普及部署。
最后,隐藏的思维链带来了审计难题。许多前沿系统可能会使用很长的内部推理轨迹,却不直接展示出来。这对安全和用户体验或许有利,但外界也因此更难审视模型究竟从 RL 中学到了什么。
结语
OpenAI、DeepMind、Meta、DeepSeek、Mistral、Moonshot 和 Anthropic 的案例表明,前沿 AI 的研发已从单纯依赖静态预训练,转向更具交互性的后训练技术栈。可验证奖励、在线优化、AI 反馈、自蒸馏、工具环境和测试时计算,如今正共同塑造着模型的推理方式。
模型不再只是记忆互联网上的模式。最强的系统经过训练和引导,会投入更多算力去验算数学、调试代码、使用工具、修订计划并校验中间步骤。强化学习并不是这场变革的唯一要素,但它已成为核心机制之一,将原始的语言模型转变为能够搜索、验证并改进自身答案的系统。
参考文献
基础:RLHF、DPO 与 AI 反馈
Ouyang et al., 2022. Training language models to follow instructions with human feedback. InstructGPT 论文,奠定了 SFT -> 奖励模型 -> PPO 的经典对齐流程。
Bai et al., 2022. Constitutional AI: Harmlessness from AI Feedback. Anthropic 关于 RLAIF / 宪法式 AI 的原始论文。
Rafailov et al., 2023. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. DPO 核心论文,有助于理解无需显式训练奖励模型的离线偏好优化。
Anthropic, 2023. Claude's Constitution. 指导 Claude 式宪法评审的原则公开版本。
Anthropic, 2026. Claude's New Constitution. 更新后的公开宪法,有助于理解从规则清单转向更广泛的基于说理的对齐。
推理 RL 与可验证奖励
OpenAI, 2024. Learning to Reason with LLMs. OpenAI 关于 o1 式推理、RL 训练和测试时计算的一手资料。
DeepSeek-AI, 2025. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 关于 DeepSeek-R1、DeepSeek-R1-Zero、GRPO 以及 RLVR 式推理训练的一手资料。
Yue et al., 2025. Stable Reinforcement Learning for Efficient Reasoning. 提出 GRPO-$\lambda$,并探讨如何在推理 RL 中稳定长度惩罚。
Moonshot AI, 2025. Kimi k1.5: Scaling Reinforcement Learning with LLMs. 关于 Kimi 长上下文 RL 与扩展方法的一手资料。
Label Studio, 2025. Reinforcement Learning from Verifiable Rewards. 关于 RLVR 的二手解读;适合作为通俗易懂的概念概述,但不宜作为主要证据来源。
前沿模型案例研究
Meta AI, 2025. The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation. 关于 Llama 4 后训练的一手资料,涵盖轻量 SFT、在线 RL 和 DPO 式打磨。
Mistral AI, 2025. Magistral. 关于 Mistral 推理模型家族、多语言推理重点以及 RL/后训练思路的一手资料。
Google DeepMind, 2026. Accelerating Mathematical and Scientific Discovery with Gemini Deep Think. DeepMind 关于 Gemini Deep Think 及其科学推理能力的一手资料。
Feng et al., 2026. Towards Autonomous Mathematics Research. 介绍基于 Gemini Deep Think 构建的数学研究智能体 Aletheia 的研究论文。
Feng et al., 2026. Aletheia tackles FirstProof autonomously. Aletheia 在 FirstProof 挑战中的后续评估。
Tehrani et al., 2026. Fine-Tuning GPT-5 for GPU Kernel Generation. Makora 关于利用可验证奖励进行 RL 微调以生成 GPU 内核的论文。
Makora, 2026. We RL'd GPT-5 to Write Better Kernels. Makora GPU 内核 RL 工作的配套博客文章。
实用背景与延伸阅读
Decode the Future, 2024. RLHF explained. 面向希望了解较少技术细节的读者的 RLHF 通俗入门。
Le Wagon, 2025. OpenAI o1 and o3 explained: how thinking models work. 关于推理模型概念的二手概述;有助于建立直觉,但可信度不及模型和论文的一手资料。
