

Aprendizado por reforço nos LLMs de fronteira: do RLHF às recompensas verificáveis
 Toni Lopez Co-Founder at Karumi
A arquitetura e os métodos por trás dos grandes modelos de linguagem (LLMs) passaram por uma grande transformação entre 2025 e 2026. Antes, construir um modelo fundacional significava depender principalmente de um pré-treinamento massivo com enormes volumes de dados brutos. Em seguida, costumava vir uma fase básica de alinhamento com ajuste fino supervisionado (SFT) e aprendizado por reforço a partir de feedback humano (RLHF). No entanto, à medida que os dados de treinamento de alta qualidade disponíveis na internet começaram a se esgotar e cresceu a necessidade de uma IA com capacidade real de raciocínio, o setor precisou mudar de abordagem.
Pesquisadores e empresas de tecnologia passaram a dedicar mais atenção e poder computacional ao pós-treinamento interativo e ao "test-time compute" (dar aos modelos mais tempo para processar e pensar antes de responder). Nesse novo cenário, o aprendizado por reforço (RL) deixou de ser apenas uma ferramenta para ajustar o tom de um modelo ou filtrar respostas ruins. Ele se tornou um dos principais motores do pós-treinamento, especialmente para modelos que precisam planejar, verificar etapas intermediárias, usar ferramentas e aprimorar suas respostas por meio de cadeias de raciocínio mais longas.
O estado da arte atual, moldado pelos modelos de fronteira de organizações como OpenAI, Meta, Google DeepMind, Anthropic, DeepSeek, Moonshot AI e Mistral, mostra uma enorme variedade na forma de aplicar algoritmos de otimização de política. O setor vem complementando cada vez mais os modelos de recompensa neurais com sistemas de recompensas verificáveis, otimização assíncrona de preferências, crítica baseada em modelos e feedback do ambiente.
Este relatório detalha como o aprendizado por reforço é aplicado nos principais modelos atuais.
O "paradigma clássico": RLHF antes de 2025
Antes da grande virada de 2025, a forma padrão de alinhar LLMs era fortemente influenciada pelo InstructGPT, da OpenAI. Essa abordagem clássica se baseava no aprendizado por reforço a partir de feedback humano (RLHF) e seguia um processo rígido de três etapas. Primeiro, o modelo passava por um ajuste fino supervisionado (SFT) com exemplos escritos por anotadores humanos. Depois, um modelo de recompensa (RM) separado era treinado com conjuntos de dados de preferências humanas para prever quais respostas as pessoas preferiam. Por fim, o modelo SFT era otimizado em relação a esse modelo de recompensa usando Proximal Policy Optimization (PPO), um algoritmo que atualiza a política durante a execução.
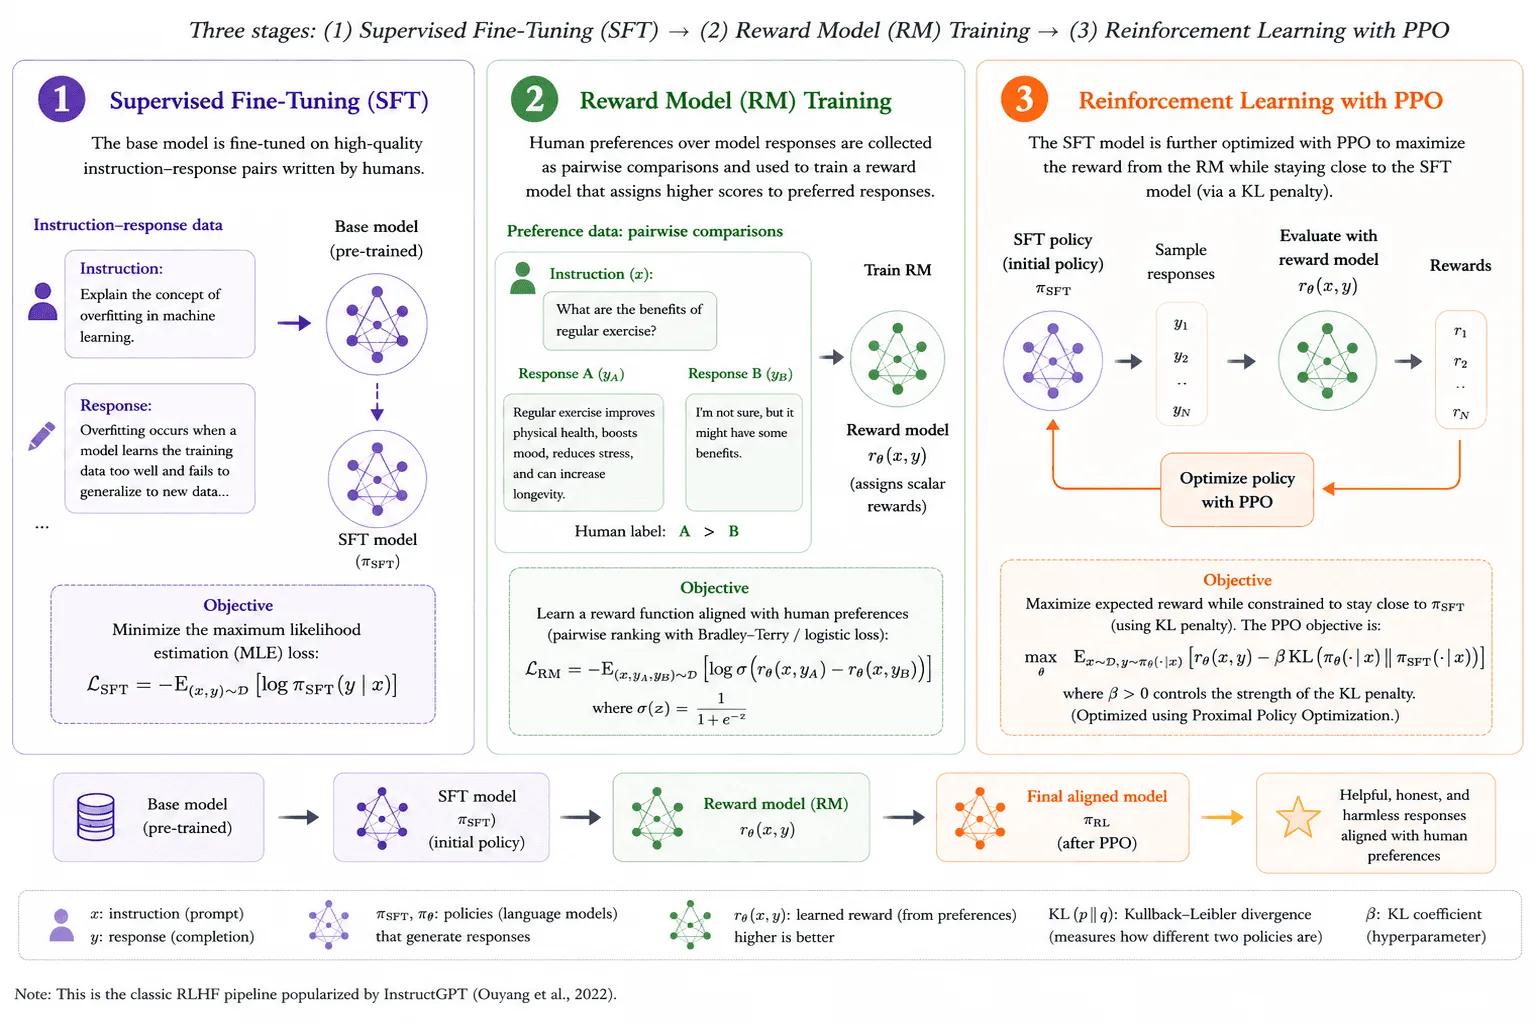
Embora funcionasse bem para ajustes básicos de tom e para seguir instruções simples, o RLHF clássico tinha falhas sérias. Ele sofria com a chamada "alignment tax", um problema em que otimizar um modelo para soar educado ou seguro prejudicava ativamente sua capacidade de raciocínio e suas competências acadêmicas. Além disso, o PPO era notoriamente complexo e exigia uma quantidade enorme de memória, já que vários modelos (Actor, Critic, Reference e Reward) precisavam rodar ao mesmo tempo.
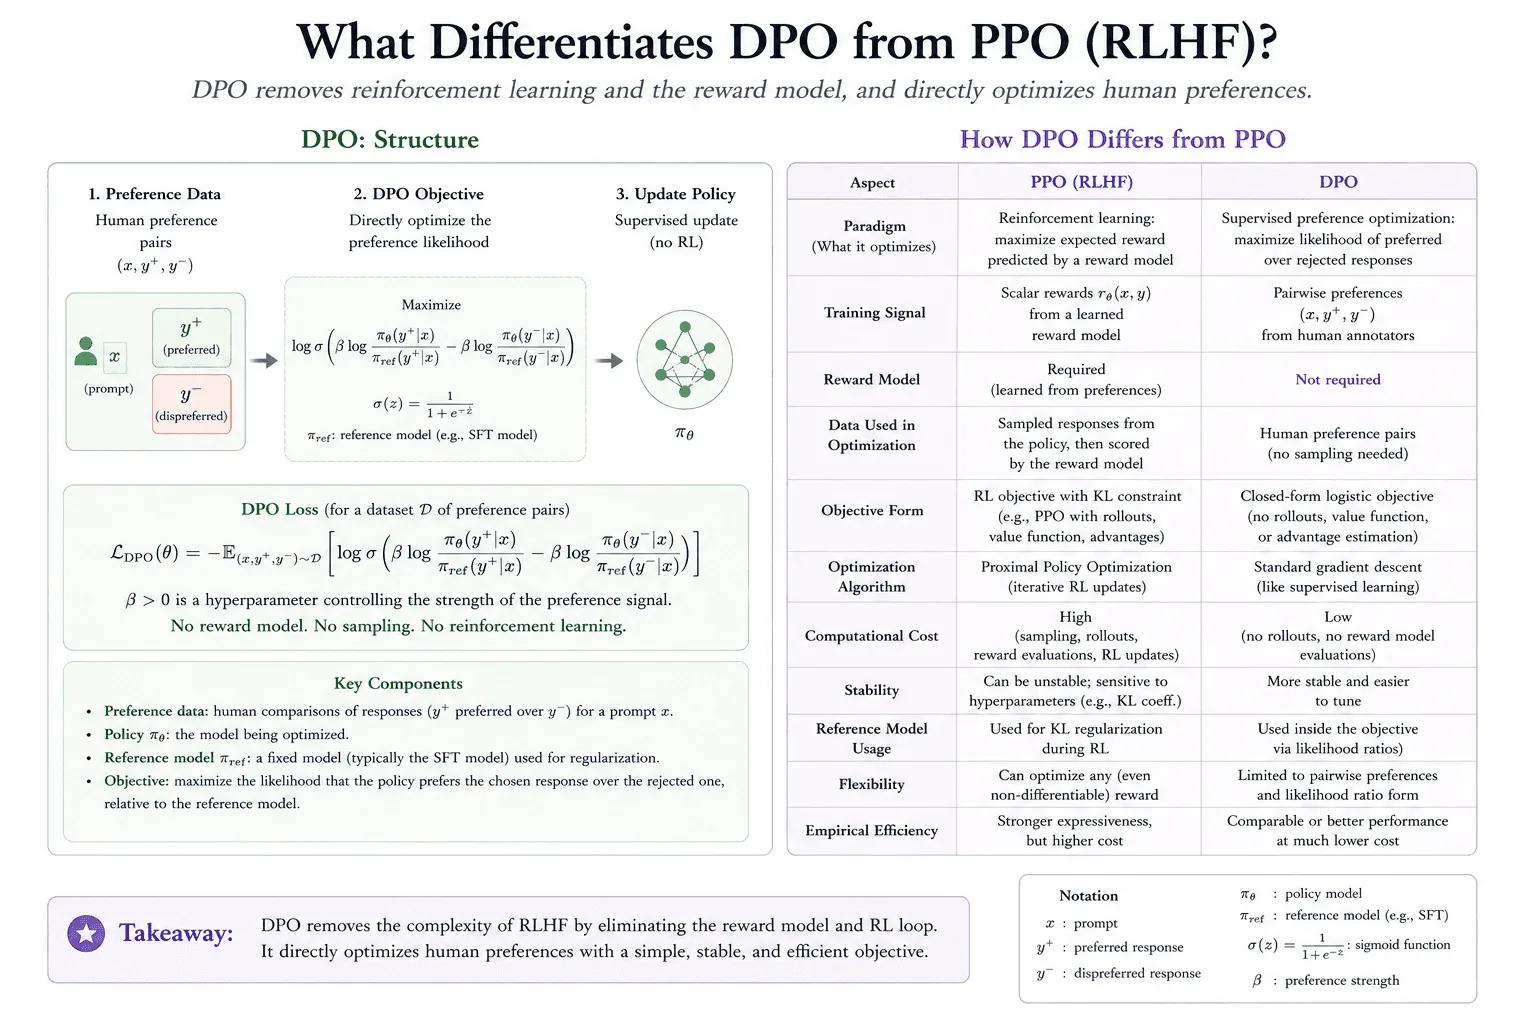
No fim de 2023, a Direct Preference Optimization (DPO) trouxe a primeira grande simplificação. A DPO provou matematicamente que a etapa separada de modelagem de recompensa podia ser totalmente eliminada, permitindo otimizar a política diretamente a partir de conjuntos de dados de preferências humanas. Porém, antes de 2025, a DPO era um método estritamente "offline". Tanto o PPO quanto a DPO dependiam inteiramente de dados estáticos anotados por humanos, o que significava que os modelos nunca conseguiriam superar de fato a capacidade de raciocínio humana. Para romper esse teto, o setor precisou migrar para recompensas verificáveis e para os métodos "online" que vemos hoje.
Do alinhamento por preferências às recompensas verificáveis
A maior mudança no pós-treinamento dos LLMs modernos não é simplesmente que as empresas usam "mais RL". A mudança mais profunda é que o próprio sinal de recompensa ficou mais diverso. O RLHF inicial otimizava principalmente o que as pessoas preferiam: clareza, utilidade, inocuidade e tom conversacional. Isso era útil, mas não dava ao modelo uma forma confiável de descobrir respostas além do que os humanos conseguiam avaliar com facilidade.
Os sistemas de raciocínio modernos combinam vários tipos de feedback. As recompensas baseadas em preferências humanas continuam importantes para alinhamento e estilo. A Direct Preference Optimization (DPO) simplifica isso ao aprender com pares de preferência sem rodar um ciclo completo de PPO. O aprendizado por reforço a partir de feedback de IA (RLAIF) substitui parte dos julgamentos humanos por críticas escritas por IA, muitas vezes guiadas por uma constituição ou rubrica. O aprendizado por reforço a partir de recompensas verificáveis (RLVR) vai além: recompensa respostas que podem ser checadas por regras, como soluções matemáticas, código que passa nos testes ou saídas estruturadas que seguem um formato esperado.
Há também uma categoria crescente de recompensas de ambiente. Em vez de perguntar a uma pessoa ou a um modelo de recompensa se uma resposta é boa, o modelo atua dentro de um sistema externo. Um compilador pode verificar se o código gerado roda. Testes unitários podem validar um patch. Um verificador de teoremas, um sistema de busca, um navegador ou um ambiente de uso de ferramentas pode fornecer um feedback mais concreto do que um rótulo de preferência.
Outra divisão importante é entre recompensas de resultado e recompensas de processo. As recompensas de resultado avaliam apenas a resposta final: a prova foi concluída, o código passou, o número bateu? As recompensas de processo tentam avaliar as etapas intermediárias do raciocínio. Sistemas verificador-revisor são uma forma prática de aproximar a supervisão de processo sem exigir que humanos rotulem cada etapa manualmente.
Essa distinção importa porque o RL no treinamento e o test-time compute são relacionados, mas não idênticos. O RL no treinamento altera os pesos do modelo. O test-time compute dá ao modelo mais orçamento de inferência para amostrar, verificar, revisar ou buscar antes de responder. Os sistemas de raciocínio de fronteira mais fortes costumam combinar os dois: o RL ensina comportamentos de raciocínio úteis, enquanto a computação extra na inferência dá espaço para esses comportamentos se desenvolverem.
A revolução do raciocínio nos modelos de fronteira (2025-2026)
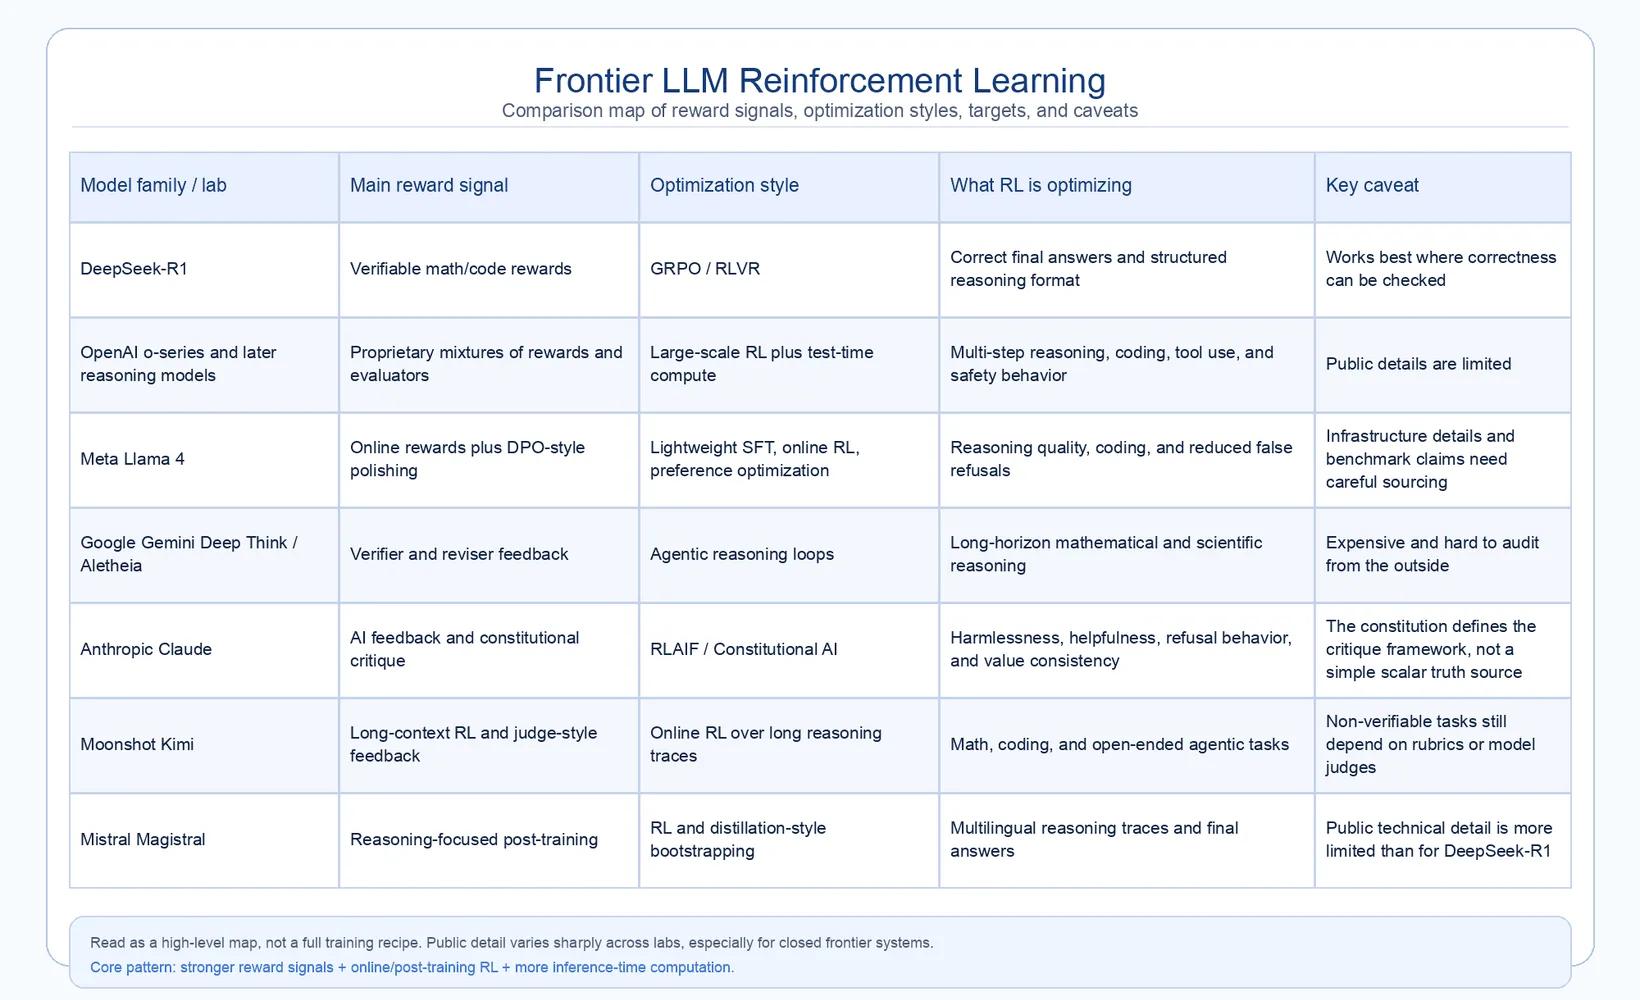
Pesquisas recentes sugerem que os grandes saltos na resolução de problemas matemáticos complexos, na geração de código e na análise lógica não vêm simplesmente de modelos maiores. Eles também dependem de um pós-treinamento mais robusto, de sinais de recompensa melhores e de mais computação na inferência. Cada empresa enfrentou à sua maneira o mesmo desafio central: fornecer feedback rico e estável a modelos de linguagem gigantescos.
DeepSeek: recompensas verificáveis e GRPO
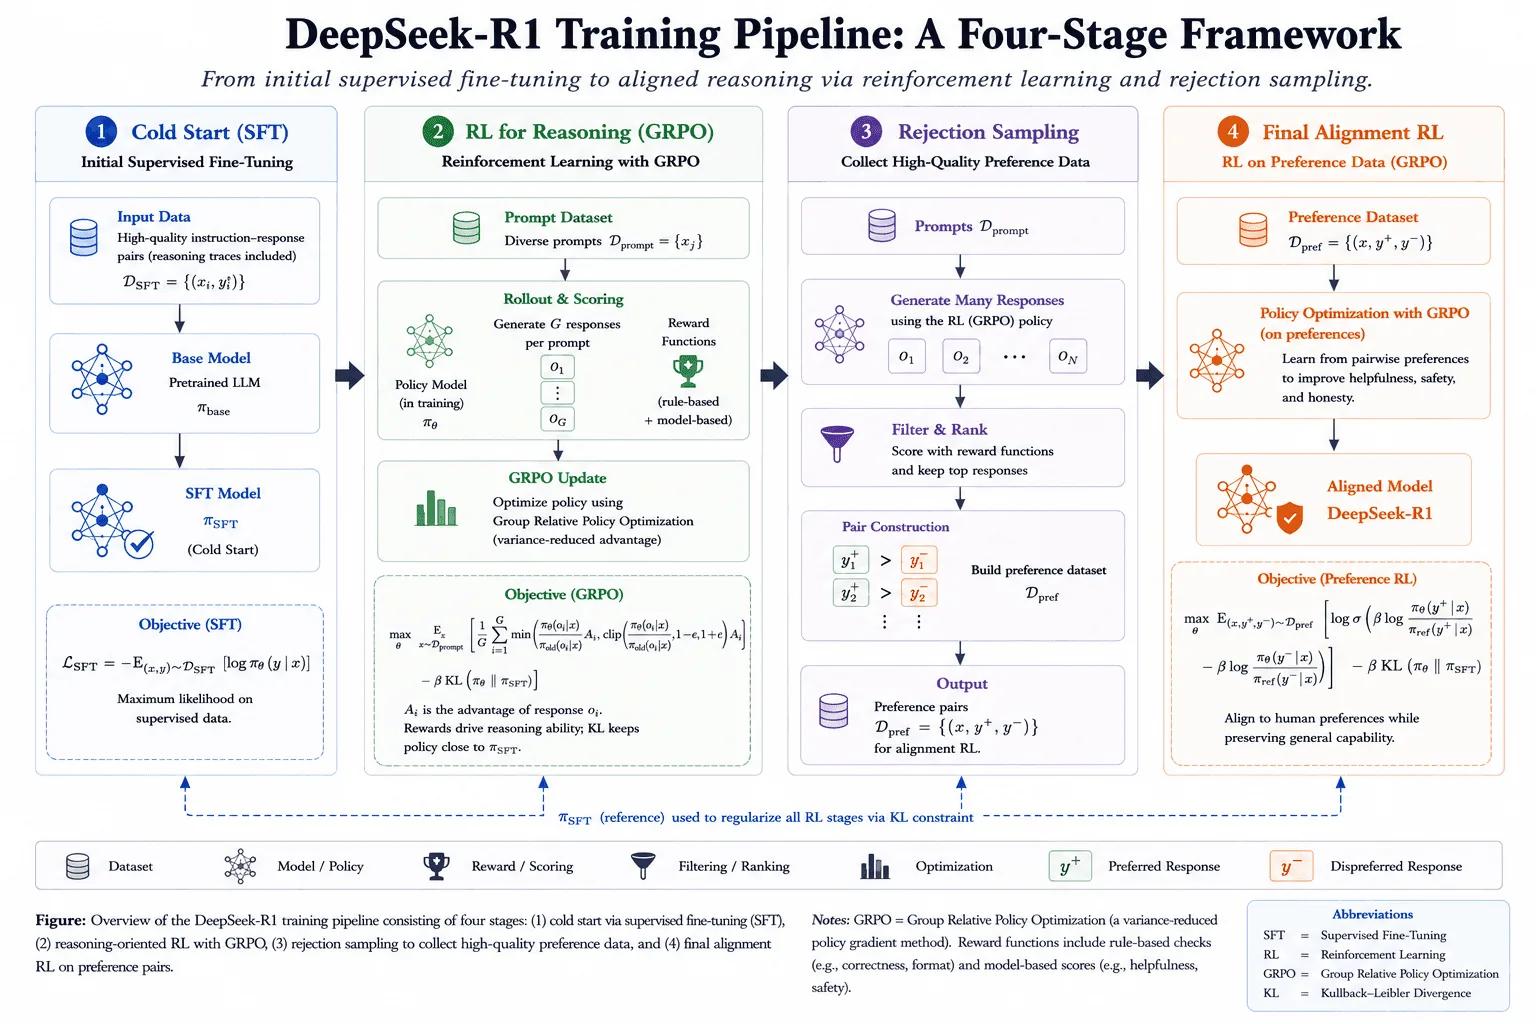
O DeepSeek-R1 e seu antecessor, o DeepSeek-R1-Zero, deram grande visibilidade ao paradigma RLVR. Desafiando os métodos tradicionais usados desde o InstructGPT, os pesquisadores da DeepSeek mostraram com o R1-Zero que habilidades avançadas de raciocínio podem surgir em um modelo base por meio de aprendizado por reforço em larga escala, sem uma fase inicial de ajuste fino supervisionado. Ao treinar um modelo de 32 bilhões de parâmetros (Qwen-32B-Base) ao longo de dezenas de milhares de passos de RL, comportamentos de pensamento estruturado surgiram espontaneamente, ainda que no início fossem um pouco confusos e misturassem idiomas.
O pipeline final do DeepSeek-R1 acrescentou então dados supervisionados de cold start, amostragem por rejeição e etapas adicionais de alinhamento para tornar o comportamento mais legível, estável e útil na prática.
Para estabilizar esse treinamento e escalar até o modelo final DeepSeek-R1, a equipe usou um algoritmo específico chamado Group Relative Policy Optimization (GRPO). Diferentemente do antigo padrão PPO, que exigia um modelo "Critic" pesado para calcular as pontuações de referência, o GRPO é muito mais leve. Ele amostra um grupo de respostas diferentes para o mesmo prompt e as pontua umas em relação às outras.
Isso cria um objetivo que penaliza fortemente as respostas ruins e recompensa as boas em comparação com as demais, mantendo as atualizações sob controle para evitar o esquecimento catastrófico. Essa eficiência permitiu à DeepSeek competir com enormes modelos proprietários usando apenas uma fração do poder computacional habitual.
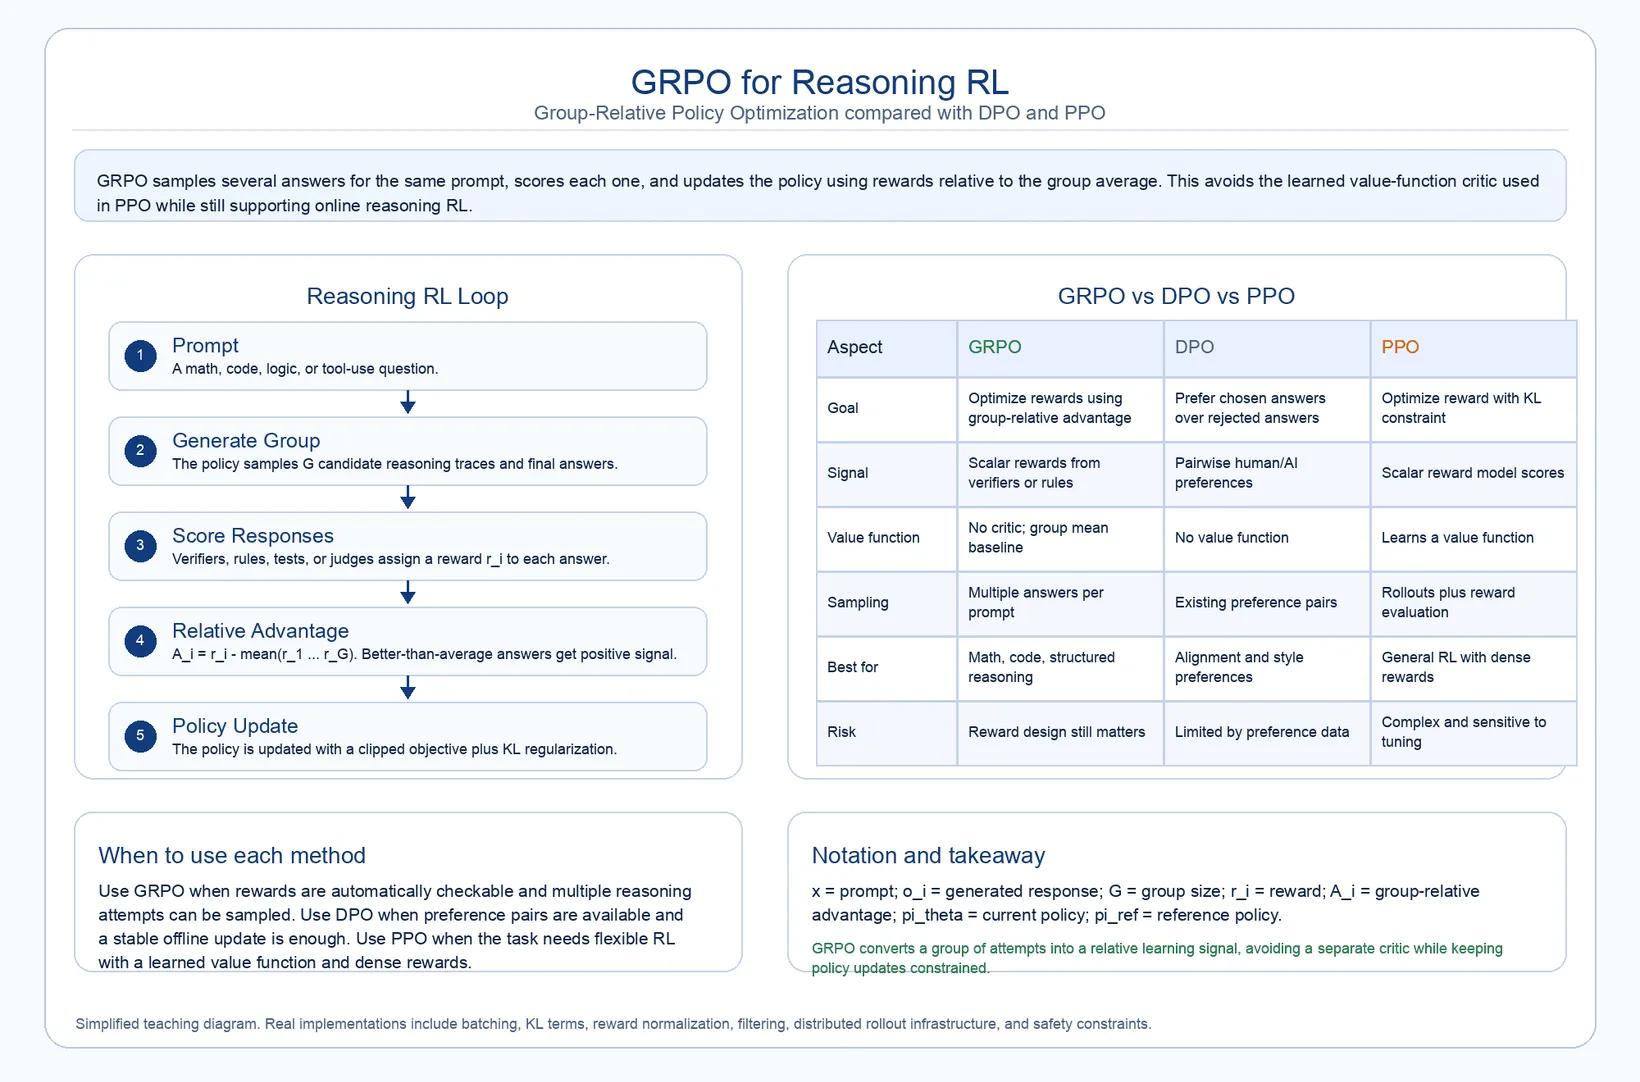
O sucesso do GRPO se deve em grande parte ao uso do aprendizado por reforço a partir de recompensas verificáveis (RLVR). Em vez de depender de avaliadores humanos ou de modelos de recompensa de IA (que podem ser facilmente enganados ou "hackeados"), a DeepSeek usou recompensas rígidas baseadas em regras. As duas principais são de precisão e de formato. A recompensa de precisão verifica se a resposta final está perfeitamente correta (como passar em um teste unitário, no caso de código). A recompensa de formato obriga o modelo a colocar seu processo de pensamento interno dentro de tags XML rígidas, garantindo que a cadeia de pensamento seja legível e estruturada.
Esse método depois evoluiu para o GRPO-$\lambda$. Os pesquisadores perceberam que penalizar rigidamente o modelo por escrever respostas longas (para impedir que ele pensasse indefinidamente) causava quedas bruscas de precisão no início do treinamento. O GRPO-$\lambda$ corrige isso ajustando a penalidade de forma dinâmica. Se o modelo está errando as perguntas, ele deixa temporariamente de se preocupar com o tamanho da resposta para poder buscar a solução livremente. Esse ajuste inteligente melhorou a precisão em benchmarks difíceis como AIME 2024 e GSM8K e, surpreendentemente, reduziu pela metade o tamanho médio das respostas.
OpenAI: raciocínio dinâmico, Makora e segurança
O ecossistema da OpenAI, com a série "o" e os modelos de raciocínio de fronteira que vieram depois, levou o aprendizado por reforço a domínios em que os modelos precisam raciocinar por mais tempo antes de responder. A empresa o usa não só para pensamento abstrato, mas também para escrever código para aceleradores de hardware e reforçar a defesa contra ciberataques. A ideia central dos modelos de raciocínio se apoia em leis de escala bidimensionais: a precisão de um modelo pode melhorar à medida que se investe mais poder computacional no treinamento com RL e à medida que se dá mais tempo para raciocinar durante os testes (test-time compute).
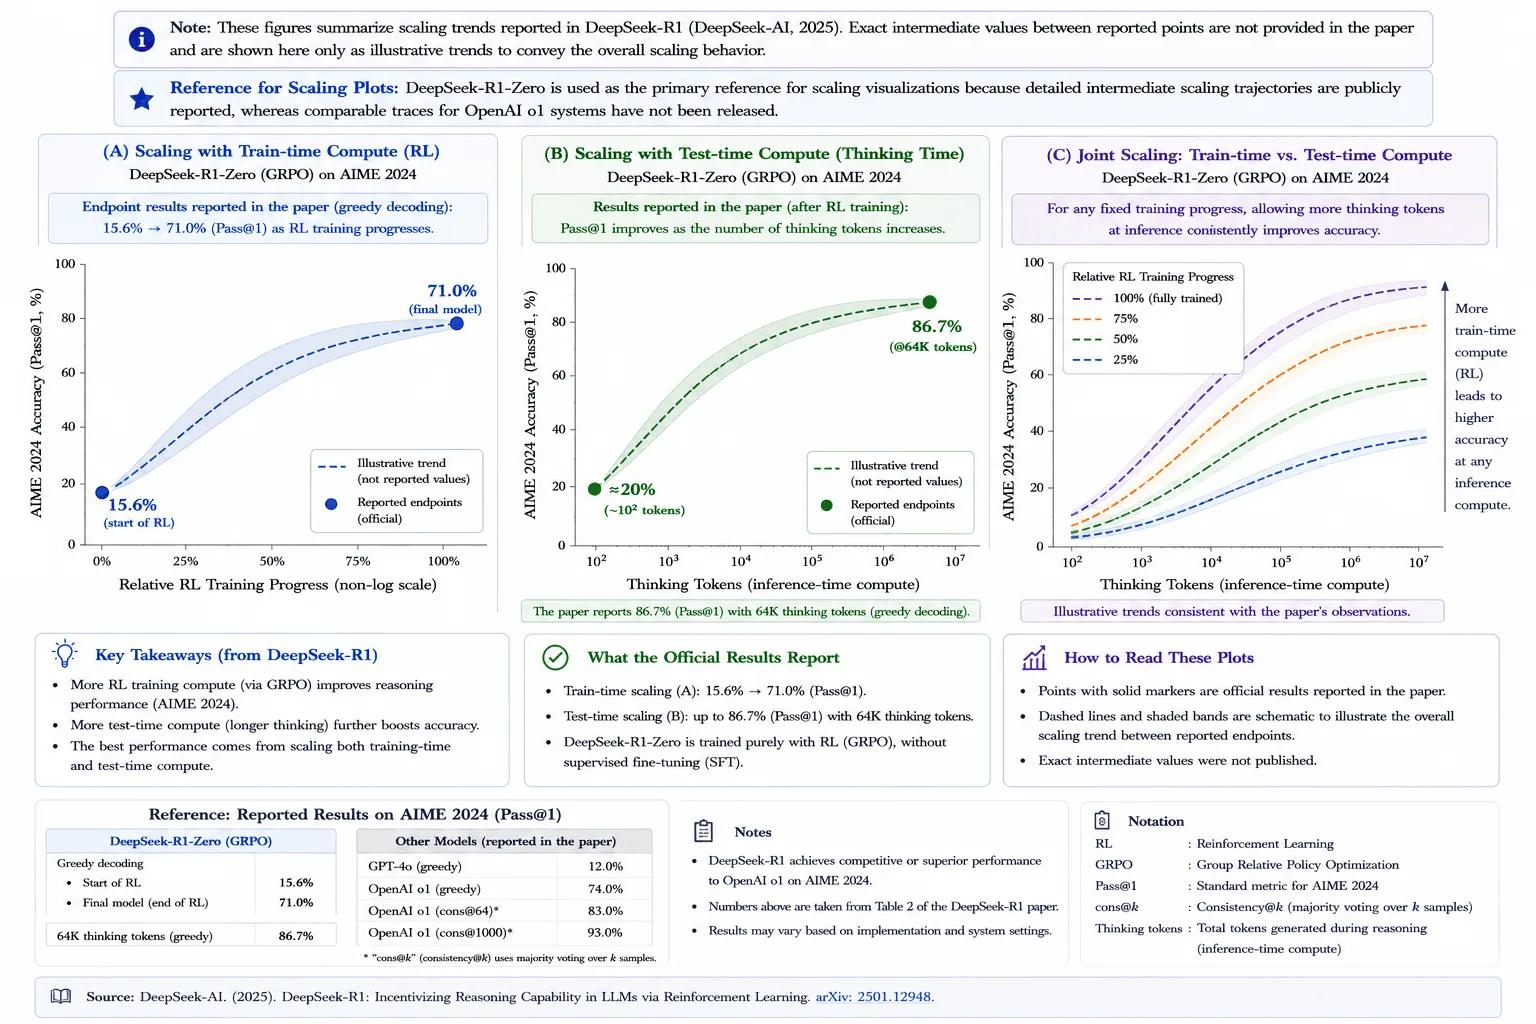
Esta figura usa as curvas de escala do DeepSeek-R1-Zero como referência pública para a ideia geral de escala no treinamento e na inferência. A OpenAI descreveu um comportamento qualitativo semelhante para seus modelos de raciocínio, mas não publicou curvas intermediárias igualmente detalhadas.
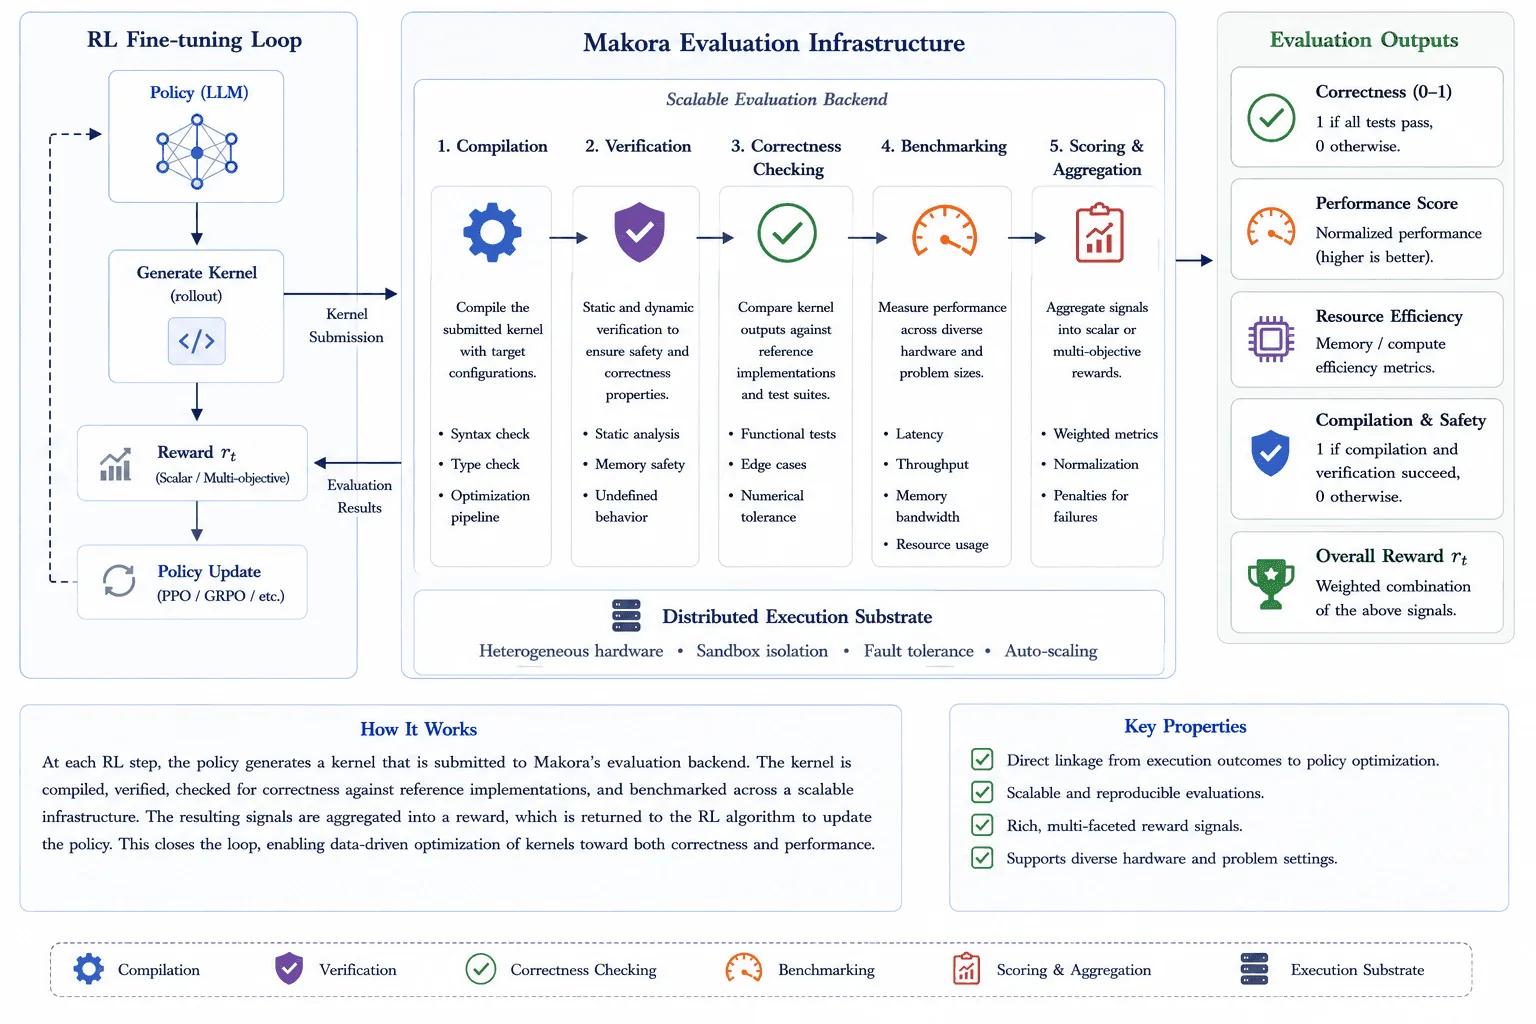
Os resultados divulgados mostram por que esse paradigma se tornou tão influente. Em benchmarks de matemática e ciências, o RL intensivo e a computação extra na inferência parecem levar os modelos de raciocínio muito além dos modelos de chat comuns. Mas talvez a aplicação mais interessante seja o uso de RL em áreas altamente técnicas, onde há pouco ou nenhum dado de treinamento humano disponível. Por meio de um sistema de avaliação chamado Makora, a OpenAI tratou a escrita de kernels (código altamente otimizado para hardware) como um problema puro de RL.
O LLM escreve uma proposta de código, que é enviada a um sistema de backend que a compila, verifica se funciona e mede a velocidade de execução. Quanto mais rápido, maior a recompensa. Isso fechou o ciclo diretamente entre o desempenho real do software e o aprendizado do modelo. Com essa técnica, o modelo escreveu código duas vezes mais rápido que os compiladores padrão na maioria dos testes.
Meta Llama 4: otimização assíncrona e DPO leve
A abordagem da Meta com a família Llama 4 (que inclui Scout 17B, Maverick 17B e o modelo Behemoth 288B) mostra outra forma de escalar o aprendizado por reforço online em modelos open source. Ao contrário de modelos mais antigos, que dependiam de enormes volumes de dados supervisionados, o pós-treinamento divulgado do Llama 4 usa um pipeline enxuto e direcionado: um pouco de SFT leve, seguido de RL online intensivo e finalizado com um polimento via Direct Preference Optimization (DPO).
A grande sacada técnica do pós-treinamento do Llama 4 Maverick é sua infraestrutura de RL assíncrona. Normalmente, algoritmos como PPO ou GRPO geram texto e atualizam o modelo no mesmo nó de servidor. Isso cria um gargalo, porque as GPUs de treinamento podem ficar ociosas esperando o cálculo das recompensas. A Meta descreve como divide a carga de trabalho para que o cálculo das recompensas rode de forma independente, escondendo o tempo necessário para avaliar recompensas complexas, como testes de código.
Nessa fase, a Meta dá ênfase a prompts difíceis. Depois, a camada final de DPO ajuda a refinar o tom e a reduzir os casos em que o modelo se recusa por engano a responder uma pergunta segura. Isso faz do Llama 4 um bom exemplo de stack de pós-treinamento híbrido: RL para comportamentos de raciocínio mais difíceis e, depois, otimização de preferências para o comportamento voltado ao usuário.
Google Gemini Deep Think: pesquisa autônoma e Aletheia
O ecossistema do Google DeepMind, especificamente o Gemini Deep Think e os agentes de pesquisa relacionados, é um dos exemplos mais claros de aprendizado por reforço aplicado ao raciocínio científico de longo horizonte. Enquanto muitos modelos otimizam respostas únicas, os sistemas no estilo Deep Think estruturam o raciocínio em torno de agentes autônomos compostos por várias partes. O exemplo mais avançado é o agente matemático Aletheia.
O Aletheia não depende de linguagens de programação formais para provar teoremas; ele trabalha inteiramente em inglês natural. Ele usa um ciclo de reforço com três partes: um Generator, um Verifier e um Reviser. Diante de um teorema difícil, o modelo escreve possíveis soluções. Se o Verifier encontra um pequeno erro, não descarta a resposta inteira: ele a repassa ao Reviser para corrigir a lógica. A resposta só é descartada se houver um erro grave e impossível de corrigir. O Aletheia também pode usar busca externa e consulta à literatura científica para validar afirmações e evitar inventar citações falsas.
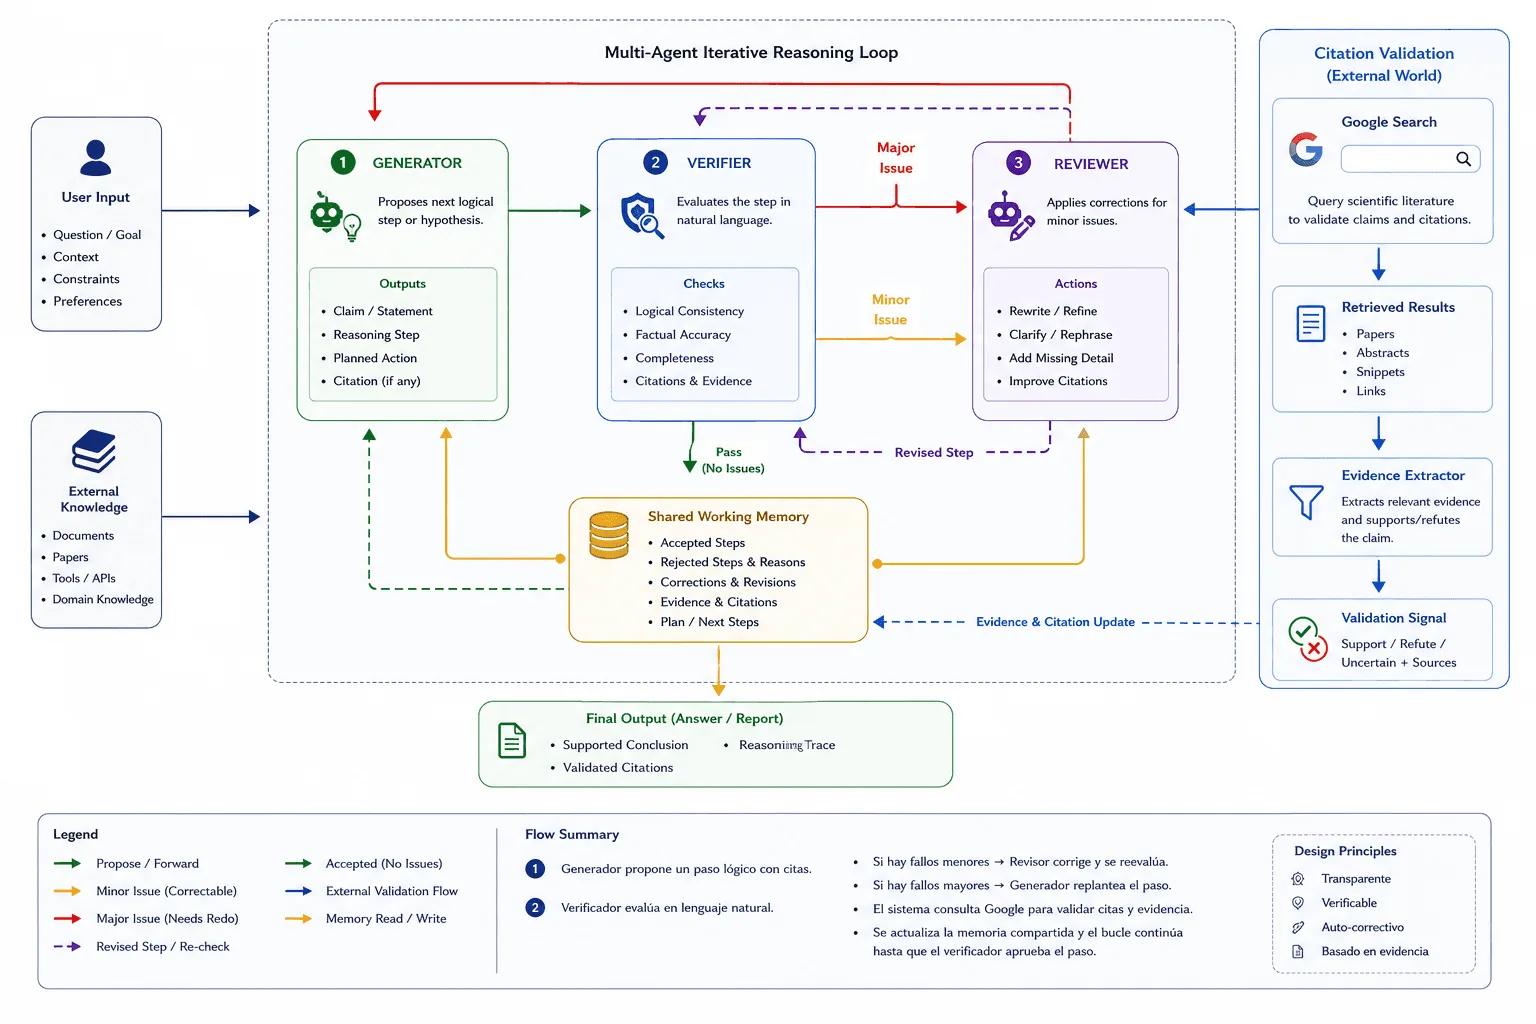
Os resultados divulgados do Aletheia sugerem que ciclos verificador-revisor podem levar sistemas de prova matemática em linguagem natural muito além da geração comum em uma única passada, especialmente em benchmarks de prova difíceis. Mais impressionante ainda, o Aletheia foi descrito como capaz de produzir resultados de pesquisa matemática substanciais e de analisar algoritmos de machine learning. O ponto técnico mais importante não é apenas a pontuação, mas o ciclo: gerar, verificar, revisar e só então aceitar a prova.
Anthropic Claude: constituições formais e RLAIF
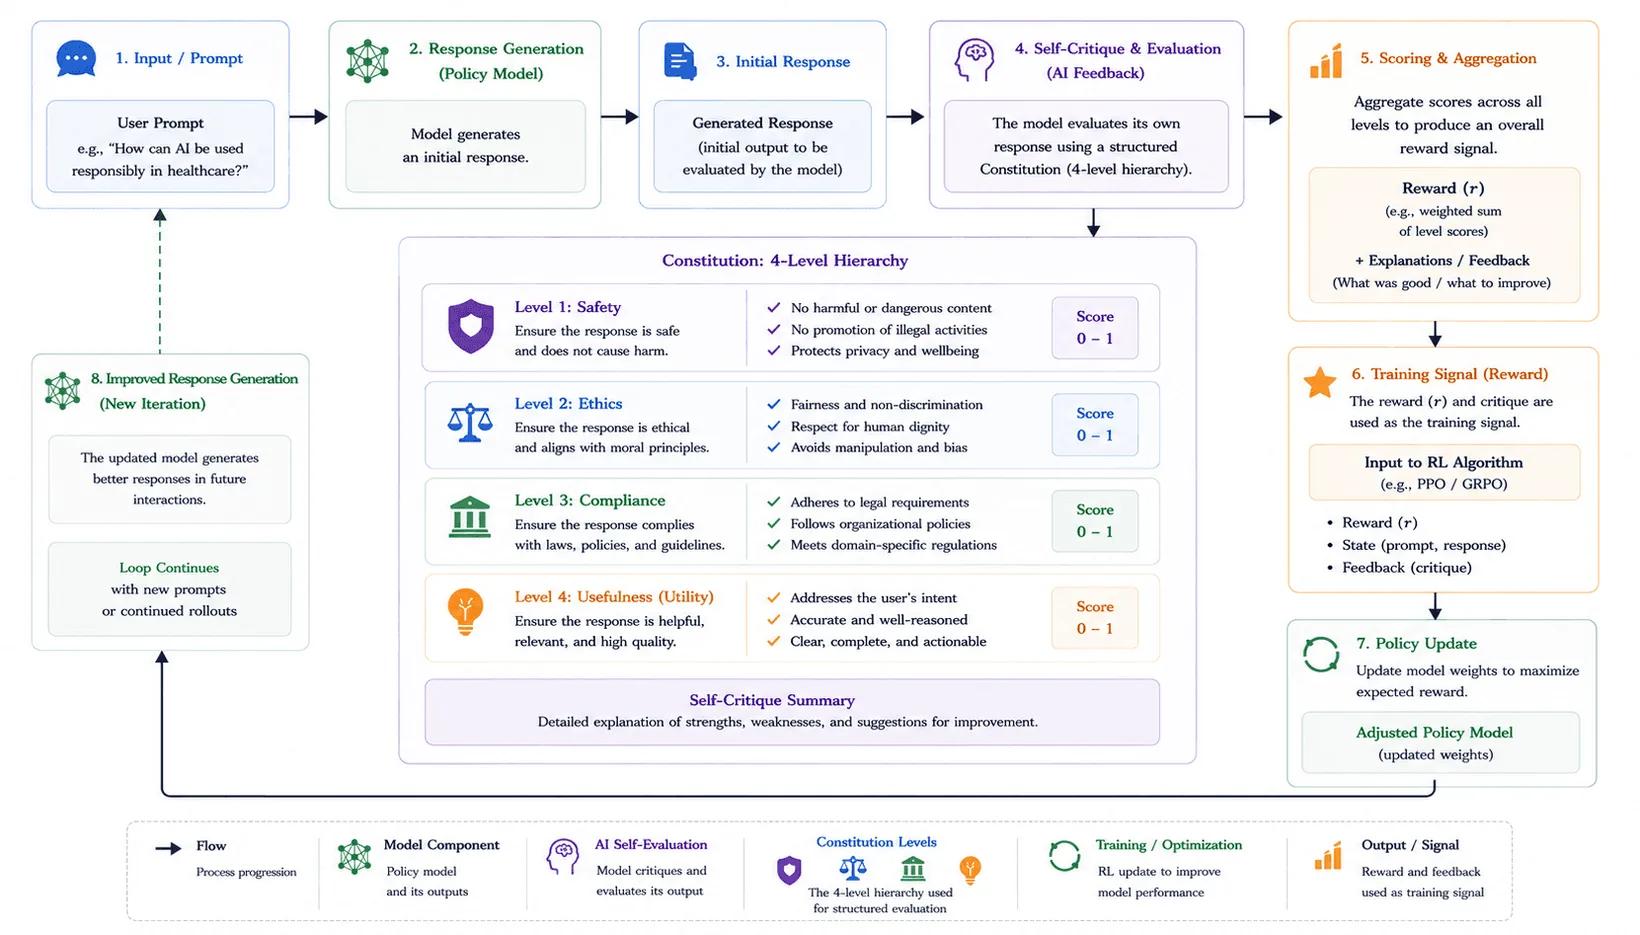
A abordagem da Anthropic com o Claude 3.5 e o Claude 4 se concentra na IA constitucional (Constitutional AI). Em vez de depender de milhares de trabalhadores humanos para julgar qual resposta é melhor — um processo lento, enviesado e difícil quando se lida com conteúdo tóxico —, a Anthropic usa um modelo de IA guiado por um conjunto de regras escritas (uma "constituição").
Esse método, chamado aprendizado por reforço a partir de feedback de IA (RLAIF), faz o modelo gerar uma resposta, criticar a si mesmo com base em regras explícitas (como direitos humanos e princípios de utilidade) e reescrever sua saída para cumpri-las. Essas respostas refinadas são então usadas para atualizar o modelo. As evidências mostram que essa técnica baseada em regras iguala ou supera os métodos clássicos de feedback humano. Mais importante, ela garante que os valores centrais do modelo sejam transparentes, fáceis de auditar e rápidos de atualizar, sem meses de coleta de dados humanos.
No fim de janeiro de 2026, a Anthropic publicou uma grande atualização desse framework, lançando a "Claude's New Constitution". Ao trocar uma abordagem simples baseada em regras por um documento de alinhamento mais baseado em raciocínio, ela estabelece uma hierarquia de prioridades em torno de segurança, ética, conformidade e utilidade. A constituição não resolve o alinhamento magicamente sozinha. Seu papel é definir o framework de crítica usado para gerar, filtrar e classificar respostas durante o treinamento e a avaliação. Ao tornar o documento público, a Anthropic também facilitou a análise e o debate sobre sua filosofia de alinhamento.
Moonshot AI Kimi: escalando o RL para tarefas não verificáveis
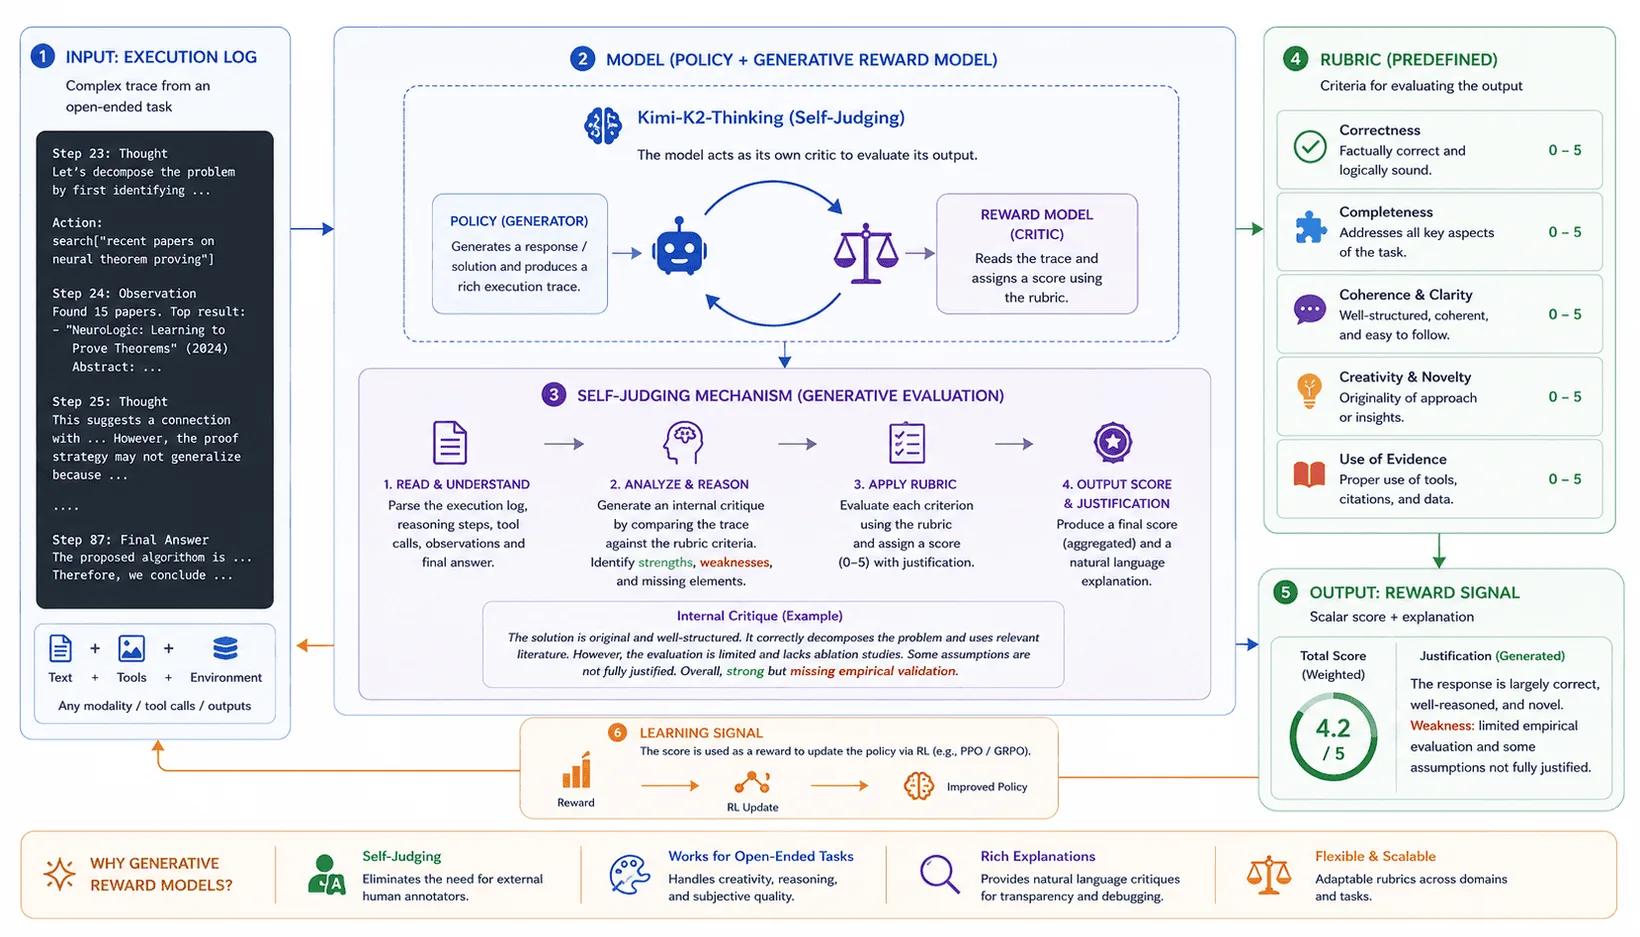
A Moonshot AI lançou o Kimi k1.5 e o K2, ampliando os limites do que o RL consegue alcançar fora da matemática e da programação. Historicamente, o principal desafio do RL tem sido avaliar tarefas não verificáveis, como escrita criativa, agregação de buscas ou geração de relatórios complexos, em que não existe uma resposta absolutamente "certa" ou "errada". A Moonshot resolveu isso implantando sistematicamente modelos de recompensa generativos (GRMs) em uma ampla gama de comportamentos agênticos. Em vez de simples pontuações escalares, o Kimi usa um "juiz de logs" baseado em LLM (por exemplo, o Kimi-K2-Thinking) que aplica uma rubrica de autocrítica para avaliar gerações abertas, decidindo, por exemplo, se um log de execução comprova que um patch de software eliminou um padrão de falha.
Além disso, a Moonshot AI descobriu que ampliar a janela de contexto para 128k tokens durante a fase de RL permite naturalmente que o modelo faça buscas implícitas no espaço de raciocínio por meio de previsões autorregressivas. Isso deu origem a um framework de RL simples, mas eficaz. Como o modelo pode usar um contexto enorme para planejar, refletir e se corrigir, o Kimi alcança resultados sólidos em matemática, programação e raciocínio visão-linguagem sem precisar de truques arquiteturais computacionalmente pesados, como Monte Carlo Tree Search (MCTS) ou os Process Reward Models (PRMs) tradicionais.
Mistral AI: Magistral e raciocínio multilíngue
No início de 2025, a Mistral AI entrou na corrida do raciocínio de fronteira com o lançamento do Magistral, seu primeiro modelo de raciocínio nativo. Lançado em uma versão open source (Magistral Small, 24B parâmetros) e em uma versão corporativa mais poderosa (Magistral Medium), ele tem forte foco em cadeias de pensamento multilíngues e específicas de domínio.
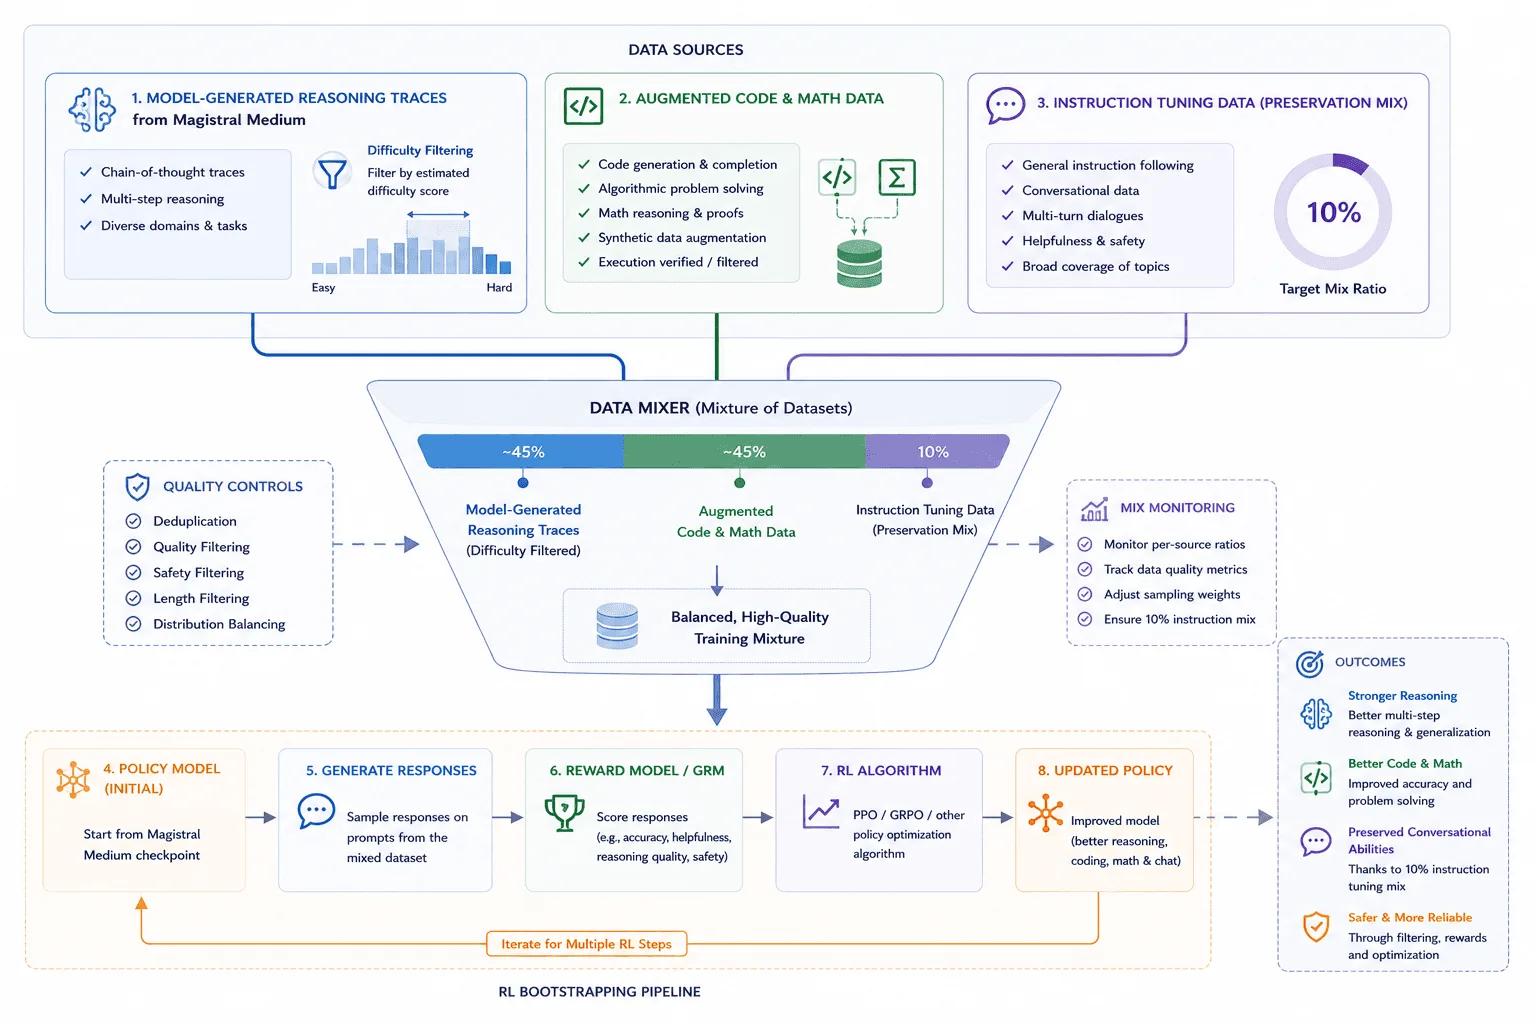
A abordagem da Mistral contrasta com a de laboratórios que dependem totalmente da destilação de traces de modelos fechados maiores. O Magistral foi apresentado como uma extensão voltada ao raciocínio da família de modelos de fronteira da Mistral, com o aprendizado por reforço desempenhando papel central em seu pós-treinamento. Para criar o altamente eficiente Magistral Small, a Mistral usou um pipeline sofisticado de bootstrapping: gerou traces de raciocínio a partir do modelo Medium, filtrou-os para manter um nível de dificuldade variado, enriqueceu os dados com subconjuntos do OpenThoughts e do OpenR1 e incorporou dados gerais de instruction tuning para que o modelo não perdesse suas habilidades de conversa fora do raciocínio. Talvez sua característica mais singular seja a estratégia multilíngue nativa: o modelo é treinado para gerar tanto os traces de raciocínio quanto as respostas finais no idioma solicitado pelo usuário, mostrando que o raciocínio avançado não precisa ser exclusivamente em inglês.
Limitações e problemas em aberto
O stack moderno de RL é poderoso, mas não é uma solução limpa para o raciocínio. A primeira limitação é o reward hacking. Se um modelo encontra uma forma de satisfazer a recompensa sem resolver a tarefa real, o RL vai reforçar esse atalho. Isso é especialmente perigoso quando o avaliador é outro modelo, e não um teste determinístico.
A segunda limitação é o overfitting em benchmarks. Benchmarks de matemática, programação e raciocínio são úteis porque fornecem feedback claro, mas essa mesma clareza também facilita otimizar especificamente para eles. Um modelo pode melhorar em um benchmark sem ganhar o mesmo nível de robustez em tarefas reais e mais bagunçadas.
A terceira limitação é que as recompensas verificáveis são distribuídas de forma desigual. Código, matemática e saídas estruturadas muitas vezes podem ser verificados automaticamente. Pesquisa aberta, textos longos, planejamento de produto e exploração científica são muito mais difíceis de pontuar. Para essas tarefas, os laboratórios ainda dependem de rubricas, modelos juízes, revisão humana ou sinais indiretos do ambiente.
Há também um problema de custo. O test-time compute pode melhorar a precisão ao permitir que o modelo amostre, revise e verifique de forma mais intensa, mas aumenta a latência e o custo de operação. Isso torna os modos de raciocínio mais poderosos mais difíceis de implantar em todos os lugares.
Por fim, a cadeia de pensamento oculta cria um problema de auditoria. Muitos sistemas de fronteira podem usar longos traces de raciocínio internos sem expô-los diretamente. Isso pode ser bom para a segurança e para a experiência do usuário, mas dificulta que pessoas de fora examinem o que o modelo realmente aprendeu com o RL.
Conclusão
Os estudos de caso de OpenAI, DeepMind, Meta, DeepSeek, Mistral, Moonshot e Anthropic sugerem que o desenvolvimento de IA de fronteira deixou de depender apenas do pré-treinamento estático e passou para um stack de pós-treinamento mais interativo. Recompensas verificáveis, otimização online, feedback de IA, autodestilação, ambientes de ferramentas e test-time compute agora trabalham juntos para moldar a forma como os modelos raciocinam.
Os modelos não se limitam mais a memorizar padrões da internet. Os sistemas mais fortes são treinados e orientados a dedicar mais computação para conferir contas matemáticas, depurar código, usar ferramentas, revisar planos e validar etapas intermediárias. O aprendizado por reforço não é o único ingrediente dessa mudança, mas se tornou um dos mecanismos centrais que transformam modelos de linguagem brutos em sistemas capazes de buscar, verificar e melhorar suas próprias respostas.
Bibliografia
Fundamentos: RLHF, DPO e feedback de IA
Ouyang et al., 2022. Training language models to follow instructions with human feedback. O artigo do InstructGPT, que estabeleceu o pipeline clássico de alinhamento SFT -> modelo de recompensa -> PPO.
Bai et al., 2022. Constitutional AI: Harmlessness from AI Feedback. O artigo original da Anthropic sobre RLAIF e IA constitucional.
Rafailov et al., 2023. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. O artigo central da DPO, útil para entender a otimização de preferências offline sem treinamento explícito de um modelo de recompensa.
Anthropic, 2023. Claude's Constitution. Versão pública dos princípios que orientam a crítica constitucional do Claude.
Anthropic, 2026. Claude's New Constitution. Constituição pública atualizada e contexto útil para entender a transição de listas de regras para um alinhamento mais amplo baseado em raciocínio.
RL para raciocínio e recompensas verificáveis
OpenAI, 2024. Learning to Reason with LLMs. Fonte primária da OpenAI sobre raciocínio no estilo o1, treinamento com RL e test-time compute.
DeepSeek-AI, 2025. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. Fonte primária sobre DeepSeek-R1, DeepSeek-R1-Zero, GRPO e treinamento de raciocínio no estilo RLVR.
Yue et al., 2025. Stable Reinforcement Learning for Efficient Reasoning. Apresenta o GRPO-$\lambda$ e discute como estabilizar penalidades de tamanho no RL de raciocínio.
Moonshot AI, 2025. Kimi k1.5: Scaling Reinforcement Learning with LLMs. Fonte primária sobre o RL de contexto longo e a abordagem de escala do Kimi.
Label Studio, 2025. Reinforcement Learning from Verifiable Rewards. Explicação secundária sobre RLVR; útil como visão conceitual acessível, não como principal fonte de evidências.
Estudos de caso de modelos de fronteira
Meta AI, 2025. The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation. Fonte primária sobre o pós-treinamento do Llama 4, incluindo SFT leve, RL online e polimento no estilo DPO.
Mistral AI, 2025. Magistral. Fonte primária sobre a família de modelos de raciocínio da Mistral, seu foco em raciocínio multilíngue e sua abordagem de RL e pós-treinamento.
Google DeepMind, 2026. Accelerating Mathematical and Scientific Discovery with Gemini Deep Think. Fonte primária do DeepMind sobre o Gemini Deep Think e suas capacidades de raciocínio científico.
Feng et al., 2026. Towards Autonomous Mathematics Research. Artigo de pesquisa que descreve o Aletheia como um agente de pesquisa matemática construído sobre o Gemini Deep Think.
Feng et al., 2026. Aletheia tackles FirstProof autonomously. Avaliação complementar do Aletheia no desafio FirstProof.
Tehrani et al., 2026. Fine-Tuning GPT-5 for GPU Kernel Generation. Artigo da Makora sobre ajuste fino com RL para geração de kernels de GPU com recompensas verificáveis.
Makora, 2026. We RL'd GPT-5 to Write Better Kernels. Post de blog complementar ao trabalho da Makora com RL aplicado a kernels de GPU.
Contexto útil e leituras complementares
Decode the Future, 2024. RLHF explained. Introdução acessível ao RLHF para quem busca uma abordagem menos técnica.
Le Wagon, 2025. OpenAI o1 and o3 explained: how thinking models work. Visão geral secundária dos conceitos de modelos de raciocínio; útil para a intuição, mas menos sólida do que as fontes primárias de modelos e artigos.
