

LLM の量子化:その仕組みと注意すべき点
 Toni Lopez Co-Founder at Karumi
1. 量子化とは
量子化は数値表現を圧縮することで大規模言語モデルを現実的に動かせるようにしますが、ビットを削るたびに精度、堅牢性、挙動の面でトレードオフが生じます。
大規模言語モデルは、規模が大きくなるにつれて計算の問題だけでなく、メモリの問題にもなります。すべてのパラメータはどこかに保存され、メモリ上を移動し、推論が実用的な速度を保てるだけ速く読み出されなければなりません。モデルが数十億から数百億、数千億のパラメータへと成長するにつれ、この重みの移動が主要なボトルネックの一つになります。
これはよく「メモリの壁」と呼ばれます。計算用ハードウェアは進化を続けても、メモリの容量と帯域幅は同じペースでは伸びません。そのため、演算そのものが不可能だからではなく、重みを効率よく保持・移動するコストが高すぎるために、モデルの実行が難しくなることがあるのです。
FP16 や BF16 の大規模モデルは、コンシューマー向けハードウェアが余裕をもって提供できる量をはるかに超えるメモリを必要とすることがあります。16 ビット精度で保存された 70B モデルは、それだけで多くのローカル環境が容易に読み込める範囲を大きく超えており、しかもこの見積もりは静的な重みだけのものです。実際の推論では、アクティベーション、一時バッファ、KV キャッシュのための領域も必要になります [13][16]。
だからこそ、量子化はニッチな最適化ではありません。何らかの圧縮を施さなければ、有用なモデルの多くは高価な GPU、サーバー級のデプロイ、あるいは積極的なオフロード戦略なしには使えないままです。量子化は、こうした厳しいハードウェア制約を、精度と効率のあいだで制御可能なトレードオフへと変える技術です [13][14]。
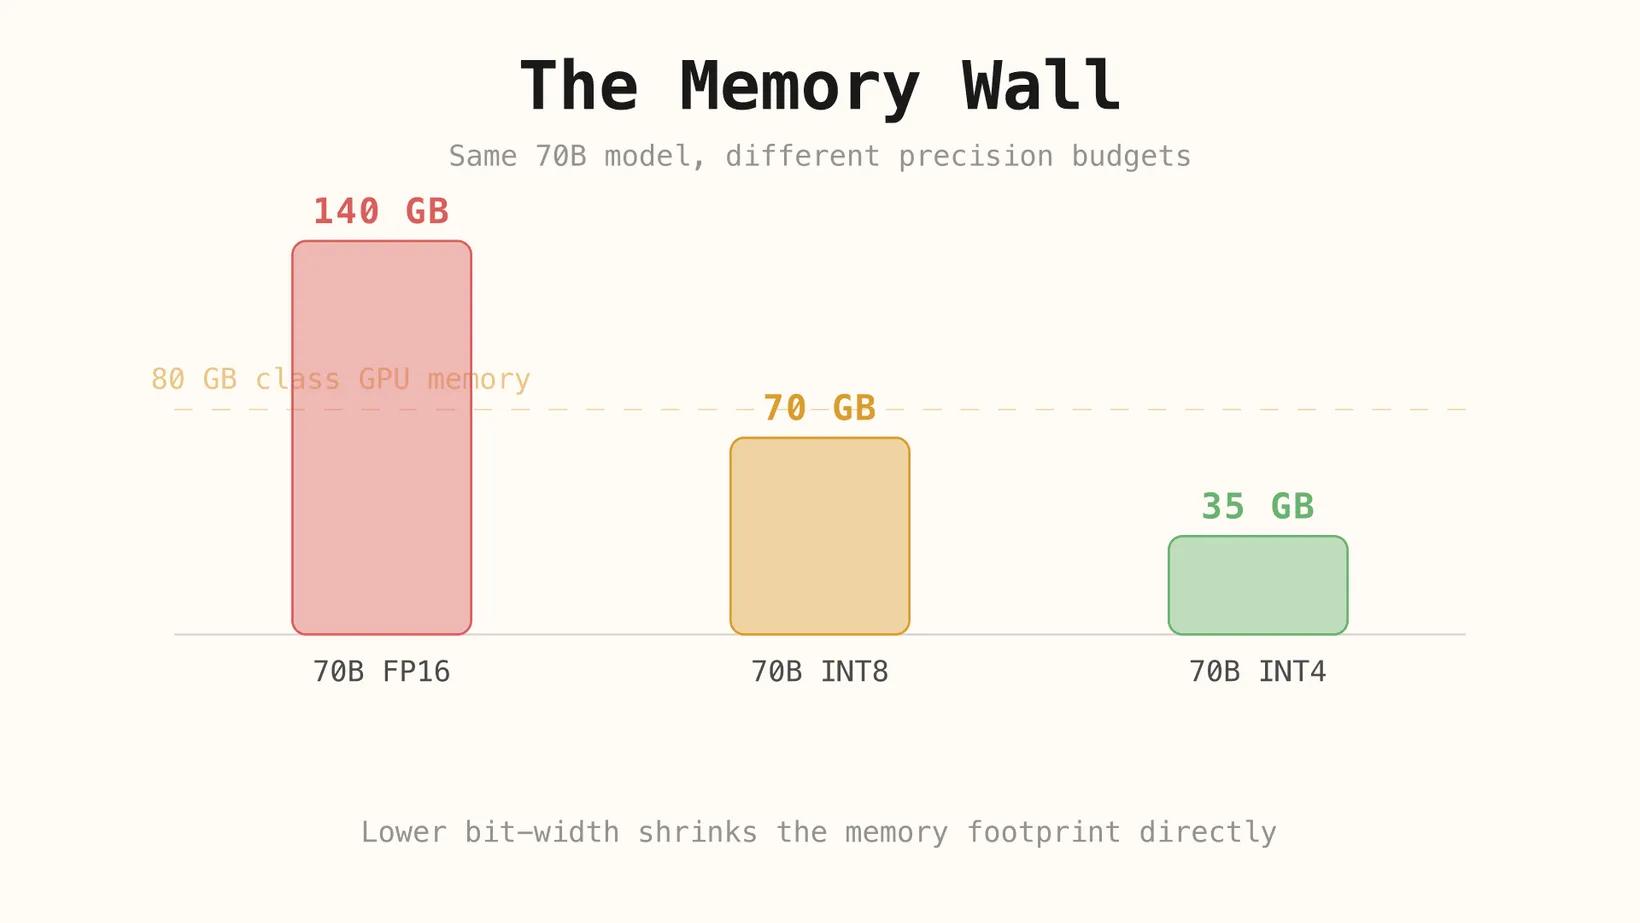
本記事では、このトレードオフを最初から最後までたどります。まず、数学的な操作としての量子化を説明します。次に、その単純な実装がなぜ大規模な Transformer を壊してしまうのかを示します。続いて、生じる誤差を制御しようとする主要な最新アプローチを整理し、最後に、精度を下げたときに気づかないうちに劣化しうる能力や挙動を見ていきます。
2. 量子化の基本的な考え方
量子化とは、本質的には豊かな数値の語彙をより小さな語彙に置き換えることです。重みに細かく区切られた多数の浮動小数点値をとらせる代わりに、より小さな離散グリッド上に収めるよう強制します。利用できる段階の数を大胆に減らすほど、表現は小さくなります。
これにより、すぐに 2 つの利点が得られます。第一に、各重みが使うビット数が減るため、モデルに必要なメモリが少なくなります。第二に、ハードウェアが移動させるデータ量が減るため、実際の推論速度が向上することが多くなります。しかしこうした利点には現実的な代償があります。以前は区別されていた値が、同じ低ビット表現に潰れてしまう可能性があるのです。
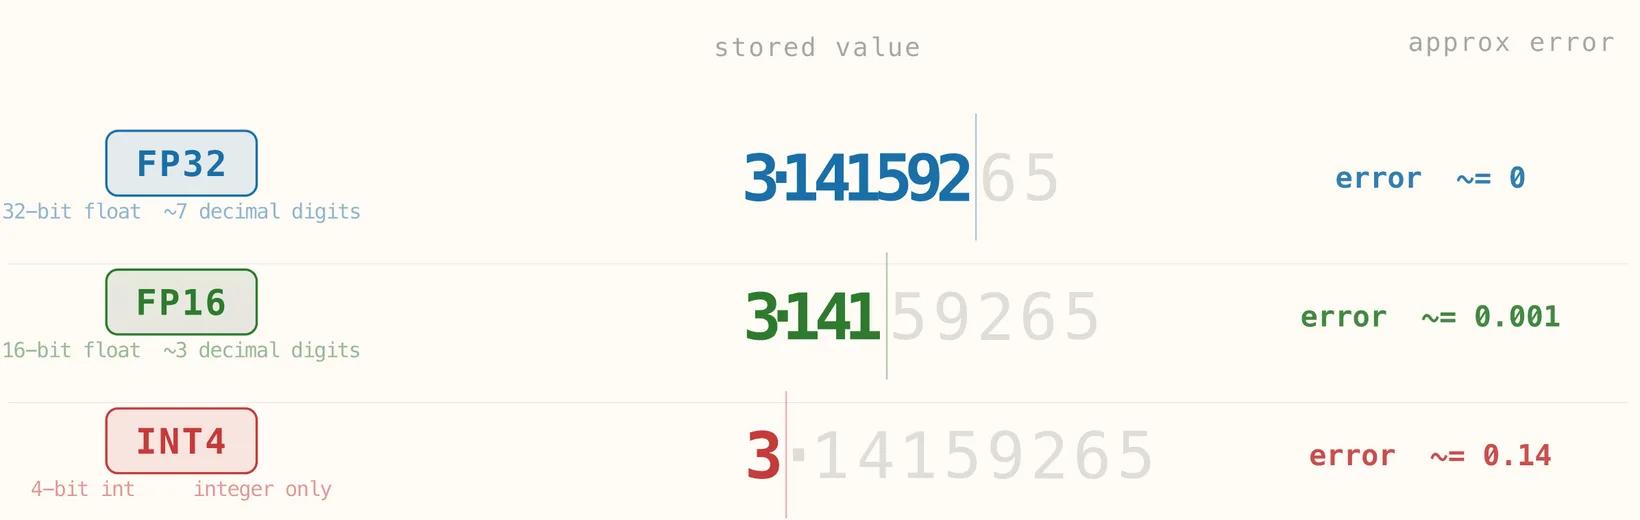
下の図は、1 つの値を異なる精度で表したときの、その代償を示しています。FP32 では、数値は小数部の情報をほぼすべて保持しているため、近似誤差は実質的に無視できます。FP16 では細部の一部が丸められて失われますが、保存される値は元の値に近いままです。INT4 になると、モデルは細かな小数構造をまったく保持できなくなり、保存される値ははるかに粗くなって誤差が急激に大きくなります。要点はシンプルです。精度が低いほど、モデルは元の数値を忠実に保存できなくなります。
2.1 量子化の式
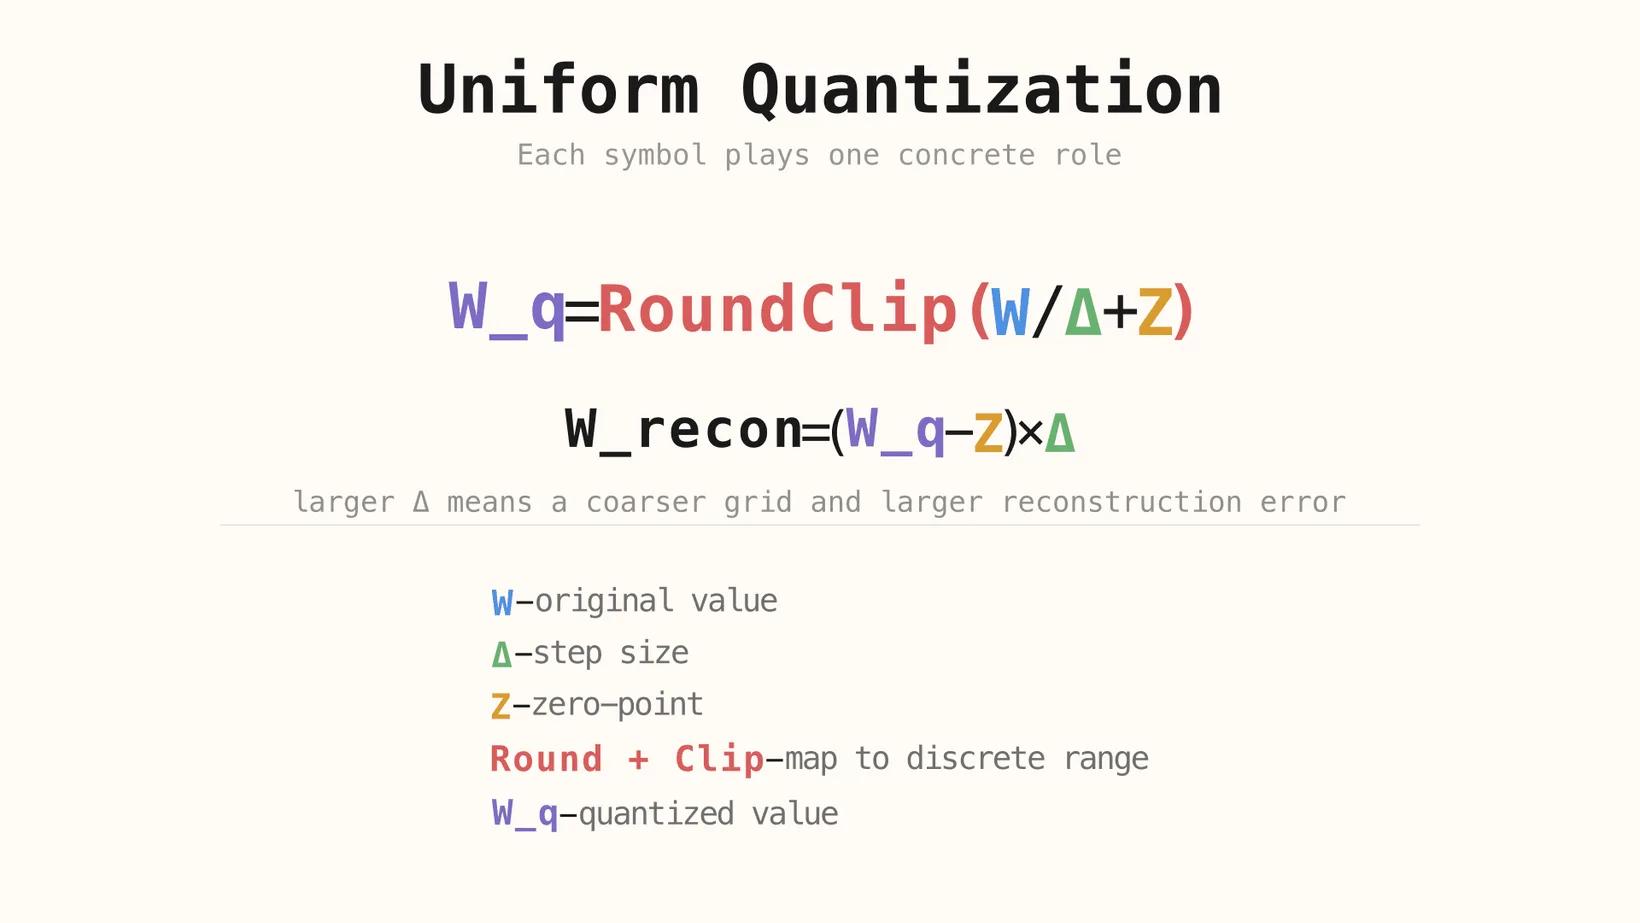
量子化のパイプラインは、単純な操作の連続として理解できます。値をスケーリングし、離散グリッドにシフトし、丸め、許容範囲にクリップし、推論時に近似的に復元する、という流れです [1]。
青の W は元の高精度な値です。緑の Δ は量子化の各ステップの大きさ、つまりグリッド自体の解像度を決めます。琥珀色の Z は、非対称なマッピングが必要な場合にゼロを正しく表現できるようグリッドをずらします。そして赤の Round + Clip の段階で、値はターゲットのビット幅が許す離散的な整数範囲に押し込まれ、紫の W_q が得られます。
推論時、モデルは元の値を正確には取り戻せません。同じスケールとオフセットでマッピングを逆算し、近似値を復元します。そのため、逆量子化は完全な逆変換ではありません。近接する複数の実数値がいったん 1 つの離散レベルに潰れてしまうと、失われた細部は元に戻せないのです。
精度を下げても、モデルがランダムに壊れるわけではありません。モデルが表現できる異なる値の数が減り、その結果として近似誤差が増え、近い値同士を区別しにくくなるのです。
重要なのは、この損失が構造的であるという点です。量子化グリッドが粗いと、まず重み同士の小さな差が消えていきます。つまり、モデルはパラメータの大まかな形は保つものの、細かな数値の情報を失います。これが多数のテンソルやレイヤーで繰り返されると、蓄積した誤差こそが、あらゆる量子化手法が管理しようとする中心的な問題になります [3]。
では、なぜこの誤差が大規模言語モデルでは少し厄介な程度にとどまらず、特に危険なものになるのでしょうか。
3. 単純な量子化が LLM で失敗する理由
上の小数の例は、あえてシンプルにしています。1 つの値が精度を失ったときに何が起こるかを示すものです。大規模言語モデルも根本的には同じ理由で失敗しますが、その規模ははるかに厄介です。1 つの数値が丸められるのではなく、テンソル全体が一度に解像度を失い、その損失が不均一な大きさ、まれな極端値、レイヤーごとの感度と相互に作用します。
モデルの重みが単なる数値にすぎないなら、量子化とはそれをより大胆に丸めるだけのことだと考えたくなります。小さなおもちゃの例なら、その直感はもっともらしく思えます。表現を縮め、多少の誤差を受け入れて先に進めばよい、と。しかし、大規模な Transformer は交換可能な数値を並べた巨大な表ではありません。その性能は、レイヤー、チャネル、トークンにまたがる非常に不均一な数値構造に依存しています。
そのため、単純な丸めでは品質がなだらかに、均一に低下するわけではありません。ネットワークが最も頼りにしている区別そのものを壊してしまうことがあります。結果として精度が下がるだけでなく、「精度が下がればノイズが少し増えるだけ」という単純なメンタルモデルから予想されるよりもはるかに急激に、一貫性、パープレキシティ、推論の質が崩れることもあります。
3.2 外れ値、ステップ幅の肥大化、巨大なアクティベーション
主な失敗要因は丸めそのものではなく、テンソルに極端な値が含まれているときに丸めが引き起こす現象です。テンソルに他よりはるかに大きな値をもつ外れ値が 1 つ、あるいは少数含まれていると、量子化のスケールはそれらを含むよう引き伸ばされます。スケールが大きくなるということは、離散的な各ステップがより広い実数値の範囲をカバーするということです。
そうなると、分布の中心にあるごく普通の値が有効な解像度を失います。多数の異なるレベルに割り当てられる代わりに、はるかに少ないバケットに潰れてしまうのです。事実上、外れ値がテンソル全体にその範囲の代償を払わせることになります。だからこそ、式の中の緑の Δ が非常に重要なのです。Δ が大きくなりすぎると、グリッドはデータの大部分にとって粗すぎるものになります。
同じ考え方は静的な重みにとどまりません。大規模モデルでは、アテンションシンクのように振る舞うトークン固有のスパイクを含む、巨大なアクティベーションが生じることもあります。これらは無害な例外ケースではありません。単純な量子化がうまく扱えない、まさに不釣り合いなスケールの問題を生み出すのです [2] [5] [7]。
モデルが大きくなるにつれ、こうした病理はより構造的なものになります。大規模な Transformer では、外れ値チャネル、トークンレベルのアクティベーションスパイク、そして単純な量子化の信頼性を大きく損なう挙動が現れます。つまり問題は、単に「パラメータが増えれば丸め誤差も増える」ということではありません。大きなモデルほど、1 つの大雑把なグローバルルールでは圧縮しにくい数値的な幾何構造をもつようになる、という点が問題なのです [2][3]。
単純な量子化をスケール管理と誤差制御の失敗として理解すると、最新の量子化手法は恣意的な略語の羅列ではなく、的を絞った対策として見えてきます。
4. 現在の量子化の実際の使われ方
4.1 学習後量子化と量子化を考慮した学習
現代の量子化は、通常、学習後量子化(PTQ)か量子化を考慮した学習(QAT)のどちらかから始まります。PTQ は、学習が終わった後のモデルを適応させます。安価で実用的なため、オープンウェイトモデルの推論ワークフローでは主流となっています。QAT は学習やファインチューニングの段階でモデルを量子化にさらすためコストが高くなりますが、その代わり、ターゲット精度が非常に低い場合でも品質をよりよく保てます [1][11][12]。
この最初の分類が重要なのは、どのような問題を解こうとしているのかがわかるからです。PTQ の問いは「既存のモデルを再学習せずに、どこまで圧縮できるか」。QAT の問いは「モデルは最初から量子化された環境で動くことを学習できるか」です。
4.2 最新手法が守ろうとしているもの
量子化誤差がすべて同じように有害なわけではないため、手法によって守ろうとするものは異なります。アクティベーションにとって最も重要な重みやチャネルを保護しようとする手法もあれば、テンソルの一部の問題領域が残りを台無しにしないよう、局所的なスケーリングに注力する手法もあります。スループット、柔軟なビットレート目標、あるいは特定のハードウェアスタックを効率よく活用することを軸に最適化された手法もあります [6][4][5]。
そのため、最新の量子化手法は誤差制御の戦略として捉えるのが最もわかりやすいでしょう。どの手法も同じ問いに答えようとしています。「単純に圧縮するには重要すぎる情報はどれか。そして、それを守る最も安価な方法は何か」という問いです。
4.3 実践で使われる主な手法とデプロイ形式
現在のエコシステムは略語の無作為な寄せ集めではありませんが、性質の異なるものが混在しています。AWQ、GPTQ、QAT は量子化手法または学習アプローチです。一方、GGUF と EXL2 はモデル形式や推論エコシステムに近いものです。量子化モデルを特定のハードウェアやランタイムに合う形でパッケージ化し、運用可能にするという点で重要です。
| 名称 | 種類 | 主な考え方 | 強み | 最適な用途 |
|---|---|---|---|---|
| GGUF | 形式/デプロイエコシステム | ローカル推論スタックで広く使われる、ポータブルな量子化モデル形式 | ポータビリティと実用的なデフォルト設定 | CPU、Apple Silicon、異種混在のローカル環境 |
| AWQ | 量子化手法 | 量子化時にアクティベーション上重要な重みを保護する | 低ビット幅でも高い品質を維持 | 品質を重視する GPU 推論 |
| GPTQ | 量子化手法 | 二次情報を用いた学習後の重み量子化 | 高い圧縮率と高速な推論 | スループット重視の GPU サービング |
| EXL2 | 形式/ランタイムエコシステム | ExLlama 系の推論向けに調整された混合ビットレートの量子化形式 | メモリと速度の柔軟なトレードオフ | マルチ GPU や VRAM に制約のある ExLlama 環境 |
| QAT | 学習アプローチ | 量子化をループに組み込んで学習またはファインチューニングする | 超低精度で最も高い堅牢性 | 再学習のコストが許容できるケース |
この表の目的は名称を暗記することではありません。各行が問題の少しずつ異なるレイヤーを解決していることに気づくことです。重みをどう量子化するかを示す行もあれば、量子化モデルをどうパッケージ化し実行するかを示す行もあります。この表は、GGUF 仕様、AWQ、GPTQ、ExLlamaV2 / EXL2、そして LLM-QAT や EfficientQAT といった LLM 向け QAT の最近の研究から得られた知見をまとめたものです [9][6][4][10][11][12]。
4.4 各手法・形式が適している場面
トレードオフが明確になれば、全体像は把握しやすくなります。幅広いローカル環境でのポータビリティや、CPU と Apple Silicon でよく動く形式を求めるなら、GGUF が自然な選択です [9]。GPU 推論を優先する場合は AWQ と GPTQ が有力ですが、両者はトレードオフの異なる側面を最適化しています。品質の維持をより重視する場合は AWQ が好まれる傾向があり、スループットが中心となる場合は GPTQ が選ばれることが多くなります [6][4]。
EXL2 は、メモリに収めること自体が最大の最適化課題であり、特定の推論スタック内でビットレートをより細かく制御したい場合に適しています [10]。QAT はまったく別のカテゴリに属します。サービング形式ではなく学習時の戦略であり、積極的な低ビットでのデプロイが十分に重要で、量子化ノイズに耐えられるようモデルを再学習またはファインチューニングするコストを正当化できる場合に魅力的な選択肢となります [11][12]。
ただし、手法を選ぶことは話の半分にすぎません。より難しいのは、圧縮を適用した後にどのような能力や挙動が不安定になるのか、という問いです。
5. 量子化の見えにくいコスト
5.1 能力の劣化:推論、コンテキスト、マルチモーダルの信頼性
最近の評価では、精度を下げると推論の質や長いコンテキストでの挙動が劣化しうること、そして同じ低ビットでの堅牢性の問題がマルチモーダルシステムにも影響しうることが示唆されています。こうした劣化は不均一なことが多く、安定を保つタスクがある一方で、大きく悪化するタスクもあります。モデルは流暢さを保ったまま、多段階の数学、長い推論の連鎖、あるいは多数のレイヤーにわたって小さな内部の区別が保たれることを前提とするタスクで信頼性を失う場合があります [15][16][12]。
この不均一さは、ベンチマークの小さな一部分だけで量子化を評価すると誤った判断につながりうる理由の一つです。短いプロンプトではほとんど変化がないように見えるモデルでも、長いコンテキスト、より難しい推論タスク、あるいは誤差がより大きく累積するマルチモーダル入力では品質が低下することがあります [13][14][16]。
5.2 エージェントや実運用での静かな失敗
最近の評価では、量子化されたモデルがより目立たない形で失敗しうることも示唆されています。表面的には流暢に見えても、ツールの使用、多段階の計画、エージェント型のワークフローがもろくなる場合があります。これは危険な特性です。有能そうに聞こえるのに、外部システムやツール、遅れて現れる影響が重要になるまさにその場面で信頼性が落ちるモデルを生み出すからです [14][17]。
実務的には、量子化はテキスト生成の問題としてだけでなく、システムの挙動の問題として評価すべきだということです。モデルがエージェントのループ、検索(リトリーバル)スタック、ツール呼び出しのワークフローに組み込まれている場合、トークンレベルでのわずかな信頼性の低下が、はるかに大きな運用上の障害につながる可能性があります。
5.3 安全性、バイアス、アライメントのゆがみ
最近の評価では、圧縮によって安全性や挙動に関する特性も変化しうることが示唆されています。量子化によってモデルが自動的に危険になったり偏ったりするわけではありませんが、アライメント、ガードレール、安定した挙動を支える仕組みをゆがめる可能性はあります。もともと数値的にもろい挙動がある場合、低ビット圧縮によってそれが十分にずれ、拒否の挙動、有害な出力の傾向、敵対的プロンプトへの耐性が変わることがあります [13][17]。
ここで取るべき姿勢は、否定でもパニックでもありません。量子化は挙動を変える介入として扱い、その影響を直接測定する必要があります。モデルが小さく速くなったかを問うだけでは不十分です。解像度を落としたことで、どの特性が不安定になったのかも問う必要があります。
6. まとめ:量子化
量子化によって、大規模モデルは保存コストが下がり、移動が容易になり、デプロイもしやすくなります。高度なモデルが専用インフラの外でも動作できる主な理由の一つです。その意味で、量子化は現代の LLM を広く利用可能にしている重要技術の一つといえます。量子化がなければ、多くのモデルは、ごく一部のユーザーや組織しか負担できないハードウェア予算の壁の向こうに閉じ込められたままだったでしょう。
一方で、デプロイを実用的にするのと同じ圧縮が、モデル内部の計算から有用な解像度を奪うこともあります。その損失は、推論の劣化、目立たない不安定さ、挙動の変化として現れる可能性があります。重要な教訓は、量子化は決して「タダ」ではないということです。明らかに行う価値がある場合でも、モデルが思考する数値的な枠組みそのものを変えてしまいます。
6.1 今後の研究の方向性
現在の研究は、より賢い低ビット手法、敏感なアクティベーションのより適切な保護、ハードウェアを意識した形式、そしてベンチマーク精度を超えて圧縮が何を変えるのかをより細かく評価する方向へ進んでいます。大きな方向性は明確です。今後の課題は、モデルをより少ないビット数に収めることだけではなく、モデルのどの部分を大胆に圧縮でき、どの部分を数値的に保護し続けるべきかを見極めることにあります [6][12][17]。
だからこそ、量子化は最後に施すストレージの小技ではなく、中核的な設計レイヤーとして理解すべきです。量子化はモデルの品質、デプロイコスト、挙動の信頼性のあいだに位置しており、優れた最新手法はいずれも、この 3 つの要求をより賢くバランスさせようとする試みなのです。
参考文献
[1] Jacob et al. (2018). Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. スケール/ゼロポイント量子化と量子化を考慮した学習に関する基礎的な文献。
[2] Dettmers et al. (2022). LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. Transformer の外れ値と、単純な低ビット圧縮が大規模になると異なる形で失敗する理由に関する中心的な文献。
[3] Gong et al. (2024). What Makes Quantization for Large Language Models Hard? An Empirical Study from the Lens of Perturbation. 量子化誤差を一般的なノイズではなく構造化された摂動として理解するうえで有用な文献。
[4] Frantar et al. (2022). GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. GPT 系モデルにおける二次情報を用いた学習後量子化の一次資料。
[5] Xiao et al. (2023). SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models. 重みとアクティベーションの量子化におけるアクティベーション外れ値の扱いに関する重要な文献。
[6] Lin et al. (2023). AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration. 低ビット LLM 量子化においてアクティベーション上重要な重みを保護する手法の一次資料。
[7] Lee et al. (2023). OWQ: Outlier-Aware Weight Quantization for Efficient Fine-Tuning and Inference of Large Language Models. 外れ値を考慮した低ビット量子化とファインチューニングに関する有用な文献。
[8] Dettmers et al. (2023). QLoRA: Efficient Finetuning of Quantized LLMs. 4 ビット量子化でのファインチューニングと NF4 ベースの学習ワークフローに関する重要な文献。
[9] ggml / llama.cpp. GGUF format specification. デプロイ指向の手法のセクションで取り上げた GGUF ファイル形式の公式仕様。
[10] turboderp-org. ExLlamaV2 README and EXL2 quantization notes. EXL2 の混合ビットレートによるローカル GPU ワークフローの主要な実装資料。
[11] Liu et al. (2023). LLM-QAT: Data-Free Quantization Aware Training for Large Language Models. LLM に特化した初期の QAT 文献で、特に 8 ビット未満の精度で重要。
[12] Chen et al. (2024). EfficientQAT: Efficient Quantization-Aware Training for Large Language Models. 低ビット学習の実用的な効率性に焦点を当てた、より新しい LLM-QAT 研究。
[13] Jin et al. (2024). A Comprehensive Evaluation of Quantization Strategies for Large Language Models. 能力、アライメント、効率を網羅する幅広い評価フレームワーク。
[14] Lee et al. (2024). Exploring the Trade-Offs: Quantization Methods, Task Difficulty, and Model Size in Large Language Models From Edge to Giant. モデル、量子化手法、ベンチマーク群を横断した大規模な比較。
[15] Li et al. (2025). Quantization Meets Reasoning: Exploring LLM Low-Bit Quantization Degradation for Mathematical Reasoning. 積極的な低ビット量子化による推論能力の劣化を直接示すエビデンス。
[16] Mekala et al. (2025). Does quantization affect models' performance on long-context tasks?. 量子化による長いコンテキストでの劣化に関する主要な文献。
[17] Kharinaev et al. (2025). Investigating the Impact of Quantization Methods on the Safety and Reliability of Large Language Models. 安全性・信頼性のセクション、および挙動の変化を直接測定すべき理由に関する文献。
