

Cuantizar LLM: cómo funciona y qué debería preocuparte
 Toni Lopez Co-Founder at Karumi
1. Introducción a la cuantización
La cuantización permite ejecutar grandes modelos de lenguaje en la práctica al comprimir su representación numérica, pero cada bit que se elimina implica concesiones en precisión, robustez y comportamiento.
Al crecer, los grandes modelos de lenguaje no solo se convierten en un problema de cómputo, sino también de memoria. Cada parámetro debe almacenarse en algún lugar, moverse por la memoria y leerse lo bastante rápido como para que la inferencia siga siendo viable. A medida que los modelos pasan de miles de millones a decenas o cientos de miles de millones de parámetros, ese movimiento de pesos se convierte en uno de los principales cuellos de botella.
Es lo que suele llamarse el muro de la memoria: el hardware de cómputo puede seguir mejorando, pero la capacidad y el ancho de banda de la memoria no escalan al mismo ritmo. Por eso, un modelo puede resultar difícil de ejecutar no porque la aritmética sea imposible, sino porque sus pesos son demasiado costosos de almacenar y mover de forma eficiente.
Un modelo grande en FP16 o BF16 puede requerir mucha más memoria de la que el hardware de consumo ofrece con holgura. Un modelo de 70B almacenado con precisión de 16 bits ya supera con creces lo que la mayoría de configuraciones locales pueden cargar fácilmente, y esa estimación solo cubre los pesos estáticos. En la práctica, la inferencia también necesita espacio para activaciones, búferes temporales y la caché KV [13][16].
Por eso la cuantización no es una optimización de nicho. Sin algún tipo de compresión, muchos modelos útiles quedan fuera de alcance salvo con GPU caras, despliegues de nivel servidor o estrategias agresivas de offloading. La cuantización es la técnica que convierte esta restricción rígida de hardware en un equilibrio controlable entre precisión y eficiencia [13][14].
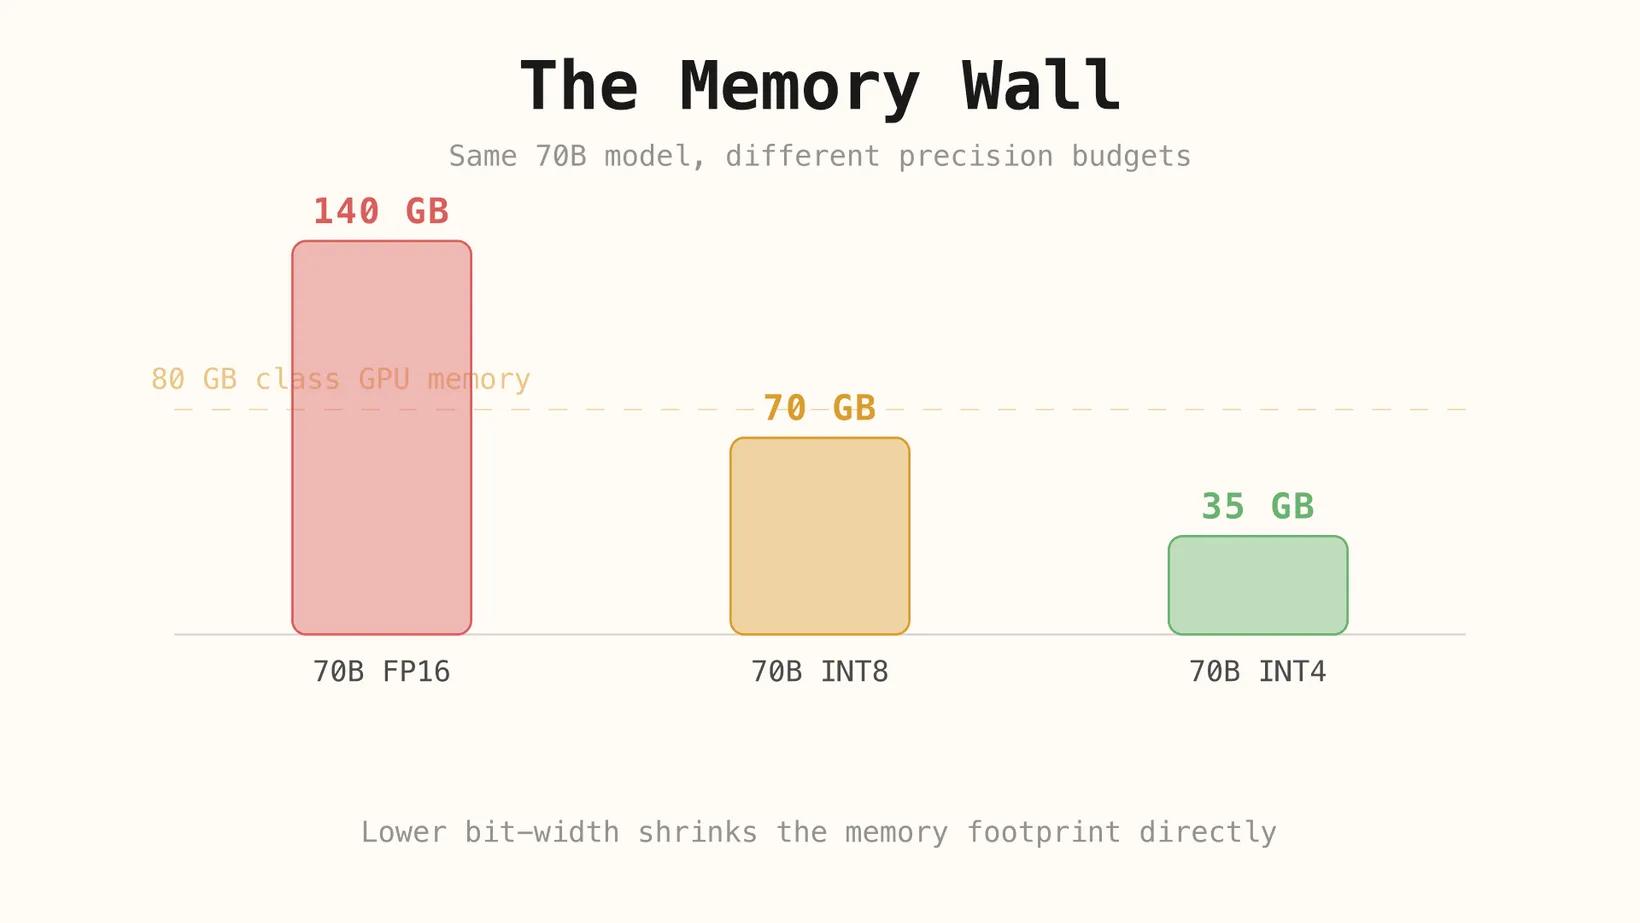
Este artículo recorre ese equilibrio de principio a fin. Primero explica qué es la cuantización como operación matemática. Después muestra por qué la versión ingenua de esa idea rompe los grandes transformers. A continuación, repasa los principales enfoques modernos que intentan controlar el error resultante y, por último, analiza las capacidades y comportamientos que pueden degradarse de forma silenciosa cuando baja la precisión.
2. La intuición básica detrás de la cuantización
En esencia, cuantizar significa sustituir un vocabulario numérico rico por uno más reducido. En lugar de permitir que un peso adopte muchos valores de coma flotante finamente separados, lo obligamos a situarse en una cuadrícula discreta más pequeña. Cuanto más agresivamente reducimos el número de niveles disponibles, más compacta es la representación.
Esto aporta dos beneficios inmediatos. Primero, el modelo necesita menos memoria porque cada peso usa menos bits. Segundo, el hardware tiene menos datos que mover, lo que a menudo mejora la velocidad real de inferencia. Pero estas ganancias tienen un coste real: valores que antes eran distintos pueden acabar colapsando en la misma representación de pocos bits.
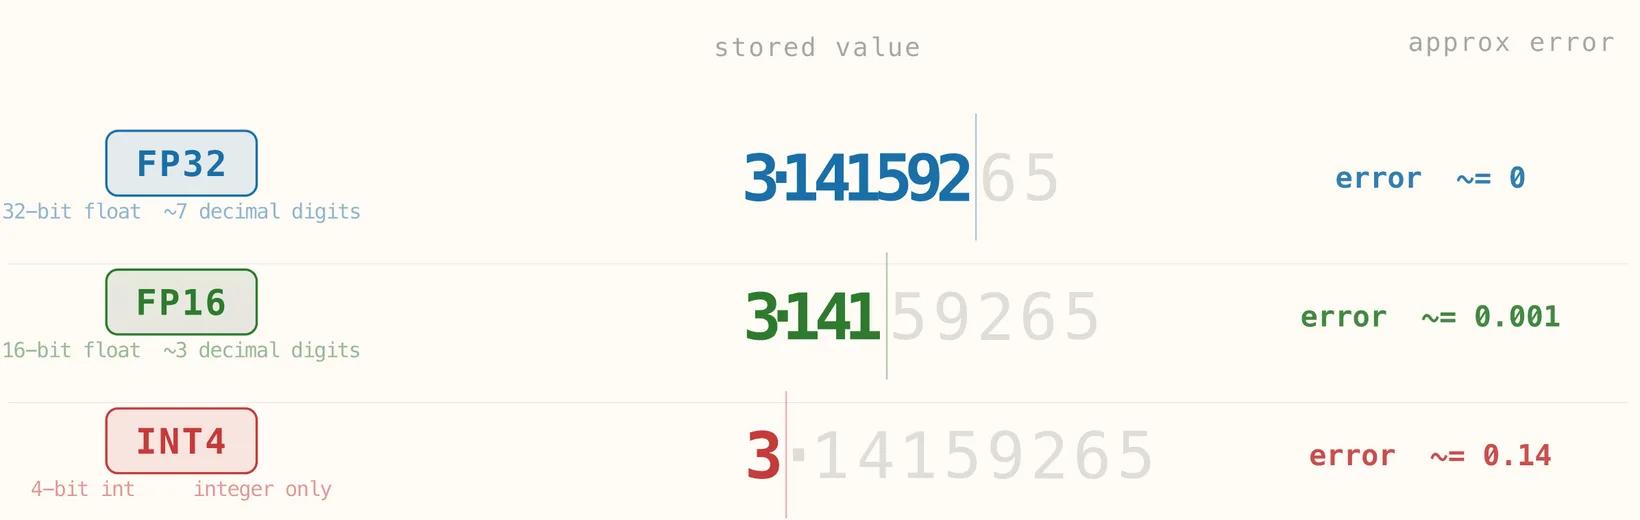
La figura siguiente muestra ese sacrificio con un único valor escrito con distintas precisiones. En FP32, el número conserva casi todo su detalle decimal, así que el error de aproximación es prácticamente despreciable. En FP16, parte de ese detalle se pierde al redondear, pero el valor almacenado sigue estando cerca del original. En INT4, el modelo ya no puede conservar en absoluto la estructura decimal fina, por lo que el valor almacenado se vuelve mucho más tosco y el error crece de forma pronunciada. La idea clave es sencilla: cuanto menor es la precisión, con menos fidelidad puede el modelo almacenar el número original.
2.1 La fórmula de cuantización
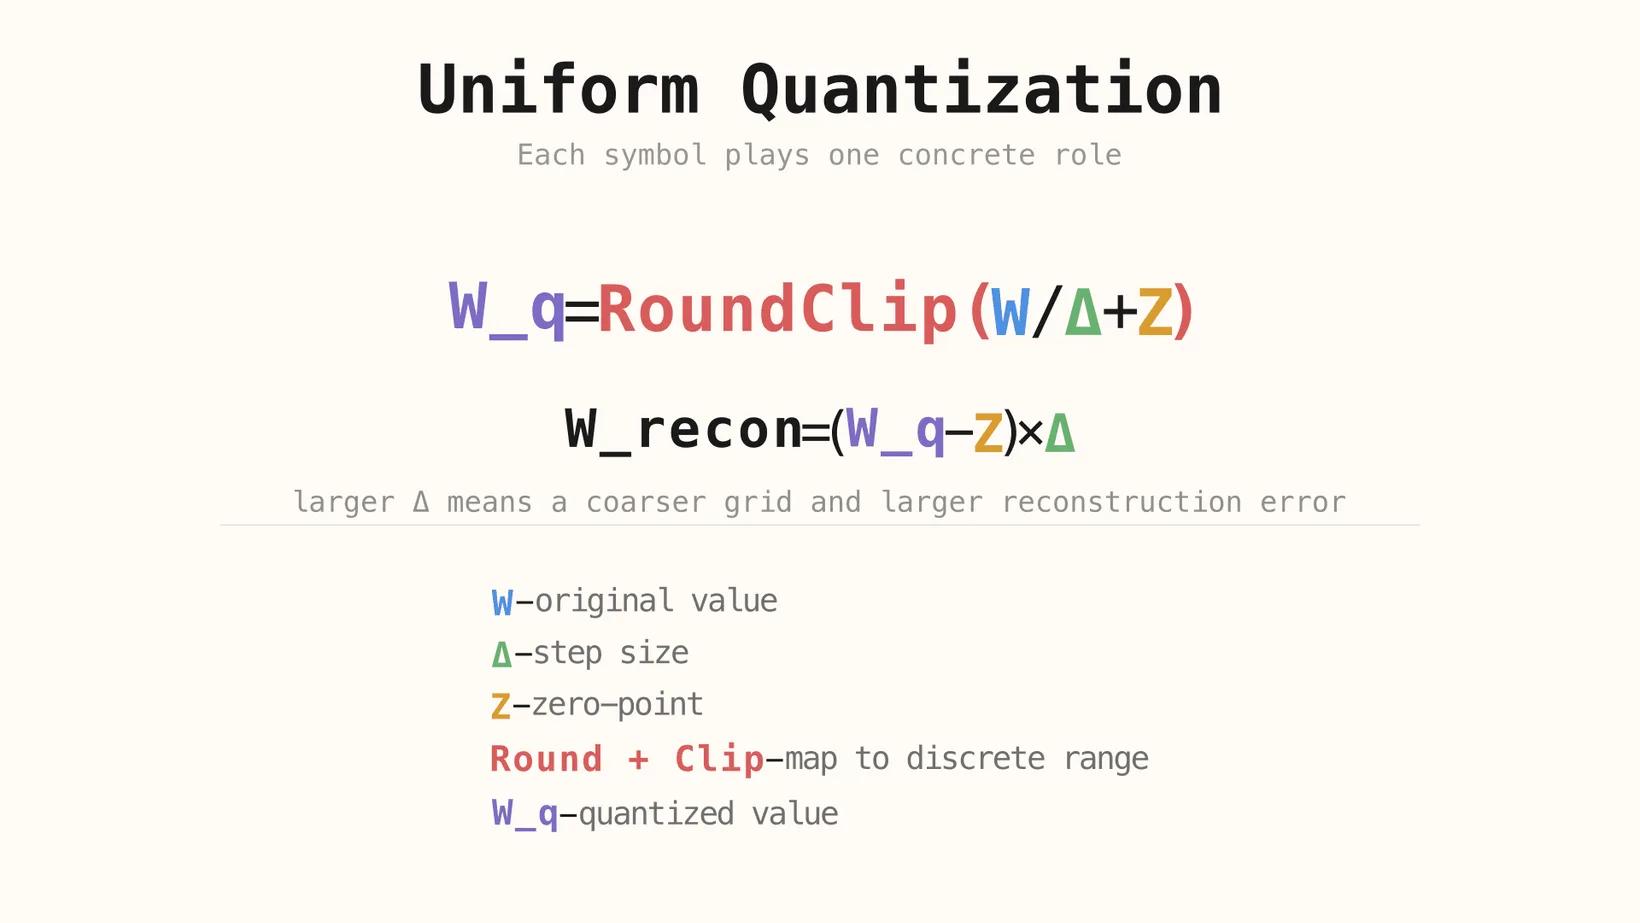
El proceso de cuantización puede entenderse como una secuencia de operaciones sencillas: escalar un valor, desplazarlo a una cuadrícula discreta, redondearlo, recortarlo al rango permitido y, después, reconstruirlo de forma aproximada durante la inferencia [1].
La W azul es el valor original de alta precisión. La Δ verde controla el tamaño de cada paso de cuantización, es decir, la resolución de la propia cuadrícula. La Z ámbar desplaza esa cuadrícula para que el cero pueda representarse correctamente cuando se necesita un mapeo asimétrico. La etapa roja Round + Clip fuerza entonces el valor dentro del rango de enteros discreto que permite el ancho de bits objetivo, lo que produce la W_q violeta.
En el momento de la inferencia, el modelo no recupera exactamente el valor original. Reconstruye una aproximación invirtiendo el mapeo con la misma escala y el mismo desplazamiento. Por eso la decuantización no es una inversa perfecta: una vez que varios valores reales cercanos se han colapsado en un único nivel discreto, el detalle perdido no se puede recuperar.
Reducir la precisión no daña el modelo al azar. Reduce el número de valores distintos que el modelo puede representar, lo que aumenta el error de aproximación y hace más difícil distinguir valores cercanos.
Lo importante es que esa pérdida es estructurada. Si la cuadrícula de cuantización es gruesa, las pequeñas diferencias entre pesos son lo primero que desaparece. Es decir, el modelo conserva la forma general de sus parámetros, pero pierde el detalle numérico fino. Cuando esto se repite en muchos tensores y capas, el error acumulado se convierte en el problema central que todo método de cuantización intenta gestionar [3].
La siguiente pregunta es por qué ese error se vuelve especialmente peligroso en los grandes modelos de lenguaje, en lugar de ser solo una leve molestia.
3. Por qué la cuantización ingenua falla en los LLM
El ejemplo decimal anterior es sencillo a propósito: muestra lo que ocurre cuando un valor pierde precisión. Los grandes modelos de lenguaje fallan por la misma razón de fondo, pero a una escala mucho más compleja. En lugar de redondear un solo número, tensores enteros pierden resolución a la vez, y esa pérdida interactúa con magnitudes desiguales, valores extremos poco frecuentes y sensibilidades propias de cada capa.
Si los pesos de un modelo son solo números, es tentador pensar que cuantizar consiste simplemente en redondearlos de forma más agresiva. En un pequeño ejemplo de juguete, esa intuición parece razonable: se reduce la representación, se acepta cierto error y listo. Pero los grandes transformers no son simples tablas enormes de números intercambiables. Su rendimiento depende de una estructura numérica muy desigual, repartida entre capas, canales y tokens.
Por eso, el redondeo ingenuo no produce una pérdida de calidad suave y uniforme. Puede destruir justo las distinciones de las que más depende la red. El resultado no es solo una menor precisión, sino a veces un colapso mucho más brusco de la coherencia, la perplejidad o la calidad del razonamiento de lo que predeciría un modelo mental simple del tipo «menos precisión equivale a un poco más de ruido».
3.2 Valores atípicos, pasos de cuantización inflados y activaciones masivas
El principal modo de fallo no es el redondeo en sí, sino lo que provoca cuando un tensor contiene valores extremos. Si un tensor tiene uno o unos pocos valores atípicos con una magnitud mucho mayor que el resto, la escala de cuantización tiene que estirarse para incluirlos. Esa escala mayor implica que cada paso discreto cubre ahora un rango de valores reales más amplio.
Cuando eso ocurre, los valores normales del centro de la distribución pierden resolución útil. En lugar de repartirse en muchos niveles distintos, colapsan en un número mucho menor de intervalos. En la práctica, el valor atípico obliga a todo el tensor a pagar por su rango. Por eso la Δ verde de la fórmula es tan importante: cuando Δ se vuelve demasiado grande, la cuadrícula es demasiado gruesa para la mayoría de los datos.
La misma idea va más allá de los pesos estáticos. Los modelos grandes también pueden desarrollar activaciones masivas, incluidos picos específicos de ciertos tokens que se comportan como attention sinks. No son casos límite inofensivos: generan exactamente el tipo de problema de escala desproporcionado que la cuantización ingenua gestiona mal [2] [5] [7].
A medida que los modelos crecen, estas patologías se vuelven más estructurales. Los grandes transformers desarrollan canales atípicos, picos de activación a nivel de token y comportamientos que hacen que la cuantización ingenua sea mucho menos fiable. Por tanto, el problema no es solo que «más parámetros significa más error de redondeo». El problema es que los modelos más grandes desarrollan una geometría numérica más difícil de comprimir con una única regla global burda [2][3].
Cuando se entiende la cuantización ingenua como un fallo en la gestión de la escala y el control del error, los métodos modernos de cuantización dejan de parecer siglas arbitrarias y pasan a verse como respuestas específicas.
4. Cómo se aplica realmente la cuantización hoy
4.1 Cuantización posentrenamiento frente a entrenamiento consciente de la cuantización
La cuantización moderna suele partir de la cuantización posentrenamiento (PTQ) o del entrenamiento consciente de la cuantización (QAT). La PTQ adapta un modelo una vez terminado el entrenamiento. Es barata, práctica y, por eso, predomina en los flujos de inferencia con modelos de pesos abiertos. El QAT es más caro porque expone el modelo a la cuantización durante el entrenamiento o el fine-tuning, pero a cambio puede preservar mejor la calidad cuando la precisión objetivo es muy baja [1][11][12].
Esta primera división es importante porque indica qué tipo de problema estamos resolviendo. La PTQ se pregunta: ¿cuánta compresión podemos obtener de un modelo existente sin reentrenarlo? El QAT se pregunta: ¿puede el modelo aprender desde el principio a funcionar en un régimen cuantizado?
4.2 Qué intentan preservar los métodos modernos
Cada método intenta preservar algo distinto porque no todos los errores de cuantización son igual de dañinos. Algunos métodos protegen los pesos o canales más importantes para las activaciones. Otros se centran en el escalado local para que una zona problemática de un tensor no arruine el resto. Otros se optimizan para el rendimiento, para objetivos de tasa de bits flexibles o para aprovechar mejor un stack de hardware concreto [6][4][5].
Por eso, la mejor forma de entender los métodos modernos de cuantización es como estrategias de control del error. Todos intentan responder a la misma pregunta: ¿qué información es demasiado importante para comprimirla de forma ingenua y cuál es la forma más barata de protegerla?
4.3 Principales métodos y formatos de despliegue en la práctica
El ecosistema actual no es una lista aleatoria de siglas, pero sí mezcla cosas de distinta naturaleza. AWQ, GPTQ y QAT son métodos de cuantización o enfoques de entrenamiento. GGUF y EXL2 se acercan más a formatos de modelo y ecosistemas de inferencia: importan porque empaquetan o ponen en funcionamiento modelos cuantizados de forma adaptada a determinado hardware y entornos de ejecución.
| Nombre | Tipo | Idea principal | Punto fuerte | Ideal para |
|---|---|---|---|---|
| GGUF | formato / ecosistema de despliegue | formato portátil de modelos cuantizados muy usado en stacks de inferencia local | portabilidad y valores predeterminados prácticos | CPU, Apple Silicon, configuraciones locales heterogéneas |
| AWQ | método de cuantización | proteger durante la cuantización los pesos relevantes para las activaciones | gran conservación de la calidad con pocos bits | inferencia en GPU cuando la calidad importa |
| GPTQ | método de cuantización | cuantización de pesos posentrenamiento de segundo orden | inferencia rápida con buena compresión | serving en GPU orientado al rendimiento |
| EXL2 | formato / ecosistema de ejecución | formato cuantizado de tasa de bits mixta ajustado a la inferencia al estilo ExLlama | equilibrio flexible entre memoria y velocidad | configuraciones de ExLlama multi-GPU o con VRAM limitada |
| QAT | enfoque de entrenamiento | entrenar o ajustar con la cuantización incluida en el proceso | máxima robustez con precisión muy baja | casos en los que el coste de reentrenar es asumible |
El objetivo de esta tabla no es memorizar nombres, sino darse cuenta de que cada fila resuelve una capa ligeramente distinta del problema: algunas describen cómo se cuantizan los pesos y otras cómo se empaquetan y ejecutan los modelos cuantizados. La tabla condensa ideas de la especificación GGUF, AWQ, GPTQ, ExLlamaV2 / EXL2 y trabajos recientes de QAT centrados en LLM, como LLM-QAT y EfficientQAT [9][6][4][10][11][12].
4.4 Cuándo tienen sentido estos métodos y formatos
Una vez claros los trade-offs, el panorama es más fácil de entender. GGUF es la opción natural cuando buscas una amplia portabilidad local y un formato que funcione bien en CPU y Apple Silicon [9]. AWQ y GPTQ encajan mejor cuando la prioridad es la inferencia en GPU, pero optimizan lados distintos del equilibrio: AWQ suele preferirse cuando importa más preservar la calidad, mientras que GPTQ se elige a menudo cuando el rendimiento es lo principal [6][4].
EXL2 tiene sentido cuando hacer que el modelo quepa en memoria es en sí el principal problema de optimización y quieres un control más fino de la tasa de bits dentro de un stack de inferencia concreto [10]. El QAT pertenece a otra categoría: no es un formato de serving, sino una estrategia de entrenamiento que resulta atractiva cuando un despliegue agresivo con pocos bits importa lo suficiente como para justificar reentrenar o ajustar el modelo para que resista el ruido de cuantización [11][12].
Pero elegir un método es solo la mitad de la historia. La pregunta más difícil es qué capacidades y comportamientos se vuelven menos estables una vez aplicada esa compresión.
5. Los costes ocultos de la cuantización
5.1 Degradación de capacidades: razonamiento, contexto y fiabilidad multimodal
Evaluaciones recientes sugieren que reducir la precisión puede degradar la calidad del razonamiento y el comportamiento con contextos largos, y que el mismo problema de robustez con pocos bits también puede afectar a los sistemas multimodales. Estas degradaciones suelen ser desiguales: algunas tareas se mantienen estables mientras otras empeoran de forma notable. Un modelo puede conservar la fluidez y aun así perder fiabilidad en matemáticas de varios pasos, cadenas largas de inferencia o tareas que dependen de que pequeñas distinciones internas se mantengan a lo largo de muchas capas [15][16][12].
Esta desigualdad es una de las razones por las que la cuantización puede resultar engañosa si solo se evalúa con una pequeña muestra de benchmarks. Un modelo que parece casi igual con prompts cortos puede perder calidad con contextos más largos, tareas de razonamiento más difíciles o entradas multimodales en las que el error se acumula con más fuerza [13][14][16].
5.2 Fallos silenciosos en agentes y en el comportamiento real
Evaluaciones recientes también sugieren que los modelos cuantizados pueden fallar de formas más discretas. El uso de herramientas, la planificación en varios pasos y los flujos de trabajo agénticos pueden volverse más frágiles incluso cuando el modelo sigue pareciendo fluido en la superficie. Es un perfil peligroso, porque produce modelos que suenan competentes mientras pierden fiabilidad justo en los momentos en que importan los sistemas externos, las herramientas o las consecuencias diferidas [14][17].
En la práctica, esto significa que la cuantización debe evaluarse no solo como un problema de generación de texto, sino como un problema de comportamiento del sistema. Si un modelo forma parte de un bucle de agente, un stack de recuperación o un flujo de llamadas a herramientas, una pequeña pérdida de fiabilidad a nivel de token puede convertirse en un fallo operativo mucho mayor.
5.3 Distorsiones en seguridad, sesgo y alineamiento
Evaluaciones recientes sugieren que la compresión también puede alterar las propiedades de seguridad y de comportamiento. La cuantización no hace que un modelo sea automáticamente inseguro o sesgado, pero puede distorsionar los mecanismos que sostienen el alineamiento, las salvaguardas y un comportamiento estable. Si algunos comportamientos ya son numéricamente frágiles, la compresión con pocos bits puede desplazarlos lo suficiente como para cambiar las negativas del modelo, su tendencia a la toxicidad o su robustez frente a prompts adversarios [13][17].
La postura correcta no es ni la negación ni el pánico. La cuantización debe tratarse como una intervención que cambia el comportamiento y cuyos efectos hay que medir directamente. No basta con preguntar si el modelo es más pequeño y más rápido; también hay que preguntarse qué propiedades se han vuelto menos estables al eliminar resolución.
6. Conclusión: cuantización
La cuantización hace que los modelos grandes sean más baratos de almacenar, más fáciles de mover y más prácticos de desplegar. Es una de las principales razones por las que los modelos avanzados pueden ejecutarse fuera de infraestructuras especializadas. En ese sentido, la cuantización es una de las tecnologías clave detrás de la accesibilidad de los LLM modernos: sin ella, muchos modelos seguirían atrapados tras presupuestos de hardware que solo unos pocos usuarios u organizaciones podrían asumir.
La misma compresión que hace viable el despliegue también puede restar resolución útil a los cálculos internos del modelo. Esa pérdida puede manifestarse como un razonamiento degradado, inestabilidad silenciosa o cambios de comportamiento. La lección importante es que la cuantización nunca es «gratis». Incluso cuando claramente merece la pena, cambia el régimen numérico en el que piensa el modelo.
6.1 Hacia dónde va la investigación
La investigación actual avanza hacia métodos de pocos bits más inteligentes, una mejor protección de las activaciones sensibles, formatos adaptados al hardware y una evaluación más fina de lo que cambia la compresión más allá de la precisión en benchmarks. La dirección general está clara: el trabajo futuro no consiste solo en hacer que los modelos quepan en menos bits, sino en aprender qué partes de un modelo pueden comprimirse de forma agresiva y cuáles deben seguir protegidas numéricamente [6][12][17].
Por eso la cuantización debe entenderse como una capa central de diseño y no como un truco de almacenamiento de última hora. Se sitúa entre la calidad del modelo, el coste de despliegue y la fiabilidad del comportamiento, y los mejores métodos modernos son intentos de equilibrar esas tres presiones de forma más inteligente.
Bibliografía
[1] Jacob et al. (2018). Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. Referencia fundacional sobre la cuantización con escala / punto cero y el entrenamiento consciente de la cuantización.
[2] Dettmers et al. (2022). LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. Referencia clave sobre los valores atípicos en transformers y por qué la compresión ingenua con pocos bits falla de otra manera a gran escala.
[3] Gong et al. (2024). What Makes Quantization for Large Language Models Hard? An Empirical Study from the Lens of Perturbation. Referencia útil para entender el error de cuantización como una perturbación estructurada y no como ruido genérico.
[4] Frantar et al. (2022). GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. Fuente principal sobre la cuantización posentrenamiento de segundo orden en modelos de tipo GPT.
[5] Xiao et al. (2023). SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models. Referencia clave sobre el tratamiento de activaciones atípicas en la cuantización de pesos y activaciones.
[6] Lin et al. (2023). AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration. Fuente principal sobre la protección de los pesos relevantes para las activaciones en la cuantización de LLM con pocos bits.
[7] Lee et al. (2023). OWQ: Outlier-Aware Weight Quantization for Efficient Fine-Tuning and Inference of Large Language Models. Referencia útil sobre cuantización con pocos bits sensible a valores atípicos y fine-tuning.
[8] Dettmers et al. (2023). QLoRA: Efficient Finetuning of Quantized LLMs. Referencia importante sobre fine-tuning cuantizado a 4 bits y flujos de entrenamiento basados en NF4.
[9] ggml / llama.cpp. GGUF format specification. Especificación oficial del formato de archivo GGUF tratado en la sección de métodos orientados al despliegue.
[10] turboderp-org. ExLlamaV2 README and EXL2 quantization notes. Referencia principal de implementación del flujo de trabajo local en GPU con tasa de bits mixta de EXL2.
[11] Liu et al. (2023). LLM-QAT: Data-Free Quantization Aware Training for Large Language Models. Una de las primeras referencias de QAT específicas para LLM, especialmente relevante por debajo de 8 bits.
[12] Chen et al. (2024). EfficientQAT: Efficient Quantization-Aware Training for Large Language Models. Trabajo más reciente de QAT para LLM centrado en la eficiencia práctica del entrenamiento con pocos bits.
[13] Jin et al. (2024). A Comprehensive Evaluation of Quantization Strategies for Large Language Models. Marco de evaluación amplio que abarca capacidades, alineamiento y eficiencia.
[14] Lee et al. (2024). Exploring the Trade-Offs: Quantization Methods, Task Difficulty, and Model Size in Large Language Models From Edge to Giant. Comparación a gran escala entre modelos, cuantizadores y familias de benchmarks.
[15] Li et al. (2025). Quantization Meets Reasoning: Exploring LLM Low-Bit Quantization Degradation for Mathematical Reasoning. Evidencia directa de la degradación del razonamiento con cuantización agresiva de pocos bits.
[16] Mekala et al. (2025). Does quantization affect models' performance on long-context tasks?. Referencia principal sobre la degradación en contextos largos bajo cuantización.
[17] Kharinaev et al. (2025). Investigating the Impact of Quantization Methods on the Safety and Reliability of Large Language Models. Referencia para la sección de seguridad y fiabilidad, y para entender por qué los cambios de comportamiento deben medirse directamente.
