

LLMs quantisieren: So funktioniert es und darauf sollten Sie achten
 Toni Lopez Co-Founder at Karumi
1. Einführung in die Quantisierung
Quantisierung macht große Sprachmodelle praktisch nutzbar, indem sie ihre numerische Darstellung komprimiert – doch jedes entfernte Bit bringt Kompromisse bei Genauigkeit, Robustheit und Verhalten mit sich.
Große Sprachmodelle werden mit wachsender Größe nicht nur zum Rechenproblem, sondern vor allem zum Speicherproblem. Jeder Parameter muss irgendwo gespeichert, durch den Speicher bewegt und schnell genug gelesen werden, damit die Inferenz praktikabel bleibt. Wenn Modelle von Milliarden auf zig oder Hunderte Milliarden Parameter anwachsen, wird dieses Bewegen der Gewichte zu einem der größten Engpässe.
Das nennt man häufig die Memory Wall: Die Rechenhardware wird zwar immer leistungsfähiger, doch Speicherkapazität und -bandbreite wachsen nicht im gleichen Tempo. Ein Modell kann also schwer zu betreiben sein – nicht, weil die Arithmetik unmöglich wäre, sondern weil es zu teuer ist, seine Gewichte effizient vorzuhalten und zu bewegen.
Ein großes Modell in FP16 oder BF16 kann weit mehr Speicher benötigen, als Consumer-Hardware bequem bereitstellen kann. Ein 70B-Modell in 16-Bit-Präzision übersteigt bereits deutlich, was die meisten lokalen Setups problemlos laden können – und diese Schätzung umfasst nur die statischen Gewichte. In der Praxis braucht die Inferenz zusätzlich Platz für Aktivierungen, temporäre Puffer und den KV-Cache [13][16].
Deshalb ist Quantisierung keine Nischenoptimierung. Ohne irgendeine Form der Kompression bleiben viele nützliche Modelle hinter teuren GPUs, Deployments auf Server-Niveau oder aggressiven Offloading-Strategien verschlossen. Quantisierung ist die Technik, die aus dieser harten Hardwaregrenze einen steuerbaren Kompromiss zwischen Genauigkeit und Effizienz macht [13][14].
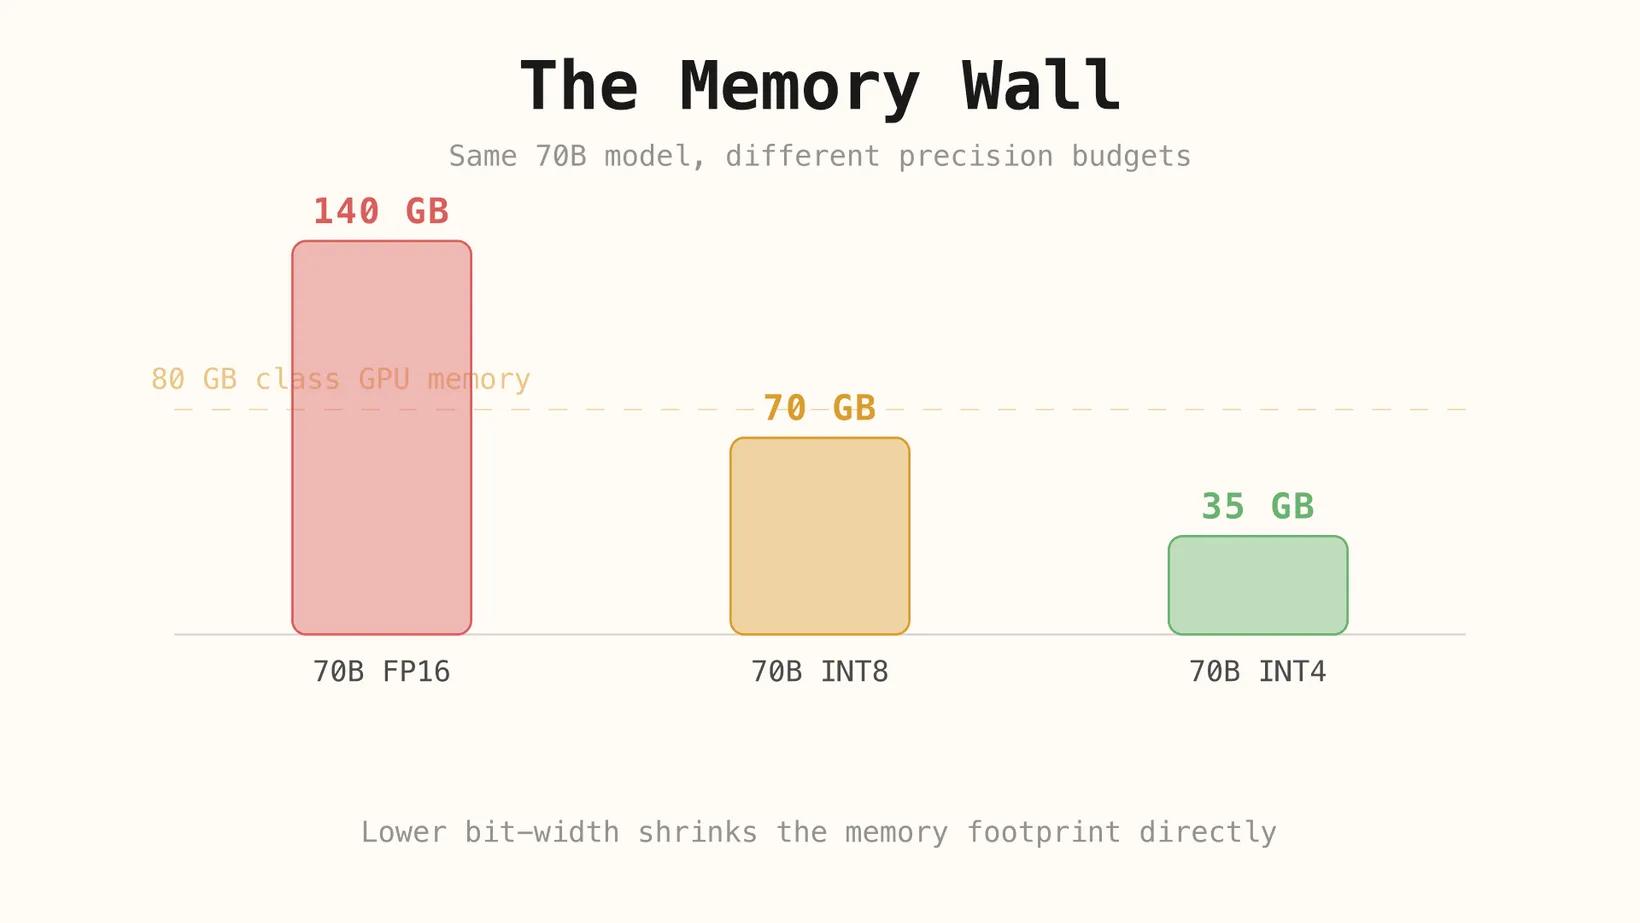
Dieser Artikel verfolgt diesen Kompromiss von Anfang bis Ende. Zunächst wird erklärt, was Quantisierung als mathematische Operation ist. Dann zeigt er, warum die naive Umsetzung dieser Idee große Transformer zerstört. Anschließend gibt er einen Überblick über die wichtigsten modernen Ansätze, die den entstehenden Fehler kontrollieren sollen, und betrachtet schließlich die Fähigkeiten und Verhaltensweisen, die bei sinkender Präzision unbemerkt nachlassen können.
2. Die Grundidee der Quantisierung
Im Kern bedeutet Quantisierung, ein reichhaltiges numerisches Vokabular durch ein kleineres zu ersetzen. Statt einem Gewicht viele fein abgestufte Gleitkommawerte zu erlauben, zwingen wir es auf ein kleineres diskretes Raster. Je stärker wir die Zahl der verfügbaren Stufen reduzieren, desto kompakter wird die Darstellung.
Das bringt zwei unmittelbare Vorteile. Erstens braucht das Modell weniger Speicher, weil jedes Gewicht weniger Bits belegt. Zweitens muss die Hardware weniger Daten bewegen, was die Inferenzgeschwindigkeit in der Praxis oft verbessert. Doch diese Gewinne haben einen echten Preis: Werte, die vorher unterscheidbar waren, können nun in derselben Low-Bit-Darstellung zusammenfallen.
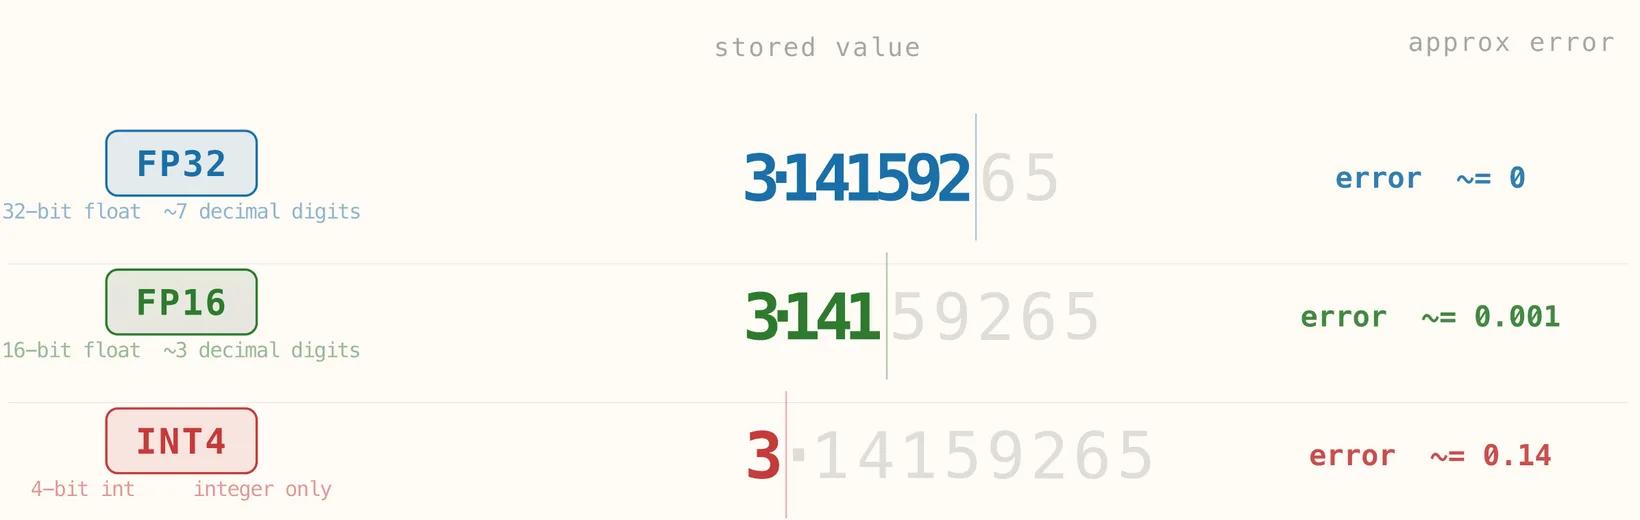
Die folgende Abbildung zeigt diesen Preis anhand eines einzelnen Werts in unterschiedlichen Präzisionen. In FP32 bleiben fast alle Nachkommastellen erhalten, der Approximationsfehler ist praktisch vernachlässigbar. In FP16 geht ein Teil dieser Details durch Rundung verloren, der gespeicherte Wert liegt aber noch nahe am Original. In INT4 kann das Modell feine Nachkommastrukturen überhaupt nicht mehr abbilden: Der gespeicherte Wert wird deutlich gröber, und der Fehler steigt stark an. Die Kernidee ist einfach: Je niedriger die Präzision, desto ungenauer kann das Modell die ursprüngliche Zahl speichern.
2.1 Die Quantisierungsformel
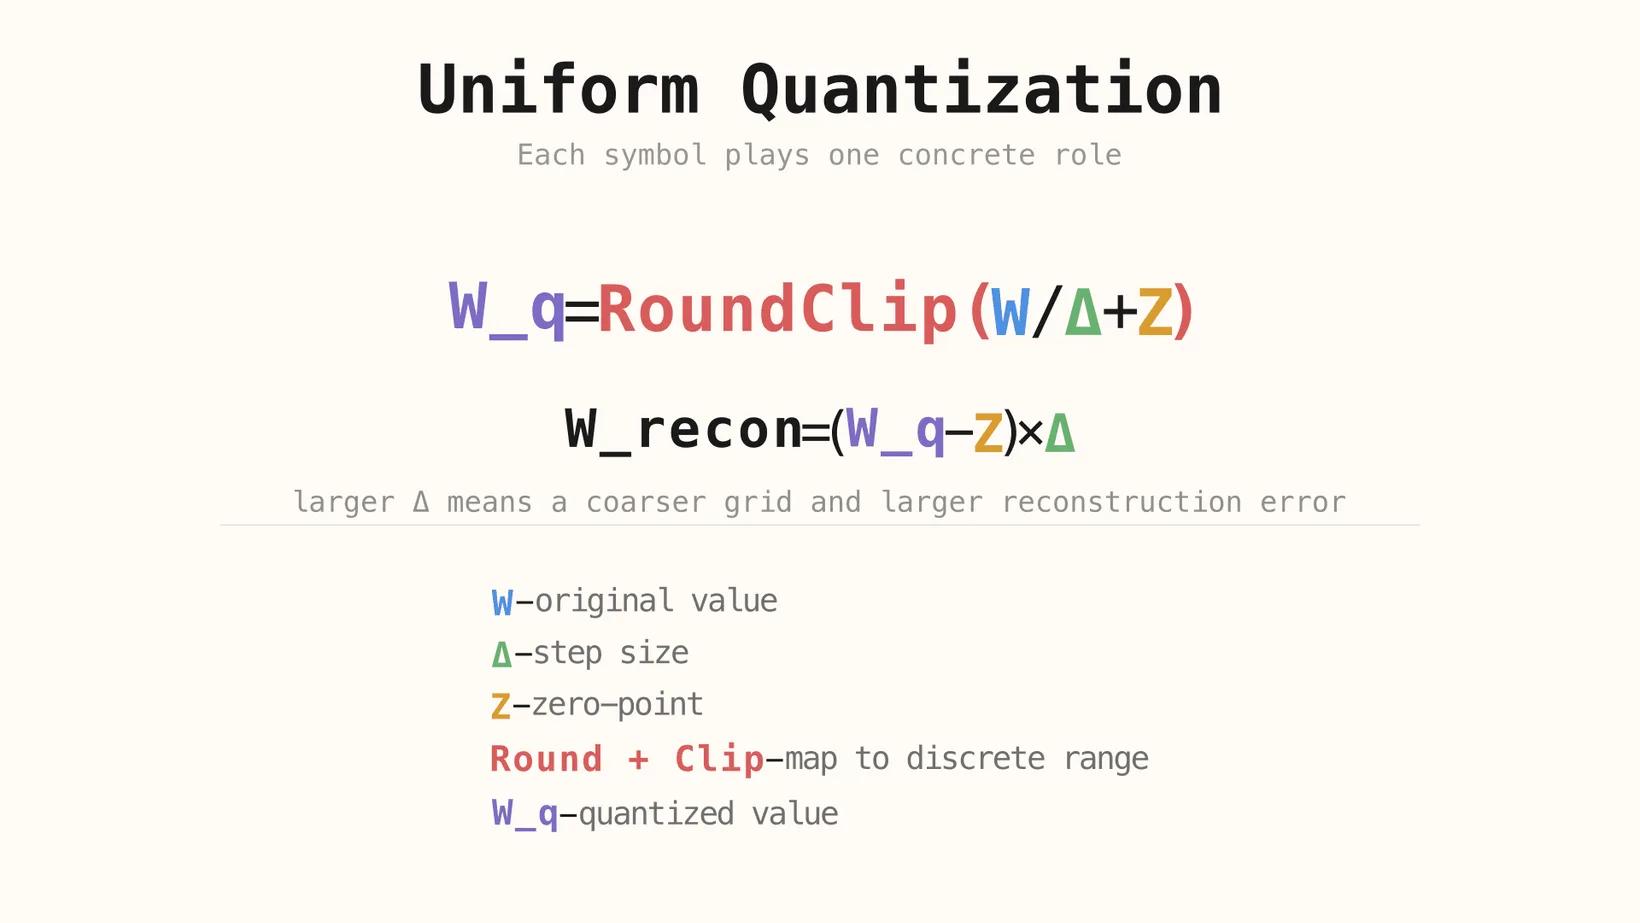
Die Quantisierungspipeline lässt sich als Abfolge einfacher Operationen verstehen: einen Wert skalieren, ihn auf ein diskretes Raster verschieben, runden, auf den zulässigen Bereich begrenzen und ihn dann bei der Inferenz näherungsweise rekonstruieren [1].
Das blaue W ist der ursprüngliche hochpräzise Wert. Das grüne Δ bestimmt die Größe jedes Quantisierungsschritts und damit die Auflösung des Rasters selbst. Das bernsteinfarbene Z verschiebt dieses Raster, damit null korrekt dargestellt werden kann, wenn eine asymmetrische Abbildung nötig ist. Die rote Stufe Round + Clip zwingt den Wert anschließend in den diskreten Ganzzahlbereich, den die Ziel-Bitbreite zulässt, und erzeugt so das violette W_q.
Bei der Inferenz gewinnt das Modell den ursprünglichen Wert nicht exakt zurück. Es rekonstruiert eine Näherung, indem es die Abbildung mit derselben Skalierung und demselben Offset umkehrt. Deshalb ist die Dequantisierung keine perfekte Umkehrung: Sobald mehrere benachbarte reelle Werte auf eine einzige diskrete Stufe zusammengefallen sind, lässt sich das verlorene Detail nicht wiederherstellen.
Geringere Präzision schädigt das Modell nicht zufällig. Sie verringert die Zahl der unterscheidbaren Werte, die das Modell darstellen kann – dadurch steigt der Approximationsfehler, und benachbarte Werte lassen sich schwerer unterscheiden.
Entscheidend ist, dass dieser Verlust strukturiert ist. Ist das Quantisierungsraster grob, verschwinden zuerst die kleinen Unterschiede zwischen Gewichten. Das Modell behält also die grobe Form seiner Parameter, verliert aber feine numerische Details. Wiederholt sich das über viele Tensoren und Schichten hinweg, wird der akkumulierte Fehler zum zentralen Problem, das jede Quantisierungsmethode in den Griff bekommen will [3].
Bleibt die Frage, warum dieser Fehler gerade in großen Sprachmodellen gefährlich wird – statt nur leicht störend zu sein.
3. Warum naive Quantisierung bei LLMs scheitert
Das obige Dezimalbeispiel ist bewusst einfach gehalten: Es zeigt, was passiert, wenn ein einzelner Wert an Präzision verliert. Große Sprachmodelle scheitern aus demselben Grund, aber auf einer weitaus schwierigeren Ebene. Statt einer einzelnen Zahl verlieren ganze Tensoren auf einmal an Auflösung, und dieser Verlust wirkt mit ungleichen Größenordnungen, seltenen Extremwerten und schichtspezifischen Empfindlichkeiten zusammen.
Wenn Modellgewichte nur Zahlen sind, liegt die Annahme nahe, Quantisierung bestehe lediglich darin, sie stärker zu runden. Bei einem kleinen Spielzeugbeispiel wirkt diese Intuition plausibel: Darstellung verkleinern, etwas Fehler in Kauf nehmen, weiter geht’s. Große Transformer sind jedoch nicht einfach riesige Tabellen austauschbarer Zahlen. Ihre Leistung hängt von einer sehr ungleichmäßigen numerischen Struktur ab, die über Schichten, Kanäle und Tokens verteilt ist.
Naives Runden führt daher nicht zu einem sanften, gleichmäßigen Qualitätsverlust. Es kann genau die Unterscheidungen zerstören, auf die das Netz am stärksten angewiesen ist. Das Ergebnis ist nicht nur eine geringere Genauigkeit, sondern mitunter ein weit abrupterer Einbruch bei Kohärenz, Perplexität oder Schlussfolgerungsqualität, als das simple Denkmodell „weniger Präzision gleich etwas mehr Rauschen“ erwarten ließe.
3.2 Ausreißer, aufgeblähte Schrittweiten und massive Aktivierungen
Das Hauptproblem ist nicht das Runden an sich, sondern was das Runden bewirkt, wenn ein Tensor Extremwerte enthält. Enthält ein Tensor einen oder wenige Ausreißer mit deutlich größerem Betrag als der Rest, muss sich die Quantisierungsskala dehnen, um sie abzudecken. Eine größere Skala bedeutet, dass jeder diskrete Schritt nun einen breiteren Bereich reeller Werte abdeckt.
Sobald das passiert, verlieren die gewöhnlichen Werte in der Mitte der Verteilung nutzbare Auflösung. Statt auf viele unterscheidbare Stufen abgebildet zu werden, fallen sie in deutlich weniger Buckets zusammen. Im Grunde zwingt der Ausreißer den gesamten Tensor, für seinen Wertebereich zu bezahlen. Deshalb ist das grüne Δ in der Formel so wichtig: Wird Δ zu groß, ist das Raster für den Großteil der Daten zu grob.
Dieselbe Idee gilt nicht nur für statische Gewichte. Große Modelle können auch massive Aktivierungen entwickeln, darunter tokenspezifische Spitzen, die sich wie Attention Sinks verhalten. Das sind keine harmlosen Randfälle. Sie erzeugen genau die Art von unverhältnismäßigem Skalierungsproblem, mit dem naive Quantisierung schlecht umgehen kann [2] [5] [7].
Je größer die Modelle werden, desto struktureller werden diese Pathologien. Große Transformer entwickeln Ausreißerkanäle, Aktivierungsspitzen auf Token-Ebene und Verhaltensweisen, die naive Quantisierung deutlich unzuverlässiger machen. Das Problem ist also nicht nur „mehr Parameter bedeuten mehr Rundungsfehler“. Das Problem ist, dass größere Modelle eine numerische Geometrie entwickeln, die sich mit einer einzigen groben globalen Regel schwerer komprimieren lässt [2][3].
Versteht man naive Quantisierung als Versagen bei Skalierungsmanagement und Fehlerkontrolle, wirken moderne Quantisierungsmethoden nicht mehr wie beliebige Akronyme, sondern wie gezielte Antworten.
4. Wie Quantisierung heute tatsächlich eingesetzt wird
4.1 Post-Training-Quantisierung vs. Quantization-Aware Training
Moderne Quantisierung beginnt in der Regel entweder mit Post-Training-Quantisierung (PTQ) oder mit Quantization-Aware Training (QAT). PTQ passt ein Modell an, nachdem das Training abgeschlossen ist. Sie ist günstig, praktisch und daher in Inferenz-Workflows mit Open-Weight-Modellen vorherrschend. QAT ist aufwendiger, weil das Modell bereits während des Trainings oder Fine-Tunings der Quantisierung ausgesetzt wird – dafür bleibt die Qualität besser erhalten, wenn die Zielpräzision sehr niedrig wird [1][11][12].
Diese erste Unterscheidung ist wichtig, weil sie zeigt, welches Problem wir lösen. PTQ fragt: Wie viel Kompression lässt sich aus einem bestehenden Modell herausholen, ohne es neu zu trainieren? QAT fragt: Kann das Modell von Anfang an lernen, in einem quantisierten Regime zu funktionieren?
4.2 Was moderne Methoden bewahren wollen
Verschiedene Methoden wollen Unterschiedliches bewahren, weil nicht jeder Quantisierungsfehler gleich schädlich ist. Manche Methoden schützen die Gewichte oder Kanäle, die für die Aktivierungen am wichtigsten sind. Andere setzen auf lokale Skalierung, damit ein problematischer Bereich eines Tensors nicht den Rest ruiniert. Wieder andere sind auf Durchsatz, flexible Bitraten-Ziele oder die effizientere Nutzung eines bestimmten Hardware-Stacks optimiert [6][4][5].
Deshalb versteht man moderne Quantisierungsmethoden am besten als Strategien zur Fehlerkontrolle. Sie alle versuchen, dieselbe Frage zu beantworten: Welche Information ist zu wichtig, um naiv komprimiert zu werden, und wie lässt sie sich am günstigsten schützen?
4.3 Wichtige Methoden und Deployment-Formate in der Praxis
Das heutige Ökosystem ist keine zufällige Liste von Akronymen, vermischt aber durchaus unterschiedliche Dinge. AWQ, GPTQ und QAT sind Quantisierungsmethoden bzw. Trainingsansätze. GGUF und EXL2 sind eher Modellformate und Inferenz-Ökosysteme: Sie sind relevant, weil sie quantisierte Modelle so verpacken oder nutzbar machen, dass sie zu bestimmter Hardware und bestimmten Laufzeitumgebungen passen.
| Name | Typ | Grundidee | Stärke | Ideal für |
|---|---|---|---|---|
| GGUF | Format / Deployment-Ökosystem | portables quantisiertes Modellformat, weit verbreitet in lokalen Inferenz-Stacks | Portabilität und praxistaugliche Standardeinstellungen | CPUs, Apple Silicon, heterogene lokale Setups |
| AWQ | Quantisierungsmethode | aktivierungsrelevante Gewichte bei der Quantisierung schützen | hoher Qualitätserhalt bei niedriger Bitbreite | GPU-Inferenz, bei der Qualität zählt |
| GPTQ | Quantisierungsmethode | Post-Training-Quantisierung der Gewichte zweiter Ordnung | schnelle Inferenz bei guter Kompression | durchsatzorientiertes GPU-Serving |
| EXL2 | Format / Laufzeit-Ökosystem | quantisiertes Format mit gemischter Bitrate, abgestimmt auf Inferenz im ExLlama-Stil | flexibler Kompromiss zwischen Speicher und Geschwindigkeit | Multi-GPU- oder VRAM-begrenzte ExLlama-Setups |
| QAT | Trainingsansatz | Training oder Fine-Tuning mit Quantisierung im Loop | höchste Robustheit bei sehr niedriger Präzision | Fälle, in denen die Kosten für erneutes Training vertretbar sind |
Es geht bei dieser Tabelle nicht darum, Namen auswendig zu lernen. Sie soll zeigen, dass jede Zeile eine etwas andere Ebene des Problems löst: Manche Zeilen beschreiben, wie Gewichte quantisiert werden, andere, wie quantisierte Modelle verpackt und ausgeführt werden. Die Tabelle fasst Ideen aus der GGUF-Spezifikation, AWQ, GPTQ, ExLlamaV2 / EXL2 sowie aktuellen LLM-spezifischen QAT-Arbeiten wie LLM-QAT und EfficientQAT zusammen [9][6][4][10][11][12].
4.4 Wann diese Methoden und Formate sinnvoll sind
Sind die Kompromisse klar, lässt sich die Landschaft leichter einordnen. GGUF ist die naheliegende Wahl, wenn Sie breite lokale Portabilität und ein Format wünschen, das auf CPUs und Apple Silicon gut funktioniert [9]. AWQ und GPTQ bieten sich eher an, wenn GPU-Inferenz Priorität hat, optimieren aber unterschiedliche Seiten des Kompromisses: AWQ wird tendenziell bevorzugt, wenn der Erhalt der Qualität wichtiger ist, während GPTQ oft gewählt wird, wenn der Durchsatz im Mittelpunkt steht [6][4].
EXL2 ist sinnvoll, wenn es vor allem darum geht, das Modell überhaupt in den Speicher zu bekommen, und Sie innerhalb eines bestimmten Inferenz-Stacks eine feinere Kontrolle über die Bitrate möchten [10]. QAT gehört in eine ganz andere Kategorie: Es ist kein Serving-Format, sondern eine Strategie zur Trainingszeit. Sie wird attraktiv, wenn ein aggressives Low-Bit-Deployment so wichtig ist, dass es sich lohnt, das Modell neu zu trainieren oder per Fine-Tuning so anzupassen, dass es das Quantisierungsrauschen verkraftet [11][12].
Doch die Wahl der Methode ist nur die halbe Geschichte. Die schwierigere Frage lautet, welche Fähigkeiten und Verhaltensweisen weniger stabil werden, sobald diese Kompression angewendet wurde.
5. Die versteckten Kosten der Quantisierung
5.1 Nachlassende Fähigkeiten: Reasoning, Kontext und multimodale Zuverlässigkeit
Aktuelle Evaluierungen deuten darauf hin, dass eine geringere Präzision die Qualität des Schlussfolgerns und das Verhalten bei langen Kontexten beeinträchtigen kann – und dasselbe Robustheitsproblem bei niedriger Bitbreite kann auch multimodale Systeme betreffen. Diese Verschlechterungen sind oft ungleichmäßig: Manche Aufgaben bleiben stabil, andere verschlechtern sich deutlich. Ein Modell kann flüssig formulieren und trotzdem an Zuverlässigkeit verlieren – etwa bei mehrstufiger Mathematik, langen Inferenzketten oder Aufgaben, bei denen kleine interne Unterschiede über viele Schichten hinweg erhalten bleiben müssen [15][16][12].
Diese Ungleichmäßigkeit ist ein Grund, warum Quantisierung täuschen kann, wenn sie nur anhand eines kleinen Benchmark-Ausschnitts bewertet wird. Ein Modell, das bei kurzen Prompts nahezu unverändert wirkt, kann bei längeren Kontexten, anspruchsvolleren Reasoning-Aufgaben oder multimodalen Eingaben, bei denen sich der Fehler stärker aufschaukelt, dennoch an Qualität verlieren [13][14][16].
5.2 Stille Ausfälle bei Agenten und im realen Einsatz
Aktuelle Evaluierungen deuten außerdem darauf hin, dass quantisierte Modelle auf leisere Weise versagen können. Tool-Nutzung, mehrstufige Planung und agentische Workflows können fragiler werden, selbst wenn das Modell an der Oberfläche weiterhin flüssig wirkt. Das ist ein gefährliches Profil: Es entstehen Modelle, die kompetent klingen, aber genau dann an Zuverlässigkeit verlieren, wenn externe Systeme, Tools oder verzögerte Konsequenzen ins Spiel kommen [14][17].
In der Praxis heißt das: Quantisierung sollte nicht nur als Problem der Textgenerierung, sondern als Problem des Systemverhaltens bewertet werden. Ist ein Modell Teil einer Agenten-Schleife, eines Retrieval-Stacks oder eines Tool-Calling-Workflows, kann ein kleiner Zuverlässigkeitsverlust auf Token-Ebene zu einem deutlich größeren operativen Ausfall führen.
5.3 Verzerrungen bei Sicherheit, Bias und Alignment
Aktuelle Evaluierungen deuten darauf hin, dass Kompression auch Sicherheits- und Verhaltenseigenschaften verändern kann. Quantisierung macht ein Modell nicht automatisch unsicher oder voreingenommen, kann aber die Mechanismen verzerren, die Alignment, Guardrails und stabiles Verhalten stützen. Sind bestimmte Verhaltensweisen numerisch ohnehin fragil, kann Low-Bit-Kompression sie so weit verschieben, dass sich das Ablehnungsverhalten, Tendenzen zu toxischen Inhalten oder die Robustheit gegenüber adversarialen Prompts ändern [13][17].
Die richtige Haltung ist weder Verdrängung noch Panik. Quantisierung sollte als Eingriff behandelt werden, der das Verhalten verändert und dessen Auswirkungen direkt gemessen werden müssen. Es reicht nicht zu fragen, ob das Modell kleiner und schneller ist; wir müssen auch fragen, welche Eigenschaften weniger stabil geworden sind, als Auflösung entfernt wurde.
6. Fazit: Quantisierung
Quantisierung macht große Modelle günstiger zu speichern, leichter zu bewegen und praktischer bereitzustellen. Sie ist einer der Hauptgründe, warum fortgeschrittene Modelle auch außerhalb spezialisierter Infrastruktur laufen können. In diesem Sinne ist Quantisierung eine der Schlüsseltechnologien hinter der breiten Zugänglichkeit moderner LLMs: Ohne sie blieben viele Modelle hinter Hardwarebudgets gefangen, die nur wenige Nutzer oder Organisationen stemmen könnten.
Dieselbe Kompression, die das Deployment praktikabel macht, kann den internen Berechnungen des Modells aber auch nützliche Auflösung entziehen. Dieser Verlust kann sich als schlechteres Reasoning, stille Instabilität oder verändertes Verhalten zeigen. Die wichtigste Lehre: Quantisierung ist nie „kostenlos“. Selbst wenn sie sich eindeutig lohnt, verändert sie das numerische Regime, in dem das Modell denkt.
6.1 Wohin sich die Forschung entwickelt
Die aktuelle Forschung bewegt sich in Richtung intelligenterer Low-Bit-Methoden, besseren Schutzes sensibler Aktivierungen, hardwarebewusster Formate und einer feineren Bewertung dessen, was Kompression jenseits der Benchmark-Genauigkeit verändert. Die grobe Richtung ist klar: Künftig geht es nicht nur darum, Modelle in weniger Bits unterzubringen, sondern zu verstehen, welche Teile eines Modells sich aggressiv komprimieren lassen und welche numerisch geschützt bleiben müssen [6][12][17].
Deshalb sollte Quantisierung als zentrale Designebene verstanden werden und nicht als letzter Speichertrick. Sie steht zwischen Modellqualität, Deployment-Kosten und Verhaltenszuverlässigkeit – und die besten modernen Methoden sind allesamt Versuche, diese drei Anforderungen intelligenter auszubalancieren.
Literaturverzeichnis
[1] Jacob et al. (2018). Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. Grundlegende Referenz für Scale-/Zero-Point-Quantisierung und Quantization-Aware Training.
[2] Dettmers et al. (2022). LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. Zentrale Referenz zu Ausreißern in Transformern und dazu, warum naive Low-Bit-Kompression im großen Maßstab anders scheitert.
[3] Gong et al. (2024). What Makes Quantization for Large Language Models Hard? An Empirical Study from the Lens of Perturbation. Hilfreiche Referenz, um Quantisierungsfehler als strukturierte Störung statt als generisches Rauschen zu verstehen.
[4] Frantar et al. (2022). GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. Primärquelle für Post-Training-Quantisierung zweiter Ordnung in Modellen im GPT-Stil.
[5] Xiao et al. (2023). SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models. Wichtige Referenz zum Umgang mit Aktivierungsausreißern bei der Quantisierung von Gewichten und Aktivierungen.
[6] Lin et al. (2023). AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration. Primärquelle zum Schutz aktivierungsrelevanter Gewichte bei der Low-Bit-Quantisierung von LLMs.
[7] Lee et al. (2023). OWQ: Outlier-Aware Weight Quantization for Efficient Fine-Tuning and Inference of Large Language Models. Hilfreiche Referenz zu ausreißersensitiver Low-Bit-Quantisierung und Fine-Tuning.
[8] Dettmers et al. (2023). QLoRA: Efficient Finetuning of Quantized LLMs. Wichtige Referenz zu 4-Bit-quantisiertem Fine-Tuning und NF4-basierten Trainings-Workflows.
[9] ggml / llama.cpp. GGUF format specification. Offizielle Spezifikation des GGUF-Dateiformats, das im Abschnitt über deploymentorientierte Methoden behandelt wird.
[10] turboderp-org. ExLlamaV2 README and EXL2 quantization notes. Primäre Implementierungsreferenz für den lokalen GPU-Workflow von EXL2 mit gemischter Bitrate.
[11] Liu et al. (2023). LLM-QAT: Data-Free Quantization Aware Training for Large Language Models. Frühe LLM-spezifische QAT-Referenz, besonders relevant unterhalb von 8-Bit-Präzision.
[12] Chen et al. (2024). EfficientQAT: Efficient Quantization-Aware Training for Large Language Models. Neuere LLM-QAT-Arbeit mit Fokus auf praktischer Effizienz beim Low-Bit-Training.
[13] Jin et al. (2024). A Comprehensive Evaluation of Quantization Strategies for Large Language Models. Umfassendes Evaluierungs-Framework zu Fähigkeiten, Alignment und Effizienz.
[14] Lee et al. (2024). Exploring the Trade-Offs: Quantization Methods, Task Difficulty, and Model Size in Large Language Models From Edge to Giant. Groß angelegter Vergleich über Modelle, Quantisierer und Benchmark-Familien hinweg.
[15] Li et al. (2025). Quantization Meets Reasoning: Exploring LLM Low-Bit Quantization Degradation for Mathematical Reasoning. Direkte Belege für nachlassendes Reasoning bei aggressiver Low-Bit-Quantisierung.
[16] Mekala et al. (2025). Does quantization affect models' performance on long-context tasks?. Primäre Referenz zur Verschlechterung bei langen Kontexten durch Quantisierung.
[17] Kharinaev et al. (2025). Investigating the Impact of Quantization Methods on the Safety and Reliability of Large Language Models. Referenz für den Abschnitt zu Sicherheit und Zuverlässigkeit und dafür, warum Verhaltensänderungen direkt gemessen werden sollten.
