

Quantizando LLMs: como funciona e com o que você deve se preocupar
 Toni Lopez Co-Founder at Karumi
1. Introdução à quantização
A quantização torna viável executar grandes modelos de linguagem ao comprimir sua representação numérica, mas cada bit removido gera trade-offs em precisão, robustez e comportamento.
À medida que crescem, os grandes modelos de linguagem não viram apenas um problema de computação: viram um problema de memória. Cada parâmetro precisa ser armazenado em algum lugar, movido pela memória e lido rápido o suficiente para que a inferência continue viável. Quando os modelos passam de bilhões para dezenas ou centenas de bilhões de parâmetros, essa movimentação de pesos se torna um dos principais gargalos.
É o que muitos chamam de muro da memória: o hardware de computação pode continuar evoluindo, mas a capacidade e a largura de banda da memória não crescem no mesmo ritmo. Assim, um modelo pode se tornar difícil de executar não porque a aritmética seja impossível, mas porque seus pesos são caros demais para armazenar e movimentar com eficiência.
Um modelo grande em FP16 ou BF16 pode exigir muito mais memória do que um hardware de consumo consegue oferecer com folga. Um modelo de 70B armazenado com precisão de 16 bits já vai muito além do que a maioria das configurações locais consegue carregar com facilidade, e essa estimativa cobre apenas os pesos estáticos. Na prática, a inferência também precisa de espaço para ativações, buffers temporários e o cache KV [13][16].
Por isso a quantização não é uma otimização de nicho. Sem algum tipo de compressão, muitos modelos úteis continuam dependentes de GPUs caras, implantações em nível de servidor ou estratégias agressivas de offloading. A quantização é a técnica que transforma essa restrição rígida de hardware em um trade-off controlável entre precisão e eficiência [13][14].
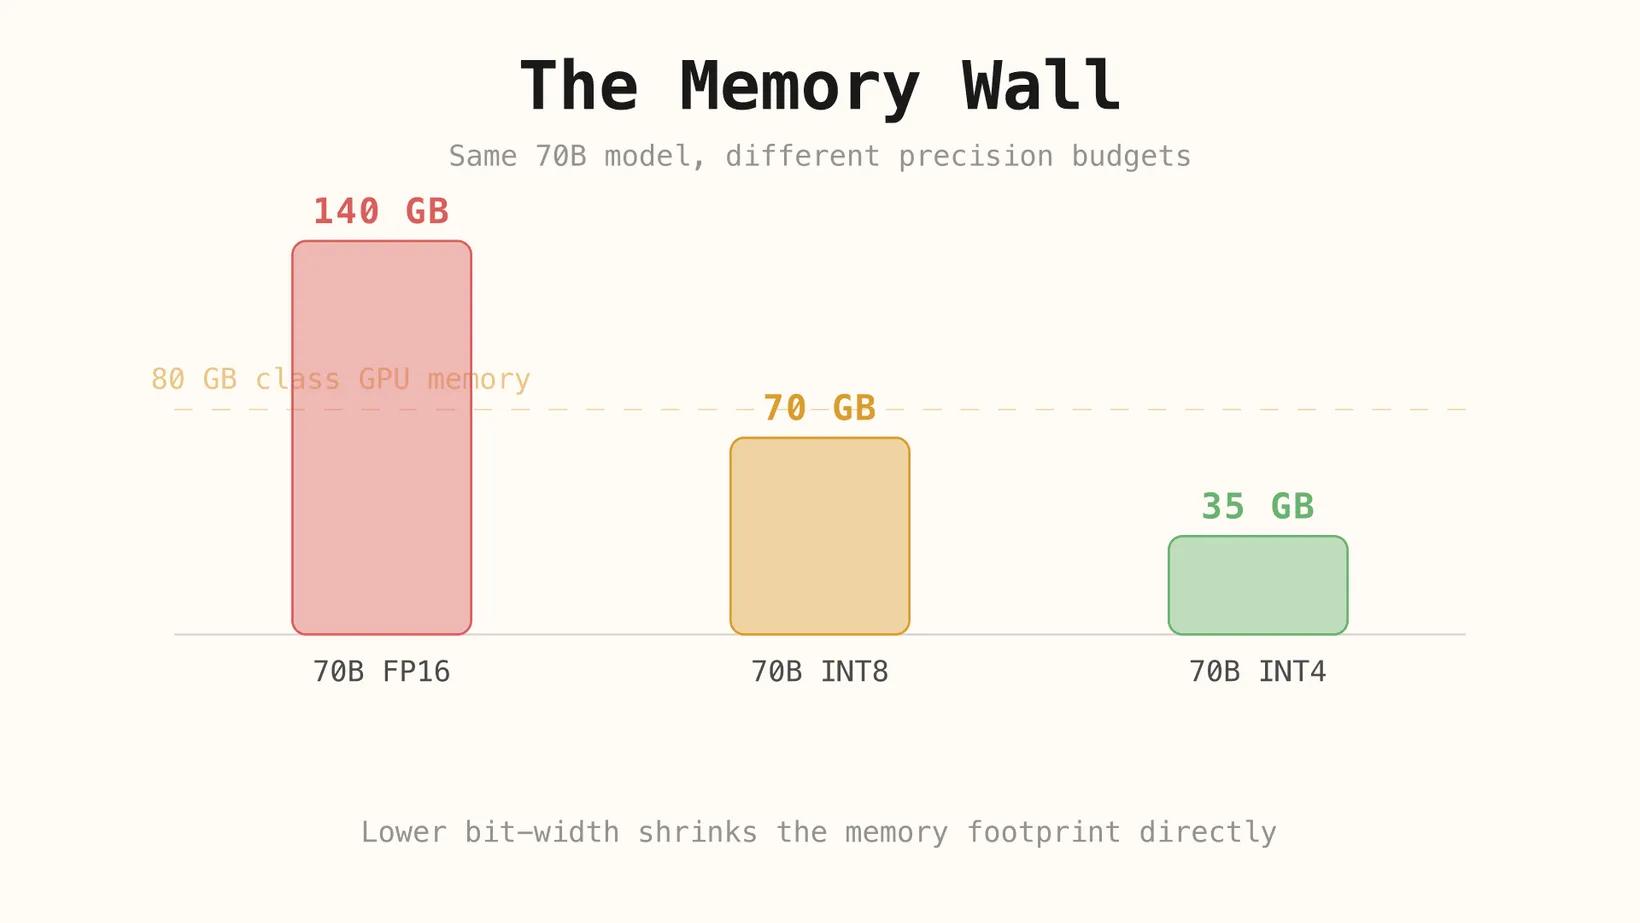
Este artigo acompanha esse trade-off do começo ao fim. Primeiro, explica o que é a quantização como operação matemática. Depois, mostra por que a versão ingênua dessa ideia quebra grandes transformers. Em seguida, mapeia as principais abordagens modernas que tentam controlar o erro resultante e, por fim, analisa as capacidades e os comportamentos que podem se degradar silenciosamente quando a precisão diminui.
2. A intuição básica por trás da quantização
Em essência, quantizar significa substituir um vocabulário numérico rico por um menor. Em vez de permitir que um peso assuma muitos valores de ponto flutuante finamente espaçados, nós o forçamos a ocupar uma grade discreta menor. Quanto mais agressivamente reduzimos o número de níveis disponíveis, menor fica a representação.
Isso traz dois benefícios imediatos. Primeiro, o modelo precisa de menos memória, porque cada peso usa menos bits. Segundo, o hardware tem menos dados para movimentar, o que muitas vezes melhora a velocidade real de inferência. Mas esses ganhos têm um custo real: valores que antes eram distintos podem acabar colapsando na mesma representação de poucos bits.
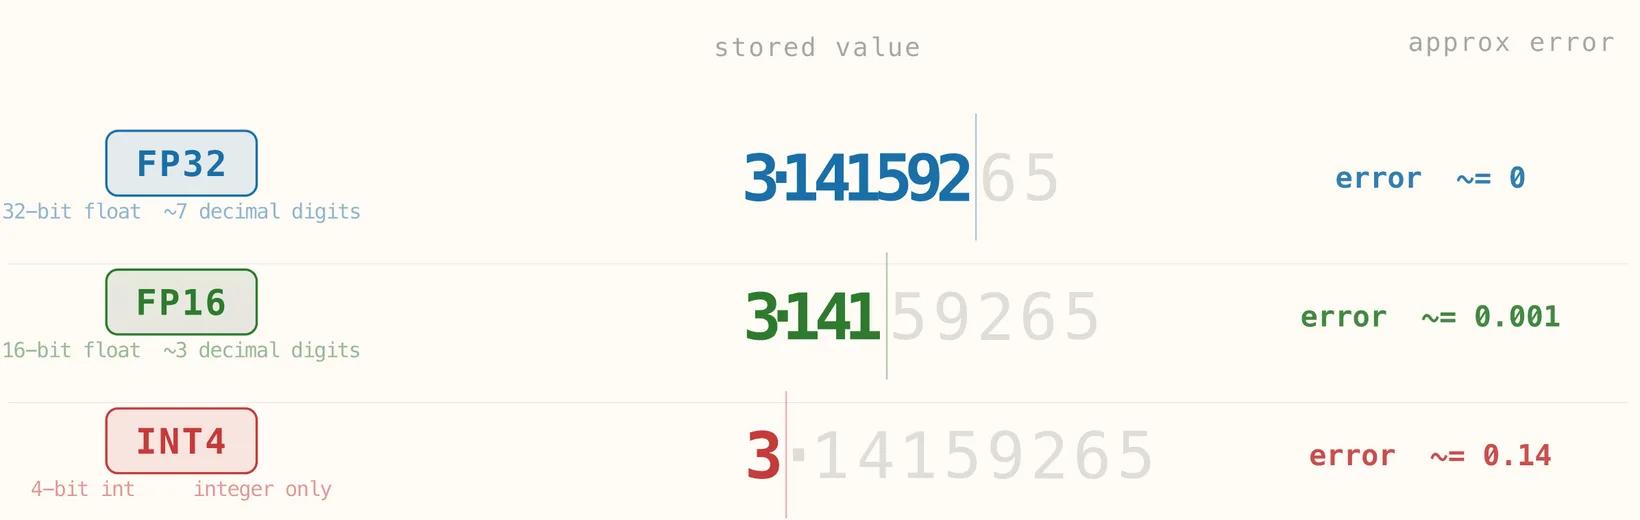
A figura abaixo mostra esse sacrifício com um único valor escrito em diferentes precisões. Em FP32, o número preserva quase todo o seu detalhe decimal, então o erro de aproximação é praticamente desprezível. Em FP16, parte desse detalhe se perde no arredondamento, mas o valor armazenado ainda fica próximo do original. Em INT4, o modelo já não consegue preservar a estrutura decimal fina, então o valor armazenado fica muito mais grosseiro e o erro cresce bastante. A ideia central é simples: quanto menor a precisão, com menos fidelidade o modelo consegue armazenar o número original.
2.1 A fórmula de quantização
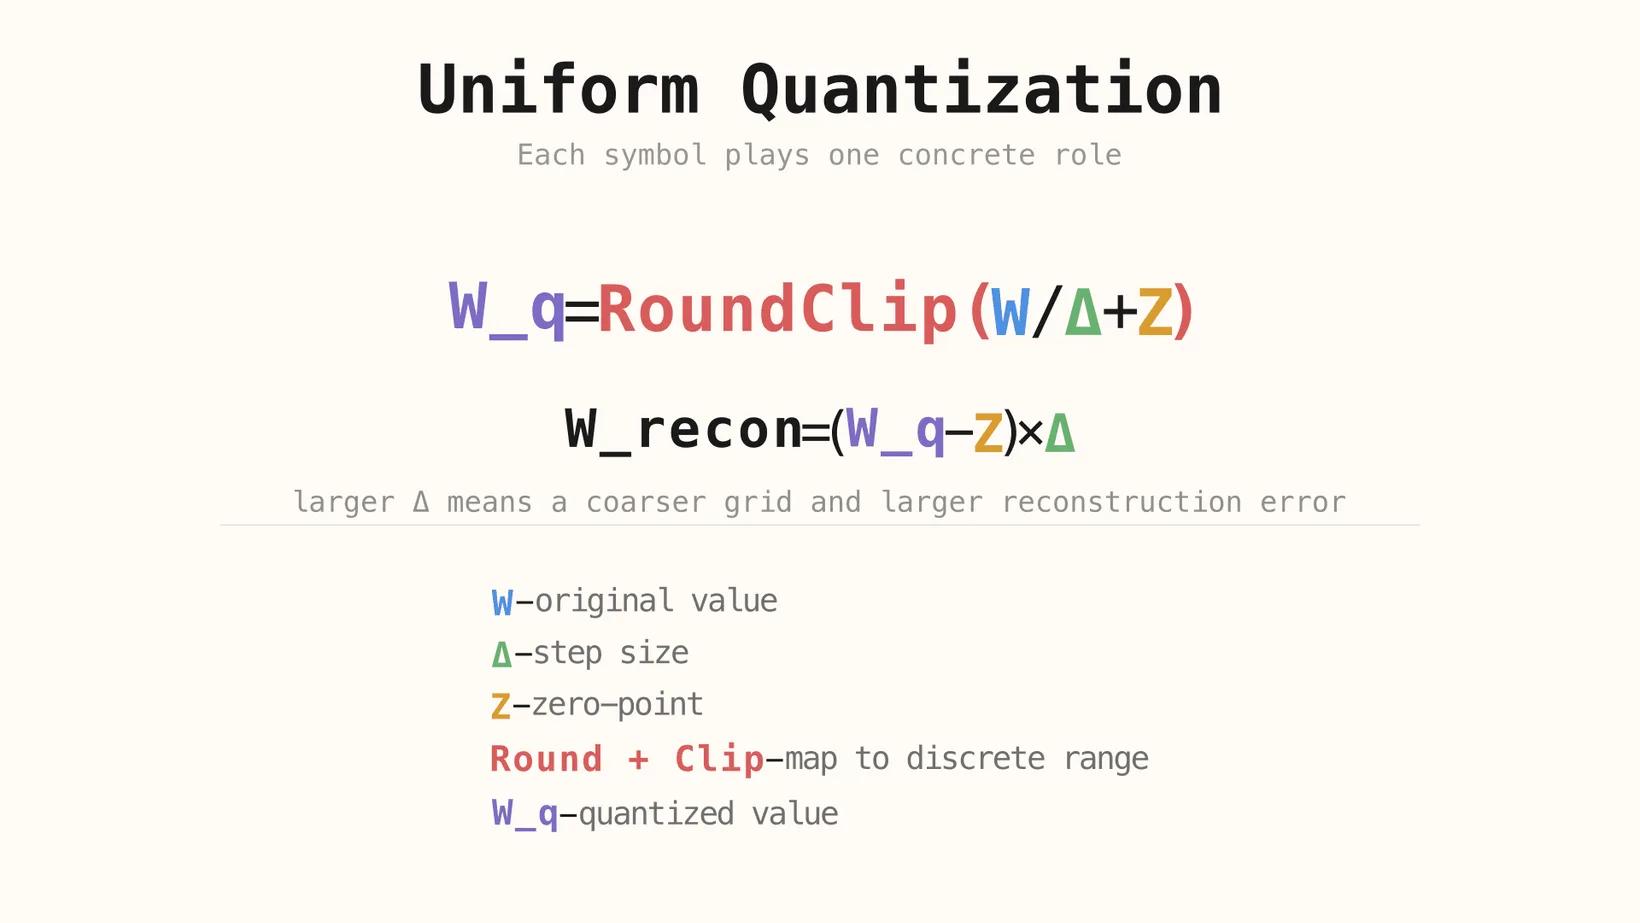
O pipeline de quantização pode ser entendido como uma sequência de operações simples: escalar um valor, deslocá-lo para uma grade discreta, arredondá-lo, limitá-lo ao intervalo permitido e, depois, reconstruí-lo de forma aproximada durante a inferência [1].
O W azul é o valor original de alta precisão. O Δ verde controla o tamanho de cada passo de quantização, ou seja, a resolução da própria grade. O Z âmbar desloca essa grade para que o zero possa ser representado corretamente quando é necessário um mapeamento assimétrico. A etapa vermelha Round + Clip força então o valor para o intervalo discreto de inteiros permitido pela largura de bits alvo, gerando o W_q violeta.
No momento da inferência, o modelo não recupera exatamente o valor original. Ele reconstrói uma aproximação invertendo o mapeamento com a mesma escala e o mesmo deslocamento. Por isso a desquantização não é uma inversa perfeita: depois que vários valores reais próximos colapsam em um único nível discreto, o detalhe perdido não pode ser recuperado.
Uma precisão menor não danifica o modelo de forma aleatória. Ela reduz o número de valores distintos que o modelo consegue representar, o que aumenta o erro de aproximação e torna mais difícil distinguir valores próximos.
O ponto importante é que essa perda é estruturada. Se a grade de quantização é grosseira, as pequenas diferenças entre pesos são as primeiras a desaparecer. Ou seja, o modelo mantém a forma geral de seus parâmetros, mas perde o detalhe numérico fino. Quando isso se repete em muitos tensores e camadas, o erro acumulado se torna o problema central que todo método de quantização tenta administrar [3].
A próxima pergunta é por que esse erro se torna especialmente perigoso em grandes modelos de linguagem, em vez de apenas levemente incômodo.
3. Por que a quantização ingênua falha em LLMs
O exemplo decimal acima é propositalmente simples: mostra o que acontece quando um valor perde precisão. Os grandes modelos de linguagem falham pelo mesmo motivo de fundo, mas em uma escala muito mais difícil. Em vez de um único número ser arredondado, tensores inteiros perdem resolução de uma só vez, e essa perda interage com magnitudes desiguais, valores extremos raros e sensibilidades específicas de cada camada.
Se os pesos de um modelo são apenas números, é tentador achar que quantizar é só uma questão de arredondá-los de forma mais agressiva. Em um pequeno exemplo de brinquedo, essa intuição parece razoável: reduza a representação, aceite algum erro e siga em frente. Mas grandes transformers não são apenas tabelas gigantes de números intercambiáveis. Seu desempenho depende de uma estrutura numérica muito desigual, distribuída entre camadas, canais e tokens.
Por isso, o arredondamento ingênuo não produz uma perda de qualidade suave e uniforme. Ele pode destruir justamente as distinções das quais a rede mais depende. O resultado não é só uma precisão menor, mas às vezes um colapso muito mais abrupto de coerência, perplexidade ou qualidade de raciocínio do que o modelo mental simplista de “menos precisão é igual a um pouco mais de ruído” faria prever.
3.2 Outliers, inflação do passo de quantização e ativações massivas
O principal modo de falha não é o arredondamento em si, mas o que ele provoca quando um tensor contém valores extremos. Se um tensor tem um ou poucos outliers com magnitude muito maior que o restante, a escala de quantização precisa se esticar para incluí-los. Essa escala maior significa que cada passo discreto passa a cobrir um intervalo mais amplo de valores reais.
Quando isso acontece, os valores comuns no centro da distribuição perdem resolução útil. Em vez de serem mapeados para muitos níveis distintos, eles colapsam em um número muito menor de faixas. Na prática, o outlier obriga o tensor inteiro a pagar pelo seu intervalo. É por isso que o Δ verde da fórmula importa tanto: quando Δ fica grande demais, a grade se torna grosseira demais para a maior parte dos dados.
A mesma ideia vai além dos pesos estáticos. Modelos grandes também podem desenvolver ativações massivas, incluindo picos específicos de certos tokens que se comportam como attention sinks. Não são casos extremos inofensivos: eles criam exatamente o tipo de problema de escala desproporcional que a quantização ingênua lida mal [2] [5] [7].
À medida que os modelos crescem, essas patologias se tornam mais estruturais. Grandes transformers desenvolvem canais outliers, picos de ativação no nível do token e comportamentos que tornam a quantização ingênua bem menos confiável. Portanto, o problema não é apenas que “mais parâmetros significam mais erro de arredondamento”. O problema é que modelos maiores desenvolvem uma geometria numérica mais difícil de comprimir com uma única regra global grosseira [2][3].
Quando se entende a quantização ingênua como uma falha de gestão de escala e de controle de erro, os métodos modernos de quantização deixam de parecer siglas arbitrárias e passam a parecer respostas direcionadas.
4. Como a quantização é aplicada hoje na prática
4.1 Quantização pós-treinamento vs. treinamento com consciência de quantização
A quantização moderna normalmente começa com a quantização pós-treinamento (PTQ) ou com o treinamento com consciência de quantização (QAT). A PTQ adapta um modelo depois que o treinamento termina. É barata, prática e, por isso, predominante nos fluxos de inferência com modelos de pesos abertos. O QAT é mais caro porque expõe o modelo à quantização durante o treinamento ou o fine-tuning, mas, em troca, consegue preservar melhor a qualidade quando a precisão alvo fica muito baixa [1][11][12].
Essa primeira divisão importa porque indica que tipo de problema estamos resolvendo. A PTQ pergunta: quanta compressão conseguimos extrair de um modelo existente sem retreiná-lo? O QAT pergunta: o modelo consegue aprender desde o início a operar em um regime quantizado?
4.2 O que os métodos modernos tentam preservar
Métodos diferentes tentam preservar coisas diferentes, porque nem todo erro de quantização é igualmente prejudicial. Alguns métodos tentam proteger os pesos ou canais mais importantes para as ativações. Outros se concentram no escalonamento local, para que uma região problemática de um tensor não arruíne o restante. Outros ainda são otimizados para throughput, metas flexíveis de taxa de bits ou para aproveitar com mais eficiência uma stack de hardware específica [6][4][5].
Por isso, a melhor forma de entender os métodos modernos de quantização é como estratégias de controle de erro. Todos tentam responder à mesma pergunta: que informação é importante demais para ser comprimida de forma ingênua e qual é a maneira mais barata de protegê-la?
4.3 Principais métodos e formatos de implantação na prática
O ecossistema atual não é uma lista aleatória de siglas, mas mistura coisas de naturezas diferentes. AWQ, GPTQ e QAT são métodos de quantização ou abordagens de treinamento. GGUF e EXL2 estão mais próximos de formatos de modelo e ecossistemas de inferência: importam porque empacotam ou operacionalizam modelos quantizados de forma adequada a determinados hardwares e runtimes.
| Nome | Tipo | Ideia principal | Ponto forte | Ideal para |
|---|---|---|---|---|
| GGUF | formato / ecossistema de implantação | formato portátil de modelos quantizados, amplamente usado em stacks de inferência local | portabilidade e padrões práticos | CPUs, Apple Silicon, configurações locais heterogêneas |
| AWQ | método de quantização | proteger durante a quantização os pesos mais relevantes para as ativações | ótima preservação de qualidade com poucos bits | inferência em GPU quando a qualidade importa |
| GPTQ | método de quantização | quantização de pesos pós-treinamento de segunda ordem | inferência rápida com boa compressão | serving em GPU orientado a throughput |
| EXL2 | formato / ecossistema de runtime | formato quantizado com taxa de bits mista, ajustado para inferência no estilo ExLlama | trade-off flexível entre memória e velocidade | configurações ExLlama com várias GPUs ou VRAM limitada |
| QAT | abordagem de treinamento | treinar ou fazer fine-tuning com a quantização incluída no ciclo | maior robustez em precisão muito baixa | casos em que o custo de retreinar é aceitável |
O objetivo desta tabela não é decorar nomes. É perceber que cada linha resolve uma camada ligeiramente diferente do problema: algumas descrevem como os pesos são quantizados, enquanto outras descrevem como os modelos quantizados são empacotados e executados. A tabela condensa ideias da especificação GGUF, de AWQ, GPTQ, ExLlamaV2 / EXL2 e de trabalhos recentes de QAT voltados a LLMs, como LLM-QAT e EfficientQAT [9][6][4][10][11][12].
4.4 Quando esses métodos e formatos fazem sentido
Com os trade-offs claros, fica mais fácil entender o cenário. GGUF é a escolha natural quando você quer ampla portabilidade local e um formato que funcione bem em CPUs e Apple Silicon [9]. AWQ e GPTQ fazem mais sentido quando a prioridade é a inferência em GPU, mas otimizam lados diferentes do trade-off: AWQ costuma ser preferido quando preservar a qualidade importa mais, enquanto GPTQ é frequentemente escolhido quando o throughput é central [6][4].
EXL2 faz sentido quando caber na memória é, por si só, o principal problema de otimização e você quer um controle mais fino da taxa de bits dentro de uma stack de inferência específica [10]. O QAT pertence a outra categoria: não é um formato de serving, mas uma estratégia aplicada no treinamento, que se torna atraente quando uma implantação agressiva com poucos bits é importante o bastante para justificar retreinar ou fazer fine-tuning do modelo para que ele resista ao ruído de quantização [11][12].
Mas escolher um método é só metade da história. A pergunta mais difícil é quais capacidades e comportamentos ficam menos estáveis depois que essa compressão é aplicada.
5. Os custos ocultos da quantização
5.1 Degradação de capacidades: raciocínio, contexto e confiabilidade multimodal
Avaliações recentes sugerem que reduzir a precisão pode degradar a qualidade do raciocínio e o comportamento em contextos longos, e o mesmo problema de robustez com poucos bits também pode afetar sistemas multimodais. Essas degradações costumam ser desiguais: algumas tarefas permanecem estáveis, enquanto outras pioram bastante. Um modelo pode manter a fluência e ainda assim perder confiabilidade em matemática de várias etapas, cadeias longas de inferência ou tarefas que dependem de pequenas distinções internas preservadas ao longo de muitas camadas [15][16][12].
Essa desigualdade é um dos motivos pelos quais a quantização pode enganar quando é avaliada apenas com uma pequena amostra de benchmarks. Um modelo que parece quase inalterado em prompts curtos pode, ainda assim, perder qualidade em contextos mais longos, tarefas de raciocínio mais difíceis ou entradas multimodais em que o erro se acumula com mais intensidade [13][14][16].
5.2 Falhas silenciosas em agentes e no comportamento real
Avaliações recentes também sugerem que modelos quantizados podem falhar de maneiras mais discretas. O uso de ferramentas, o planejamento em várias etapas e os fluxos de trabalho agênticos podem ficar mais frágeis mesmo quando o modelo ainda parece fluente na superfície. É um perfil perigoso, porque gera modelos que soam competentes enquanto ficam menos confiáveis justamente nos momentos em que sistemas externos, ferramentas ou consequências tardias importam [14][17].
Na prática, isso significa que a quantização deve ser avaliada não apenas como um problema de geração de texto, mas como um problema de comportamento do sistema. Se um modelo faz parte de um loop de agente, de uma stack de recuperação ou de um fluxo de chamada de ferramentas, uma pequena perda de confiabilidade no nível do token pode se transformar em uma falha operacional muito maior.
5.3 Distorções de segurança, viés e alinhamento
Avaliações recentes sugerem que a compressão também pode alterar propriedades de segurança e de comportamento. A quantização não torna um modelo automaticamente inseguro ou enviesado, mas pode distorcer os mecanismos que sustentam o alinhamento, as proteções e a estabilidade do comportamento. Se alguns comportamentos já são numericamente frágeis, a compressão com poucos bits pode deslocá-los o suficiente para mudar o comportamento de recusa, as tendências de toxicidade ou a robustez contra prompts adversariais [13][17].
A postura correta não é nem negação nem pânico. A quantização deve ser tratada como uma intervenção que muda o comportamento e cujos efeitos precisam ser medidos diretamente. Não basta perguntar se o modelo ficou menor e mais rápido; também é preciso perguntar quais propriedades ficaram menos estáveis quando a resolução foi removida.
6. Conclusão: quantização
A quantização torna os modelos grandes mais baratos de armazenar, mais fáceis de movimentar e mais práticos de implantar. É um dos principais motivos pelos quais modelos avançados conseguem rodar fora de infraestruturas especializadas. Nesse sentido, a quantização é uma das tecnologias-chave por trás da ampla acessibilidade dos LLMs modernos: sem ela, muitos modelos continuariam presos a orçamentos de hardware que apenas poucos usuários ou organizações conseguiriam bancar.
A mesma compressão que torna a implantação viável também pode retirar resolução útil da computação interna do modelo. Essa perda pode aparecer como raciocínio degradado, instabilidade silenciosa ou mudança de comportamento. A lição importante é que a quantização nunca é “de graça”. Mesmo quando claramente vale a pena, ela muda o regime numérico em que o modelo pensa.
6.1 Para onde a pesquisa está indo
A pesquisa atual avança em direção a métodos de poucos bits mais inteligentes, melhor proteção de ativações sensíveis, formatos pensados para o hardware e uma avaliação mais refinada do que a compressão muda além da precisão em benchmarks. A direção geral é clara: o trabalho futuro não se resume a fazer os modelos caberem em menos bits, mas a aprender quais partes de um modelo podem ser comprimidas de forma agressiva e quais precisam continuar numericamente protegidas [6][12][17].
Por isso, a quantização deve ser entendida como uma camada central de design, e não como um truque final de armazenamento. Ela fica entre a qualidade do modelo, o custo de implantação e a confiabilidade do comportamento, e os melhores métodos modernos são todos tentativas de equilibrar essas três pressões de forma mais inteligente.
Referências
[1] Jacob et al. (2018). Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. Referência fundamental sobre quantização com escala / ponto zero e treinamento com consciência de quantização.
[2] Dettmers et al. (2022). LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. Referência central sobre outliers em transformers e por que a compressão ingênua com poucos bits falha de forma diferente em escala.
[3] Gong et al. (2024). What Makes Quantization for Large Language Models Hard? An Empirical Study from the Lens of Perturbation. Referência útil para entender o erro de quantização como uma perturbação estruturada, e não como ruído genérico.
[4] Frantar et al. (2022). GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. Fonte primária sobre quantização pós-treinamento de segunda ordem em modelos no estilo GPT.
[5] Xiao et al. (2023). SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models. Referência-chave sobre o tratamento de outliers de ativação na quantização de pesos e ativações.
[6] Lin et al. (2023). AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration. Fonte primária sobre a proteção de pesos relevantes para as ativações na quantização de LLMs com poucos bits.
[7] Lee et al. (2023). OWQ: Outlier-Aware Weight Quantization for Efficient Fine-Tuning and Inference of Large Language Models. Referência útil sobre quantização com poucos bits sensível a outliers e fine-tuning.
[8] Dettmers et al. (2023). QLoRA: Efficient Finetuning of Quantized LLMs. Referência importante sobre fine-tuning quantizado em 4 bits e fluxos de treinamento baseados em NF4.
[9] ggml / llama.cpp. GGUF format specification. Especificação oficial do formato de arquivo GGUF discutido na seção de métodos voltados à implantação.
[10] turboderp-org. ExLlamaV2 README and EXL2 quantization notes. Principal referência de implementação para o fluxo local em GPU com taxa de bits mista do EXL2.
[11] Liu et al. (2023). LLM-QAT: Data-Free Quantization Aware Training for Large Language Models. Uma das primeiras referências de QAT específicas para LLMs, especialmente relevante abaixo de 8 bits.
[12] Chen et al. (2024). EfficientQAT: Efficient Quantization-Aware Training for Large Language Models. Trabalho mais recente de QAT para LLMs, focado na eficiência prática do treinamento com poucos bits.
[13] Jin et al. (2024). A Comprehensive Evaluation of Quantization Strategies for Large Language Models. Amplo framework de avaliação que abrange capacidades, alinhamento e eficiência.
[14] Lee et al. (2024). Exploring the Trade-Offs: Quantization Methods, Task Difficulty, and Model Size in Large Language Models From Edge to Giant. Comparação em larga escala entre modelos, quantizadores e famílias de benchmarks.
[15] Li et al. (2025). Quantization Meets Reasoning: Exploring LLM Low-Bit Quantization Degradation for Mathematical Reasoning. Evidência direta de degradação do raciocínio sob quantização agressiva com poucos bits.
[16] Mekala et al. (2025). Does quantization affect models' performance on long-context tasks?. Principal referência sobre degradação em contextos longos sob quantização.
[17] Kharinaev et al. (2025). Investigating the Impact of Quantization Methods on the Safety and Reliability of Large Language Models. Referência para a seção de segurança e confiabilidade e para entender por que mudanças de comportamento devem ser medidas diretamente.
