

LLM'leri nicemlemek: Nasıl çalışır ve nelere dikkat etmelisiniz?
 Toni Lopez Co-Founder at Karumi
1. Nicemlemeye giriş
Nicemleme (quantization), sayısal gösterimlerini sıkıştırarak büyük dil modellerini pratikte çalıştırılabilir hâle getirir; ancak çıkarılan her bit doğruluk, sağlamlık ve davranış açısından ödünleşimler doğurur.
Büyük dil modelleri büyüdükçe yalnızca bir hesaplama sorununa değil, bir bellek sorununa da dönüşür. Her parametrenin bir yerde saklanması, bellek üzerinden taşınması ve çıkarımın pratik kalabilmesi için yeterince hızlı okunması gerekir. Modeller milyarlarca parametreden onlarca, hatta yüzlerce milyara çıktıkça ağırlıkların bu şekilde taşınması en büyük darboğazlardan biri hâline gelir.
Buna sıklıkla bellek duvarı denir: Hesaplama donanımı gelişmeye devam edebilir, ancak bellek kapasitesi ve bant genişliği aynı hızda ölçeklenmez. Dolayısıyla bir modelin çalıştırılması, aritmetik imkânsız olduğu için değil, ağırlıklarını verimli şekilde tutmak ve taşımak çok pahalı olduğu için zorlaşabilir.
FP16 veya BF16 formatındaki büyük bir model, tüketici donanımının rahatça sağlayabileceğinden çok daha fazla bellek gerektirebilir. 16 bit hassasiyetle saklanan 70B'lik bir model, çoğu yerel kurulumun kolayca yükleyebileceği sınırın zaten çok ötesindedir ve bu tahmin yalnızca statik ağırlıkları kapsar. Pratikte çıkarım; aktivasyonlar, geçici tamponlar ve KV önbelleği için de yer gerektirir [13][16].
Bu yüzden nicemleme niş bir optimizasyon değildir. Bir tür sıkıştırma olmadan pek çok faydalı model pahalı GPU'lara, sunucu sınıfı dağıtımlara veya agresif offloading stratejilerine mahkûm kalır. Nicemleme, bu katı donanım kısıtını doğruluk ile verimlilik arasında kontrol edilebilir bir ödünleşime dönüştüren tekniktir [13][14].
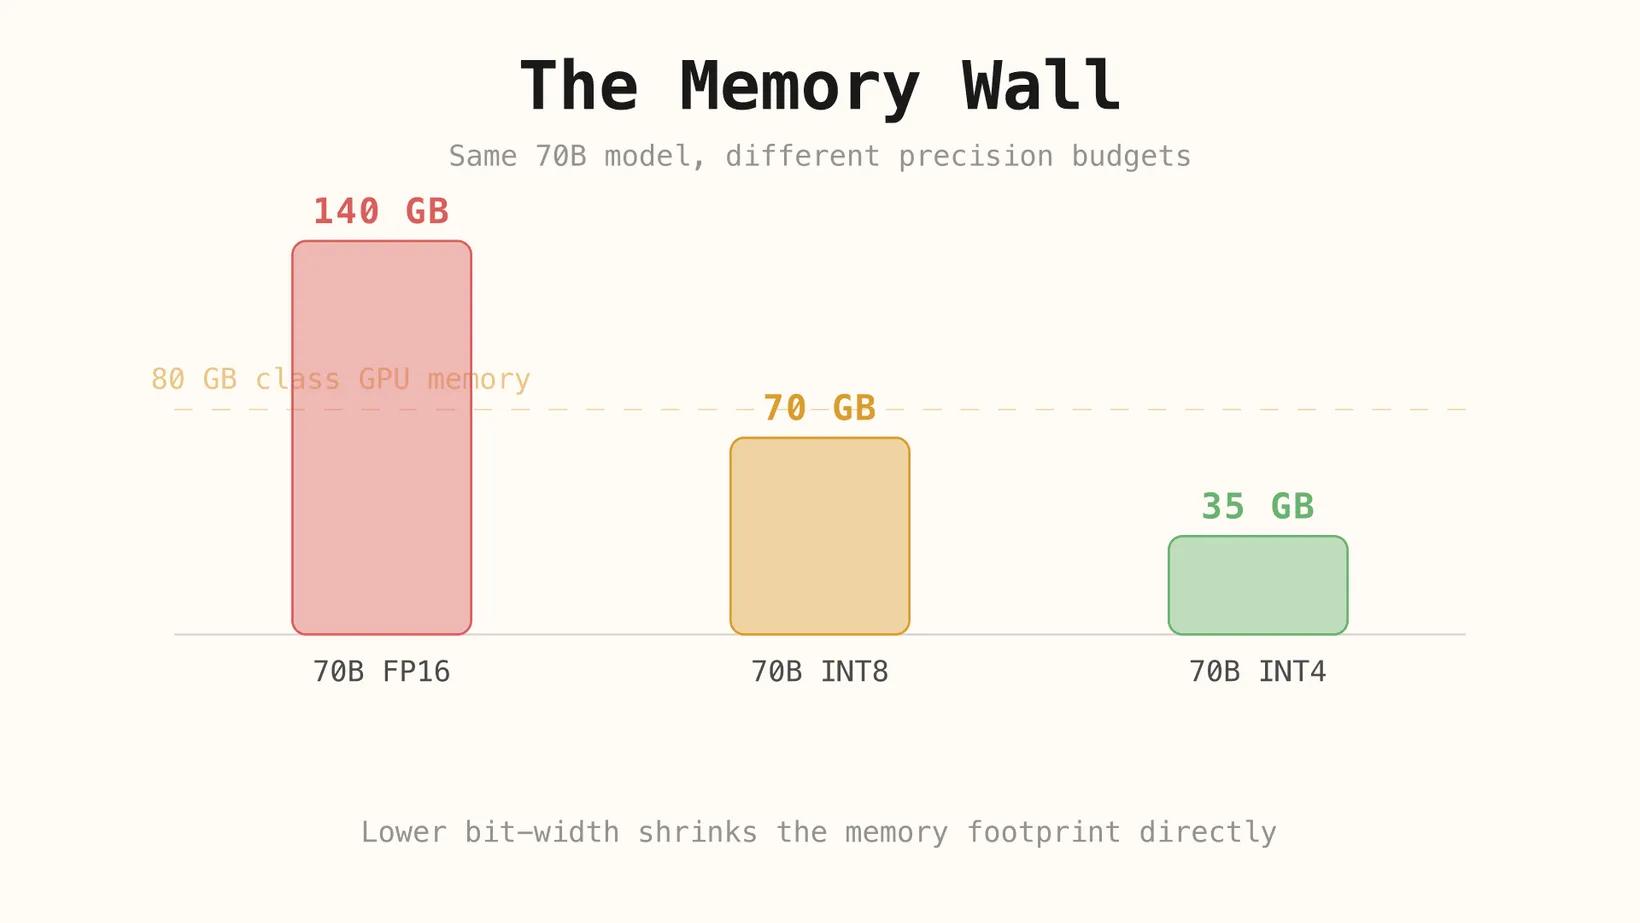
Bu yazı, söz konusu ödünleşimi baştan sona ele alıyor. Önce nicemlemenin matematiksel bir işlem olarak ne olduğunu açıklıyor. Ardından bu fikrin basit (naif) uygulamasının büyük transformer'ları neden bozduğunu gösteriyor. Sonrasında ortaya çıkan hatayı kontrol etmeye çalışan başlıca modern yaklaşımları haritalandırıyor ve son olarak hassasiyet düştüğünde sessizce gerileyebilecek yetenek ve davranışları inceliyor.
2. Nicemlemenin temel mantığı
Özünde nicemleme, zengin bir sayısal kelime dağarcığını daha küçük bir dağarcıkla değiştirmek demektir. Bir ağırlığın birbirine çok yakın pek çok kayan noktalı değer almasına izin vermek yerine, onu daha küçük ve ayrık bir ızgaraya yerleşmeye zorlarız. Kullanılabilir seviye sayısını ne kadar agresif azaltırsak gösterim o kadar küçülür.
Bu bize iki anında fayda sağlar. Birincisi, her ağırlık daha az bit kullandığı için model daha az bellek gerektirir. İkincisi, donanımın taşıması gereken veri azalır ve bu da çoğu zaman pratikteki çıkarım hızını artırır. Ancak bu kazanımların gerçek bir bedeli vardır: Eskiden birbirinden farklı olan değerler artık aynı düşük bitli gösterime çökebilir.
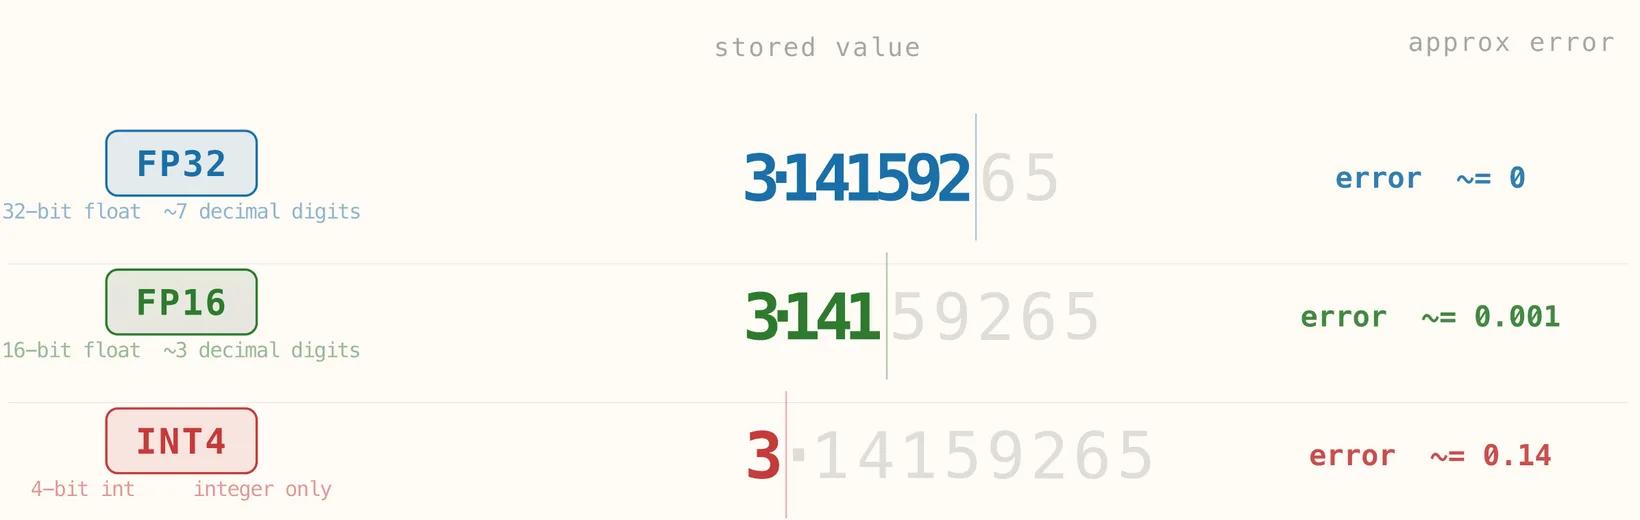
Aşağıdaki şekil, bu bedeli farklı hassasiyetlerde yazılmış tek bir değer üzerinden gösteriyor. FP32'de sayı ondalık ayrıntılarının neredeyse tamamını korur; bu nedenle yaklaşım hatası fiilen ihmal edilebilir düzeydedir. FP16'da bu ayrıntının bir kısmı yuvarlanarak kaybolur, ancak saklanan değer hâlâ orijinale yakındır. INT4'te ise model ince ondalık yapıyı artık hiç koruyamaz; saklanan değer çok daha kaba hâle gelir ve hata keskin biçimde büyür. Temel fikir basit: Hassasiyet ne kadar düşükse model orijinal sayıyı o kadar az sadakatle saklayabilir.
2.1 Nicemleme formülü
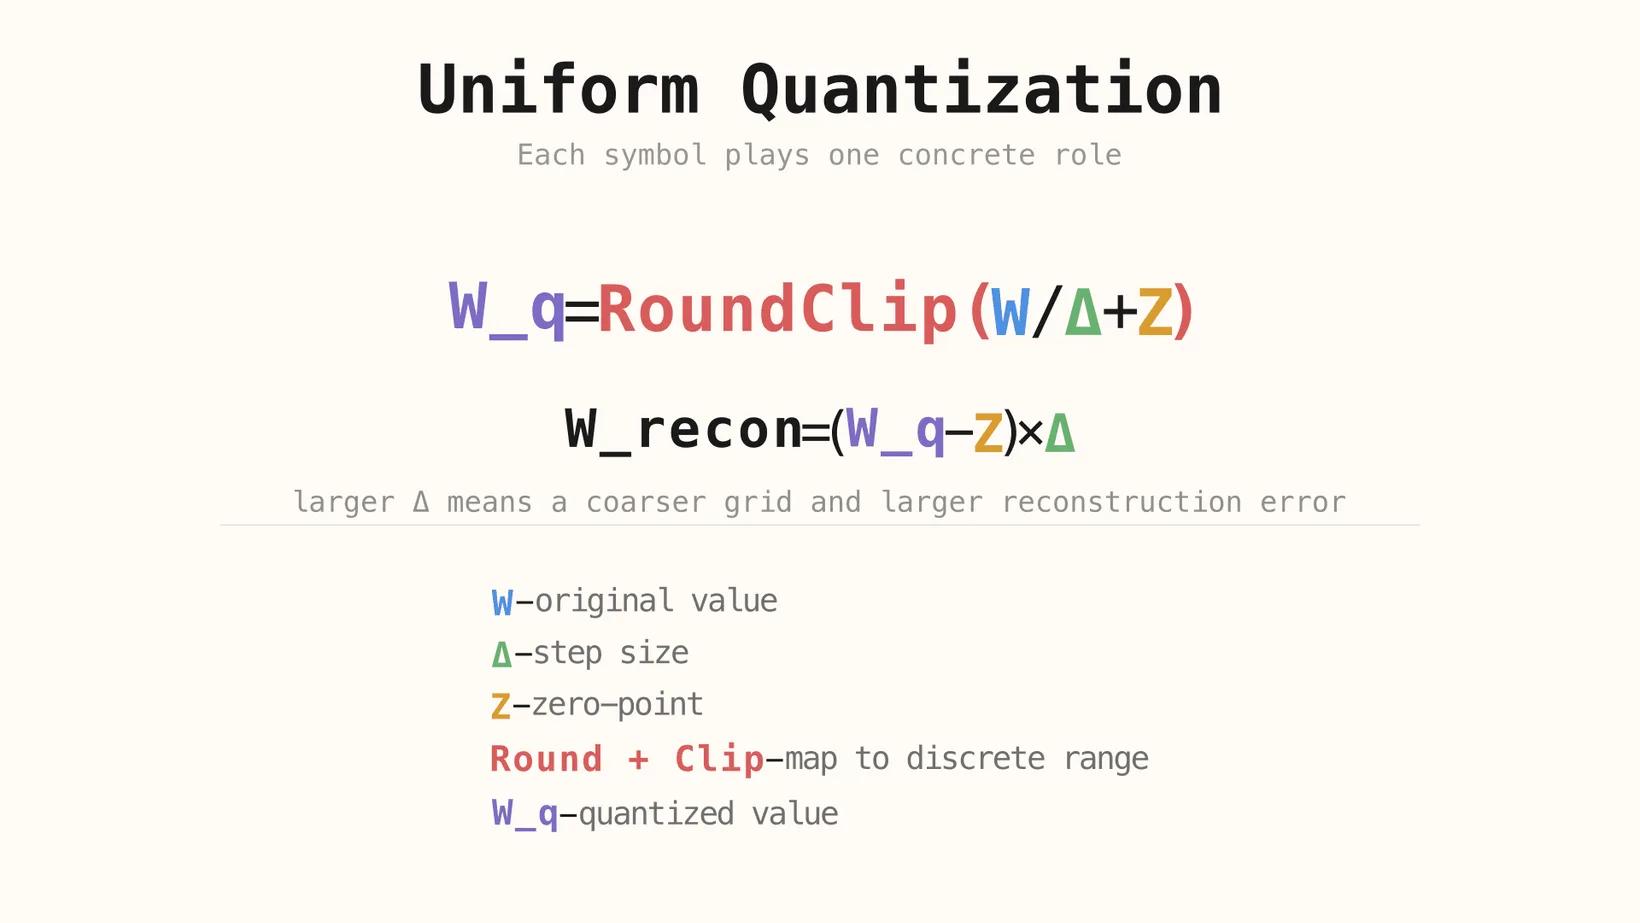
Nicemleme süreci basit işlemlerden oluşan bir dizi olarak düşünülebilir: Bir değeri ölçekle, ayrık bir ızgaraya kaydır, yuvarla, izin verilen aralığa kırp ve ardından çıkarım sırasında yaklaşık olarak yeniden oluştur [1].
Mavi W, orijinal yüksek hassasiyetli değerdir. Yeşil Δ, her nicemleme adımının boyutunu, yani ızgaranın çözünürlüğünü belirler. Kehribar rengi Z, asimetrik bir eşleme gerektiğinde sıfırın doğru temsil edilebilmesi için ızgarayı kaydırır. Ardından kırmızı Round + Clip aşaması, değeri hedef bit genişliğinin izin verdiği ayrık tam sayı aralığına zorlar ve mor W_q değerini üretir.
Çıkarım sırasında model orijinal değeri birebir geri elde etmez. Aynı ölçek ve kaydırma değeriyle eşlemeyi tersine çevirerek bir yaklaşık değer yeniden oluşturur. Bu yüzden ters nicemleme (dequantization) kusursuz bir tersine çevirme değildir: Birbirine yakın birkaç gerçek değer tek bir ayrık seviyeye çöktükten sonra kaybolan ayrıntı geri kazanılamaz.
Düşük hassasiyet modele rastgele zarar vermez. Modelin temsil edebileceği farklı değer sayısını azaltır; bu da yaklaşım hatasını artırır ve birbirine yakın değerleri ayırt etmeyi zorlaştırır.
Önemli olan, bu kaybın yapısal olmasıdır. Nicemleme ızgarası kaba ise ağırlıklar arasındaki küçük farklar ilk önce kaybolur. Yani model parametrelerinin genel şeklini korur, ancak ince sayısal ayrıntıları kaybeder. Bu durum pek çok tensör ve katmanda tekrarlandığında biriken hata, her nicemleme yönteminin yönetmeye çalıştığı temel sorun hâline gelir [3].
Sıradaki soru, bu hatanın büyük dil modellerinde neden yalnızca biraz can sıkıcı olmakla kalmayıp özellikle tehlikeli hâle geldiğidir.
3. Basit nicemleme LLM'lerde neden başarısız olur?
Yukarıdaki ondalık örnek bilinçli olarak basit tutuldu: Tek bir değer hassasiyet kaybettiğinde ne olduğunu gösteriyor. Büyük dil modelleri de aynı temel nedenle başarısız olur, ancak çok daha zorlu bir ölçekte. Tek bir sayının yuvarlanması yerine tüm tensörler aynı anda çözünürlük kaybeder ve bu kayıp; dengesiz büyüklükler, nadir uç değerler ve katmana özgü hassasiyetlerle etkileşime girer.
Model ağırlıkları yalnızca sayılardan ibaretse nicemlemenin sadece onları daha agresif yuvarlamak olduğunu düşünmek cazip gelir. Küçük bir oyuncak örnekte bu sezgi makul görünür: Gösterimi küçült, biraz hatayı kabul et ve devam et. Ancak büyük transformer'lar birbirinin yerine geçebilen sayılardan oluşan dev tablolardan ibaret değildir. Performansları katmanlara, kanallara ve token'lara yayılmış son derece dengesiz bir sayısal yapıya bağlıdır.
Bu nedenle basit yuvarlama, kalitede yumuşak ve eşit bir kayba yol açmaz. Ağın en çok dayandığı ayrımları tam da yok edebilir. Sonuç yalnızca daha düşük doğruluk değil, bazen tutarlılık, perplexity veya akıl yürütme kalitesinde “daha az hassasiyet, biraz daha fazla gürültü demektir” şeklindeki basit zihinsel modelin öngöreceğinden çok daha ani bir çöküştür.
3.2 Aykırı değerler, adım boyutu şişmesi ve devasa aktivasyonlar
Asıl başarısızlık nedeni yuvarlamanın kendisi değil, bir tensör uç değerler içerdiğinde yuvarlamanın yol açtığı durumdur. Bir tensörde geri kalanından çok daha büyük bir veya birkaç aykırı değer varsa nicemleme ölçeği bunları kapsayacak şekilde genişlemek zorunda kalır. Daha büyük bir ölçek, her ayrık adımın artık daha geniş bir gerçek değer aralığını kapsaması anlamına gelir.
Bu olduğunda, dağılımın ortasındaki sıradan değerler kullanışlı çözünürlüklerini kaybeder. Birçok farklı seviyeye eşlenmek yerine çok daha az sayıda kovaya çökerler. Başka bir deyişle, aykırı değer kendi aralığının bedelini tüm tensöre ödetir. Formüldeki yeşil Δ bu yüzden bu kadar önemlidir: Δ fazla büyüdüğünde ızgara, verilerin büyük kısmı için fazla kaba hâle gelir.
Aynı fikir statik ağırlıkların ötesine de uzanır. Büyük modeller, attention sink gibi davranan token'a özgü sıçramalar da dahil olmak üzere devasa aktivasyonlar geliştirebilir. Bunlar zararsız uç durumlar değildir. Basit nicemlemenin kötü yönettiği türden orantısız ölçek sorunlarını tam olarak bunlar yaratır [2] [5] [7].
Modeller büyüdükçe bu patolojiler daha yapısal hâle gelir. Büyük transformer'lar aykırı kanallar, token düzeyinde aktivasyon sıçramaları ve basit nicemlemeyi çok daha az güvenilir kılan davranışlar geliştirir. Dolayısıyla sorun yalnızca “daha fazla parametre, daha fazla yuvarlama hatası demektir” değildir. Sorun, daha büyük modellerin tek bir kaba küresel kuralla sıkıştırılması daha zor bir sayısal geometri geliştirmesidir [2][3].
Basit nicemleme, ölçek yönetimi ve hata kontrolünde bir başarısızlık olarak anlaşıldığında, modern nicemleme yöntemleri keyfi kısaltmalar gibi görünmekten çıkar ve hedefli çözümler olarak görünmeye başlar.
4. Nicemleme bugün pratikte nasıl uygulanıyor?
4.1 Eğitim sonrası nicemleme ve nicemleme farkındalıklı eğitim
Modern nicemleme genellikle ya eğitim sonrası nicemleme (PTQ) ya da nicemleme farkındalıklı eğitim (QAT) ile başlar. PTQ, eğitim tamamlandıktan sonra modeli uyarlar. Ucuz ve pratiktir; bu nedenle açık ağırlıklı modellerle yapılan çıkarım iş akışlarında baskındır. QAT daha maliyetlidir, çünkü modeli eğitim veya fine-tuning sırasında nicemlemeye maruz bırakır; buna karşılık hedef hassasiyet çok düşük olduğunda kaliteyi daha iyi koruyabilir [1][11][12].
Bu ilk ayrım önemlidir, çünkü hangi tür sorunu çözdüğümüzü gösterir. PTQ şunu sorar: Mevcut bir modelden, yeniden eğitmeden ne kadar sıkıştırma elde edebiliriz? QAT ise şunu sorar: Model, en başından nicemlenmiş bir rejimde çalışmayı öğrenebilir mi?
4.2 Modern yöntemler neyi korumaya çalışır?
Farklı yöntemler farklı şeyleri korumaya çalışır, çünkü tüm nicemleme hataları aynı derecede zararlı değildir. Bazı yöntemler aktivasyonlar için en önemli ağırlıkları veya kanalları korumaya çalışır. Bazıları, bir tensörün sorunlu bir bölgesinin geri kalanını mahvetmemesi için yerel ölçeklemeye odaklanır. Diğerleri ise verim, esnek bit hızı hedefleri veya belirli bir donanım yığınından daha verimli yararlanma üzerine optimize edilmiştir [6][4][5].
Bu yüzden modern nicemleme yöntemlerini en iyi hata kontrol stratejileri olarak anlamak gerekir. Hepsi aynı soruyu yanıtlamaya çalışır: Hangi bilgi basitçe sıkıştırılamayacak kadar önemlidir ve onu korumanın en ucuz yolu nedir?
4.3 Pratikte başlıca yöntemler ve dağıtım formatları
Bugünkü ekosistem rastgele bir kısaltma listesi değildir, ancak farklı türden şeyleri bir araya getirir. AWQ, GPTQ ve QAT nicemleme yöntemleri veya eğitim yaklaşımlarıdır. GGUF ve EXL2 ise daha çok model formatlarına ve çıkarım ekosistemlerine yakındır: Nicemlenmiş modelleri belirli donanımlara ve çalışma ortamlarına uygun biçimde paketledikleri veya işler hâle getirdikleri için önemlidirler.
| Ad | Tür | Ana fikir | Güçlü yanı | En uygun olduğu durum |
|---|---|---|---|---|
| GGUF | format / dağıtım ekosistemi | yerel çıkarım yığınlarında yaygın olarak kullanılan taşınabilir nicemlenmiş model formatı | taşınabilirlik ve pratik varsayılan ayarlar | CPU'lar, Apple Silicon, heterojen yerel kurulumlar |
| AWQ | nicemleme yöntemi | nicemleme sırasında aktivasyon açısından önemli ağırlıkları korur | düşük bit genişliğinde güçlü kalite koruma | kalitenin önemli olduğu GPU çıkarımı |
| GPTQ | nicemleme yöntemi | ikinci dereceden eğitim sonrası ağırlık nicemleme | iyi sıkıştırmayla hızlı çıkarım | verim odaklı GPU sunumu |
| EXL2 | format / çalışma zamanı ekosistemi | ExLlama tarzı çıkarıma göre ayarlanmış karma bit hızlı nicemlenmiş format | esnek bellek / hız ödünleşimi | çoklu GPU'lu veya VRAM kısıtlı ExLlama kurulumları |
| QAT | eğitim yaklaşımı | nicemlemeyi döngüye dahil ederek eğitme veya fine-tuning | çok düşük hassasiyette en yüksek sağlamlık | yeniden eğitim maliyetinin kabul edilebilir olduğu durumlar |
Bu tablonun amacı isimleri ezberlemek değildir. Amaç, her satırın sorunun biraz farklı bir katmanını çözdüğünü fark etmektir: Bazı satırlar ağırlıkların nasıl nicemlendiğini, diğerleri ise nicemlenmiş modellerin nasıl paketlendiğini ve çalıştırıldığını anlatır. Tablo; GGUF spesifikasyonu, AWQ, GPTQ, ExLlamaV2 / EXL2 ile LLM-QAT ve EfficientQAT gibi LLM odaklı yeni QAT çalışmalarından alınan fikirleri özetler [9][6][4][10][11][12].
4.4 Bu yöntemler ve formatlar ne zaman mantıklıdır?
Ödünleşimler netleştiğinde tabloyu değerlendirmek kolaylaşır. Geniş yerel taşınabilirlik ve CPU'lar ile Apple Silicon üzerinde iyi çalışan bir format istiyorsanız GGUF doğal tercihtir [9]. GPU çıkarımı öncelikliyse AWQ ve GPTQ daha doğal seçeneklerdir, ancak ödünleşimin farklı taraflarını optimize ederler: Kaliteyi korumak daha önemliyse genellikle AWQ tercih edilirken, verim ön plandaysa çoğunlukla GPTQ seçilir [6][4].
Modeli belleğe sığdırmak başlı başına ana optimizasyon sorunuysa ve belirli bir çıkarım yığını içinde bit hızı üzerinde daha ince kontrol istiyorsanız EXL2 mantıklıdır [10]. QAT ise tamamen farklı bir kategoriye aittir: Bir sunum formatı değil, eğitim zamanında uygulanan bir stratejidir. Agresif düşük bitli dağıtım, modelin nicemleme gürültüsüne dayanabilmesi için yeniden eğitilmesini veya fine-tuning yapılmasını haklı çıkaracak kadar önemli olduğunda cazip hâle gelir [11][12].
Ancak bir yöntem seçmek hikâyenin yalnızca yarısıdır. Daha zor soru, bu sıkıştırma uygulandıktan sonra hangi yetenek ve davranışların daha az kararlı hâle geldiğidir.
5. Nicemlemenin gizli maliyetleri
5.1 Yeteneklerde gerileme: akıl yürütme, bağlam ve çok modlu güvenilirlik
Son değerlendirmeler, hassasiyeti düşürmenin akıl yürütme kalitesini ve uzun bağlam davranışını bozabileceğini, aynı düşük bit sağlamlığı sorununun çok modlu sistemler için de önemli olabileceğini gösteriyor. Bu gerilemeler çoğu zaman dengesizdir: Bazı görevler kararlı kalırken diğerleri keskin biçimde kötüleşir. Bir model akıcılığını koruyup yine de çok adımlı matematikte, uzun çıkarım zincirlerinde veya küçük iç ayrımların pek çok katman boyunca korunmasına bağlı görevlerde güvenilirliğini kaybedebilir [15][16][12].
Bu dengesizlik, nicemlemenin yalnızca küçük bir benchmark kesitiyle değerlendirildiğinde yanıltıcı olabilmesinin nedenlerinden biridir. Kısa prompt'larda neredeyse hiç değişmemiş gibi görünen bir model; daha uzun bağlamlarda, daha zor akıl yürütme görevlerinde veya hatanın daha ağır biçimde biriktiği çok modlu girdilerde yine de kalite kaybedebilir [13][14][16].
5.2 Ajanlarda ve gerçek dünya davranışında sessiz başarısızlıklar
Son değerlendirmeler, nicemlenmiş modellerin daha sessiz biçimlerde de başarısız olabileceğini gösteriyor. Araç kullanımı, çok adımlı planlama ve ajan tabanlı iş akışları, model yüzeyde hâlâ akıcı görünse bile daha kırılgan hâle gelebilir. Bu tehlikeli bir profildir; çünkü tam da dış sistemlerin, araçların veya gecikmeli sonuçların önemli olduğu anlarda güvenilirliği azalırken kulağa yetkin gelen modeller ortaya çıkarır [14][17].
Pratikte bu, nicemlemenin yalnızca bir metin üretimi sorunu olarak değil, bir sistem davranışı sorunu olarak da değerlendirilmesi gerektiği anlamına gelir. Bir model bir ajan döngüsünün, bir bilgi erişim (retrieval) yığınının veya bir araç çağırma iş akışının parçasıysa token düzeyindeki küçük bir güvenilirlik kaybı çok daha büyük bir operasyonel arızaya dönüşebilir.
5.3 Güvenlik, yanlılık ve hizalama bozulmaları
Son değerlendirmeler, sıkıştırmanın güvenlik ve davranış özelliklerini de değiştirebileceğini gösteriyor. Nicemleme bir modeli otomatik olarak güvensiz veya yanlı hâle getirmez, ancak hizalamayı, güvenlik önlemlerini ve kararlı davranışı destekleyen mekanizmaları bozabilir. Bazı davranışlar zaten sayısal olarak kırılgansa düşük bitli sıkıştırma onları reddetme davranışını, toksisite eğilimlerini veya adversaryal prompt'lara karşı sağlamlığı değiştirecek kadar kaydırabilir [13][17].
Burada doğru tutum ne inkâr ne de paniktir. Nicemleme, etkileri doğrudan ölçülmesi gereken, davranışı değiştiren bir müdahale olarak ele alınmalıdır. Modelin daha küçük ve daha hızlı olup olmadığını sormak yeterli değildir; çözünürlük azaltıldığında hangi özelliklerin daha az kararlı hâle geldiğini de sormamız gerekir.
6. Sonuç: Nicemleme
Nicemleme, büyük modelleri saklamayı daha ucuz, taşımayı daha kolay ve dağıtmayı daha pratik hâle getirir. Gelişmiş modellerin özel altyapıların dışında çalışabilmesinin başlıca nedenlerinden biridir. Bu anlamda nicemleme, modern LLM'lerin geniş kitlelere erişilebilir olmasının arkasındaki kilit teknolojilerden biridir: O olmasaydı pek çok model, yalnızca az sayıda kullanıcının veya kuruluşun karşılayabileceği donanım bütçelerine hapsolmuş kalırdı.
Dağıtımı pratik kılan aynı sıkıştırma, modelin iç hesaplamasından faydalı çözünürlüğü de alabilir. Bu kayıp; gerileyen akıl yürütme, sessiz kararsızlık veya değişen davranış olarak kendini gösterebilir. Önemli ders şudur: Nicemleme asla “bedava” değildir. Açıkça yapmaya değer olduğunda bile modelin düşündüğü sayısal rejimi değiştirir.
6.1 Araştırmalar nereye gidiyor?
Güncel araştırmalar; daha akıllı düşük bitli yöntemlere, hassas aktivasyonların daha iyi korunmasına, donanıma duyarlı formatlara ve sıkıştırmanın benchmark doğruluğunun ötesinde neleri değiştirdiğinin daha ince değerlendirilmesine yöneliyor. Genel yön net: Gelecekteki çalışmalar yalnızca modelleri daha az bite sığdırmakla ilgili değil; bir modelin hangi bölümlerinin agresif biçimde sıkıştırılabileceğini, hangilerinin sayısal olarak korunması gerektiğini öğrenmekle ilgili [6][12][17].
Bu yüzden nicemleme, son aşamada uygulanan bir depolama hilesi olarak değil, temel bir tasarım katmanı olarak anlaşılmalıdır. Model kalitesi, dağıtım maliyeti ve davranışsal güvenilirlik arasında konumlanır; en iyi modern yöntemlerin hepsi bu üç baskıyı daha akıllıca dengeleme girişimleridir.
Kaynakça
[1] Jacob et al. (2018). Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. Ölçek / sıfır noktası nicemleme ve nicemleme farkındalıklı eğitim için temel kaynak.
[2] Dettmers et al. (2022). LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. Transformer aykırı değerleri ve basit düşük bitli sıkıştırmanın ölçekte neden farklı biçimde başarısız olduğu konusunda temel kaynak.
[3] Gong et al. (2024). What Makes Quantization for Large Language Models Hard? An Empirical Study from the Lens of Perturbation. Nicemleme hatasını genel bir gürültü yerine yapılandırılmış bir bozulma olarak anlamak için faydalı kaynak.
[4] Frantar et al. (2022). GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. GPT tarzı modellerde ikinci dereceden eğitim sonrası nicemleme için birincil kaynak.
[5] Xiao et al. (2023). SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models. Ağırlık ve aktivasyon nicemlemesinde aktivasyon aykırı değerlerinin ele alınmasına dair kilit kaynak.
[6] Lin et al. (2023). AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration. Düşük bitli LLM nicemlemesinde aktivasyon açısından önemli ağırlıkların korunması için birincil kaynak.
[7] Lee et al. (2023). OWQ: Outlier-Aware Weight Quantization for Efficient Fine-Tuning and Inference of Large Language Models. Aykırı değerlere duyarlı düşük bitli nicemleme ve fine-tuning için faydalı kaynak.
[8] Dettmers et al. (2023). QLoRA: Efficient Finetuning of Quantized LLMs. 4 bitlik nicemlenmiş fine-tuning ve NF4 tabanlı eğitim iş akışları için önemli kaynak.
[9] ggml / llama.cpp. GGUF format specification. Dağıtım odaklı yöntemler bölümünde ele alınan GGUF dosya formatının resmî spesifikasyonu.
[10] turboderp-org. ExLlamaV2 README and EXL2 quantization notes. EXL2'nin karma bit hızlı yerel GPU iş akışı için birincil uygulama kaynağı.
[11] Liu et al. (2023). LLM-QAT: Data-Free Quantization Aware Training for Large Language Models. LLM'lere özgü ilk QAT kaynaklarından biri; özellikle 8 bitin altındaki hassasiyetlerde önemlidir.
[12] Chen et al. (2024). EfficientQAT: Efficient Quantization-Aware Training for Large Language Models. Pratik düşük bitli eğitim verimliliğine odaklanan daha yeni bir LLM-QAT çalışması.
[13] Jin et al. (2024). A Comprehensive Evaluation of Quantization Strategies for Large Language Models. Yetenek, hizalama ve verimliliği kapsayan kapsamlı bir değerlendirme çerçevesi.
[14] Lee et al. (2024). Exploring the Trade-Offs: Quantization Methods, Task Difficulty, and Model Size in Large Language Models From Edge to Giant. Modeller, nicemleyiciler ve benchmark aileleri arasında büyük ölçekli karşılaştırma.
[15] Li et al. (2025). Quantization Meets Reasoning: Exploring LLM Low-Bit Quantization Degradation for Mathematical Reasoning. Agresif düşük bitli nicemlemede akıl yürütmenin gerilediğine dair doğrudan kanıt.
[16] Mekala et al. (2025). Does quantization affect models' performance on long-context tasks?. Nicemleme altında uzun bağlam performansındaki gerileme için birincil kaynak.
[17] Kharinaev et al. (2025). Investigating the Impact of Quantization Methods on the Safety and Reliability of Large Language Models. Güvenlik / güvenilirlik bölümü ve davranış değişikliklerinin neden doğrudan ölçülmesi gerektiği için kaynak.
