

LLM 量化:原理与值得关注的问题
 Toni Lopez Co-Founder at Karumi
1. 量化简介
量化通过压缩数值表示,让大语言模型得以在实际中运行,但每减少一个比特,都会在精度、鲁棒性和行为上带来权衡。
大语言模型规模扩大后,面临的不仅是计算问题,更是内存问题。每个参数都必须存储在某处、在内存中搬运,并且读取速度要足够快,推理才能保持可用。当模型从数十亿参数增长到数百亿乃至数千亿参数时,权重的搬运就成了主要瓶颈之一。
这就是人们常说的“内存墙”:计算硬件可能持续进步,但内存容量和带宽的增长速度跟不上。因此,一个模型之所以难以运行,往往不是因为算不了,而是因为高效地存放和搬运其权重的成本太高。
一个 FP16 或 BF16 格式的大模型所需的内存,可能远超消费级硬件能轻松提供的容量。一个以 16 位精度存储的 70B 模型,就已远远超出大多数本地环境能轻松加载的范围,而这个估算还只涵盖静态权重。实际推理时,还需要为激活值、临时缓冲区和 KV 缓存预留空间 [13][16]。
正因如此,量化并不是一种小众优化。如果不做任何压缩,许多有用的模型只能依赖昂贵的 GPU、服务器级部署或激进的卸载策略才能使用。量化正是将这一硬性硬件约束转化为可控的精度与效率权衡的技术 [13][14]。
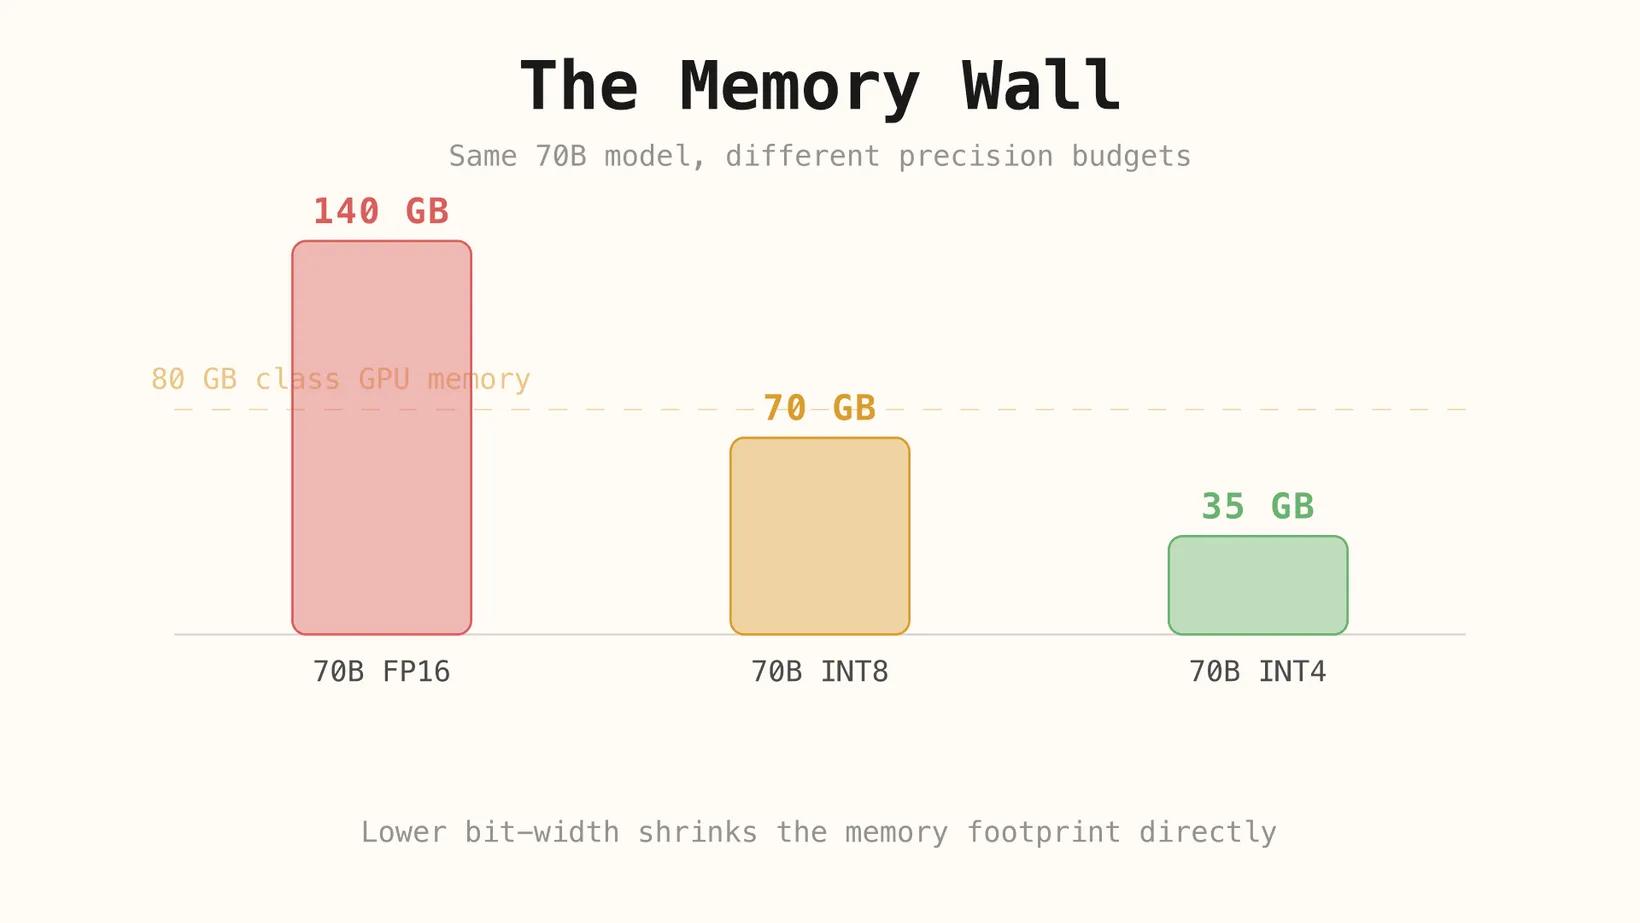
本文将完整梳理这一权衡。首先,解释量化作为一种数学运算的含义;然后,说明这一思路的朴素实现为何会破坏大型 Transformer;接着,梳理试图控制由此产生误差的主要现代方法;最后,探讨精度降低时可能悄然退化的能力与行为。
2. 量化的基本思路
从本质上讲,量化就是用一套更小的数值“词汇表”替代原本丰富的词汇表。我们不再允许权重取众多细密间隔的浮点值,而是强制它落在一个更小的离散网格上。可用的级数削减得越激进,表示就越紧凑。
这带来两个直接好处。第一,每个权重占用的比特更少,模型所需内存随之减少。第二,硬件需要搬运的数据更少,实际推理速度往往也会提升。但这些收益是有真实代价的:原本不同的值,现在可能会坍缩为同一个低比特表示。
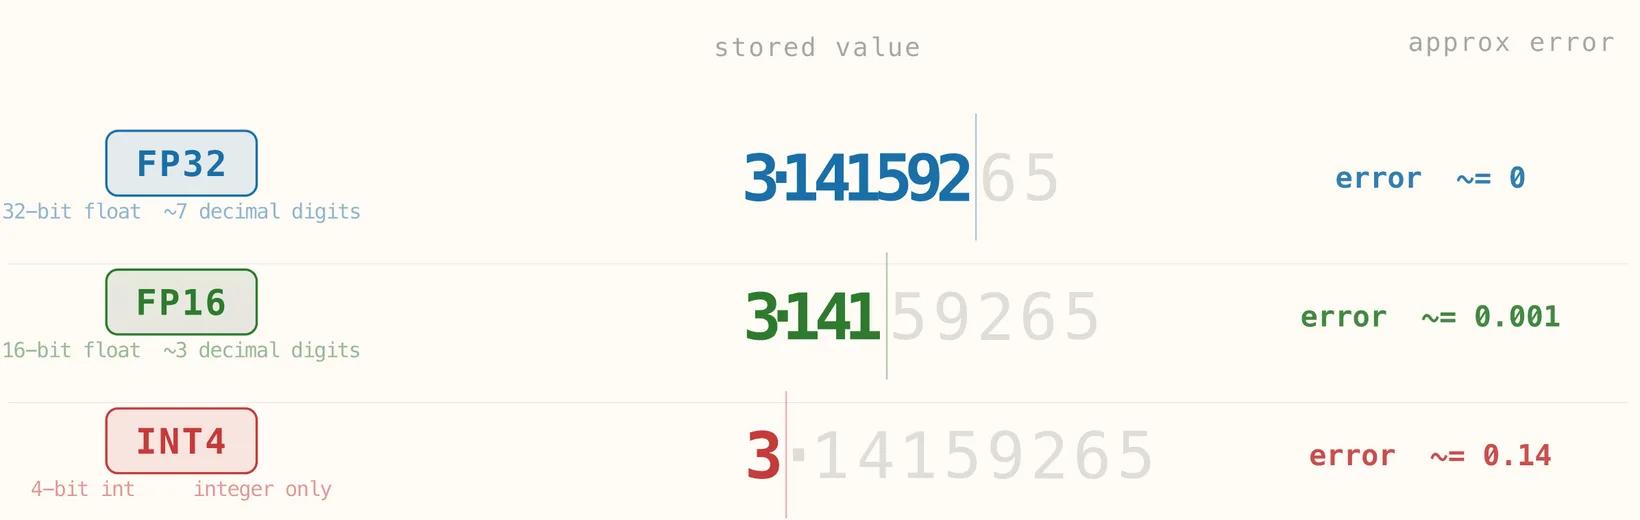
下图以同一个数值在不同精度下的表示,展示了这种代价。在 FP32 下,数字几乎保留了全部小数细节,近似误差基本可以忽略。在 FP16 下,部分细节被舍入掉,但存储值仍接近原值。到了 INT4,模型已完全无法保留精细的小数结构,存储值变得粗糙得多,误差也急剧增大。核心道理很简单:精度越低,模型存储原始数值的保真度就越差。
2.1 量化公式
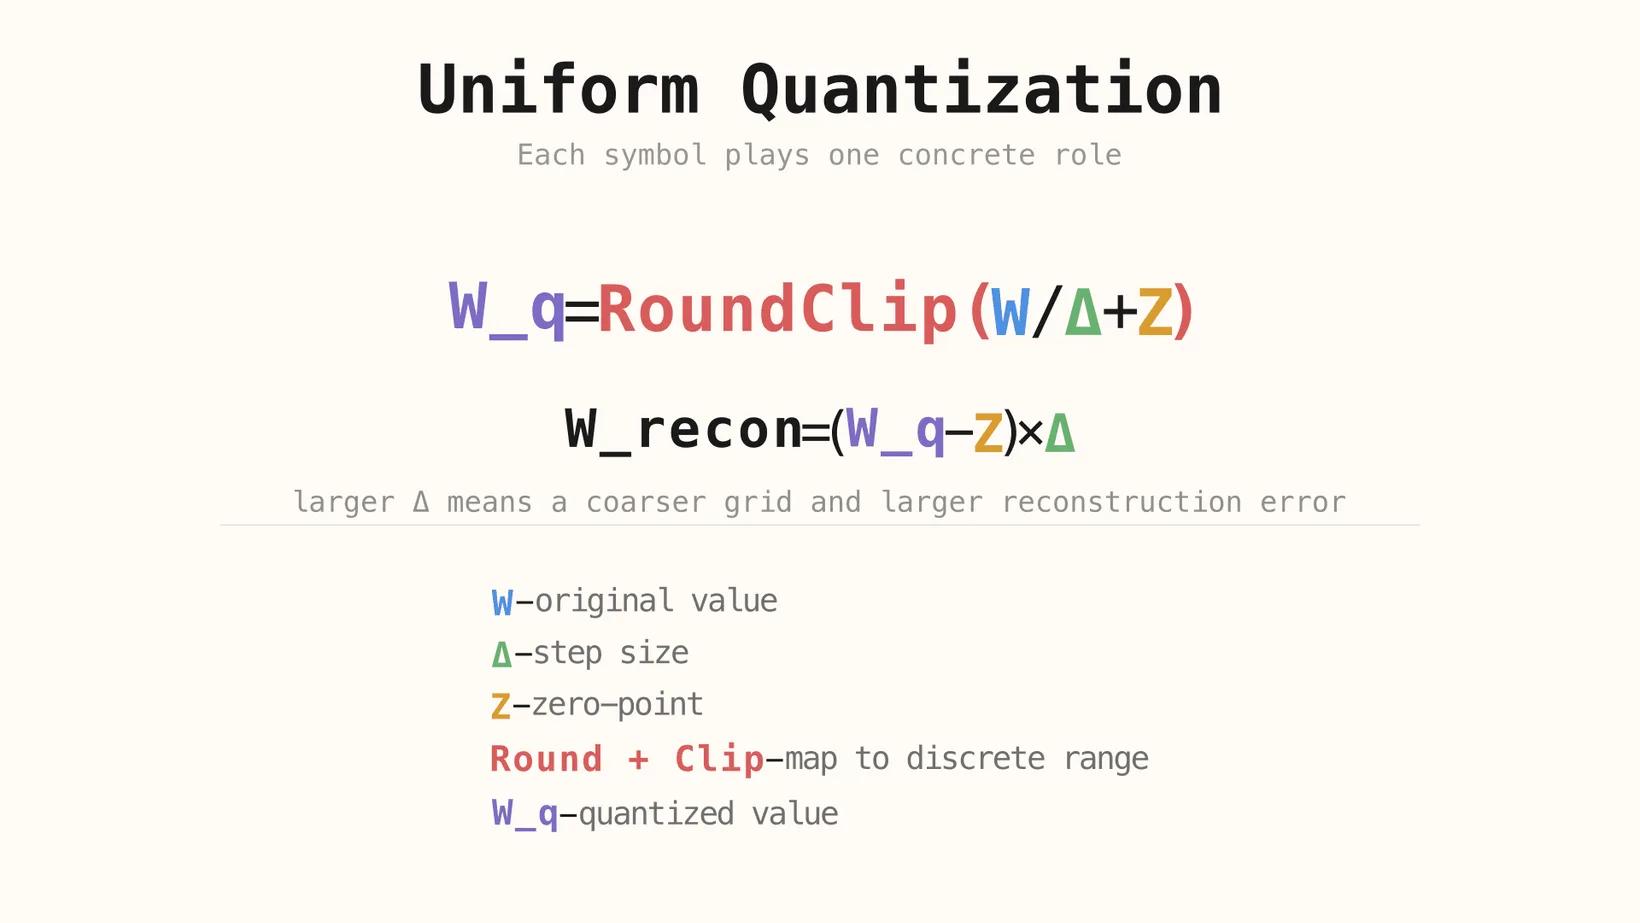
量化流程可以理解为一系列简单操作:对数值进行缩放,将其平移到离散网格上,取整,截断到允许的范围内,然后在推理时近似地重建它 [1]。
蓝色的 W 是原始的高精度值。绿色的 Δ 控制每个量化步长的大小,也就是网格本身的分辨率。琥珀色的 Z 对网格进行平移,以便在需要非对称映射时能正确表示零。随后,红色的 Round + Clip 阶段将数值强制限定在目标位宽所允许的离散整数范围内,得到紫色的 W_q。
推理时,模型无法精确还原原始值,而是用相同的缩放因子和偏移量反向映射,重建一个近似值。这就是反量化并非完美逆运算的原因:一旦多个相邻的实数值被压缩到同一个离散级别,丢失的细节就无法恢复。
降低精度并不会随机地损坏模型。它减少的是模型能表示的不同数值的数量,从而增大近似误差,使相近的数值更难区分。
关键在于,这种损失是有结构的。如果量化网格很粗,权重之间的微小差异会最先消失。也就是说,模型保留了参数的大致形态,却丢失了精细的数值细节。当这种情况在大量张量和层中反复发生时,累积误差就成了所有量化方法都要设法管控的核心问题 [3]。
接下来的问题是:为什么这种误差在大语言模型中不只是有点麻烦,而是格外危险?
3. 朴素量化为何在 LLM 中失效
上面的小数示例刻意做得很简单:它展示的是单个数值丢失精度时会发生什么。大语言模型失效的根本原因相同,但规模上要棘手得多。被舍入的不是一个数,而是整个张量同时丢失分辨率,而且这种损失还会与不均匀的数值量级、罕见的极端值以及各层特有的敏感性相互作用。
如果模型权重只是一些数字,人们很容易认为量化不过是更激进地对它们取整。在小型示例中,这种直觉似乎说得通:缩小表示、接受一定误差,然后继续。但大型 Transformer 并不是由可互换数字组成的巨大表格。它们的性能依赖于分布在各层、各通道和各 token 之间、极不均匀的数值结构。
因此,朴素取整并不会带来平滑、均匀的质量下降。它可能恰好摧毁网络最依赖的那些区分。结果不仅是精度降低,有时还会出现连贯性、困惑度或推理质量的骤然崩塌,其剧烈程度远超“精度低一点,噪声多一点”这种简单心智模型的预期。
3.2 离群值、步长膨胀与超大激活
主要的失效模式并不是取整本身,而是当张量中存在极端值时取整所造成的后果。如果一个张量中有一个或少数几个量级远大于其他值的离群值,量化尺度就必须拉伸以覆盖它们。尺度变大,意味着每个离散步长现在覆盖的实数范围更宽。
一旦如此,分布中间的普通数值就会失去有效分辨率。它们不再被映射到众多不同的级别,而是挤进少得多的区间里。实际上,离群值让整个张量为它的取值范围买单。这就是公式中绿色的 Δ 如此重要的原因:当 Δ 过大时,网格对大部分数据来说就太粗了。
同样的道理不止适用于静态权重。大模型还可能产生超大激活,包括表现得像注意力汇聚点(attention sink)的特定 token 尖峰。这些并非无害的边缘情况,恰恰会造成朴素量化难以应对的那种不成比例的尺度问题 [2] [5] [7]。
随着模型规模增长,这些病态现象会变得更具结构性。大型 Transformer 会出现离群通道、token 级激活尖峰,以及让朴素量化可靠性大幅下降的各种行为。因此,问题不只是“参数越多,舍入误差越多”,而是更大的模型会形成更难用一条粗糙的全局规则来压缩的数值几何结构 [2][3]。
一旦把朴素量化理解为尺度管理和误差控制的失败,现代量化方法就不再像一堆随意的缩写,而是一个个有针对性的应对方案。
4. 当今量化的实际应用方式
4.1 训练后量化与量化感知训练
现代量化通常从训练后量化(PTQ)或量化感知训练(QAT)入手。PTQ 在训练完成后对模型进行调整,成本低、实用性强,因此在开放权重模型的推理流程中占据主导地位。QAT 成本更高,因为它在训练或微调阶段就让模型接触量化,但作为回报,当目标精度非常低时,它能更好地保持质量 [1][11][12]。
这一初步划分之所以重要,是因为它告诉我们要解决的是哪类问题。PTQ 关心的是:不重新训练,能从现有模型中获得多大的压缩?QAT 关心的是:模型能否从一开始就学会在量化状态下运行?
4.2 现代方法试图保留什么
并非所有量化误差的危害都一样,因此不同方法试图保留的东西也不同。有些方法着重保护对激活影响最大的权重或通道;有些专注于局部缩放,避免张量中某个糟糕区域拖累其余部分;还有一些则围绕吞吐量、灵活的比特率目标,或更高效地利用特定硬件栈进行优化 [6][4][5]。
因此,最好把现代量化方法理解为误差控制策略。它们都在回答同一个问题:哪些信息重要到不能被朴素压缩?保护它们的最低成本方式是什么?
4.3 实践中的主要方法与部署格式
当今的生态并不是一份随意的缩写清单,但它确实混杂了不同性质的东西。AWQ、GPTQ 和 QAT 是量化方法或训练方法;GGUF 和 EXL2 则更接近模型格式和推理生态:它们之所以重要,是因为能以适配特定硬件和运行时的方式打包或落地量化模型。
| 名称 | 类型 | 核心思路 | 优势 | 最适用场景 |
|---|---|---|---|---|
| GGUF | 格式 / 部署生态 | 可移植的量化模型格式,广泛用于本地推理栈 | 可移植性强,默认配置实用 | CPU、Apple Silicon、异构本地环境 |
| AWQ | 量化方法 | 量化时保护对激活影响显著的权重 | 低位宽下质量保持出色 | 注重质量的 GPU 推理 |
| GPTQ | 量化方法 | 基于二阶信息的训练后权重量化 | 推理快,压缩效果好 | 以吞吐量为导向的 GPU 服务 |
| EXL2 | 格式 / 运行时生态 | 针对 ExLlama 类推理调优的混合比特率量化格式 | 内存与速度的灵活权衡 | 多 GPU 或显存受限的 ExLlama 环境 |
| QAT | 训练方法 | 在训练或微调循环中引入量化 | 极低精度下鲁棒性最佳 | 可以接受重新训练成本的场景 |
这张表的目的不是让你记住这些名称,而是让你注意到每一行解决的都是问题中略有不同的一个层面:有的描述权重如何量化,有的描述量化模型如何打包和运行。表中内容凝练自 GGUF 规范、AWQ、GPTQ、ExLlamaV2 / EXL2,以及 LLM-QAT 和 EfficientQAT 等近期面向 LLM 的 QAT 研究 [9][6][4][10][11][12]。
4.4 这些方法和格式各自适用的场景
理清权衡之后,整体格局就更容易把握了。如果你需要广泛的本地可移植性,以及在 CPU 和 Apple Silicon 上都表现良好的格式,GGUF 是自然之选 [9]。当 GPU 推理是首要考量时,AWQ 和 GPTQ 更为合适,但两者优化的是权衡的不同侧面:更看重保持质量时,通常首选 AWQ;以吞吐量为核心时,则常常选择 GPTQ [6][4]。
当“放得进内存”本身就是首要的优化问题,并且你希望在特定推理栈中更精细地控制比特率时,EXL2 是合理的选择 [10]。QAT 则完全属于另一类:它不是一种服务格式,而是一种训练阶段的策略。当激进的低比特部署重要到足以证明值得重新训练或微调模型、使其能承受量化噪声时,QAT 就很有吸引力 [11][12]。
但选择方法只是故事的一半。更难回答的问题是:施加压缩后,哪些能力和行为会变得不那么稳定?
5. 量化的隐性成本
5.1 能力退化:推理、上下文与多模态可靠性
近期评估表明,降低精度可能会削弱推理质量和长上下文表现,同样的低比特鲁棒性问题也可能影响多模态系统。这些退化往往并不均匀:有些任务保持稳定,另一些则急剧恶化。模型可能依然表达流畅,却在多步数学、长链推理,或依赖在多层之间保留细微内部差异的任务上变得不可靠 [15][16][12]。
这种不均匀性,正是只用一小部分基准测试来评估量化可能产生误导的原因之一。一个在短提示词上看起来几乎没有变化的模型,在更长的上下文、更难的推理任务,或误差累积更严重的多模态输入上,仍可能出现质量下降 [13][14][16]。
5.2 智能体与真实场景中的隐性故障
近期评估还表明,量化模型可能以更隐蔽的方式出错。即使模型表面上依然流畅,工具调用、多步规划和智能体工作流也可能变得更加脆弱。这是一种危险的特征:模型听起来很专业,却恰恰在外部系统、工具或延迟后果至关重要的时刻变得不那么可靠 [14][17]。
实践中,这意味着评估量化时不能只把它当作文本生成问题,还要把它当作系统行为问题。如果模型处于智能体循环、检索栈或工具调用工作流之中,token 层面可靠性的微小损失,就可能演变成严重得多的运营故障。
5.3 安全、偏见与对齐的扭曲
近期评估表明,压缩也可能改变模型的安全性和行为特性。量化并不会自动让模型变得不安全或带有偏见,但它可能扭曲支撑对齐、护栏和稳定行为的机制。如果某些行为在数值上本就脆弱,低比特压缩可能足以让它们发生偏移,从而改变拒答行为、生成有害内容的倾向,或对对抗性提示词的鲁棒性 [13][17]。
正确的态度既不是否认,也不是恐慌。应当把量化视为一种会改变行为的干预手段,并直接测量其影响。仅仅问模型是否变得更小、更快是不够的;还需要问:在分辨率被削减之后,哪些特性变得不那么稳定了?
6. 结论:量化
量化让大模型的存储更便宜、搬运更容易、部署更实用,是先进模型能够脱离专用基础设施运行的主要原因之一。从这个意义上说,量化是推动现代 LLM 走向普及的关键技术之一:没有它,许多模型仍会被困在只有少数用户或组织才负担得起的硬件预算之后。
然而,让部署变得可行的压缩,同样可能削去模型内部计算中有用的分辨率。这种损失可能表现为推理能力下降、隐性的不稳定或行为偏移。关键的教训是:量化从来都不是“免费”的。即使明显值得去做,它也会改变模型进行“思考”时所处的数值环境。
6.1 研究的下一步方向
当前的研究正朝着更智能的低比特方法、对敏感激活更好的保护、硬件感知的格式,以及对压缩在基准精度之外所带来变化的更精细评估等方向推进。大方向很明确:未来的工作不仅是把模型塞进更少的比特,更是要弄清模型的哪些部分可以激进压缩、哪些部分必须在数值上继续受到保护 [6][12][17]。
因此,应当把量化理解为一个核心的设计层,而不是最后一步的存储技巧。它处于模型质量、部署成本和行为可靠性之间,而最好的现代方法,都是在尝试更聪明地平衡这三方面的压力。
参考文献
[1] Jacob et al. (2018). Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference。关于缩放因子 / 零点量化和量化感知训练的奠基性文献。
[2] Dettmers et al. (2022). LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale。关于 Transformer 离群值,以及朴素低比特压缩为何在大规模下以不同方式失效的核心文献。
[3] Gong et al. (2024). What Makes Quantization for Large Language Models Hard? An Empirical Study from the Lens of Perturbation。有助于将量化误差理解为结构化扰动而非一般噪声的参考文献。
[4] Frantar et al. (2022). GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers。GPT 类模型中基于二阶信息的训练后量化的一手资料。
[5] Xiao et al. (2023). SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models。关于在权重与激活量化中处理激活离群值的关键文献。
[6] Lin et al. (2023). AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration。关于在低比特 LLM 量化中保护对激活影响显著的权重的一手资料。
[7] Lee et al. (2023). OWQ: Outlier-Aware Weight Quantization for Efficient Fine-Tuning and Inference of Large Language Models。关于离群值敏感的低比特量化与微调的实用参考文献。
[8] Dettmers et al. (2023). QLoRA: Efficient Finetuning of Quantized LLMs。关于 4 位量化微调和基于 NF4 的训练流程的重要文献。
[9] ggml / llama.cpp. GGUF format specification。面向部署的方法一节中所讨论的 GGUF 文件格式的官方规范。
[10] turboderp-org. ExLlamaV2 README and EXL2 quantization notes。EXL2 混合比特率本地 GPU 工作流的主要实现参考。
[11] Liu et al. (2023). LLM-QAT: Data-Free Quantization Aware Training for Large Language Models。较早的 LLM 专用 QAT 文献,在低于 8 位精度时尤为相关。
[12] Chen et al. (2024). EfficientQAT: Efficient Quantization-Aware Training for Large Language Models。较新的 LLM-QAT 研究,聚焦低比特训练的实际效率。
[13] Jin et al. (2024). A Comprehensive Evaluation of Quantization Strategies for Large Language Models。涵盖能力、对齐与效率的全面评估框架。
[14] Lee et al. (2024). Exploring the Trade-Offs: Quantization Methods, Task Difficulty, and Model Size in Large Language Models From Edge to Giant。跨模型、量化方法和基准测试类别的大规模对比研究。
[15] Li et al. (2025). Quantization Meets Reasoning: Exploring LLM Low-Bit Quantization Degradation for Mathematical Reasoning。激进低比特量化导致推理能力退化的直接证据。
[16] Mekala et al. (2025). Does quantization affect models' performance on long-context tasks?。关于量化导致长上下文性能退化的主要参考文献。
[17] Kharinaev et al. (2025). Investigating the Impact of Quantization Methods on the Safety and Reliability of Large Language Models。安全性 / 可靠性一节的参考文献,也说明了为何应直接测量行为变化。
