

Quantifier les LLM : comment ça marche et ce qui doit vous préoccuper
 Toni Lopez Co-Founder at Karumi
1. Introduction à la quantification
La quantification rend les grands modèles de langage exploitables en compressant leur représentation numérique, mais chaque bit supprimé entraîne des compromis en matière de précision, de robustesse et de comportement.
En grandissant, les grands modèles de langage ne posent pas seulement un problème de calcul : ils posent un problème de mémoire. Chaque paramètre doit être stocké quelque part, transiter par la mémoire et être lu assez vite pour que l’inférence reste praticable. À mesure que les modèles passent de quelques milliards à des dizaines, voire des centaines de milliards de paramètres, ce déplacement des poids devient l’un des principaux goulots d’étranglement.
C’est ce que l’on appelle souvent le mur de la mémoire : le matériel de calcul continue de progresser, mais la capacité et la bande passante mémoire n’évoluent pas au même rythme. Un modèle peut donc devenir difficile à exécuter non pas parce que les calculs sont impossibles, mais parce que ses poids coûtent trop cher à conserver et à déplacer efficacement.
Un grand modèle en FP16 ou BF16 peut exiger bien plus de mémoire que ce qu’un matériel grand public peut offrir confortablement. Un modèle de 70B stocké en précision 16 bits dépasse déjà largement ce que la plupart des configurations locales peuvent charger facilement, et cette estimation ne couvre que les poids statiques. En pratique, l’inférence a aussi besoin de place pour les activations, les tampons temporaires et le cache KV [13][16].
C’est pourquoi la quantification n’est pas une optimisation de niche. Sans une forme de compression, de nombreux modèles utiles restent inaccessibles sans GPU coûteux, déploiements de niveau serveur ou stratégies de délestage agressives. La quantification est la technique qui transforme cette contrainte matérielle stricte en un compromis maîtrisable entre précision et efficacité [13][14].
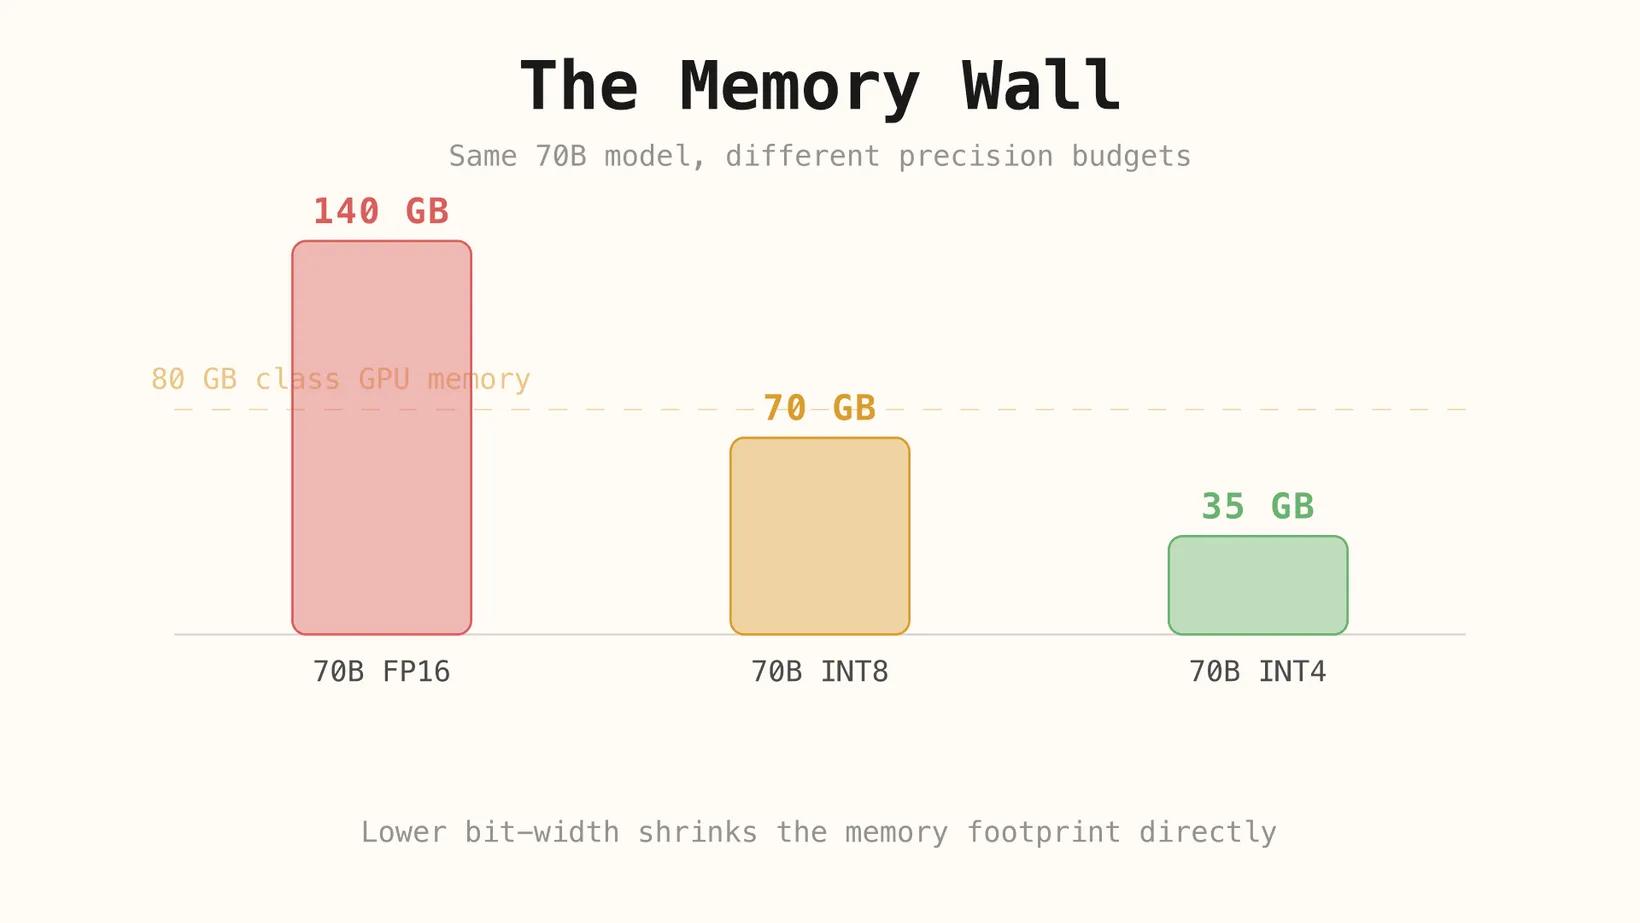
Cet article suit ce compromis de bout en bout. Il explique d’abord ce qu’est la quantification en tant qu’opération mathématique. Il montre ensuite pourquoi la version naïve de cette idée casse les grands transformers. Il passe ensuite en revue les principales approches modernes qui cherchent à maîtriser l’erreur qui en résulte, et examine enfin les capacités et comportements qui peuvent se dégrader discrètement lorsque la précision diminue.
2. L’intuition de base de la quantification
Au fond, quantifier revient à remplacer un vocabulaire numérique riche par un vocabulaire plus restreint. Au lieu de laisser un poids prendre de nombreuses valeurs à virgule flottante finement espacées, on l’oblige à se placer sur une grille discrète plus petite. Plus on réduit agressivement le nombre de niveaux disponibles, plus la représentation devient compacte.
On en tire deux bénéfices immédiats. D’abord, le modèle a besoin de moins de mémoire, car chaque poids utilise moins de bits. Ensuite, le matériel a moins de données à déplacer, ce qui améliore souvent la vitesse d’inférence en pratique. Mais ces gains ont un vrai prix : des valeurs autrefois distinctes peuvent désormais se confondre dans la même représentation à faible nombre de bits.
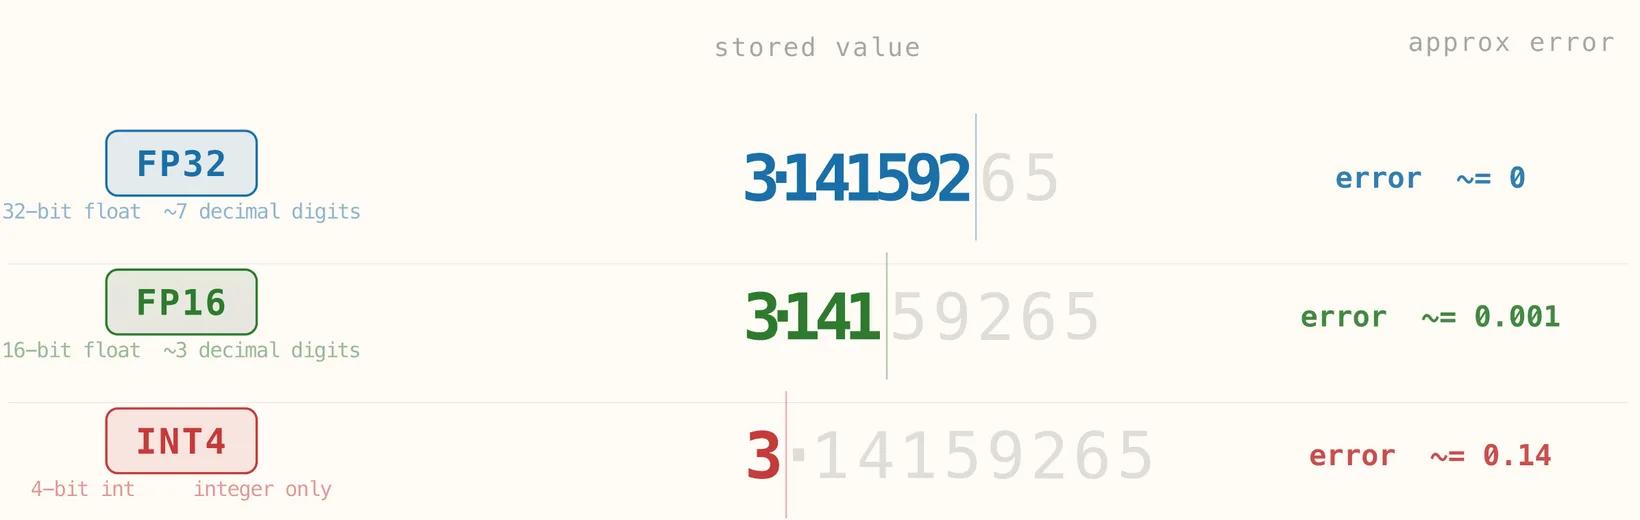
La figure ci-dessous illustre ce sacrifice avec une seule valeur écrite à différentes précisions. En FP32, le nombre conserve presque tous ses détails décimaux : l’erreur d’approximation est pratiquement négligeable. En FP16, une partie de ces détails est perdue à l’arrondi, mais la valeur stockée reste proche de l’originale. En INT4, le modèle ne peut plus du tout préserver la structure décimale fine : la valeur stockée devient beaucoup plus grossière et l’erreur augmente fortement. L’idée clé est simple : plus la précision est faible, moins le modèle peut stocker fidèlement le nombre d’origine.
2.1 La formule de quantification
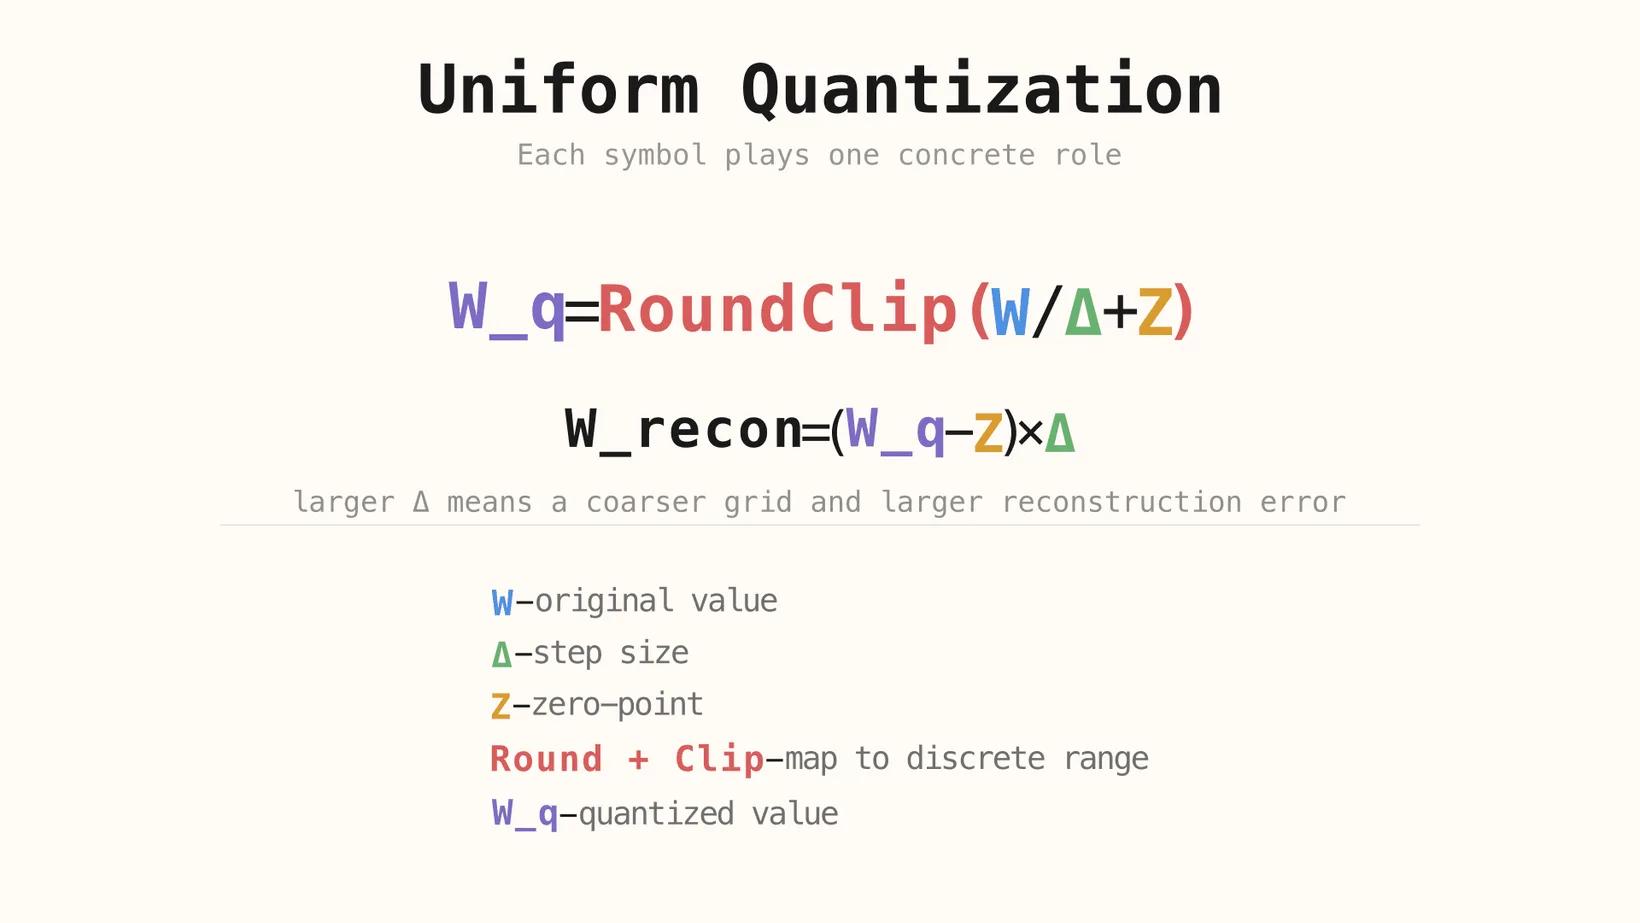
Le processus de quantification peut se comprendre comme une suite d’opérations simples : mettre une valeur à l’échelle, la décaler sur une grille discrète, l’arrondir, la borner à la plage autorisée, puis la reconstruire approximativement lors de l’inférence [1].
Le W bleu est la valeur d’origine en haute précision. Le Δ vert détermine la taille de chaque pas de quantification, c’est-à-dire la résolution de la grille elle-même. Le Z ambre décale cette grille pour que zéro puisse être représenté correctement lorsqu’un mappage asymétrique est nécessaire. L’étape rouge Round + Clip force ensuite la valeur dans la plage d’entiers discrète autorisée par la largeur de bits cible, ce qui produit le W_q violet.
Au moment de l’inférence, le modèle ne retrouve pas exactement la valeur d’origine. Il reconstruit une approximation en inversant le mappage avec la même échelle et le même décalage. C’est pourquoi la déquantification n’est pas un inverse parfait : une fois que plusieurs valeurs réelles voisines ont été ramenées à un seul niveau discret, le détail perdu ne peut plus être récupéré.
Une précision réduite n’abîme pas le modèle au hasard. Elle réduit le nombre de valeurs distinctes que le modèle peut représenter, ce qui augmente l’erreur d’approximation et rend les valeurs proches plus difficiles à distinguer.
Le point important est que cette perte est structurée. Si la grille de quantification est grossière, ce sont les petites différences entre poids qui disparaissent en premier. Le modèle conserve donc la forme générale de ses paramètres, mais perd le détail numérique fin. Lorsque ce phénomène se répète sur de nombreux tenseurs et couches, l’erreur accumulée devient le problème central que toute méthode de quantification cherche à maîtriser [3].
Reste à comprendre pourquoi cette erreur devient particulièrement dangereuse dans les grands modèles de langage, au lieu d’être simplement un peu gênante.
3. Pourquoi la quantification naïve échoue avec les LLM
L’exemple décimal ci-dessus est volontairement simple : il montre ce qui se passe lorsqu’une valeur perd en précision. Les grands modèles de langage échouent pour la même raison de fond, mais à une échelle bien plus délicate. Ce n’est pas un seul nombre qui est arrondi, mais des tenseurs entiers qui perdent en résolution d’un coup, et cette perte interagit avec des magnitudes inégales, des valeurs extrêmes rares et des sensibilités propres à chaque couche.
Si les poids d’un modèle ne sont que des nombres, on est tenté de croire que quantifier consiste simplement à les arrondir plus fortement. Sur un petit exemple jouet, cette intuition paraît raisonnable : on réduit la représentation, on accepte une certaine erreur, et on passe à autre chose. Mais les grands transformers ne sont pas de simples tableaux géants de nombres interchangeables. Leurs performances dépendent d’une structure numérique très inégale, répartie entre couches, canaux et tokens.
Un arrondi naïf ne produit donc pas une perte de qualité douce et uniforme. Il peut détruire précisément les distinctions sur lesquelles le réseau s’appuie le plus. Le résultat n’est pas seulement une précision plus faible, mais parfois un effondrement bien plus brutal de la cohérence, de la perplexité ou de la qualité de raisonnement que ne le laisserait prévoir le modèle mental simpliste « moins de précision, un peu plus de bruit ».
3.2 Valeurs aberrantes, pas de quantification gonflé et activations massives
Le principal mode de défaillance n’est pas l’arrondi en soi, mais ce qu’il produit lorsqu’un tenseur contient des valeurs extrêmes. Si un tenseur contient une ou quelques valeurs aberrantes d’une magnitude bien supérieure au reste, l’échelle de quantification doit s’étirer pour les inclure. Cette échelle plus large signifie que chaque pas discret couvre désormais une plage de valeurs réelles plus étendue.
Dès lors, les valeurs ordinaires au centre de la distribution perdent une résolution utile. Au lieu d’être réparties sur de nombreux niveaux distincts, elles se regroupent dans un nombre bien plus réduit de cases. En pratique, la valeur aberrante fait payer sa plage à l’ensemble du tenseur. C’est pourquoi le Δ vert de la formule est si important : lorsque Δ devient trop grand, la grille devient trop grossière pour la majorité des données.
La même idée va au-delà des poids statiques. Les grands modèles peuvent aussi développer des activations massives, y compris des pics propres à certains tokens qui se comportent comme des « attention sinks ». Ce ne sont pas des cas limites anodins : ils créent exactement le type de problème d’échelle disproportionné que la quantification naïve gère mal [2] [5] [7].
À mesure que les modèles grandissent, ces pathologies deviennent plus structurelles. Les grands transformers développent des canaux aberrants, des pics d’activation au niveau des tokens et des comportements qui rendent la quantification naïve bien moins fiable. Le problème n’est donc pas simplement « plus de paramètres, plus d’erreurs d’arrondi ». Le problème, c’est que les modèles plus grands développent une géométrie numérique plus difficile à compresser avec une seule règle globale grossière [2][3].
Une fois que l’on comprend la quantification naïve comme un échec de gestion de l’échelle et de maîtrise de l’erreur, les méthodes de quantification modernes cessent de ressembler à des acronymes arbitraires et apparaissent comme des réponses ciblées.
4. Comment la quantification est appliquée aujourd’hui
4.1 Quantification post-entraînement vs entraînement tenant compte de la quantification
La quantification moderne repose généralement soit sur la quantification post-entraînement (PTQ), soit sur l’entraînement tenant compte de la quantification (QAT). La PTQ adapte un modèle une fois l’entraînement terminé. Elle est peu coûteuse, pratique, et donc dominante dans les workflows d’inférence de modèles à poids ouverts. Le QAT est plus coûteux, car il expose le modèle à la quantification pendant l’entraînement ou le fine-tuning, mais il permet en contrepartie de mieux préserver la qualité lorsque la précision cible devient très faible [1][11][12].
Cette première distinction est importante, car elle indique quel type de problème on cherche à résoudre. La PTQ se demande : quelle compression peut-on obtenir d’un modèle existant sans le réentraîner ? Le QAT se demande : le modèle peut-il apprendre dès le départ à fonctionner dans un régime quantifié ?
4.2 Ce que les méthodes modernes cherchent à préserver
Les différentes méthodes cherchent à préserver des choses différentes, car toutes les erreurs de quantification ne sont pas également nuisibles. Certaines méthodes protègent les poids ou canaux les plus importants pour les activations. D’autres misent sur une mise à l’échelle locale, afin qu’une zone problématique d’un tenseur ne ruine pas le reste. D’autres encore sont optimisées pour le débit, des cibles de débit binaire flexibles ou une exploitation plus efficace d’une pile matérielle donnée [6][4][5].
C’est pourquoi il vaut mieux voir les méthodes de quantification modernes comme des stratégies de maîtrise de l’erreur. Elles cherchent toutes à répondre à la même question : quelles informations sont trop importantes pour être compressées naïvement, et quel est le moyen le moins coûteux de les protéger ?
4.3 Principales méthodes et formats de déploiement en pratique
L’écosystème actuel n’est pas une liste aléatoire d’acronymes, mais il mélange des choses de nature différente. AWQ, GPTQ et QAT sont des méthodes de quantification ou des approches d’entraînement. GGUF et EXL2 relèvent davantage des formats de modèles et des écosystèmes d’inférence : ils comptent parce qu’ils empaquettent ou rendent opérationnels les modèles quantifiés d’une manière adaptée à certains matériels et environnements d’exécution.
| Nom | Type | Idée principale | Point fort | Usage idéal |
|---|---|---|---|---|
| GGUF | format / écosystème de déploiement | format de modèle quantifié portable, très utilisé dans les piles d’inférence locales | portabilité et réglages par défaut pratiques | CPU, Apple Silicon, configurations locales hétérogènes |
| AWQ | méthode de quantification | protéger les poids saillants pour les activations pendant la quantification | très bonne préservation de la qualité à faible nombre de bits | inférence GPU quand la qualité compte |
| GPTQ | méthode de quantification | quantification des poids post-entraînement du second ordre | inférence rapide avec une bonne compression | service GPU orienté débit |
| EXL2 | format / écosystème d’exécution | format quantifié à débit binaire mixte, optimisé pour l’inférence de type ExLlama | compromis mémoire / vitesse flexible | configurations ExLlama multi-GPU ou limitées en VRAM |
| QAT | approche d’entraînement | entraîner ou affiner le modèle en intégrant la quantification à la boucle | meilleure robustesse à très faible précision | cas où le coût du réentraînement est acceptable |
Le but de ce tableau n’est pas de mémoriser des noms. Il s’agit de remarquer que chaque ligne résout une couche légèrement différente du problème : certaines décrivent la façon dont les poids sont quantifiés, d’autres la façon dont les modèles quantifiés sont empaquetés et exécutés. Le tableau condense des idées tirées de la spécification GGUF, d’AWQ, de GPTQ, d’ExLlamaV2 / EXL2 et de travaux récents sur le QAT appliqué aux LLM, comme LLM-QAT et EfficientQAT [9][6][4][10][11][12].
4.4 Quand ces méthodes et formats sont pertinents
Une fois les compromis clarifiés, le paysage devient plus facile à appréhender. GGUF est le choix naturel si vous recherchez une large portabilité locale et un format qui fonctionne bien sur CPU et Apple Silicon [9]. AWQ et GPTQ s’imposent plutôt lorsque l’inférence GPU est la priorité, mais ils optimisent des aspects différents du compromis : AWQ est généralement privilégié lorsque la préservation de la qualité compte davantage, tandis que GPTQ est souvent choisi lorsque le débit est central [6][4].
EXL2 est pertinent lorsque faire tenir le modèle en mémoire est en soi le principal problème d’optimisation et que vous souhaitez un contrôle plus fin du débit binaire au sein d’une pile d’inférence précise [10]. Le QAT appartient à une tout autre catégorie : ce n’est pas un format de service, mais une stratégie appliquée à l’entraînement, qui devient intéressante lorsqu’un déploiement agressif à faible nombre de bits compte suffisamment pour justifier de réentraîner ou d’affiner le modèle afin qu’il résiste au bruit de quantification [11][12].
Mais choisir une méthode n’est que la moitié de l’histoire. La question plus difficile est de savoir quelles capacités et quels comportements deviennent moins stables une fois cette compression appliquée.
5. Les coûts cachés de la quantification
5.1 Dégradation des capacités : raisonnement, contexte et fiabilité multimodale
Des évaluations récentes suggèrent que réduire la précision peut dégrader la qualité du raisonnement et le comportement sur les contextes longs, et que ce même problème de robustesse à faible nombre de bits peut aussi toucher les systèmes multimodaux. Ces dégradations sont souvent inégales : certaines tâches restent stables tandis que d’autres se détériorent fortement. Un modèle peut rester fluide tout en perdant en fiabilité sur les mathématiques en plusieurs étapes, les longues chaînes d’inférence ou les tâches qui exigent que de petites distinctions internes soient préservées à travers de nombreuses couches [15][16][12].
Cette inégalité est l’une des raisons pour lesquelles la quantification peut être trompeuse si on l’évalue uniquement sur un petit échantillon de benchmarks. Un modèle qui semble presque inchangé sur des prompts courts peut tout de même perdre en qualité sur des contextes plus longs, des tâches de raisonnement plus difficiles ou des entrées multimodales où l’erreur s’accumule plus fortement [13][14][16].
5.2 Défaillances silencieuses dans les agents et en conditions réelles
Des évaluations récentes suggèrent aussi que les modèles quantifiés peuvent échouer de manière plus discrète. L’utilisation d’outils, la planification en plusieurs étapes et les workflows agentiques peuvent devenir plus fragiles, même lorsque le modèle paraît toujours fluide en surface. C’est un profil dangereux, car il produit des modèles qui semblent compétents tout en devenant moins fiables précisément aux moments où des systèmes externes, des outils ou des conséquences différées entrent en jeu [14][17].
En pratique, cela signifie que la quantification doit être évaluée non seulement comme un problème de génération de texte, mais comme un problème de comportement système. Si un modèle fait partie d’une boucle d’agent, d’une pile de recherche documentaire ou d’un workflow d’appel d’outils, une petite perte de fiabilité au niveau des tokens peut se transformer en une défaillance opérationnelle bien plus grave.
5.3 Distorsions de sécurité, de biais et d’alignement
Des évaluations récentes suggèrent que la compression peut aussi modifier les propriétés de sécurité et de comportement. La quantification ne rend pas automatiquement un modèle dangereux ou biaisé, mais elle peut déformer les mécanismes qui soutiennent l’alignement, les garde-fous et la stabilité du comportement. Si certains comportements sont déjà numériquement fragiles, la compression à faible nombre de bits peut suffisamment les déplacer pour modifier les refus, les tendances à la toxicité ou la robustesse face aux prompts adversariaux [13][17].
La bonne attitude n’est ni le déni ni la panique. La quantification doit être traitée comme une intervention qui modifie le comportement et dont les effets doivent être mesurés directement. Il ne suffit pas de se demander si le modèle est plus petit et plus rapide ; il faut aussi se demander quelles propriétés sont devenues moins stables lorsque la résolution a été réduite.
6. Conclusion : la quantification
La quantification rend les grands modèles moins coûteux à stocker, plus faciles à déplacer et plus simples à déployer. C’est l’une des principales raisons pour lesquelles des modèles avancés peuvent fonctionner en dehors d’infrastructures spécialisées. En ce sens, la quantification est l’une des technologies clés de la démocratisation des LLM modernes : sans elle, de nombreux modèles resteraient prisonniers de budgets matériels que seuls quelques utilisateurs ou organisations pourraient absorber.
La compression même qui rend le déploiement praticable peut aussi retirer une résolution utile aux calculs internes du modèle. Cette perte peut se traduire par un raisonnement dégradé, une instabilité silencieuse ou un comportement modifié. La leçon essentielle est que la quantification n’est jamais « gratuite ». Même lorsqu’elle en vaut clairement la peine, elle modifie le régime numérique dans lequel le modèle raisonne.
6.1 Les prochaines orientations de la recherche
La recherche actuelle s’oriente vers des méthodes à faible nombre de bits plus intelligentes, une meilleure protection des activations sensibles, des formats adaptés au matériel et une évaluation plus fine de ce que la compression change au-delà de la précision mesurée par les benchmarks. La direction générale est claire : l’enjeu n’est pas seulement de faire tenir les modèles dans moins de bits, mais d’apprendre quelles parties d’un modèle peuvent être compressées agressivement et lesquelles doivent rester protégées numériquement [6][12][17].
C’est pourquoi la quantification doit être comprise comme une couche de conception fondamentale plutôt que comme une astuce de stockage de dernière minute. Elle se situe entre la qualité du modèle, le coût de déploiement et la fiabilité du comportement, et les meilleures méthodes modernes sont toutes des tentatives d’équilibrer plus intelligemment ces trois contraintes.
Bibliographie
[1] Jacob et al. (2018). Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. Référence fondatrice pour la quantification par échelle / point zéro et l’entraînement tenant compte de la quantification.
[2] Dettmers et al. (2022). LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. Référence centrale sur les valeurs aberrantes des transformers et sur les raisons pour lesquelles la compression naïve à faible nombre de bits échoue différemment à grande échelle.
[3] Gong et al. (2024). What Makes Quantization for Large Language Models Hard? An Empirical Study from the Lens of Perturbation. Référence utile pour comprendre l’erreur de quantification comme une perturbation structurée plutôt que comme un bruit générique.
[4] Frantar et al. (2022). GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. Source primaire sur la quantification post-entraînement du second ordre pour les modèles de type GPT.
[5] Xiao et al. (2023). SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models. Référence clé sur le traitement des activations aberrantes dans la quantification conjointe des poids et des activations.
[6] Lin et al. (2023). AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration. Source primaire sur la protection des poids saillants pour les activations dans la quantification des LLM à faible nombre de bits.
[7] Lee et al. (2023). OWQ: Outlier-Aware Weight Quantization for Efficient Fine-Tuning and Inference of Large Language Models. Référence utile sur la quantification à faible nombre de bits sensible aux valeurs aberrantes et sur le fine-tuning.
[8] Dettmers et al. (2023). QLoRA: Efficient Finetuning of Quantized LLMs. Référence importante sur le fine-tuning quantifié en 4 bits et les workflows d’entraînement basés sur NF4.
[9] ggml / llama.cpp. GGUF format specification. Spécification officielle du format de fichier GGUF évoqué dans la section consacrée aux méthodes orientées déploiement.
[10] turboderp-org. ExLlamaV2 README and EXL2 quantization notes. Référence d’implémentation principale pour le workflow GPU local à débit binaire mixte d’EXL2.
[11] Liu et al. (2023). LLM-QAT: Data-Free Quantization Aware Training for Large Language Models. L’une des premières références de QAT propres aux LLM, particulièrement pertinente en dessous de 8 bits.
[12] Chen et al. (2024). EfficientQAT: Efficient Quantization-Aware Training for Large Language Models. Travaux plus récents sur le QAT des LLM, axés sur l’efficacité pratique de l’entraînement à faible nombre de bits.
[13] Jin et al. (2024). A Comprehensive Evaluation of Quantization Strategies for Large Language Models. Cadre d’évaluation large couvrant les capacités, l’alignement et l’efficacité.
[14] Lee et al. (2024). Exploring the Trade-Offs: Quantization Methods, Task Difficulty, and Model Size in Large Language Models From Edge to Giant. Comparaison à grande échelle entre modèles, méthodes de quantification et familles de benchmarks.
[15] Li et al. (2025). Quantization Meets Reasoning: Exploring LLM Low-Bit Quantization Degradation for Mathematical Reasoning. Preuves directes de la dégradation du raisonnement sous une quantification agressive à faible nombre de bits.
[16] Mekala et al. (2025). Does quantization affect models' performance on long-context tasks?. Référence principale sur la dégradation en contexte long sous l’effet de la quantification.
[17] Kharinaev et al. (2025). Investigating the Impact of Quantization Methods on the Safety and Reliability of Large Language Models. Référence pour la section sur la sécurité et la fiabilité, et sur la nécessité de mesurer directement les changements de comportement.
