

小型モデルが牽引するエージェント型AI
 Toni Lopez Co-Founder at Karumi
人工知能はいま、パラダイムシフトの只中にあります。長年主流だったのは「大きいほど良い」という考え方でした。数千億のパラメータを持つモデル(フロンティアLLM)が、あらゆることに長けようとしてきたのです。実際、一般的な会話や推論では目覚ましい成果を上げました。しかし、焦点は変わりました。もはや質問に答えるだけではなく、エージェント型システムを構築することが求められています。計画を立て、APIを呼び出し、コードを実行し、構造化データを扱い、連続した意思決定を行う自律型AIです。この文脈では、巨大モデルは高コストで遅く、過剰な設計になりがちです。
本記事では、Small Language Model(120億パラメータ未満)とMedium Language Model(130億〜700億パラメータ)が、エージェント型タスクに「十分」なだけでなく、適切な学習と各種の手法を組み合わせれば大規模モデルを上回り得ることを論じます。今後の記事では、それぞれのイノベーションを掘り下げ、誰にでもわかる言葉で解説していきます。今回は、小・中規模言語モデルがなぜ、どのようにして業界の次の主役になるのかをお伝えします。
1. 経済性と運用効率
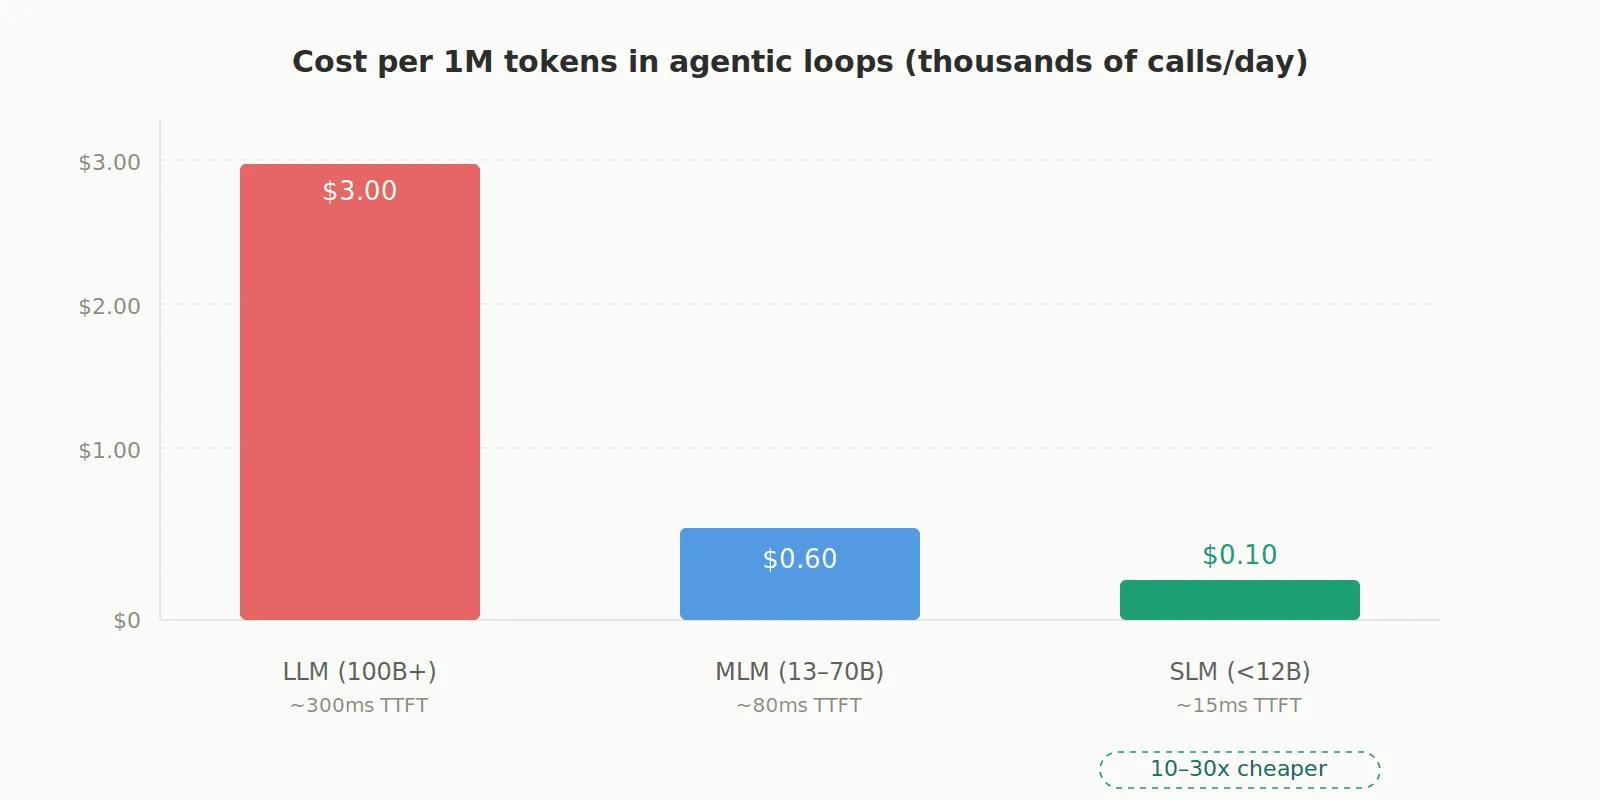
エージェント型システムは、1回の問い合わせで終わるわけではありません。短いループの中で何千回もの呼び出しを実行します。そこに1,000億超のパラメータを持つモデルを使うのは、F1マシンで日用品の買い出しに行くようなものです。SLMはトークンあたりのコストが10〜30分の1で、レイテンシも最小限(最初のトークンが返るまでの時間が大幅に短い)、CPUやモバイル端末でも動作します。さらにエッジでの展開も可能になり、クラウドに依存せずローカルでAIを動かせるため、プライバシー、データ主権、レイテンシの課題を解決できます。
2. エージェントの能力に巨大な規模は不要
実のところ、エージェント型モデルに詩や物語を書く力は必要ありません。エージェントに必要なのは、端的に言えば、正確な関数呼び出し、有効なJSONの生成、スキーマへの厳密な準拠、そしてコードを実行できることです。現在のSLMは、フォーマットされた出力を問題なく生成できます。私が見つけた例では制約付きデコーディングの手法(XGrammarやOutlinesはこうした手法を提供するライブラリです)が使われており、これによりSLMはフロンティアモデルとの差を縮めています。
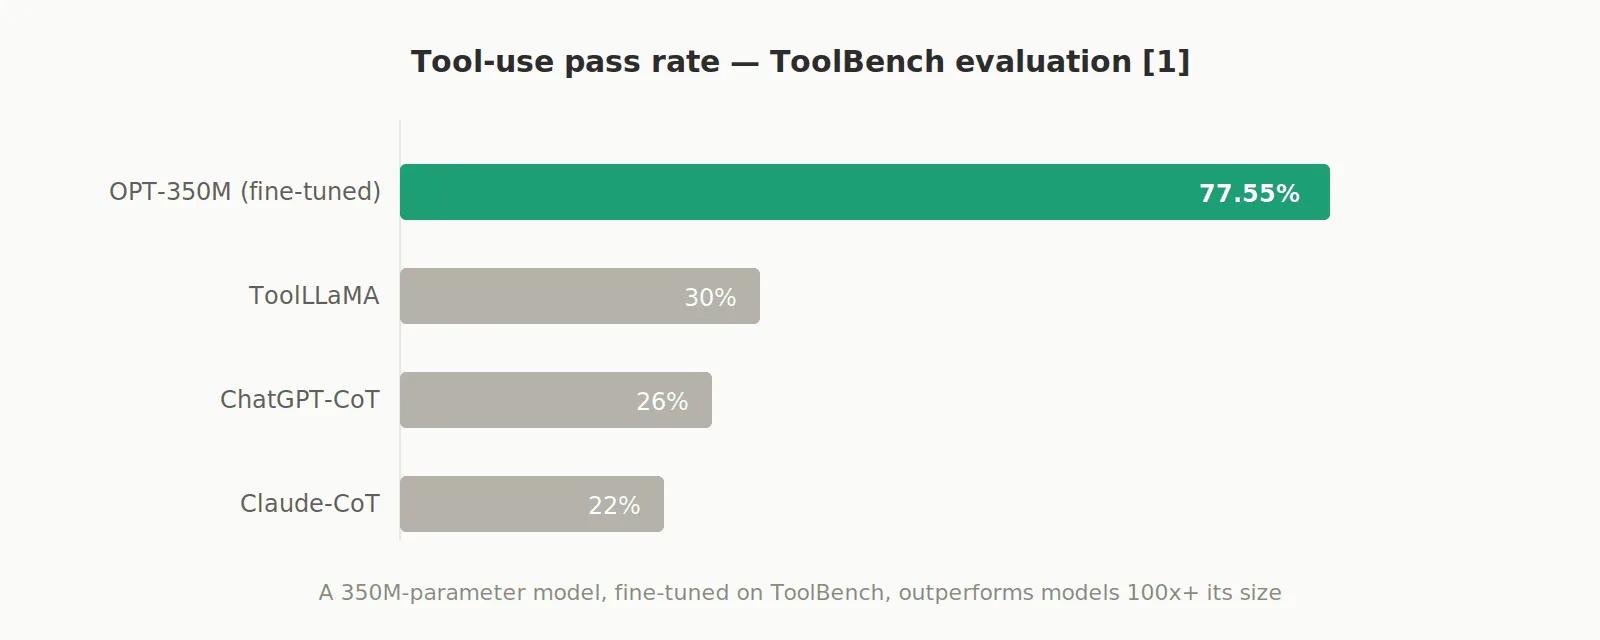
一例として、わずか3億5,000万パラメータのモデル(OPT-350M)をToolBenchのデータでファインチューニングしたところ、ツール使用の評価で77.55%の合格率を達成し、ChatGPT-CoT(26%)、ToolLLaMA(30%)、Claude-CoTを大きく上回りました[1]。
3. アーキテクチャの主要イノベーション
業界でよく知られたアーキテクチャもありますが、興味深いのは、それらがSLMの性能向上のためにどう応用されているかです。
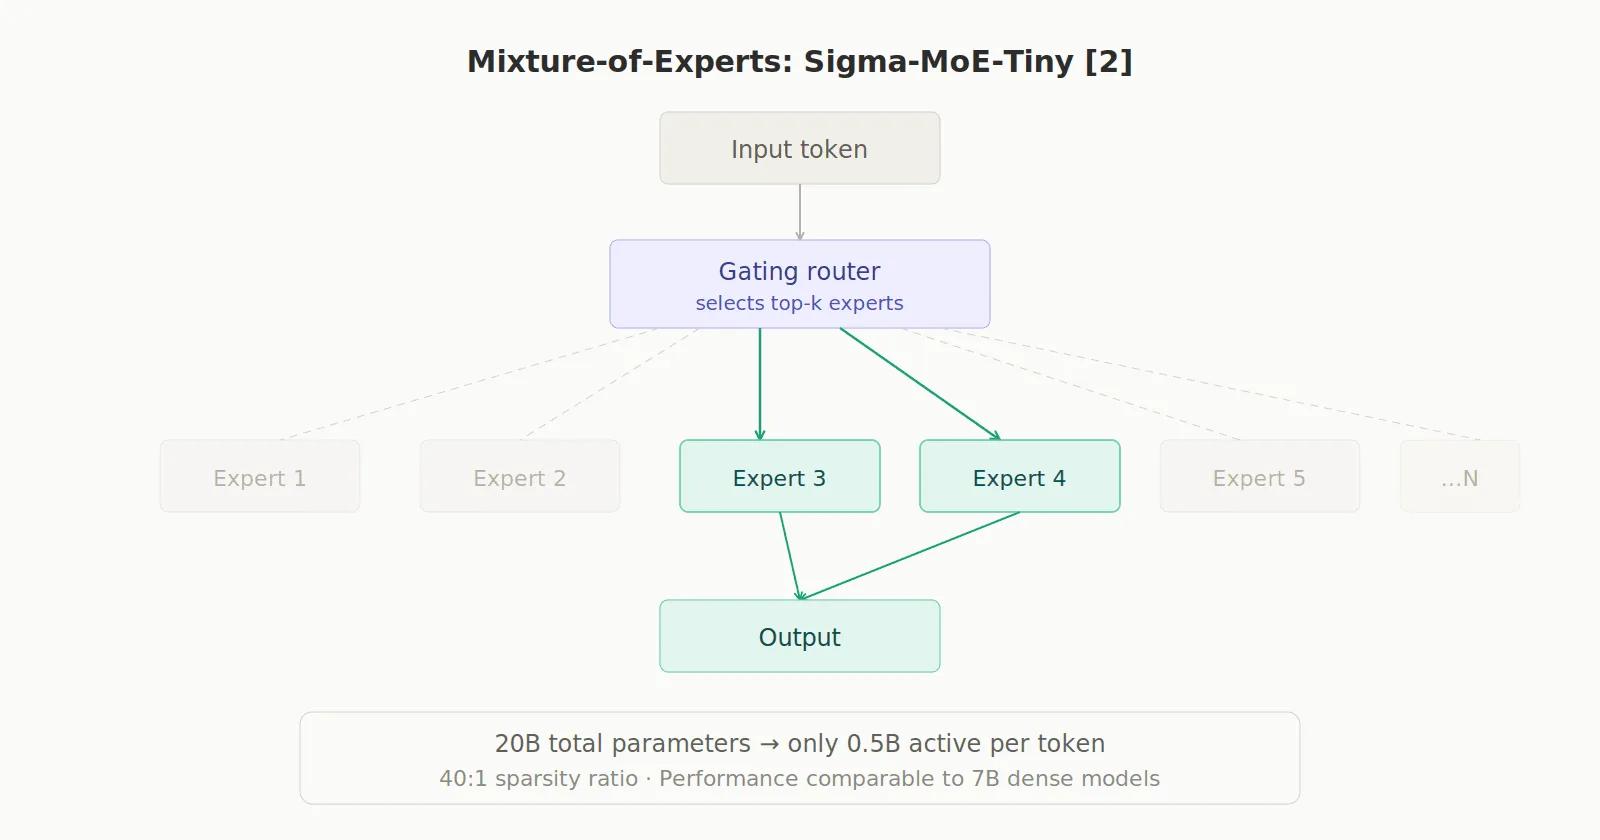
Mixture-of-Experts(MoE):Sigma-MoE-Tinyのようなモデルは総パラメータ数が200億ありながら、トークンごとに活性化するのは5億のみです(40:1の比率)。これにより、数学やコーディングで70億パラメータの密モデルに匹敵する性能を、わずかな計算量で実現しています。[2]
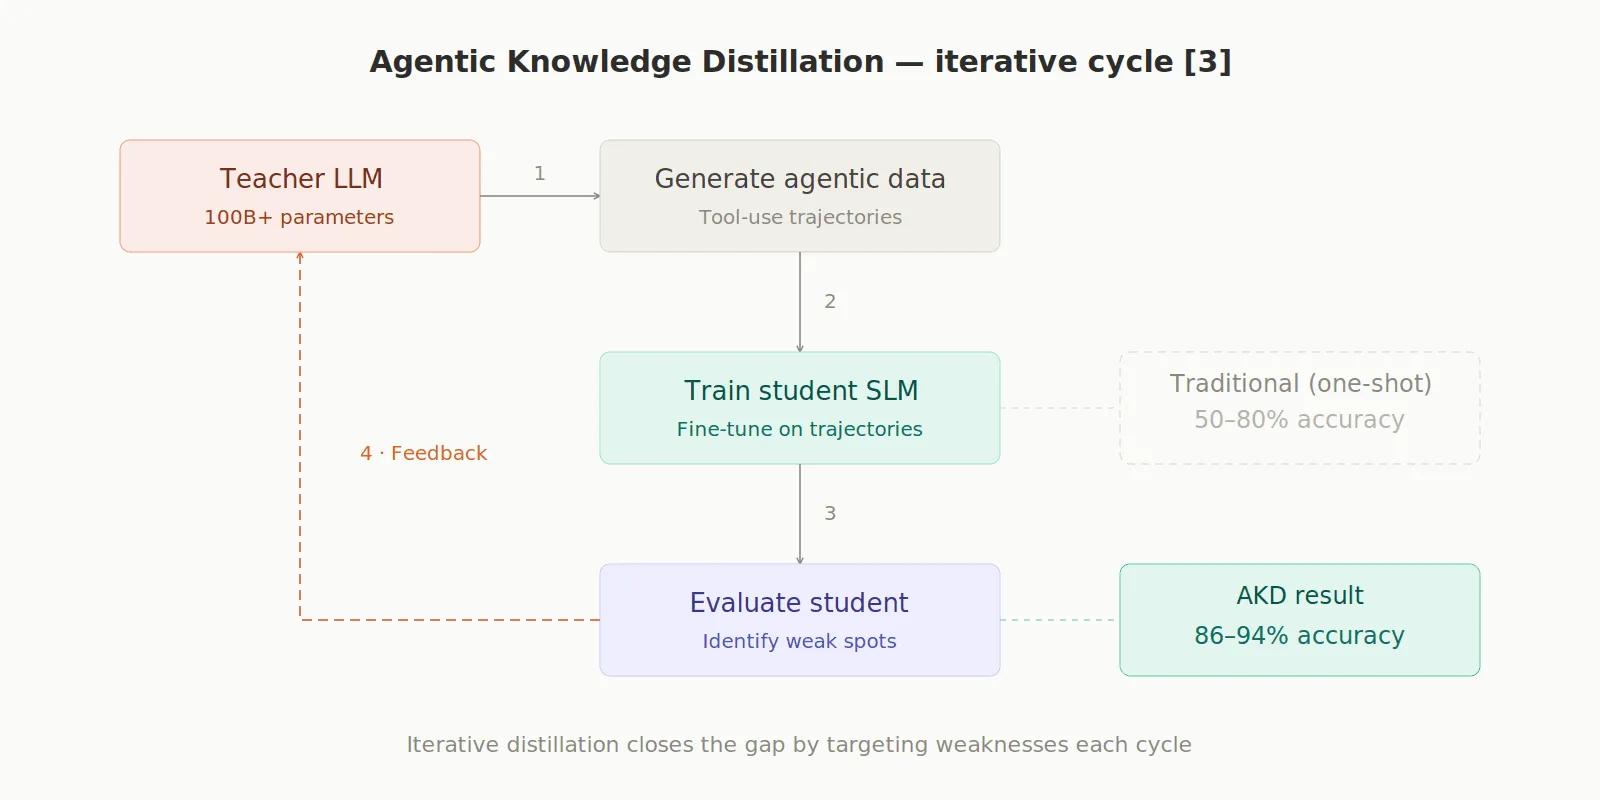
Agentic Knowledge Distillation(AKD):大規模LLMが「自律的な教師」として、データを生成し、小型モデルを評価し、反復的に学習させます。この方法で蒸留されたモデルは、セキュリティタスクで86〜94%の精度に達し、従来手法の50〜80%を上回ります。[3]
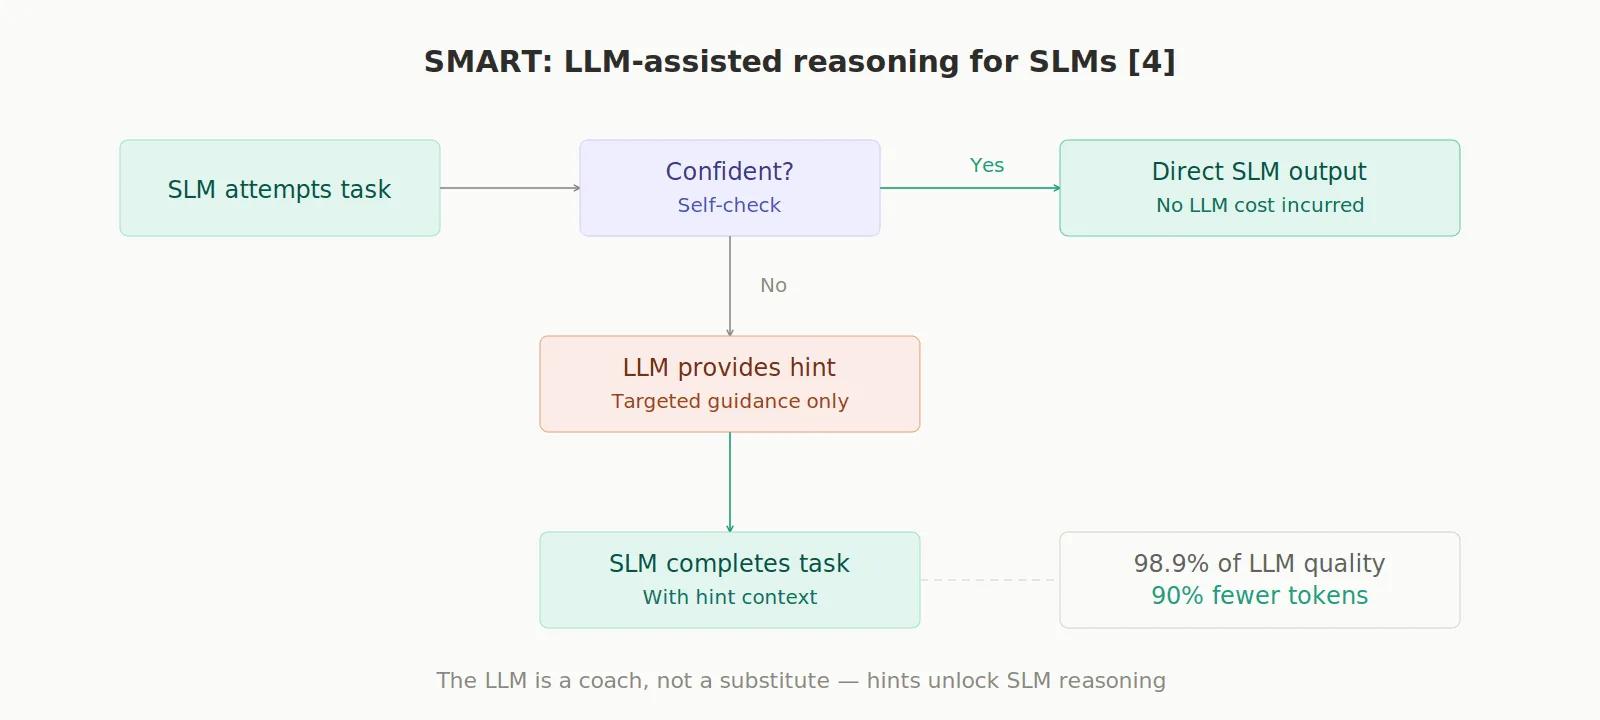
SMARTフレームワーク:SLMが複雑な推論で行き詰まったときだけ大規模LLMを呼び出し、すべてを解かせるのではなく、的を絞った「ヒント」を与えさせます。これにより、トークン使用量を90%削減しながら、大規模LLMの性能の98.9%を達成します。[4]
4. ベンチマーク
ベンチマークは、特定のタスクにおけるモデルの実力を見積もり、その信頼性を確かめるためのものです。
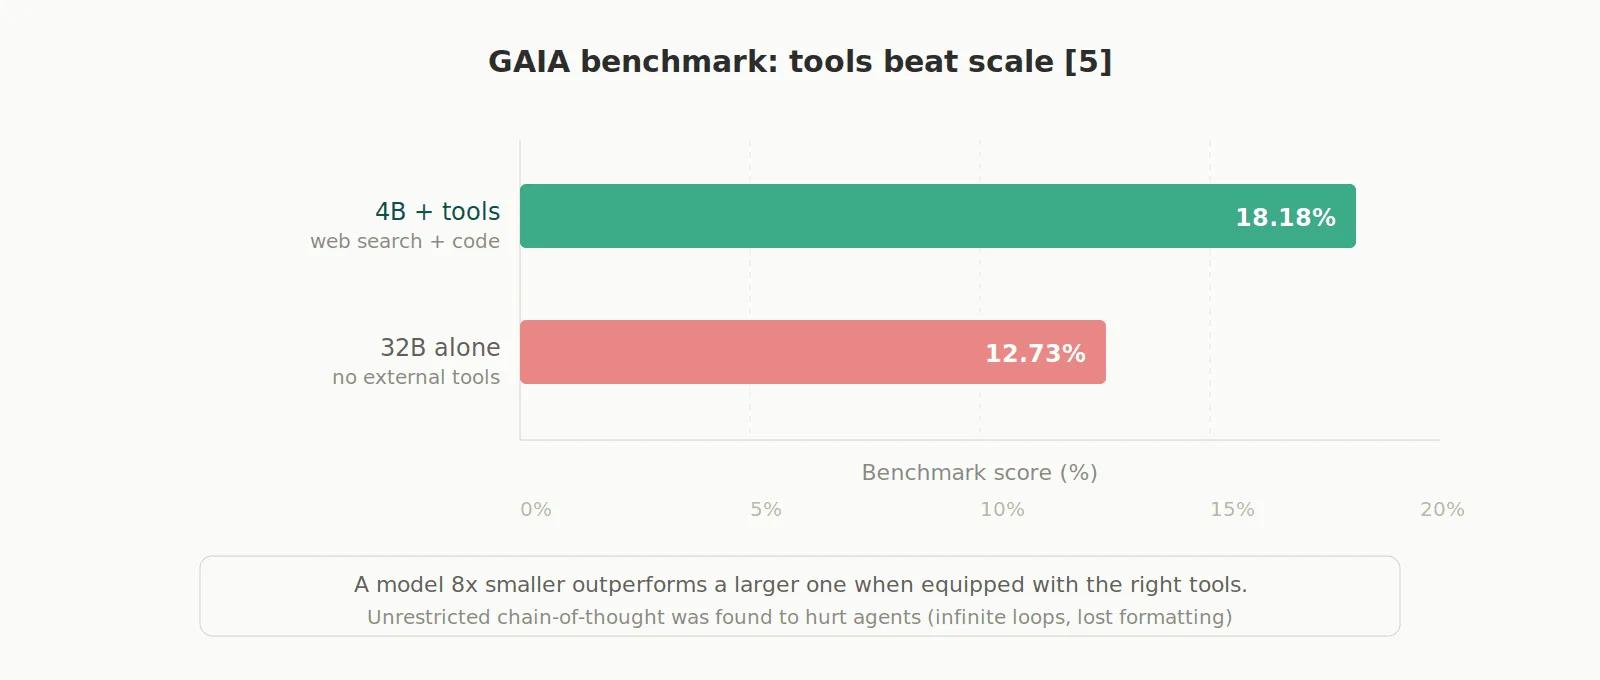
GAIAベンチマークでは、ツール(Web検索、コード実行)を備えた40億パラメータのモデルが、ツールなしの320億パラメータのモデルを上回りました(18.18%対12.73%)。さらに、制限のない「フルシンキング」(制約のないchain-of-thought)はエージェントにとってむしろ有害であることがわかりました。無限ループに陥ったり、フォーマットが崩れたりするためです。推論は計画フェーズに限定するほうが効果的です。[5]
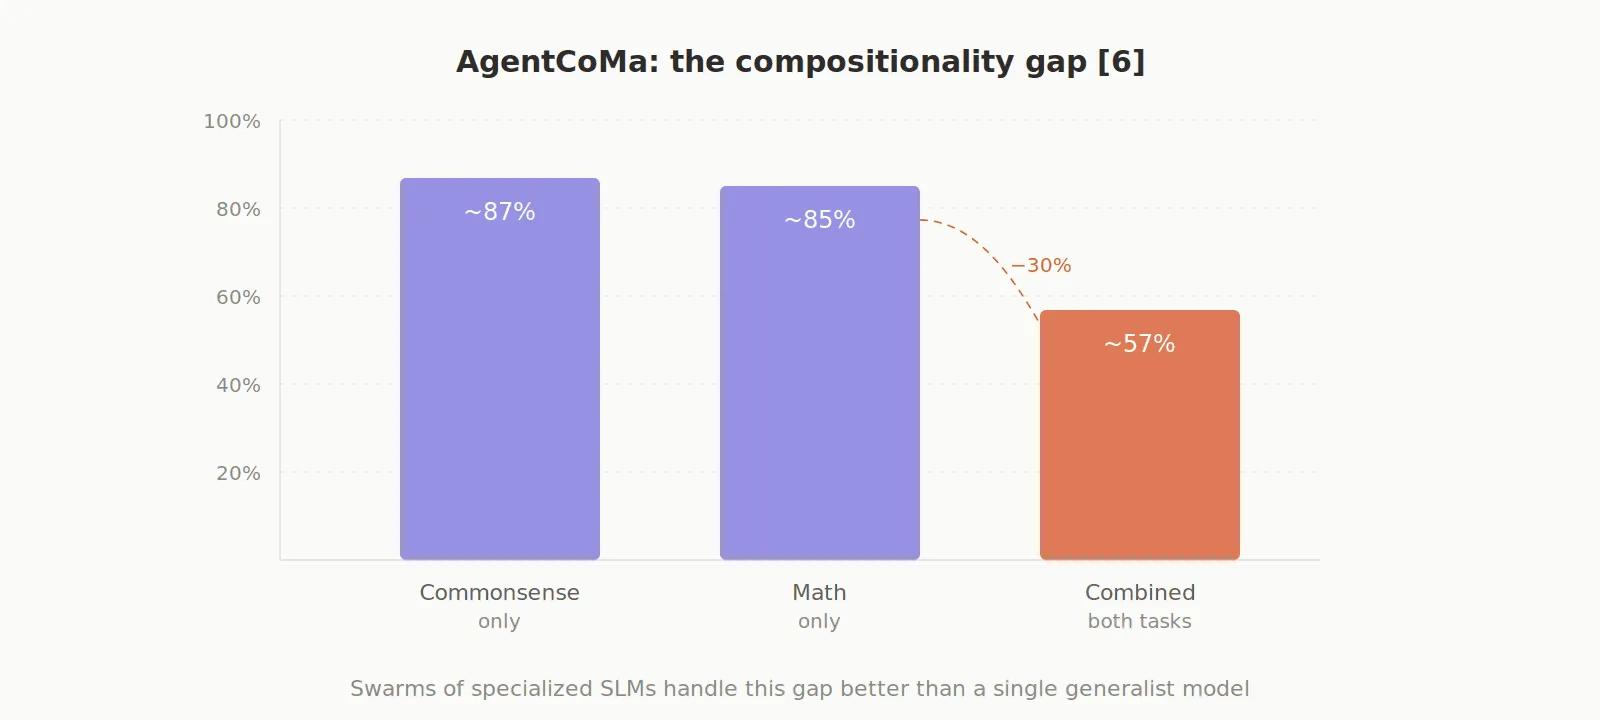
AgentCoMaベンチマークは、もう一つの課題である「合成性ギャップ」を明らかにしました。モデルは常識的推論のステップと数学のステップをそれぞれ単独では解けます(約85%以上)が、両者を1つのタスクで組み合わせると性能が約30%低下します。この課題には、単一の巨大な汎用モデルよりも、専門特化したSLMの群れのほうがうまく対処できます。[6]
5. マルチエージェントアーキテクチャ
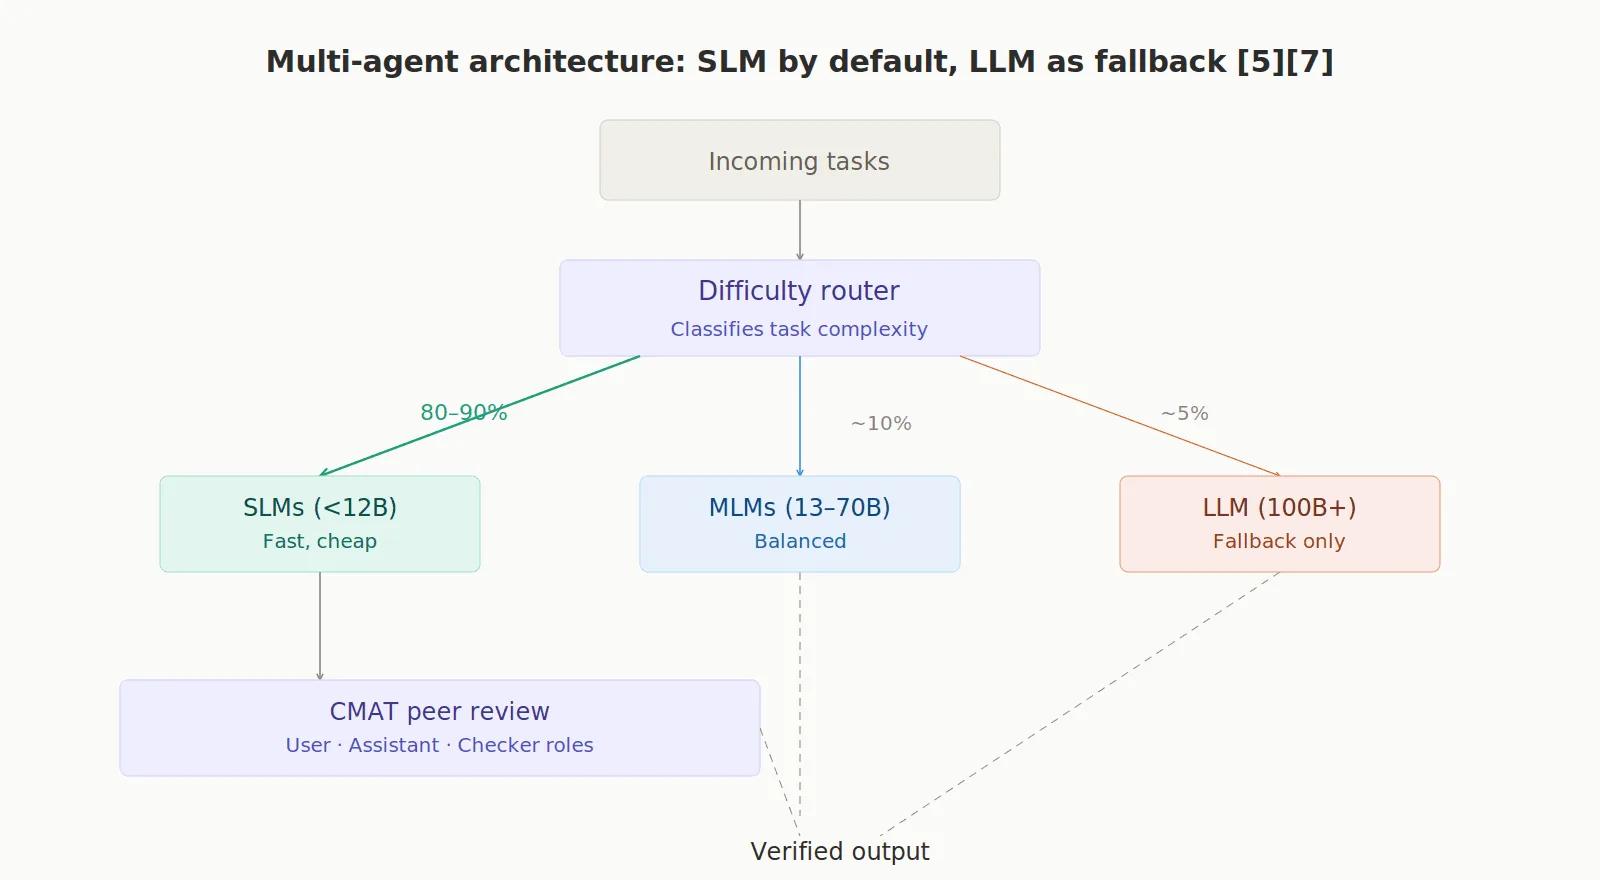
理想的な運用モデルは「基本はSLM、必要に応じてLLM」です。ルーターがタスクを難易度で分類し、簡単なものは低コストのSLMへ、中程度のものはMLMへ回し、本当に複雑なものだけを大規模LLMにエスカレーションします。これにより、ワークロードの80〜90%をSLMで処理できます。CMATのようなフレームワークでは、複数のSLMに役割(User、Assistant、Checker)を割り当て、互いにレビューさせます。[7]
6. セキュリティ
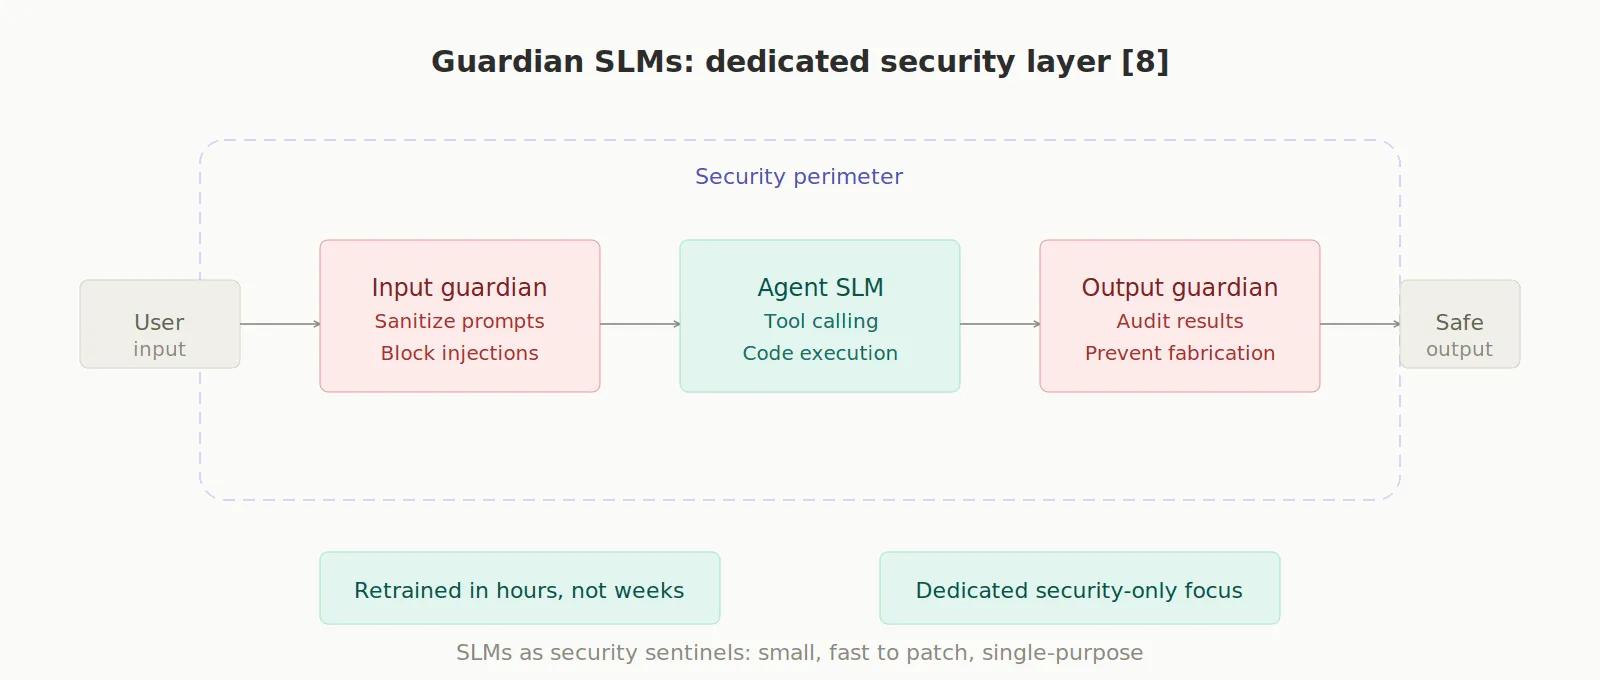
APIやデータベースにアクセスできる自律エージェントは、深刻な攻撃経路になり得ます。ここでSLMには強みがあります。数時間でパッチを当てて再学習できるのです。さらに「ガーディアンSLM」を導入することもできます。入力のサニタイズ、出力の監査、プロンプトインジェクションや記録の捏造の防止だけに特化したモデルです。[8]
まとめ
エージェント型AIの未来は、従来の巨大で中央集権的なモデルから離れる4つの原則によって形作られています。
第一に、コストとレイテンシのメリットが重視されています。小型モデル(10億〜700億パラメータのSLM/MLM)は、コストを大幅に削減し、速度を高め、エネルギー効率を向上させるため選ばれており、継続的で自律的な運用を現実的かつスケーラブルにします。
この効率性が、第二の原則である純粋な規模よりもツールによる拡張に直結します。優れた性能は、孤立したモデルをひたすら大きくすることではなく、小型モデルをプログラム的なツールと体系的に組み合わせることで生まれます。この相乗効果は、モノリシックなモデルを一貫して上回っています。
第三に、専門特化の必要性が明らかになっています。汎用モデルでは、多種多様な複雑な推論タスクに対応しきれません。効率的なルーティングの仕組みで賢く連携させた、専門特化型SLMの「群れ」こそが最も効果的な解決策です。
最後に、効率性におけるアーキテクチャの役割が極めて重要です。Extreme MoE、エージェント型蒸留、認知的スキャフォールディングといった高度な手法により、フロンティアモデルの知能と能力を、非常にコンパクトで効率的な実行エンジンに凝縮しています。
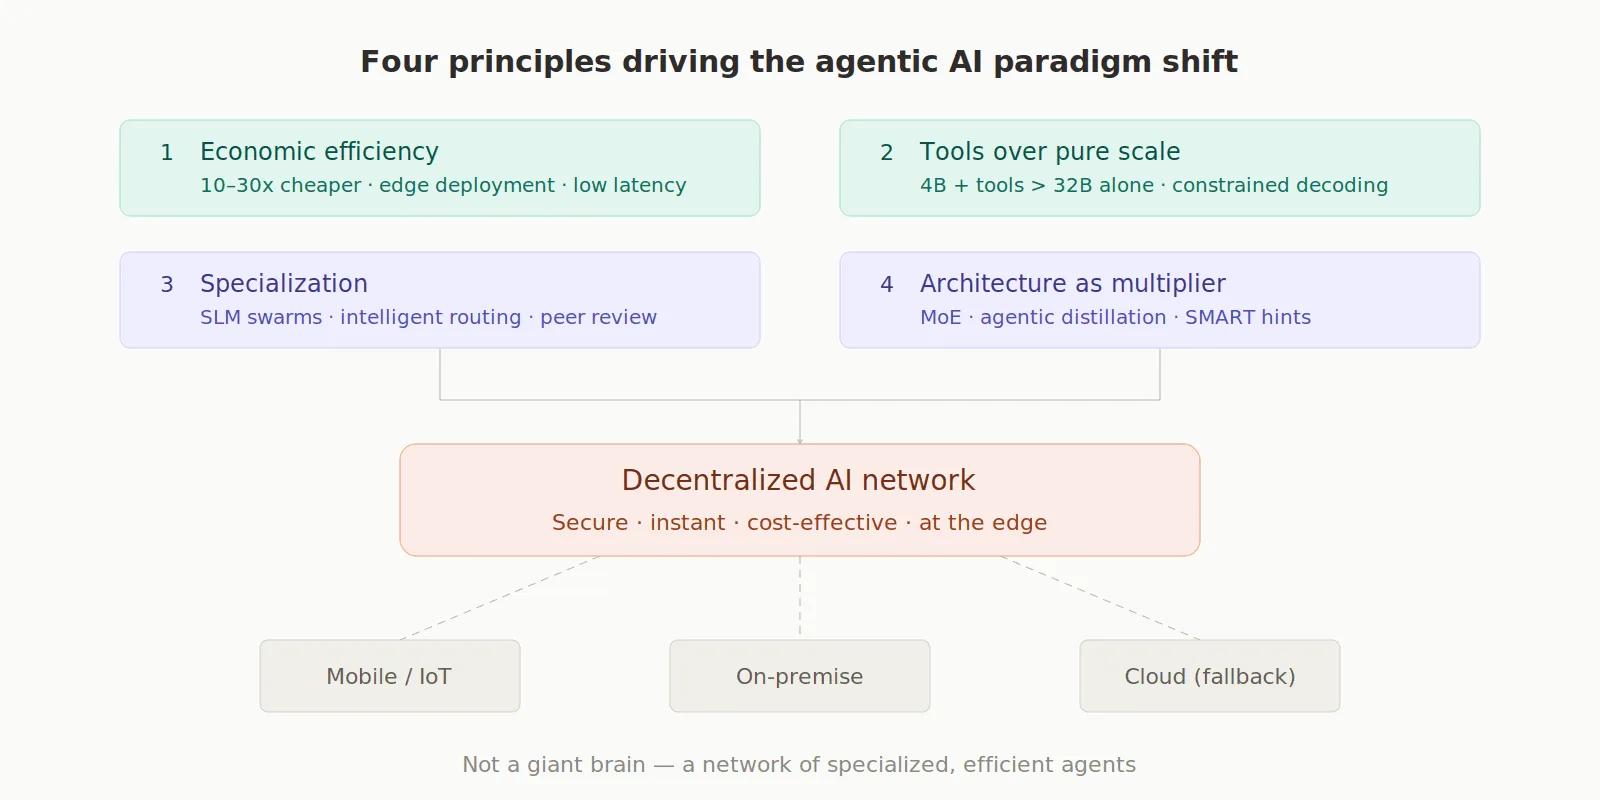
このパラダイムシフトが意味するのは、エージェント型AIの未来は中央集権的な「巨大な頭脳」ではなく、ネットワークのエッジで安全に、瞬時に、低コストで動作する小・中規模モデルの分散型ネットワークだということです。
参考文献
[1] Jhandi, P., Kazi, O., Subramanian, S., & Sendas, N. (2025). Small Language Models for Efficient Agentic Tool Calling: Outperforming Large Models with Targeted Fine-tuning. [効率的なエージェント型ツール呼び出しのための小規模言語モデル:的を絞ったファインチューニングで大規模モデルを上回る] arXiv:2512.15943. https://arxiv.org/abs/2512.15943
[2] Hu, Q., Lin, Z., Yang, Z., Ding, Y., Liu, X., Jiang, Y., Wang, R., Chen, T., Guo, Z., Xiong, Y., Gao, R., Qu, L., Su, J., Cheng, P., & Gong, Y. (2025). Sigma-MoE-Tiny Technical Report. [Sigma-MoE-Tiny 技術レポート] arXiv:2512.16248. https://arxiv.org/abs/2512.16248
[3] Kang, M., Jeong, J., Lee, S., Cho, J., & Hwang, S. J. (2025). Distilling LLM Agent into Small Models with Retrieval and Code Tools. [検索・コードツールを用いたLLMエージェントの小型モデルへの蒸留] arXiv:2505.17612. https://arxiv.org/abs/2505.17612
[4] Kim, Y., Yi, E., Kim, M., Yun, S.-Y., & Kim, T. (2025). Guiding Reasoning in Small Language Models with LLM Assistance. [LLMの支援による小規模言語モデルの推論誘導] arXiv:2504.09923. https://arxiv.org/abs/2504.09923
[5] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2026). Can Small Agent Collaboration Beat a Single Big LLM?. [小型エージェントの協調は単一の大規模LLMに勝てるか] arXiv:2601.11327. https://arxiv.org/abs/2601.11327
[6] Alazraki, L., Chen, L., Brassard, A., Stacey, J., Rahmani, H. A., & Rei, M. (2025). AgentCoMa: A Compositional Benchmark Mixing Commonsense and Mathematical Reasoning in Real-World Scenarios. [AgentCoMa:実世界シナリオにおける常識推論と数学的推論を組み合わせた合成的ベンチマーク] arXiv:2508.19988. https://arxiv.org/abs/2508.19988
[7] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2025). Route-and-Reason: Scaling Large Language Model Reasoning with Reinforced Model Router. [Route-and-Reason:強化学習型モデルルーターによるLLM推論のスケーリング] arXiv:2506.05901. https://arxiv.org/abs/2506.05901
[8] Evertz, J., Chlosta, M., Schönherr, L., & Eisenhofer, T. (2024). Whispers in the Machine: Confidentiality in Agentic Systems. [機械の中のささやき:エージェント型システムにおける機密性] arXiv:2402.06922. https://arxiv.org/abs/2402.06922
[9] Sharma, R. & Mehta, M. (2025). Small Language Models for Agentic Systems: A Survey of Architectures, Capabilities, and Deployment Trade-offs. [エージェント型システムのための小規模言語モデル:アーキテクチャ、能力、展開上のトレードオフに関するサーベイ] arXiv:2510.03847. https://arxiv.org/abs/2510.03847
[10] Belcak, P. et al. (2025). Small Language Models are the Future of Agentic AI. [小規模言語モデルはエージェント型AIの未来である] arXiv:2506.02153. https://arxiv.org/abs/2506.02153
