

Como modelos menores estão impulsionando a IA agêntica
 Toni Lopez Co-Founder at Karumi
A inteligência artificial está passando por uma mudança de paradigma. Durante anos, a lógica dominante foi “maior = melhor”: modelos com centenas de bilhões de parâmetros (LLMs de fronteira) tentando ser bons em tudo. E, sim, eles conquistaram coisas impressionantes em conversação geral e raciocínio. Mas o foco mudou. Não se trata mais apenas de responder perguntas, e sim de construir sistemas agênticos: IAs autônomas que planejam, chamam APIs, executam código, lidam com dados estruturados e tomam decisões encadeadas. Nesse contexto, os modelos gigantes se mostram caros, lentos e superdimensionados.
Este artigo defende que os Small Language Models (menos de 12B de parâmetros) e os Medium Language Models (de 13B a 70B de parâmetros) não são apenas suficientes para tarefas agênticas: com o treinamento certo e diferentes técnicas, eles podem até superar os maiores. Em próximos artigos, vamos destrinchar cada inovação e explicá-la de forma simples para todos. Hoje, queremos mostrar como e por que os modelos de linguagem pequenos e médios vão ser o próximo grande sucesso do setor.
1. Economia e eficiência operacional
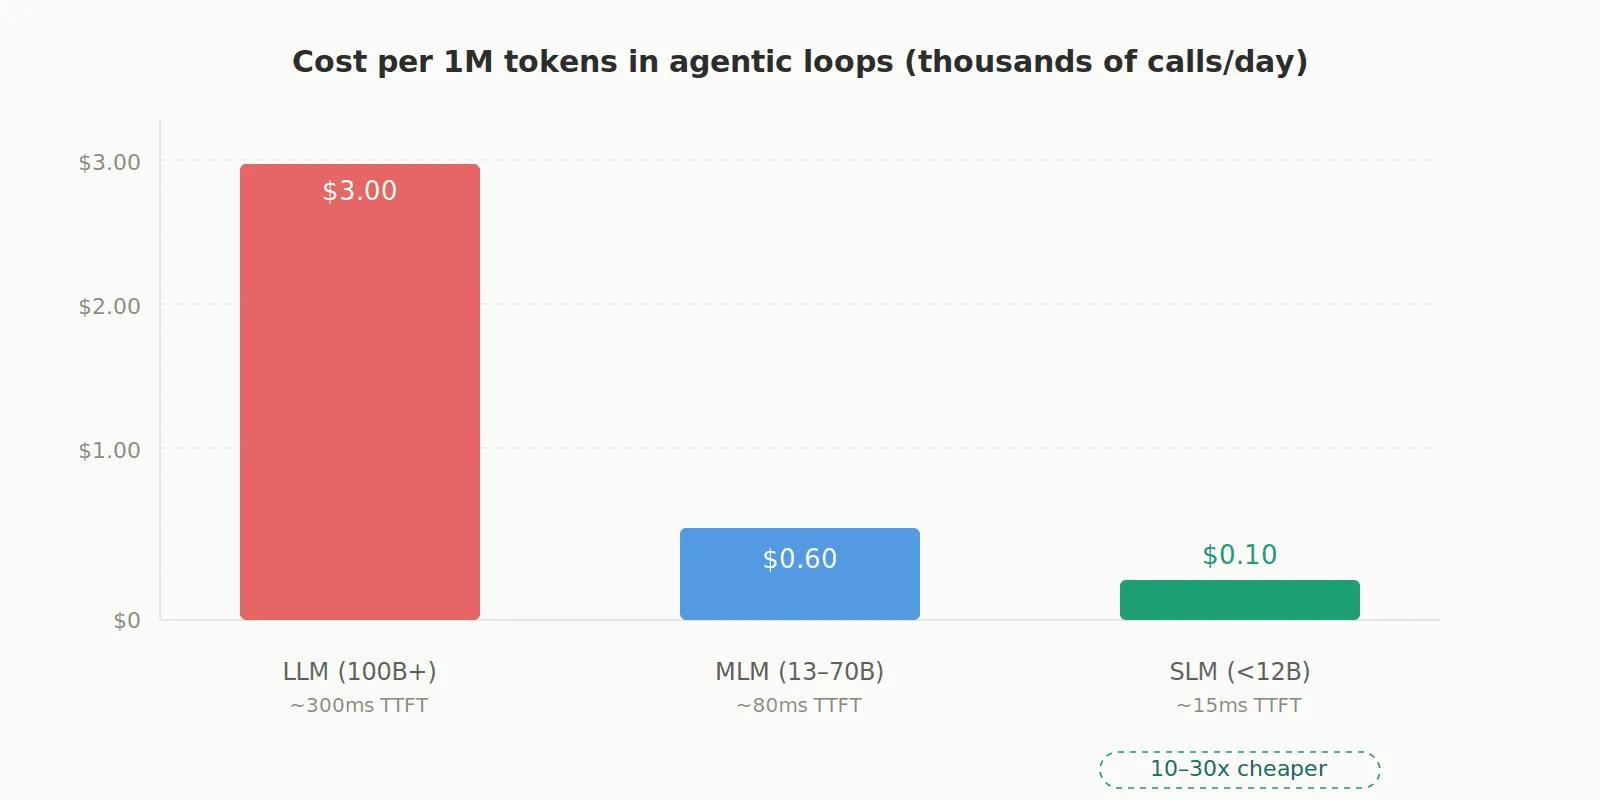
Sistemas agênticos não fazem uma única consulta: eles executam milhares de chamadas em loops curtos. Usar um modelo com mais de 100B de parâmetros para isso é como ir ao supermercado de Fórmula 1. SLMs são de 10 a 30 vezes mais baratos por token, têm latência mínima (time-to-first-token muito menor) e podem rodar até em CPUs ou dispositivos móveis. Isso também viabiliza o deploy na borda (edge): rodar a IA localmente, sem depender da nuvem, o que resolve questões de privacidade, soberania de dados e latência.
2. Habilidades agênticas não exigem escala massiva
Na prática, um modelo agêntico não precisa escrever poemas nem histórias. O que um agente precisa, em poucas palavras, é: chamadas de função corretas, geração de JSON válido, aderência estrita ao schema e a possibilidade de executar código. Hoje os SLMs já geram saídas formatadas perfeitamente; os exemplos que encontrei usam técnicas de decodificação restrita (XGrammar e Outlines são bibliotecas que oferecem técnicas como essa), permitindo que os SLMs fechem a distância para os modelos de fronteira.
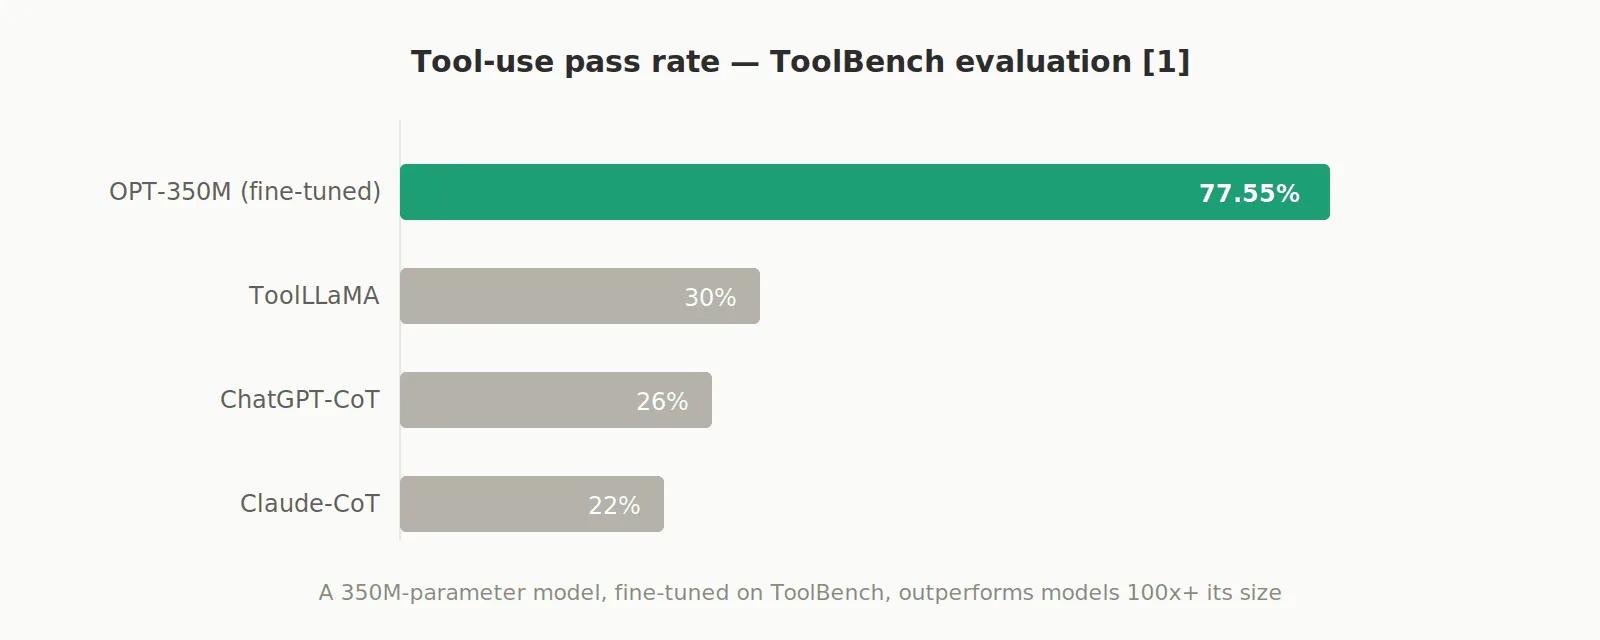
Um exemplo: um modelo com apenas 350 milhões de parâmetros (OPT-350M), ajustado com dados do ToolBench, alcançou uma taxa de acerto de 77,55% em avaliações de uso de ferramentas, deixando para trás ChatGPT-CoT (26%), ToolLLaMA (30%) e Claude-CoT [1].
3. Principais inovações de arquitetura
Algumas arquiteturas já são bem conhecidas no setor, mas o interessante é a forma como estão sendo aplicadas para obter melhor desempenho com SLMs.
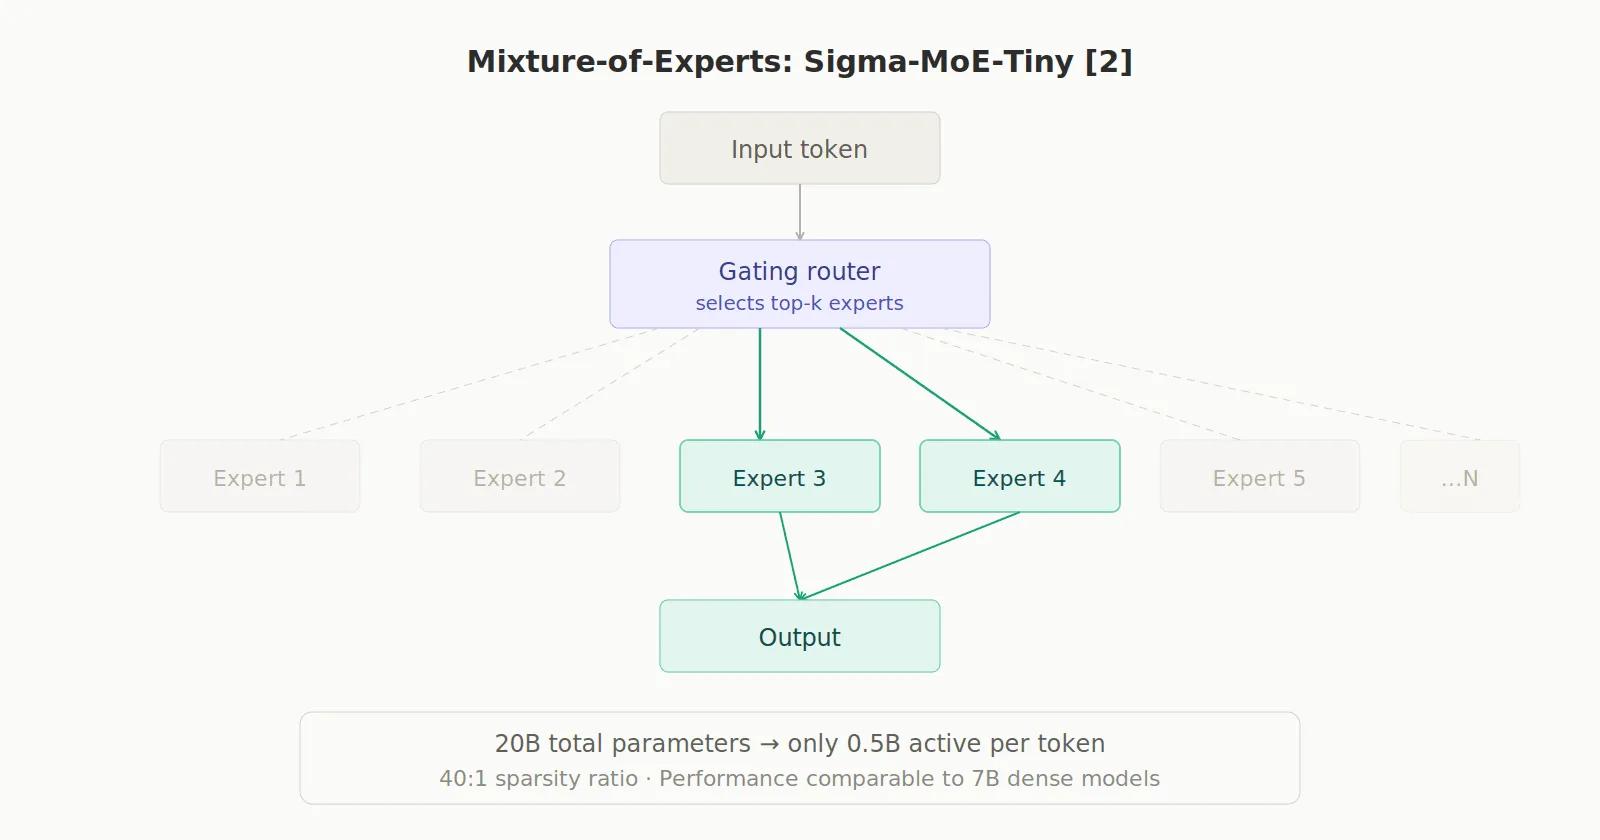
Mixture-of-Experts (MoE): modelos como o Sigma-MoE-Tiny têm 20B de parâmetros no total, mas ativam apenas 0,5B por token (uma proporção de 40:1). Assim, alcançam desempenho comparável ao de modelos densos de 7B em matemática e programação, com uma fração do processamento. [2]
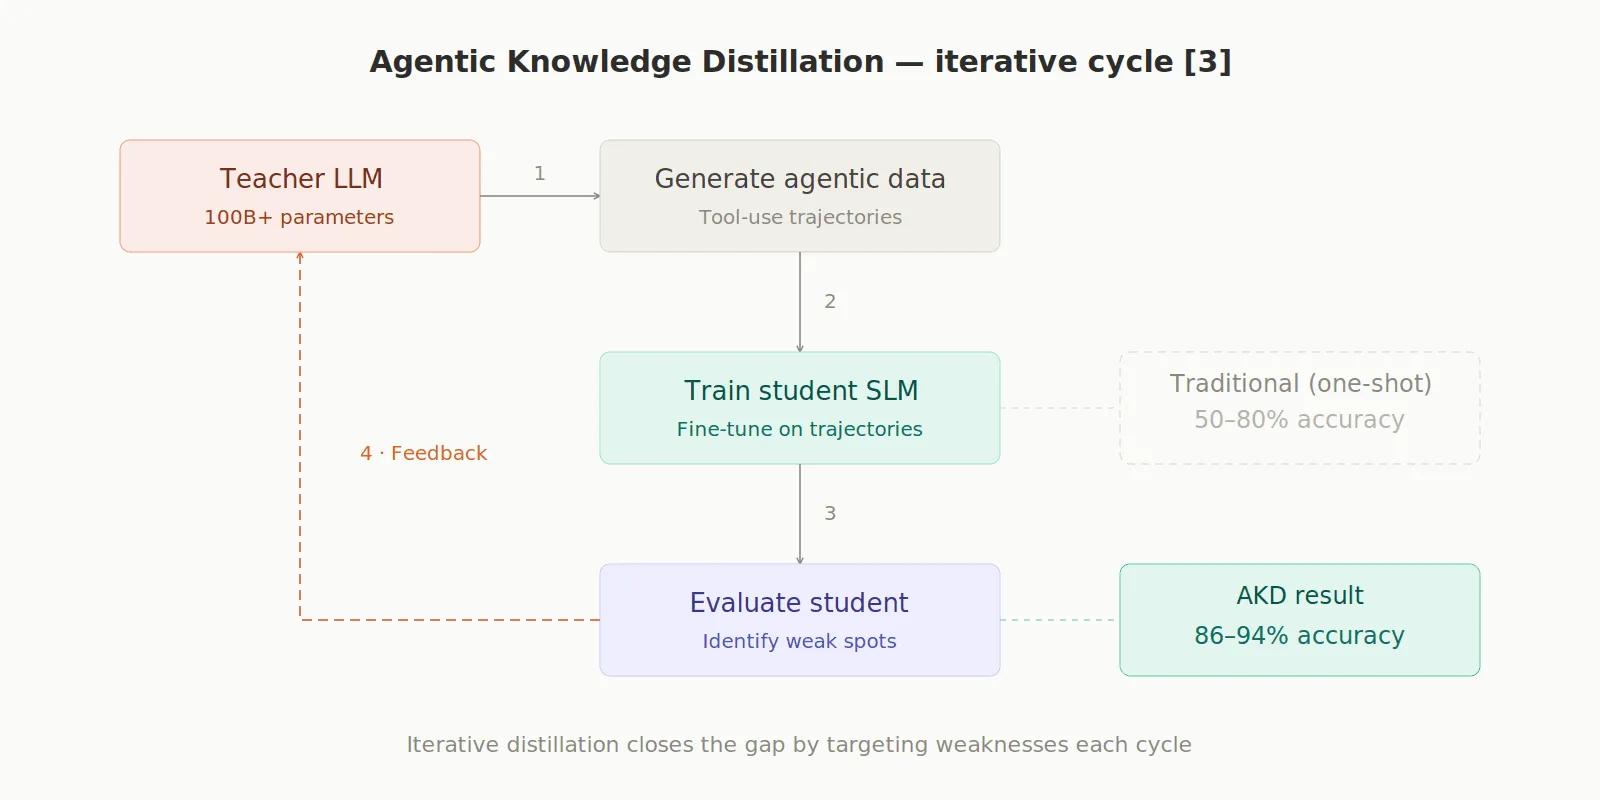
Agentic Knowledge Distillation (AKD): um LLM grande atua como “professor autônomo” que gera dados, avalia o modelo pequeno e o treina de forma iterativa. Modelos destilados dessa forma chegam a 86–94% de precisão em tarefas de segurança, contra 50–80% com métodos tradicionais. [3]
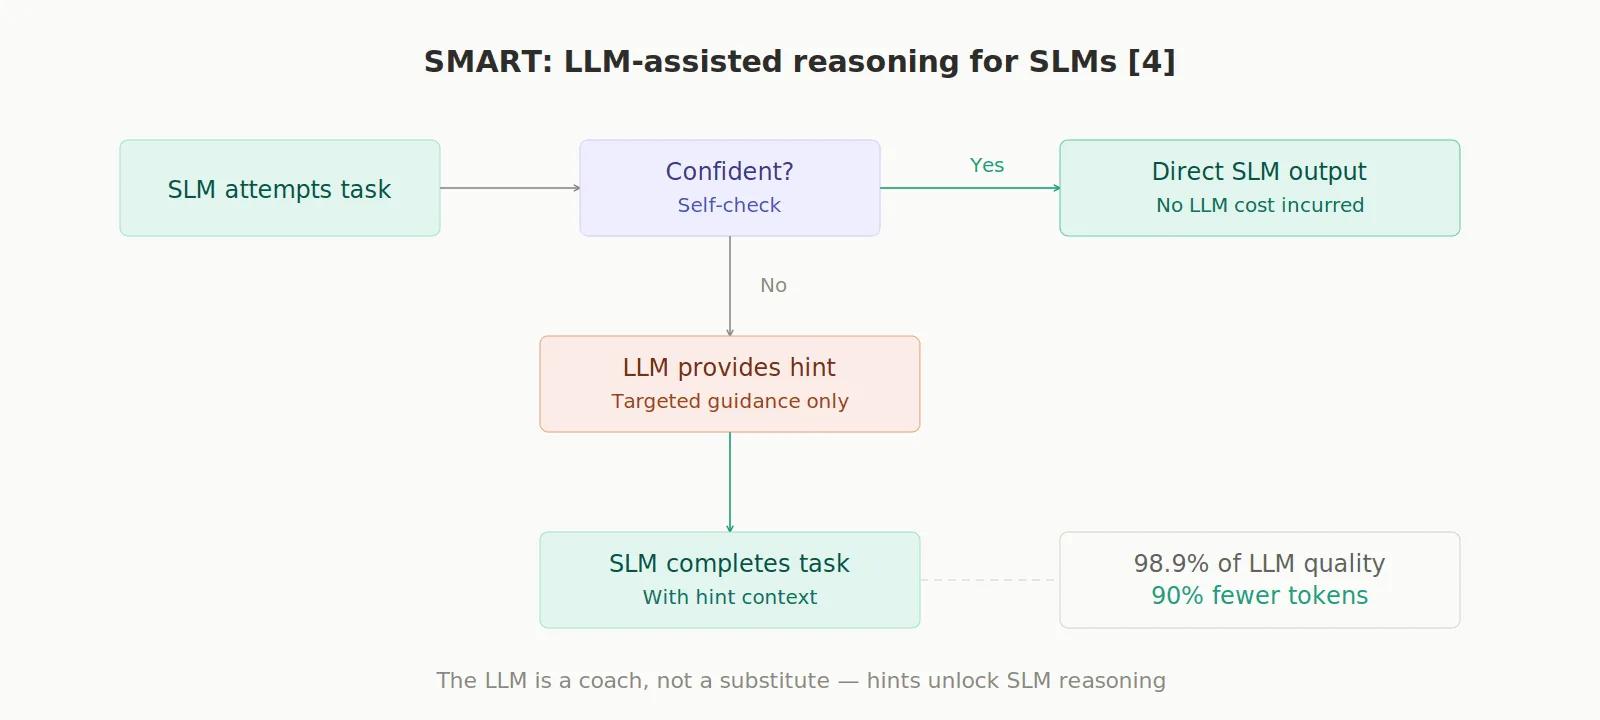
Framework SMART: quando um SLM trava em um raciocínio complexo, o LLM grande só é acionado para dar uma “dica” pontual, e não para resolver tudo. Isso atinge 98,9% do desempenho do LLM grande usando 90% menos tokens. [4]
4. Benchmarks
Benchmarks permitem estimar o quanto os modelos são bons em tarefas específicas, garantindo sua confiabilidade.
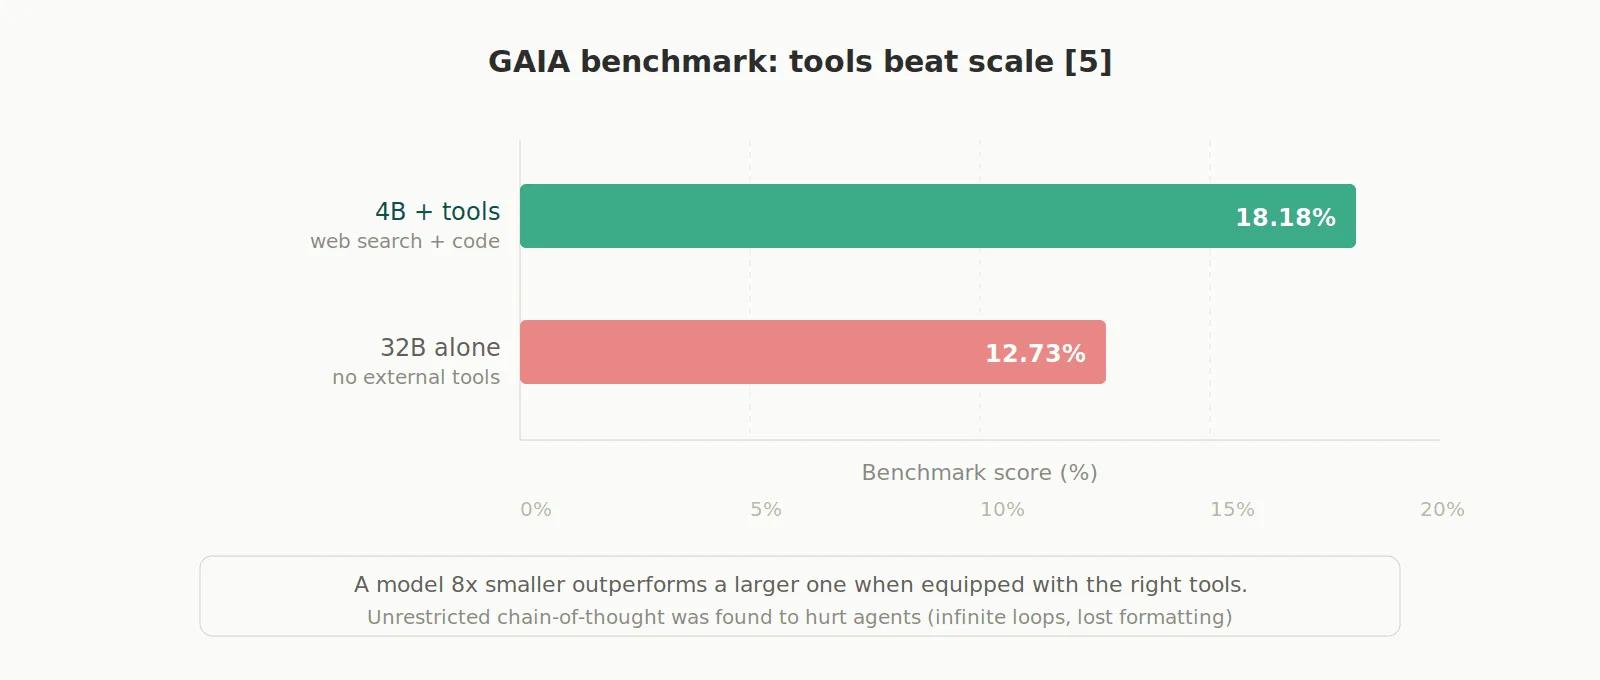
No benchmark GAIA, modelos de 4B de parâmetros com ferramentas (busca na web, execução de código) superaram modelos de 32B sem ferramentas (18,18% vs. 12,73%). Além disso, constatou-se que o “pensamento completo” irrestrito (chain-of-thought sem limites) chega a prejudicar os agentes: faz com que entrem em loops infinitos e percam a formatação. É melhor limitar o raciocínio apenas à fase de planejamento. [5]
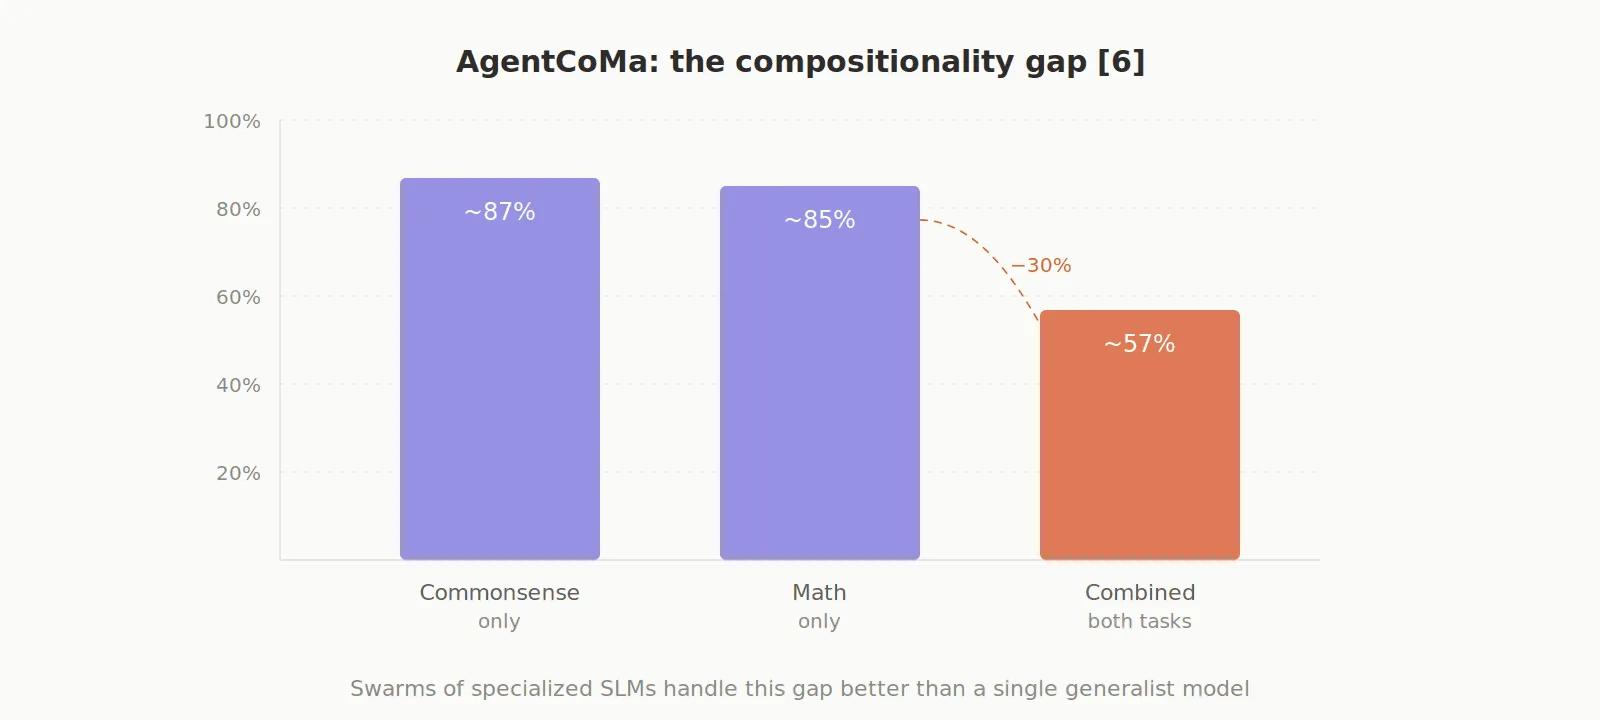
O benchmark AgentCoMa expôs outro problema: a lacuna de composicionalidade. Os modelos resolvem separadamente etapas de senso comum e etapas matemáticas (~85% ou mais), mas quando as duas são combinadas em uma única tarefa, o desempenho cai cerca de 30%. Um enxame de SLMs especializados lida melhor com isso do que um único modelo generalista gigante. [6]
5. Arquiteturas multiagente
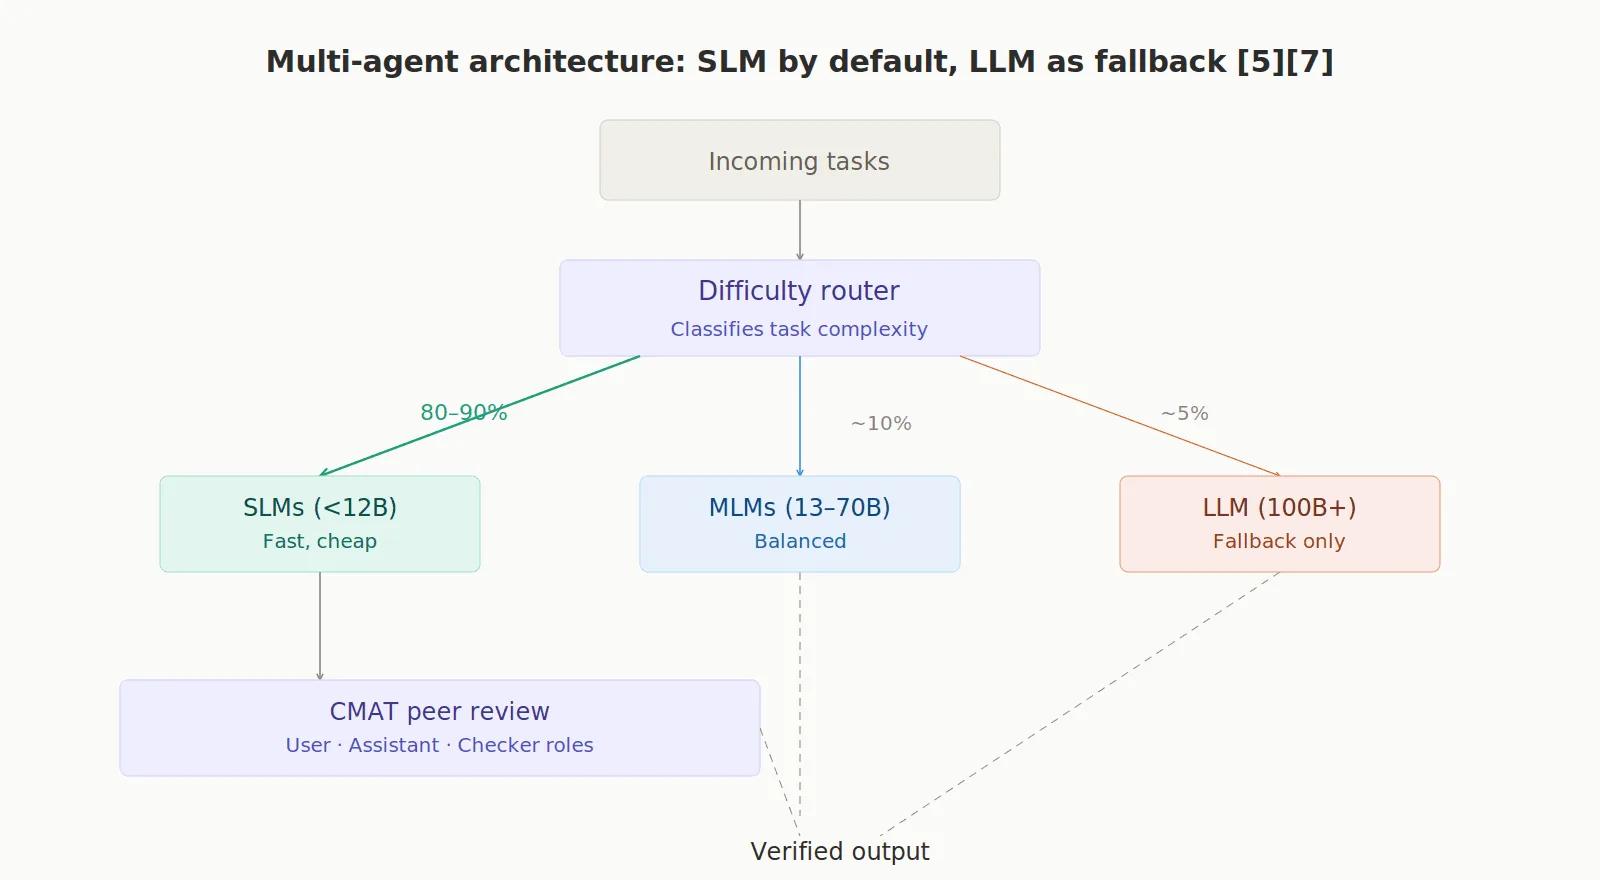
O modelo operacional ideal é “SLM por padrão, LLM como fallback”. Um roteador classifica as tarefas por dificuldade: as fáceis vão para SLMs baratos, as intermediárias para MLMs e só as realmente complexas sobem para o LLM grande. Assim, 80–90% da carga de trabalho fica com os SLMs. Frameworks como o CMAT atribuem papéis (User, Assistant, Checker) a diferentes SLMs, que revisam o trabalho uns dos outros. [7]
6. Segurança
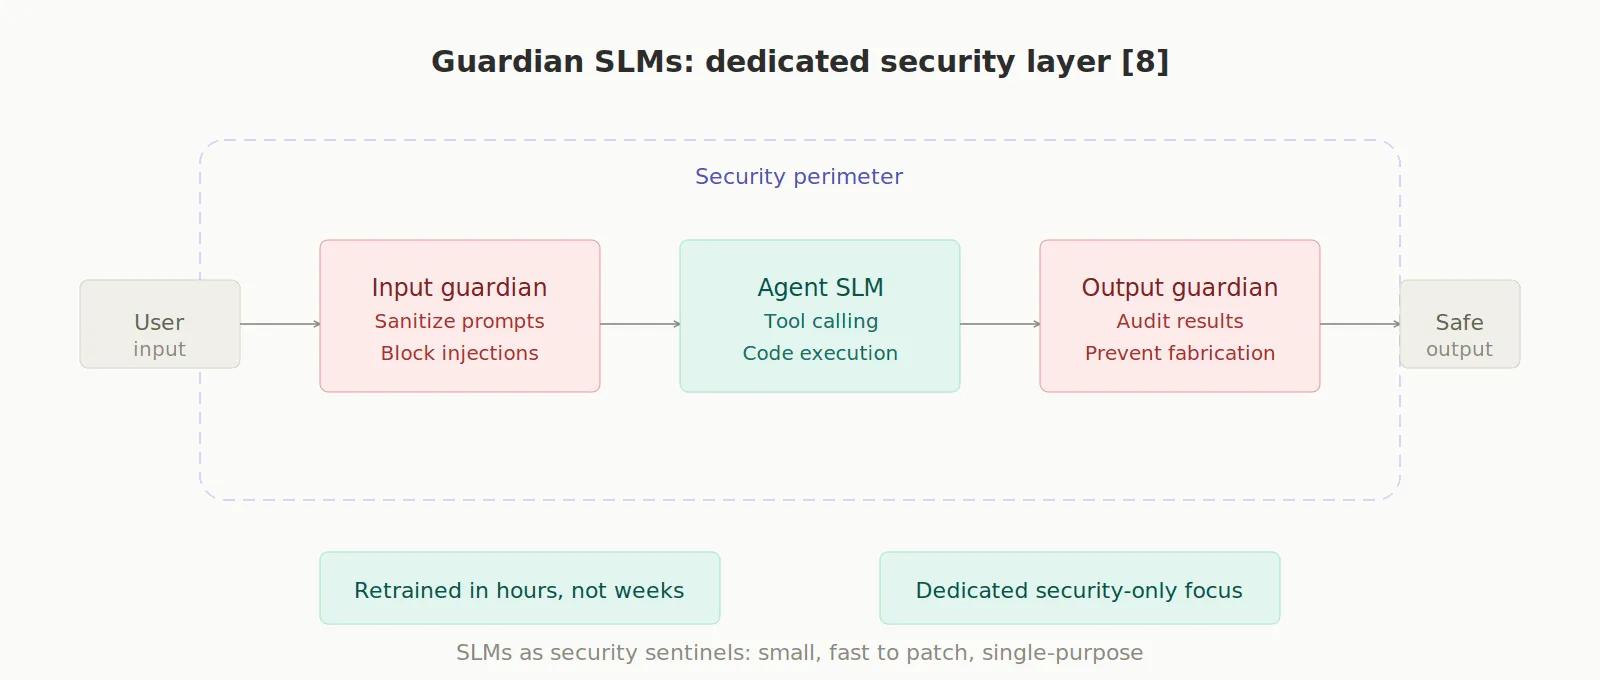
Agentes autônomos com acesso a APIs e bancos de dados são vetores de ataque sérios. Aqui os SLMs têm uma vantagem: podem ser corrigidos e retreinados em poucas horas. Além disso, é possível implantar “SLMs guardiões”: modelos dedicados exclusivamente a higienizar entradas, auditar saídas e impedir prompt injections e a fabricação de registros. [8]
Conclusão
O futuro da IA agêntica é guiado por quatro princípios-chave que se afastam do tradicional modelo gigante e centralizado.
Primeiro, há um forte foco nos benefícios econômicos e de latência: modelos menores (SLMs/MLMs, de 1B a 70B de parâmetros) são preferidos porque reduzem drasticamente o custo, aumentam a velocidade e melhoram a eficiência energética, tornando viável e escalável uma operação autônoma e contínua.
Essa eficiência leva diretamente ao segundo princípio, que enfatiza ampliar com ferramentas em vez de apostar só em escala: o desempenho superior não vem de modelos isolados cada vez maiores, e sim da integração sistemática de modelos menores com ferramentas programáticas, uma sinergia que supera consistentemente os modelos monolíticos.
Terceiro, a necessidade de especialização fica evidente: modelos de uso geral se mostram insuficientes diante da enorme variedade de tarefas de raciocínio complexo. Um “enxame” de SLMs especializados, coordenados de forma inteligente por um mecanismo de roteamento eficiente, é a solução mais eficaz.
Por fim, o papel da arquitetura na eficiência é fundamental: técnicas avançadas como Extreme MoE, destilação agêntica e scaffolding cognitivo são usadas para comprimir a inteligência e as capacidades dos modelos de fronteira em motores de execução altamente compactos e eficientes.
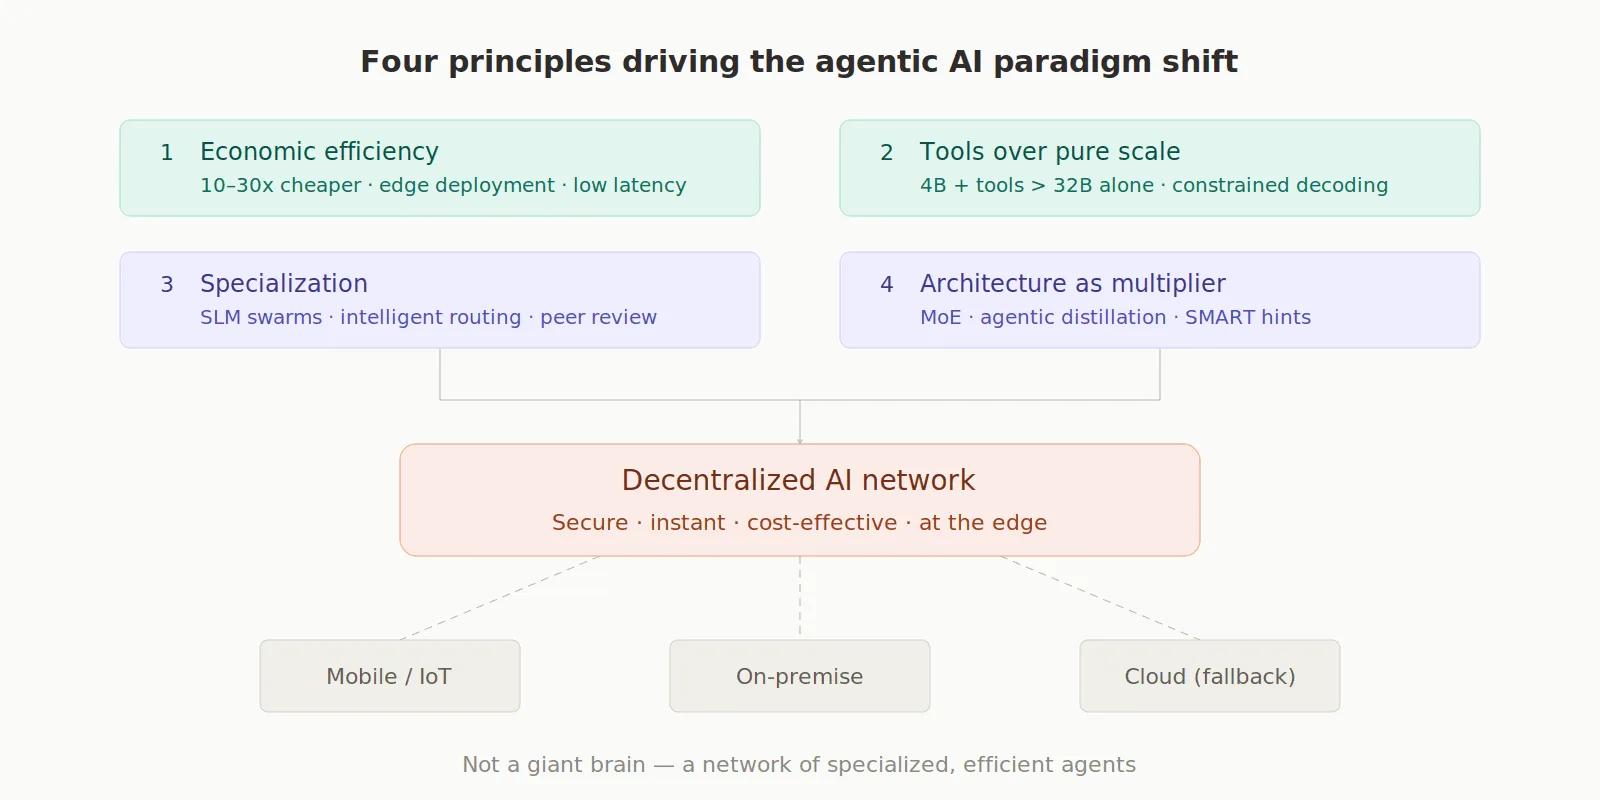
Essa mudança de paradigma significa que o futuro da IA agêntica não é um “cérebro gigante” centralizado, e sim uma rede descentralizada de modelos pequenos e médios operando de forma segura, instantânea e econômica na borda da rede.
Referências
[1] Jhandi, P., Kazi, O., Subramanian, S., & Sendas, N. (2025). Small Language Models for Efficient Agentic Tool Calling: Outperforming Large Models with Targeted Fine-tuning. [Modelos de linguagem pequenos para chamadas de ferramentas agênticas eficientes: superando modelos grandes com fine-tuning direcionado] arXiv:2512.15943. https://arxiv.org/abs/2512.15943
[2] Hu, Q., Lin, Z., Yang, Z., Ding, Y., Liu, X., Jiang, Y., Wang, R., Chen, T., Guo, Z., Xiong, Y., Gao, R., Qu, L., Su, J., Cheng, P., & Gong, Y. (2025). Sigma-MoE-Tiny Technical Report. [Relatório técnico do Sigma-MoE-Tiny] arXiv:2512.16248. https://arxiv.org/abs/2512.16248
[3] Kang, M., Jeong, J., Lee, S., Cho, J., & Hwang, S. J. (2025). Distilling LLM Agent into Small Models with Retrieval and Code Tools. [Destilando um agente LLM em modelos pequenos com ferramentas de busca e de código] arXiv:2505.17612. https://arxiv.org/abs/2505.17612
[4] Kim, Y., Yi, E., Kim, M., Yun, S.-Y., & Kim, T. (2025). Guiding Reasoning in Small Language Models with LLM Assistance. [Orientando o raciocínio de modelos de linguagem pequenos com ajuda de um LLM] arXiv:2504.09923. https://arxiv.org/abs/2504.09923
[5] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2026). Can Small Agent Collaboration Beat a Single Big LLM?. [A colaboração entre agentes pequenos pode vencer um único LLM grande?] arXiv:2601.11327. https://arxiv.org/abs/2601.11327
[6] Alazraki, L., Chen, L., Brassard, A., Stacey, J., Rahmani, H. A., & Rei, M. (2025). AgentCoMa: A Compositional Benchmark Mixing Commonsense and Mathematical Reasoning in Real-World Scenarios. [AgentCoMa: um benchmark composicional que combina senso comum e raciocínio matemático em cenários reais] arXiv:2508.19988. https://arxiv.org/abs/2508.19988
[7] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2025). Route-and-Reason: Scaling Large Language Model Reasoning with Reinforced Model Router. [Route-and-Reason: escalando o raciocínio de LLMs com um roteador de modelos reforçado] arXiv:2506.05901. https://arxiv.org/abs/2506.05901
[8] Evertz, J., Chlosta, M., Schönherr, L., & Eisenhofer, T. (2024). Whispers in the Machine: Confidentiality in Agentic Systems. [Sussurros na máquina: confidencialidade em sistemas agênticos] arXiv:2402.06922. https://arxiv.org/abs/2402.06922
[9] Sharma, R. & Mehta, M. (2025). Small Language Models for Agentic Systems: A Survey of Architectures, Capabilities, and Deployment Trade-offs. [Modelos de linguagem pequenos para sistemas agênticos: um panorama de arquiteturas, capacidades e trade-offs de implantação] arXiv:2510.03847. https://arxiv.org/abs/2510.03847
[10] Belcak, P. et al. (2025). Small Language Models are the Future of Agentic AI. [Modelos de linguagem pequenos são o futuro da IA agêntica] arXiv:2506.02153. https://arxiv.org/abs/2506.02153
