

Cómo los modelos pequeños impulsan la IA agéntica
 Toni Lopez Co-Founder at Karumi
La inteligencia artificial está viviendo un cambio de paradigma. Durante años, la lógica dominante fue «más grande = mejor»: modelos con cientos de miles de millones de parámetros (LLM de frontera) que intentaban ser buenos en todo. Y sí, lograron cosas impresionantes en conversación general y razonamiento. Pero el foco ha cambiado. Ya no se trata solo de responder preguntas, sino de construir sistemas agénticos: IA autónomas que planifican, llaman a API, ejecutan código, manejan datos estructurados y toman decisiones encadenadas. En ese contexto, los modelos masivos resultan caros, lentos y sobredimensionados.
En este artículo defendemos que los Small Language Models (menos de 12B de parámetros) y los Medium Language Models (de 13B a 70B de parámetros) no solo son suficientes para tareas agénticas: con el entrenamiento adecuado y distintas técnicas, pueden incluso superar a los más grandes. En próximos artículos analizaremos a fondo cada innovación y la explicaremos de forma sencilla para todos. Hoy queremos mostrar cómo y por qué los modelos de lenguaje pequeños y medianos van a ser el próximo gran éxito del sector.
1. Economía y eficiencia operativa
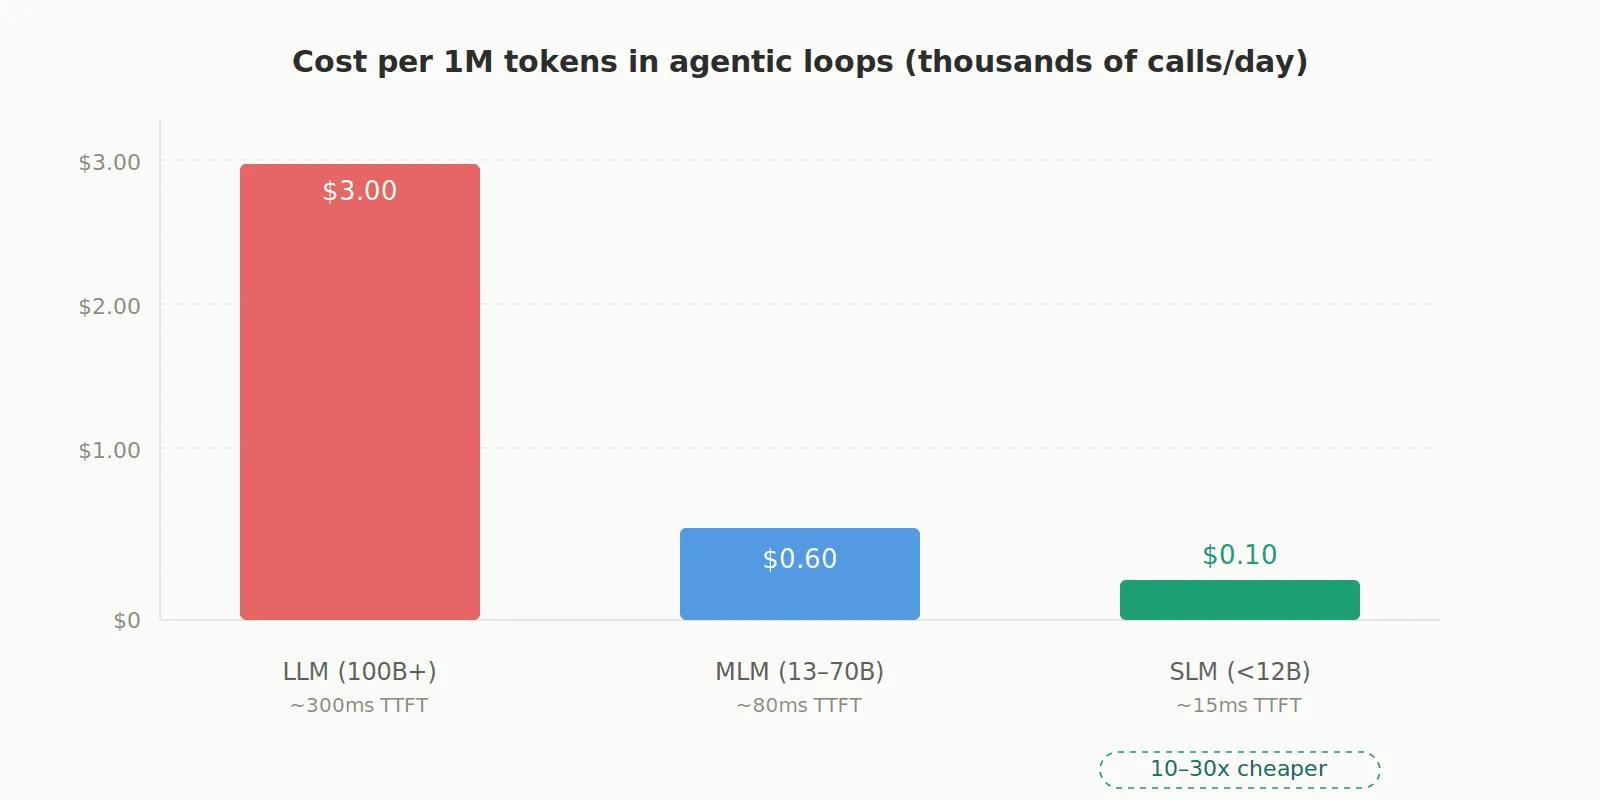
Los sistemas agénticos no hacen una sola consulta: ejecutan miles de llamadas en bucles cerrados. Usar un modelo de más de 100B de parámetros para eso es como ir al súper en un Fórmula 1. Los SLM son entre 10 y 30 veces más baratos por token, tienen una latencia mínima (un time-to-first-token mucho menor) y pueden funcionar incluso en CPU o en dispositivos móviles. Además, permiten el despliegue en el edge: ejecutar la IA en local sin depender de la nube, lo que resuelve problemas de privacidad, soberanía de datos y latencia.
2. Las habilidades agénticas no requieren una escala masiva
La realidad es que un modelo agéntico no necesita escribir poemas ni cuentos. Lo que necesita un agente, en pocas palabras, es: llamadas a funciones correctas, generación de JSON válido, cumplimiento estricto del esquema y la posibilidad de ejecutar código. Hoy los SLM pueden generar salidas con formato perfectamente; los ejemplos que encontré usan técnicas de decodificación restringida (XGrammar u Outlines son librerías que ofrecen técnicas como esta), lo que permite a los SLM cerrar la brecha con los modelos de frontera.
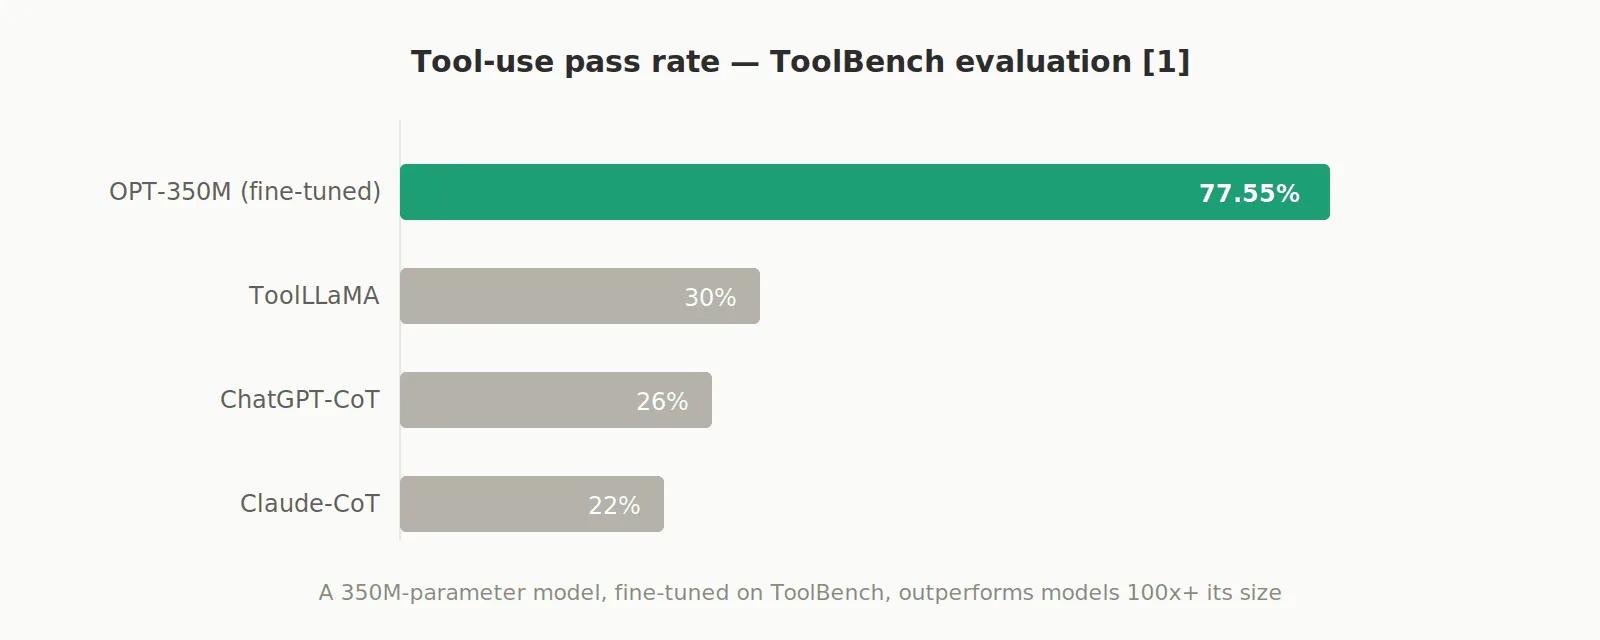
Un ejemplo: un modelo de solo 350 millones de parámetros (OPT-350M), ajustado con datos de ToolBench, alcanzó una tasa de acierto del 77,55 % en evaluaciones de uso de herramientas, muy por encima de ChatGPT-CoT (26 %), ToolLLaMA (30 %) y Claude-CoT [1].
3. Innovaciones clave de arquitectura
Hay arquitecturas muy conocidas en el sector, pero lo interesante es cómo se están aplicando para lograr un mejor rendimiento con SLM.
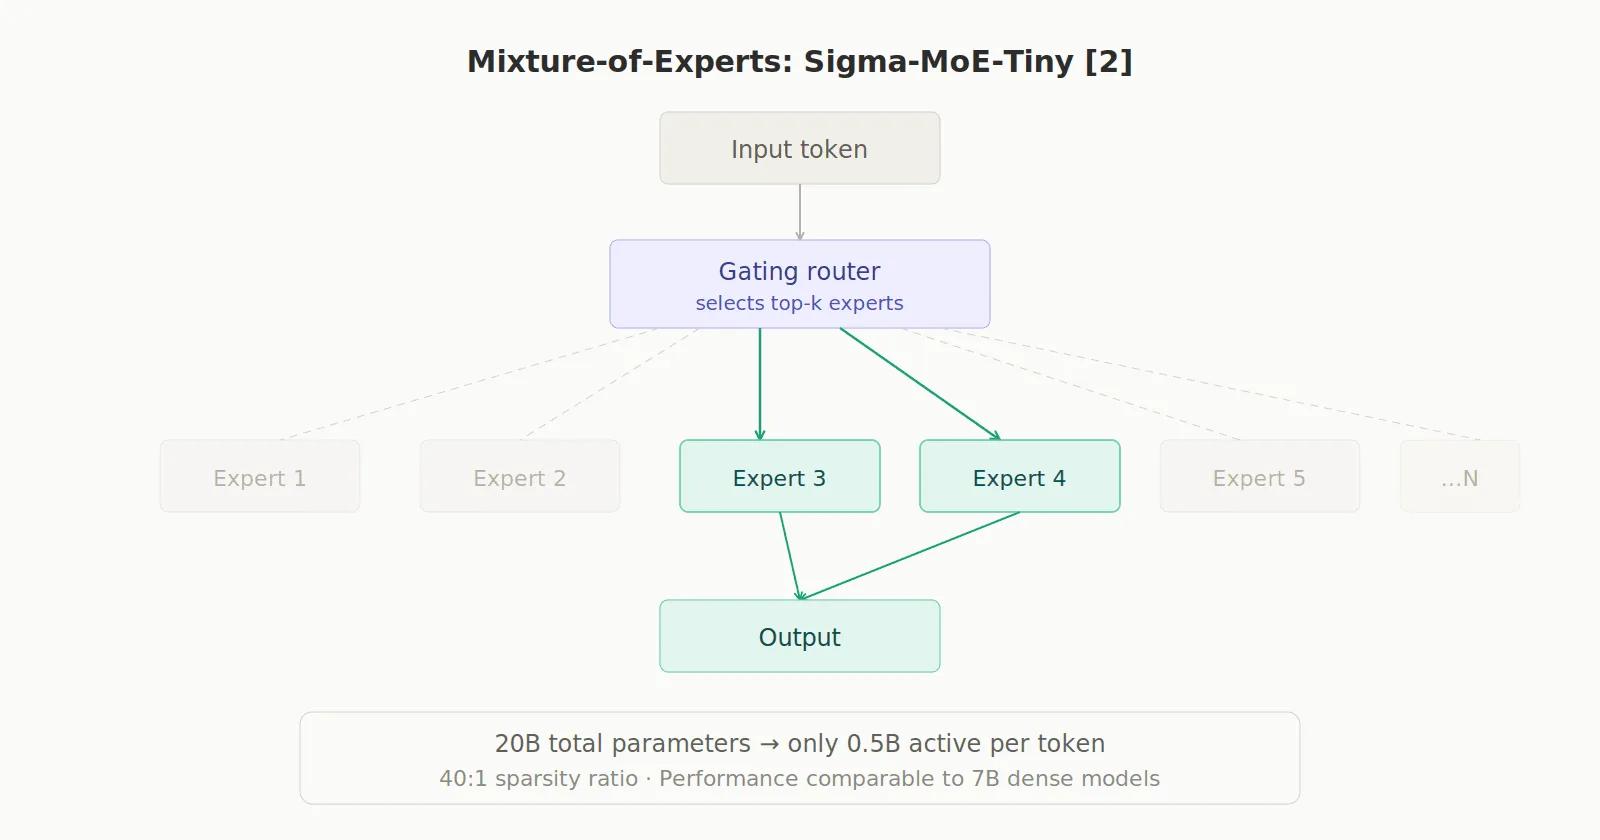
Mixture-of-Experts (MoE): modelos como Sigma-MoE-Tiny tienen 20B de parámetros en total, pero solo activan 0,5B por token (una proporción de 40:1). Así logran un rendimiento comparable al de modelos densos de 7B en matemáticas y programación, con una fracción del cómputo. [2]
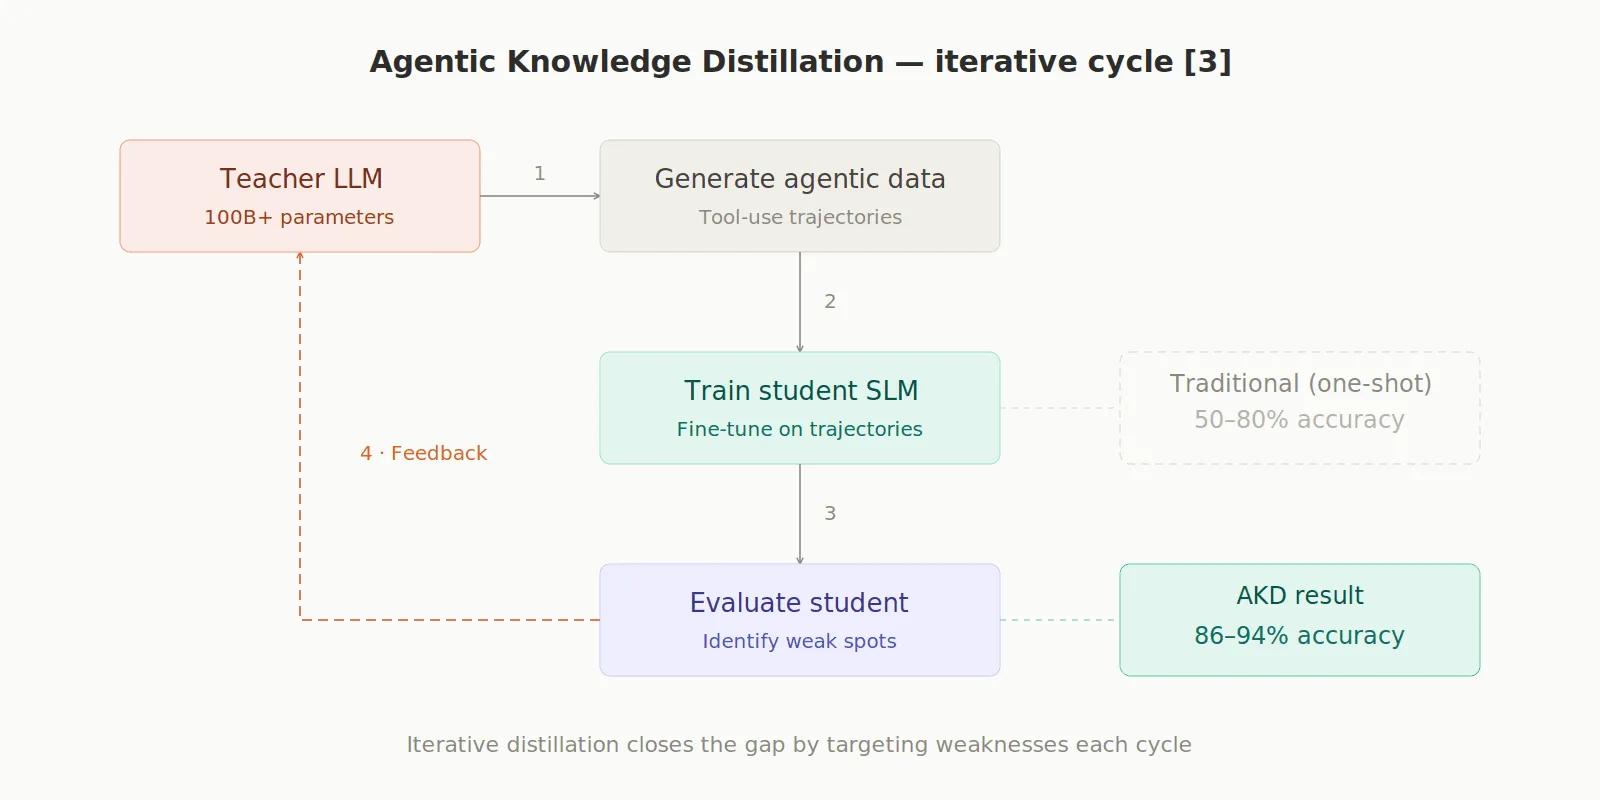
Agentic Knowledge Distillation (AKD): un LLM grande actúa como «profesor autónomo» que genera datos, evalúa al modelo pequeño y lo entrena de forma iterativa. Los modelos destilados así alcanzan un 86–94 % de precisión en tareas de seguridad, frente al 50–80 % con métodos tradicionales. [3]
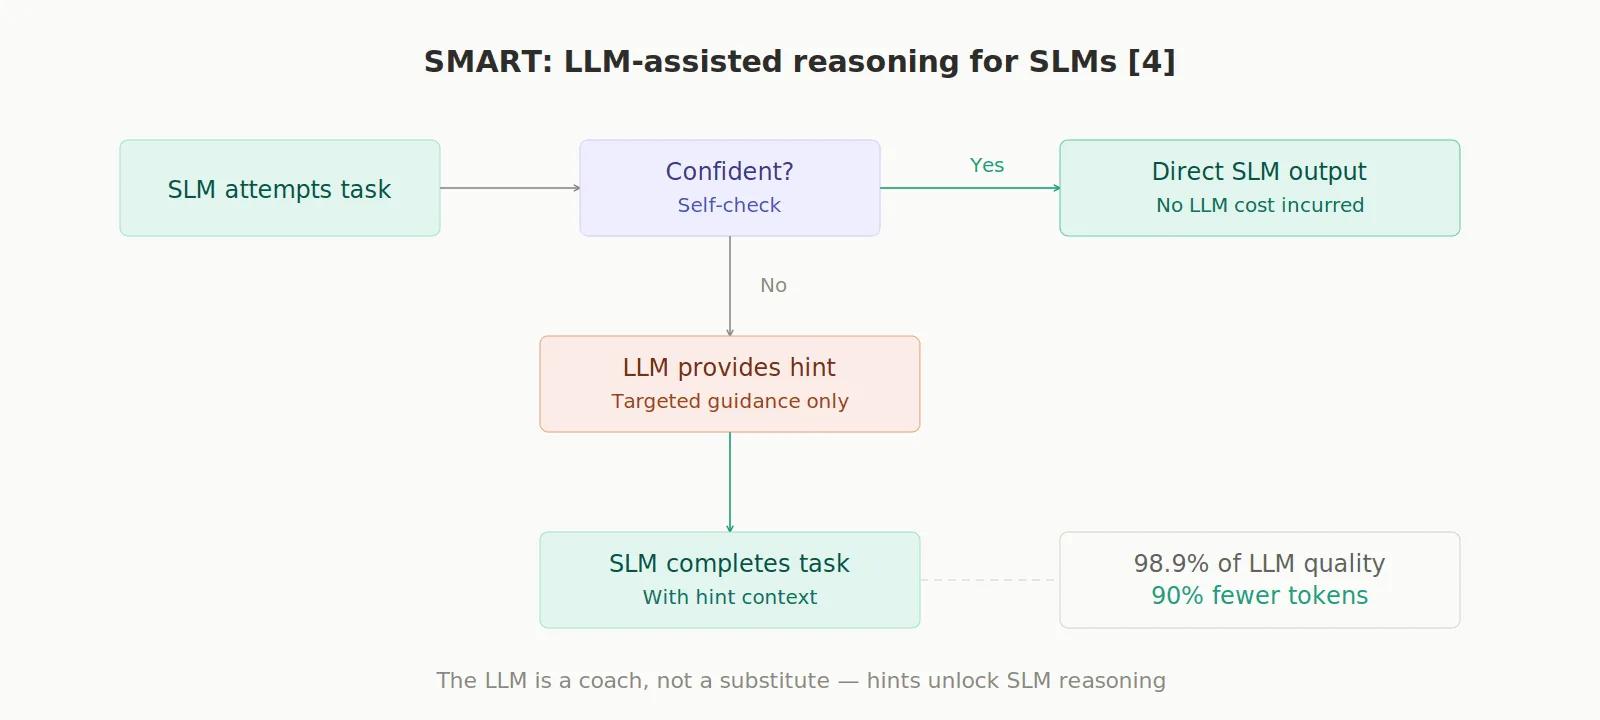
Framework SMART: cuando un SLM se atasca en un razonamiento complejo, el LLM grande solo interviene para dar una «pista» concreta, no para resolverlo todo. Así se alcanza el 98,9 % del rendimiento del LLM grande usando un 90 % menos de tokens. [4]
4. Benchmarks
Los benchmarks nos permiten estimar lo buenos que son los modelos en tareas concretas y garantizar su fiabilidad.
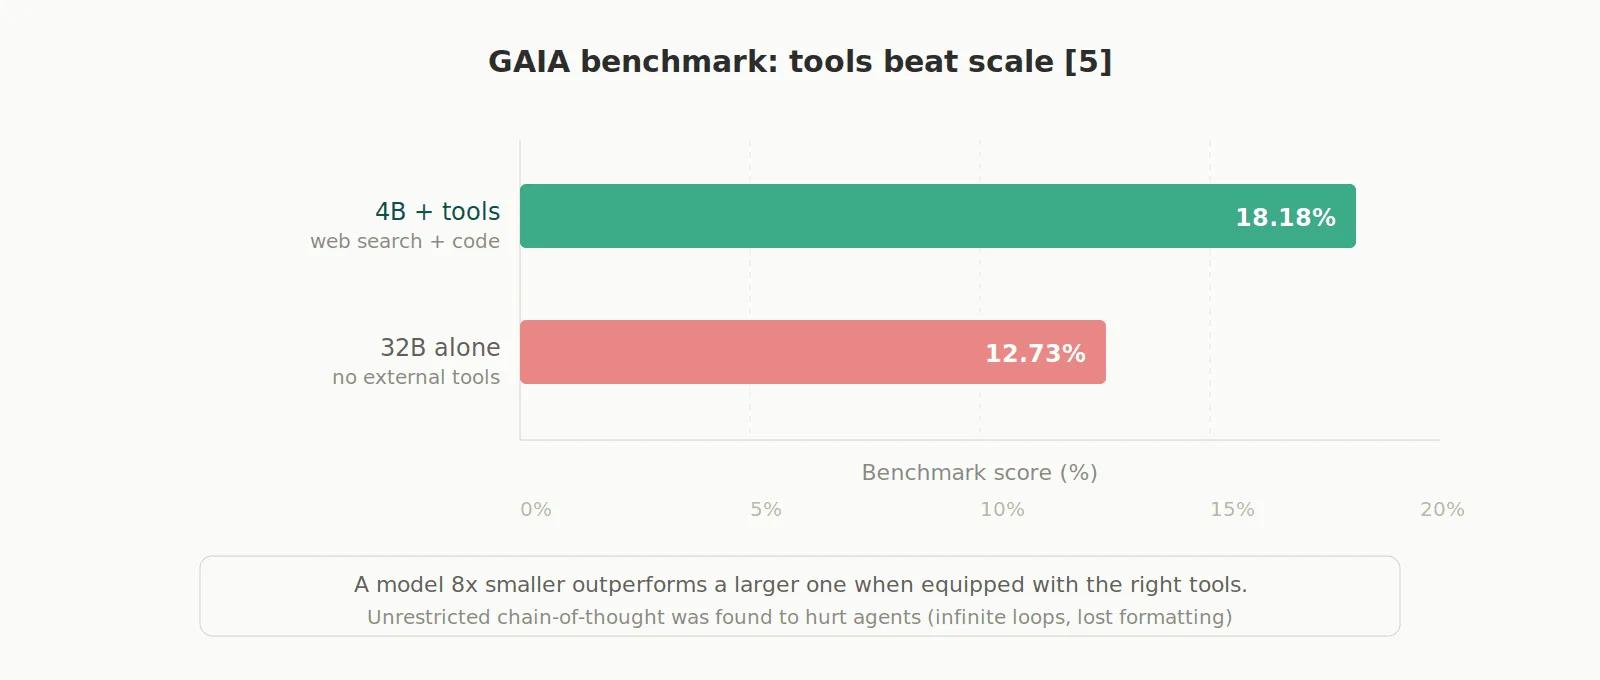
En el benchmark GAIA, modelos de 4B de parámetros con herramientas (búsqueda web, ejecución de código) superaron a modelos de 32B sin herramientas (18,18 % frente a 12,73 %). Además, se observó que el «pensamiento completo» sin restricciones (chain-of-thought sin límites) perjudica a los agentes: los hace entrar en bucles infinitos y perder el formato. Es mejor limitar el razonamiento a la fase de planificación. [5]
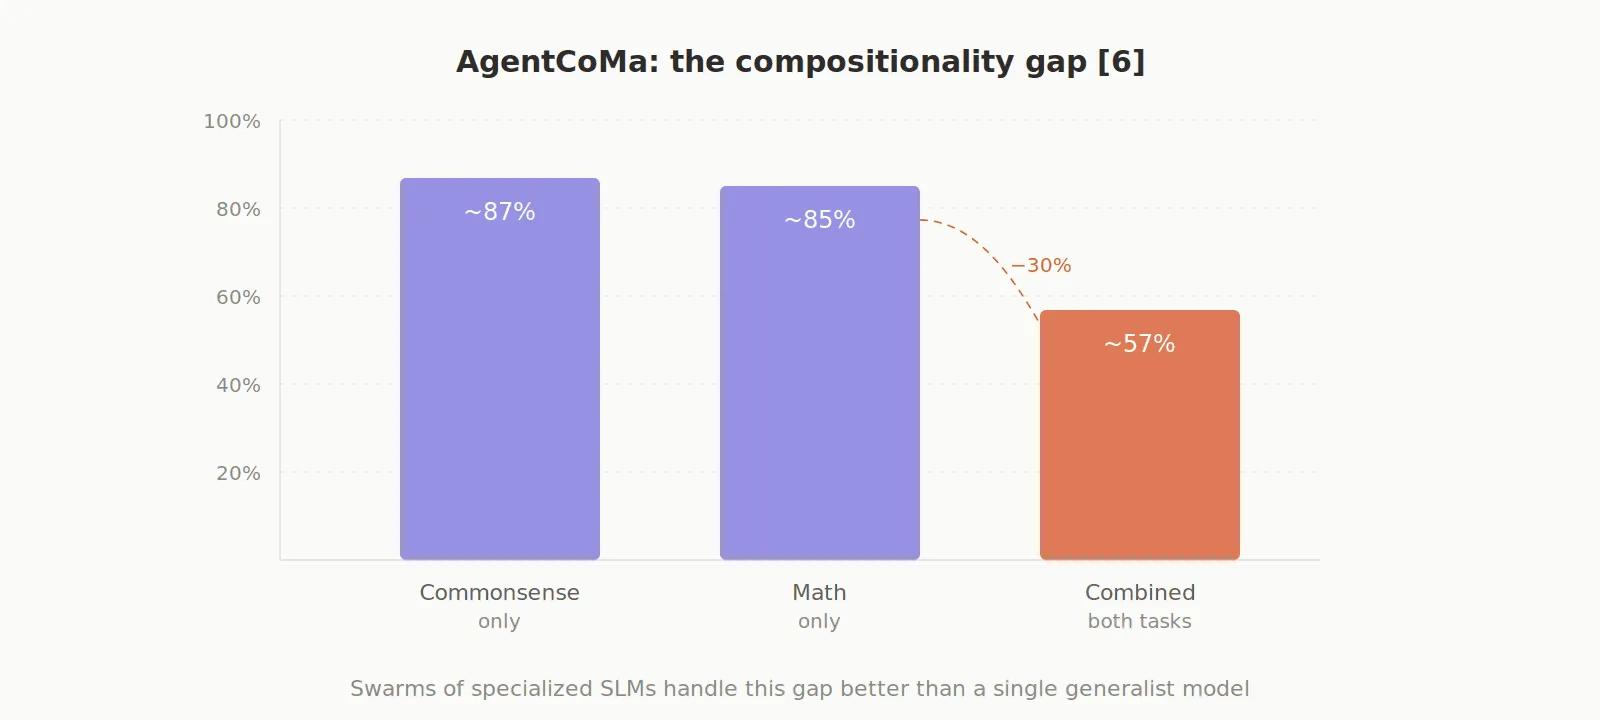
El benchmark AgentCoMa reveló otro problema: la brecha de composicionalidad. Los modelos resuelven por separado pasos de sentido común y pasos matemáticos (~85 % o más), pero cuando ambos se combinan en una misma tarea, el rendimiento cae alrededor de un 30 %. Un enjambre de SLM especializados lo resuelve mejor que un único modelo generalista gigante. [6]
5. Arquitecturas multiagente
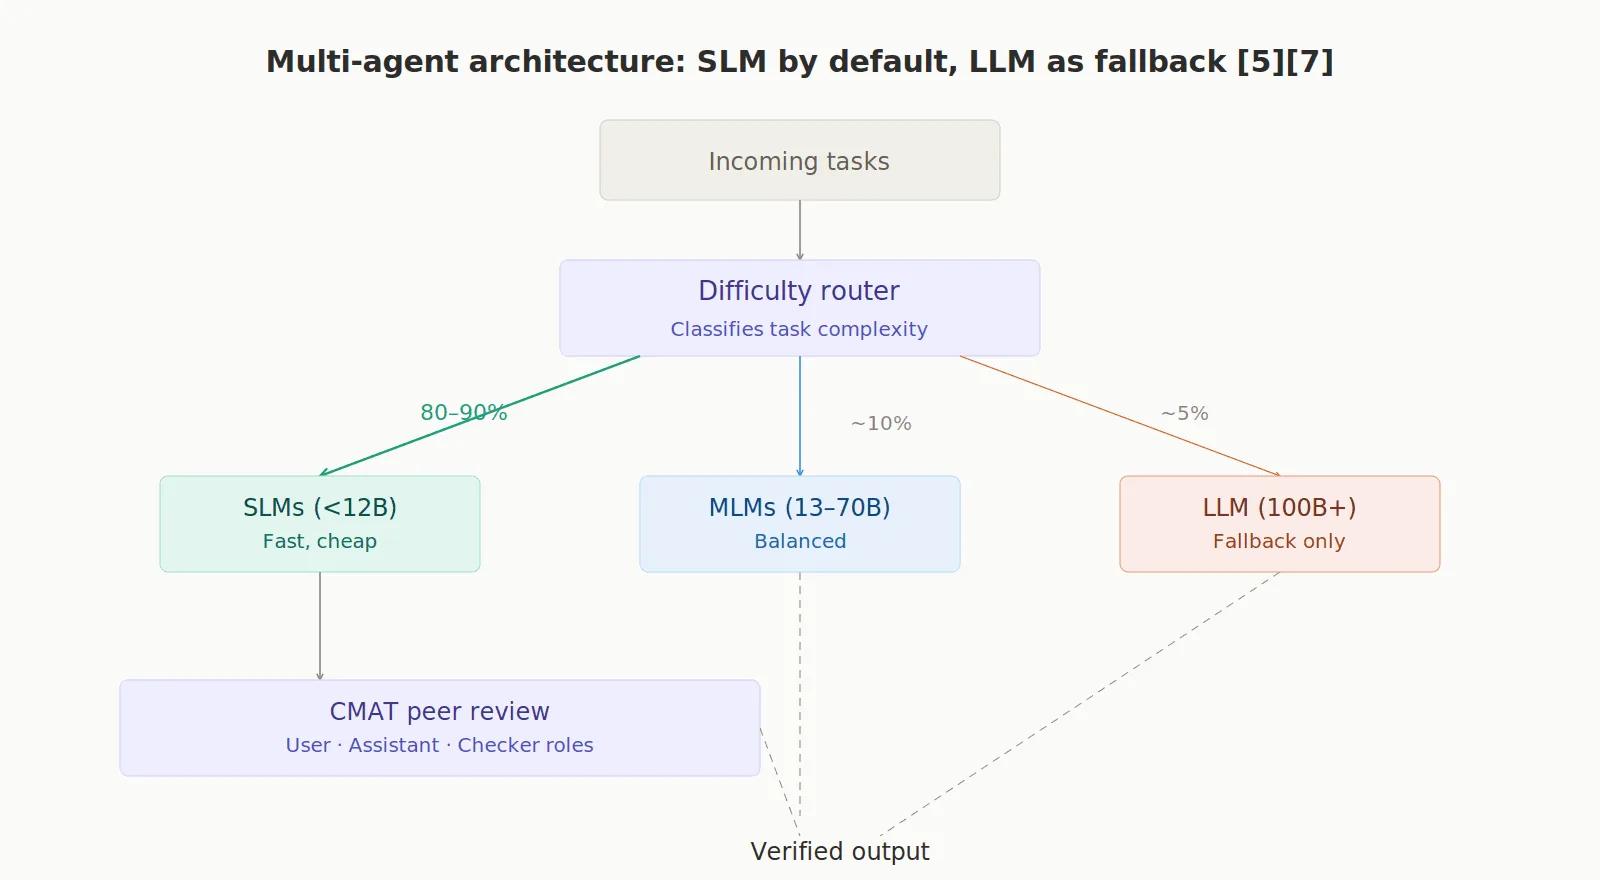
El modelo operativo ideal es «SLM por defecto, LLM como respaldo». Un router clasifica las tareas por dificultad: las fáciles van a SLM baratos, las intermedias a MLM y solo las realmente complejas escalan al LLM grande. Así, entre el 80 y el 90 % de la carga de trabajo la gestionan SLM. Frameworks como CMAT asignan roles (User, Assistant, Checker) a distintos SLM que se revisan entre sí. [7]
6. Seguridad
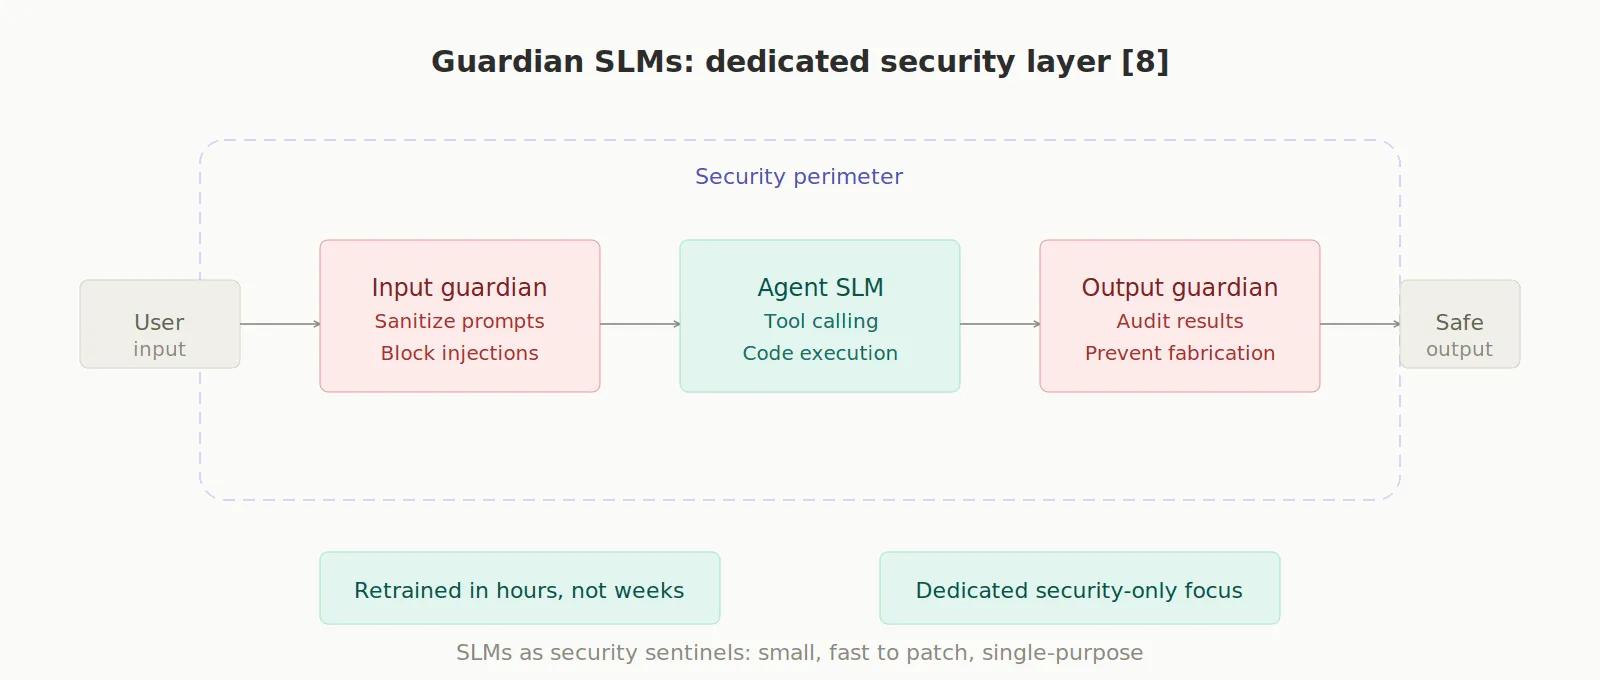
Los agentes autónomos con acceso a API y bases de datos son vectores de ataque serios. Aquí los SLM tienen ventaja: se pueden parchear y reentrenar en horas. Además, se pueden desplegar «SLM guardianes»: modelos dedicados exclusivamente a sanear entradas, auditar salidas y prevenir inyecciones de prompt y la invención de registros. [8]
Conclusión
El futuro de la IA agéntica se apoya en cuatro principios clave que se alejan del modelo tradicional, masivo y centralizado.
Primero, hay un fuerte foco en las ventajas económicas y de latencia: se prefieren modelos más pequeños (SLM/MLM, de 1B a 70B de parámetros) porque reducen drásticamente el coste, aumentan la velocidad y mejoran la eficiencia energética, lo que hace viable y escalable una operación autónoma y continua.
Esa eficiencia lleva directamente al segundo principio, que pone el acento en el aumento con herramientas por encima de la escala pura: el mejor rendimiento no se consigue con modelos aislados cada vez más grandes, sino integrando de forma sistemática modelos más pequeños con herramientas programáticas, una sinergia que supera una y otra vez a los modelos monolíticos.
Tercero, la necesidad de especialización queda clara: los modelos de propósito general se quedan cortos ante la enorme variedad de tareas de razonamiento complejo. Un «enjambre» de SLM especializados, coordinados de forma inteligente por un mecanismo de enrutamiento eficiente, es la solución más eficaz.
Por último, el papel de la arquitectura en la eficiencia es fundamental: técnicas avanzadas como Extreme MoE, la destilación agéntica y el andamiaje cognitivo permiten comprimir la inteligencia y las capacidades de los modelos de frontera en motores de ejecución muy compactos y eficientes.
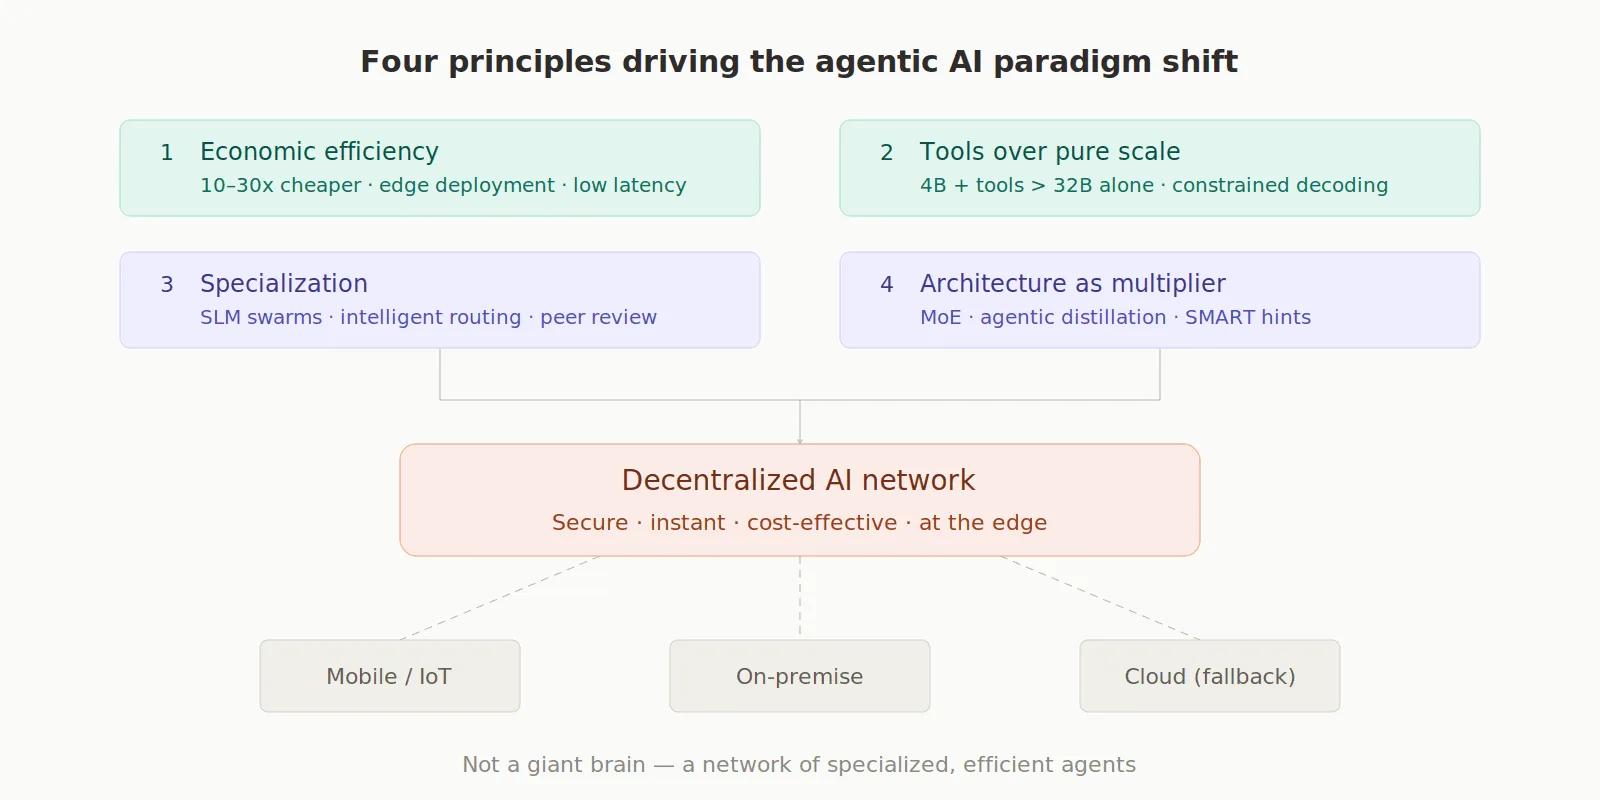
Este cambio de paradigma significa que el futuro de la IA agéntica no es un «cerebro gigante» centralizado, sino una red descentralizada de modelos pequeños y medianos que operan de forma segura, instantánea y rentable en la periferia de la red.
Referencias
[1] Jhandi, P., Kazi, O., Subramanian, S., & Sendas, N. (2025). Small Language Models for Efficient Agentic Tool Calling: Outperforming Large Models with Targeted Fine-tuning. [Modelos de lenguaje pequeños para llamadas a herramientas agénticas eficientes: superar a los modelos grandes con un ajuste fino dirigido] arXiv:2512.15943. https://arxiv.org/abs/2512.15943
[2] Hu, Q., Lin, Z., Yang, Z., Ding, Y., Liu, X., Jiang, Y., Wang, R., Chen, T., Guo, Z., Xiong, Y., Gao, R., Qu, L., Su, J., Cheng, P., & Gong, Y. (2025). Sigma-MoE-Tiny Technical Report. [Informe técnico de Sigma-MoE-Tiny] arXiv:2512.16248. https://arxiv.org/abs/2512.16248
[3] Kang, M., Jeong, J., Lee, S., Cho, J., & Hwang, S. J. (2025). Distilling LLM Agent into Small Models with Retrieval and Code Tools. [Destilar un agente LLM en modelos pequeños con herramientas de recuperación y de código] arXiv:2505.17612. https://arxiv.org/abs/2505.17612
[4] Kim, Y., Yi, E., Kim, M., Yun, S.-Y., & Kim, T. (2025). Guiding Reasoning in Small Language Models with LLM Assistance. [Guiar el razonamiento de modelos de lenguaje pequeños con ayuda de un LLM] arXiv:2504.09923. https://arxiv.org/abs/2504.09923
[5] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2026). Can Small Agent Collaboration Beat a Single Big LLM?. [¿Puede la colaboración de agentes pequeños superar a un único LLM grande?] arXiv:2601.11327. https://arxiv.org/abs/2601.11327
[6] Alazraki, L., Chen, L., Brassard, A., Stacey, J., Rahmani, H. A., & Rei, M. (2025). AgentCoMa: A Compositional Benchmark Mixing Commonsense and Mathematical Reasoning in Real-World Scenarios. [AgentCoMa: un benchmark composicional que combina sentido común y razonamiento matemático en escenarios reales] arXiv:2508.19988. https://arxiv.org/abs/2508.19988
[7] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2025). Route-and-Reason: Scaling Large Language Model Reasoning with Reinforced Model Router. [Route-and-Reason: escalar el razonamiento de los LLM con un router de modelos reforzado] arXiv:2506.05901. https://arxiv.org/abs/2506.05901
[8] Evertz, J., Chlosta, M., Schönherr, L., & Eisenhofer, T. (2024). Whispers in the Machine: Confidentiality in Agentic Systems. [Susurros en la máquina: confidencialidad en sistemas agénticos] arXiv:2402.06922. https://arxiv.org/abs/2402.06922
[9] Sharma, R. & Mehta, M. (2025). Small Language Models for Agentic Systems: A Survey of Architectures, Capabilities, and Deployment Trade-offs. [Modelos de lenguaje pequeños para sistemas agénticos: revisión de arquitecturas, capacidades y compromisos de despliegue] arXiv:2510.03847. https://arxiv.org/abs/2510.03847
[10] Belcak, P. et al. (2025). Small Language Models are the Future of Agentic AI. [Los modelos de lenguaje pequeños son el futuro de la IA agéntica] arXiv:2506.02153. https://arxiv.org/abs/2506.02153
