

小模型如何驱动智能体 AI
 Toni Lopez Co-Founder at Karumi
人工智能正在经历一场范式转变。多年来,主流逻辑一直是“越大越好”:拥有数千亿参数的模型(前沿 LLM)力求样样精通。它们确实在通用对话和推理上取得了令人瞩目的成绩。但重心已经转移。如今的目标不再只是回答问题,而是构建智能体系统:能够自主规划、调用 API、执行代码、处理结构化数据并做出连续决策的 AI。在这种场景下,超大模型显得昂贵、缓慢且设计过度。
本文认为,小型语言模型(Small Language Models,参数少于 120 亿)和中型语言模型(Medium Language Models,参数 130 亿至 700 亿)不仅足以胜任智能体任务,而且只要训练得当、方法得宜,甚至能超越更大的模型。在后续文章中,我们将逐一拆解每项创新,并用通俗易懂的语言讲清楚。今天,我们想说明中小型语言模型将如何、以及为何成为行业的下一个爆点。
1. 经济性与运营效率
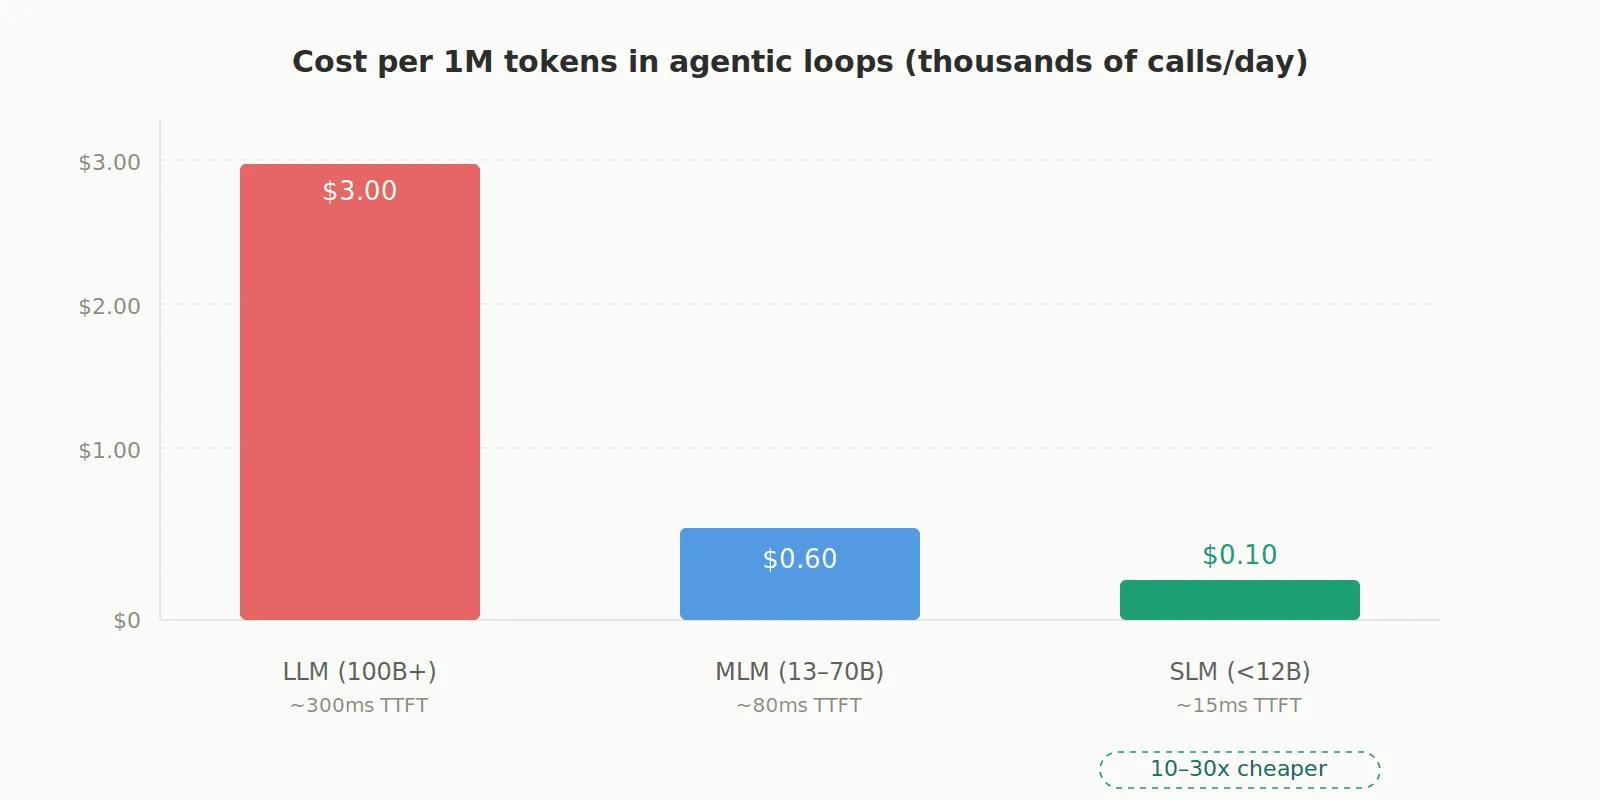
智能体系统不是只发一次请求,而是在紧凑的循环中执行成千上万次调用。为此动用一个 1000 亿以上参数的模型,就像开着 F1 赛车去买菜。SLM 每个 token 的成本低 10 到 30 倍,延迟极低(首个 token 的响应时间短得多),甚至可以在 CPU 或移动设备上运行。这也让边缘部署成为可能:无需依赖云端即可在本地运行 AI,从而解决隐私、数据主权和延迟问题。
2. 智能体能力并不需要超大规模
事实上,智能体模型并不需要写诗或讲故事。简单来说,智能体需要的是:正确的函数调用、有效的 JSON 生成、严格遵循 schema,以及执行代码的能力。如今的 SLM 已经能够稳定生成格式化输出;我找到的例子都采用了约束解码技术(XGrammar 和 Outlines 就是提供此类技术的库),让 SLM 得以缩小与前沿模型之间的差距。
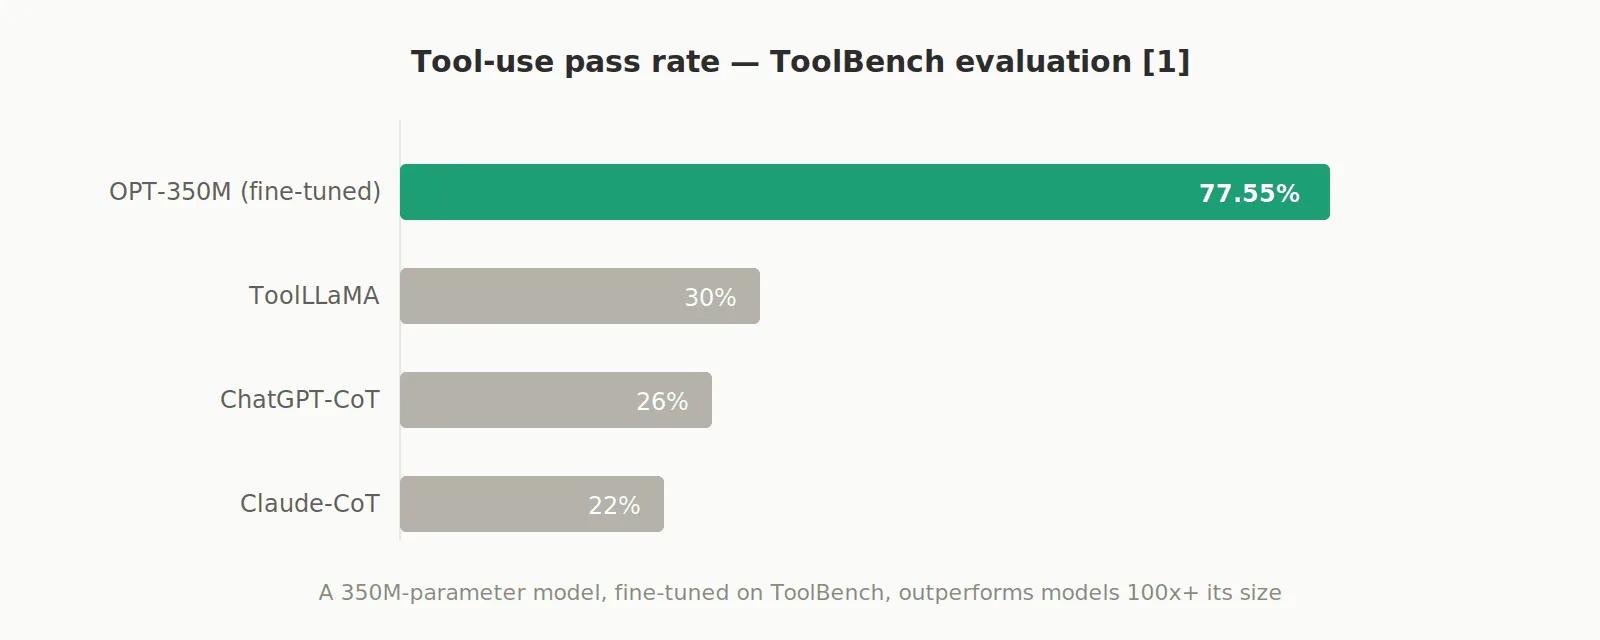
举个例子:一个仅有 3.5 亿参数的模型(OPT-350M)在 ToolBench 数据上微调后,在工具调用评测中取得了 77.55% 的通过率,远超 ChatGPT-CoT(26%)、ToolLLaMA(30%)和 Claude-CoT [1]。
3. 关键架构创新
有些架构在业内早已广为人知,但有意思的是它们如何被用来提升 SLM 的性能。
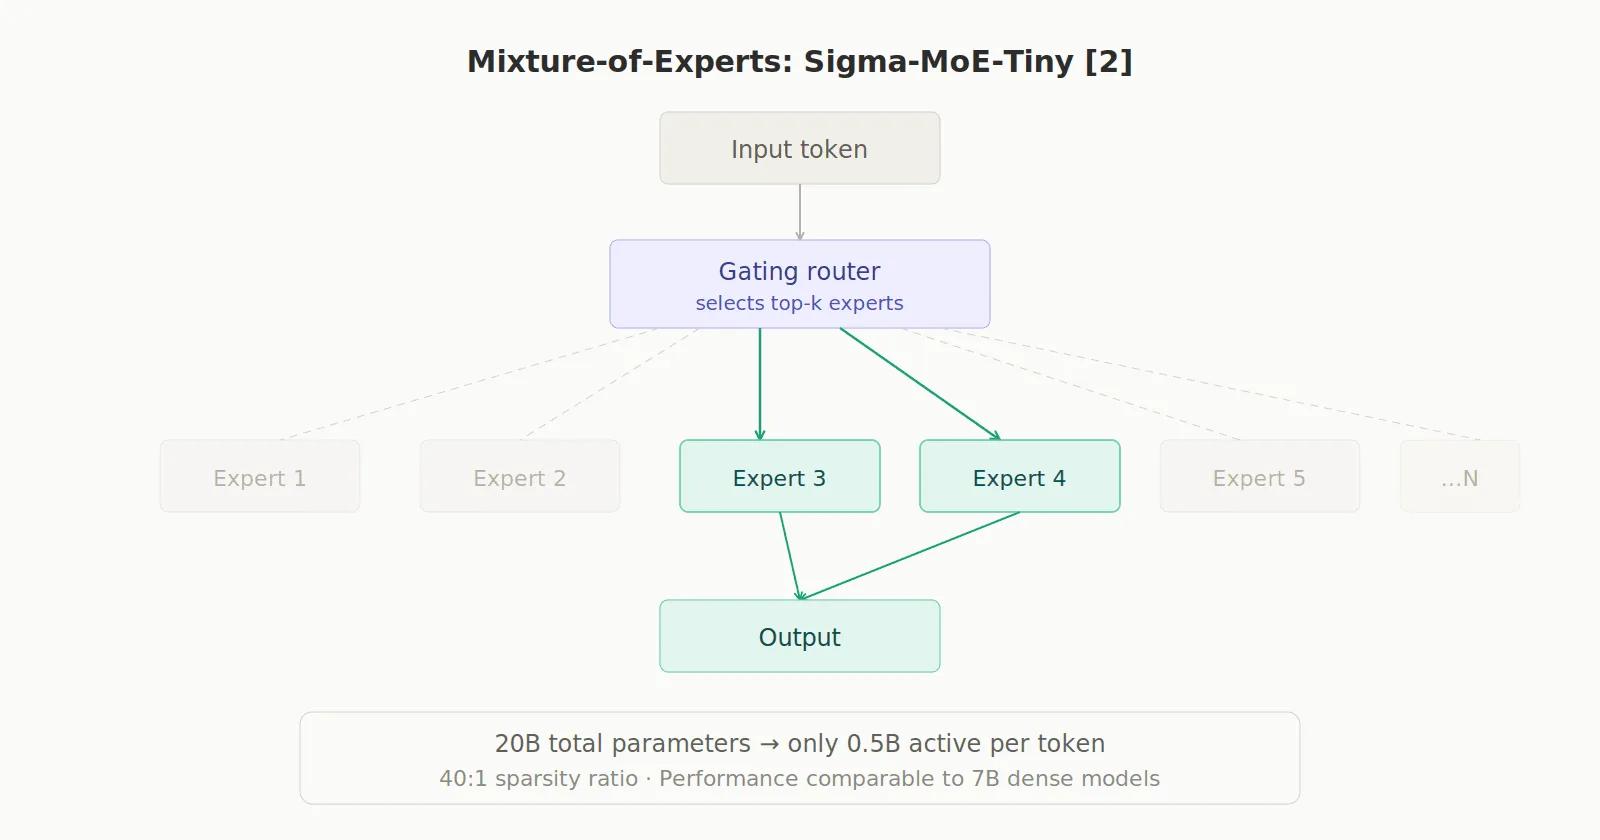
混合专家(MoE):像 Sigma-MoE-Tiny 这样的模型总参数量为 200 亿,但每个 token 只激活 5 亿(比例为 40:1)。这样一来,它在数学和编程上的表现可媲美 70 亿参数的稠密模型,而计算量只是后者的一小部分。[2]
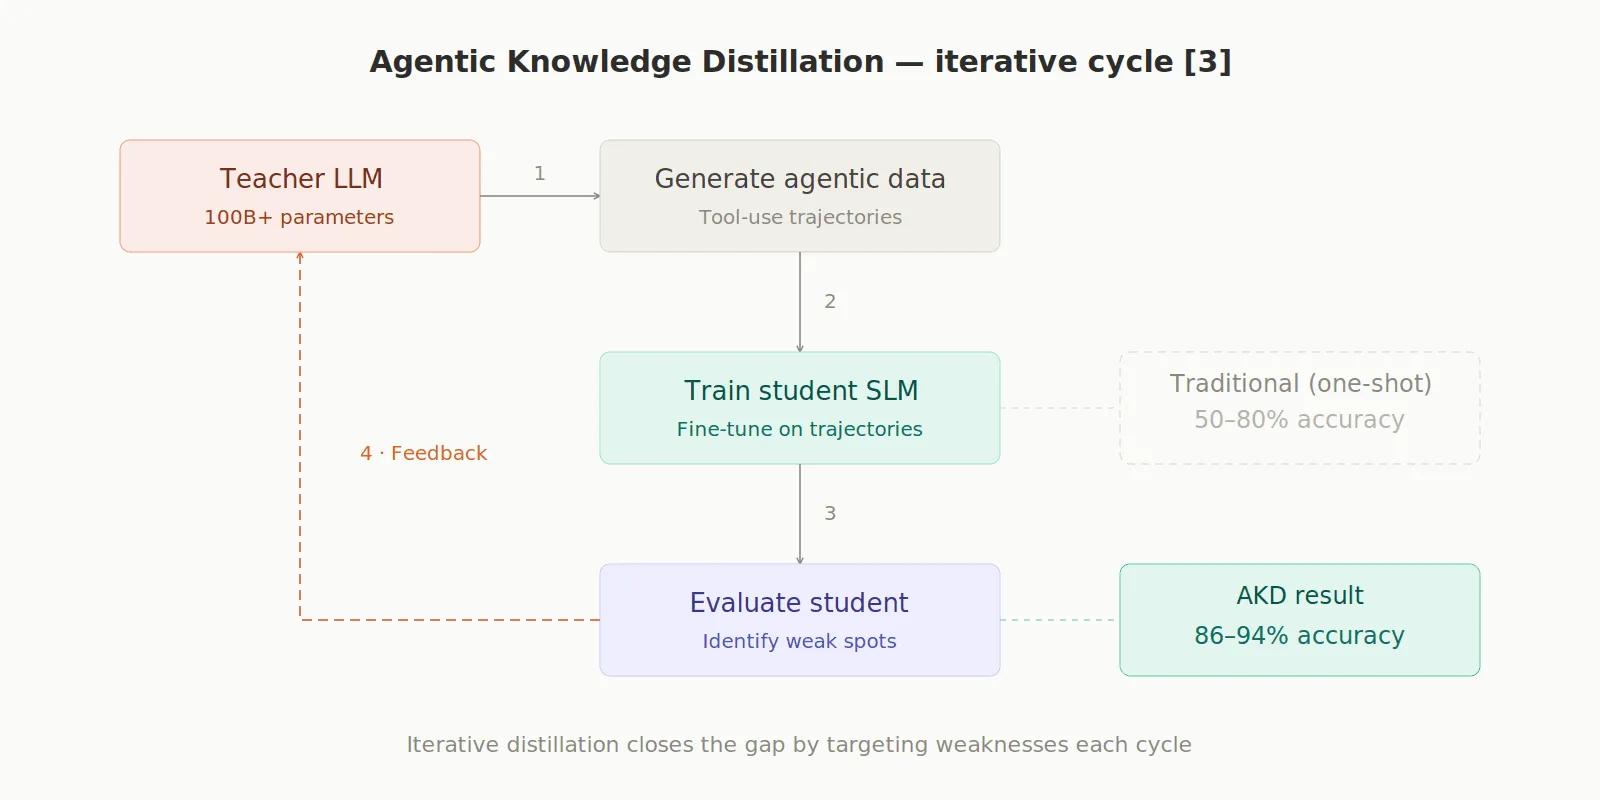
智能体知识蒸馏(AKD):由一个大型 LLM 充当“自主导师”,负责生成数据、评估小模型并对其进行迭代训练。以这种方式蒸馏出的模型在安全任务上的准确率可达 86–94%,而传统方法只有 50–80%。[3]
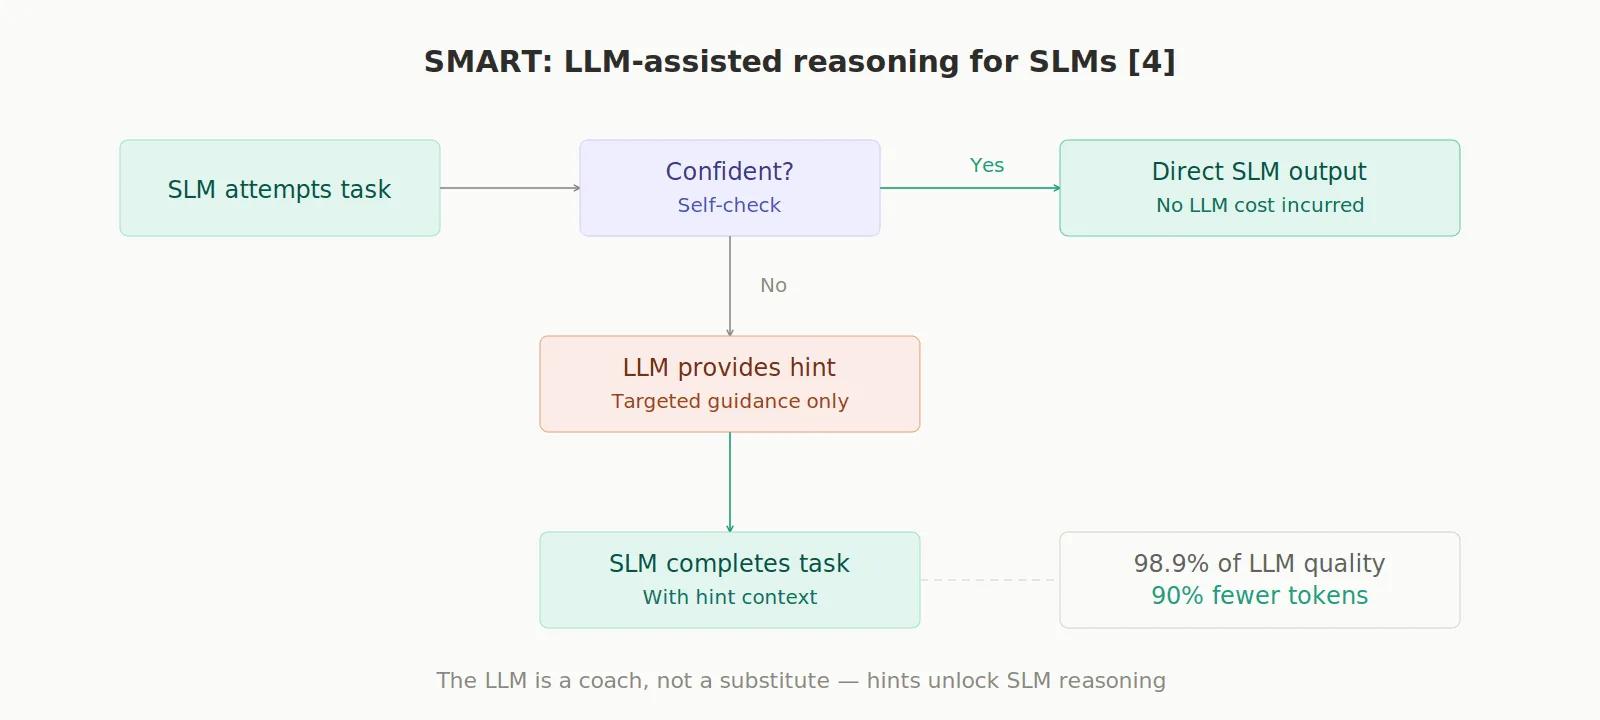
SMART 框架:当 SLM 在复杂推理中卡住时,才调用大型 LLM,而且只让它给出有针对性的“提示”,而不是包办一切。这种方式能达到大型 LLM 98.9% 的性能,同时减少 90% 的 token 用量。[4]
4. 基准测试
基准测试帮助我们评估模型在特定任务上的表现,从而确保模型的可靠性。
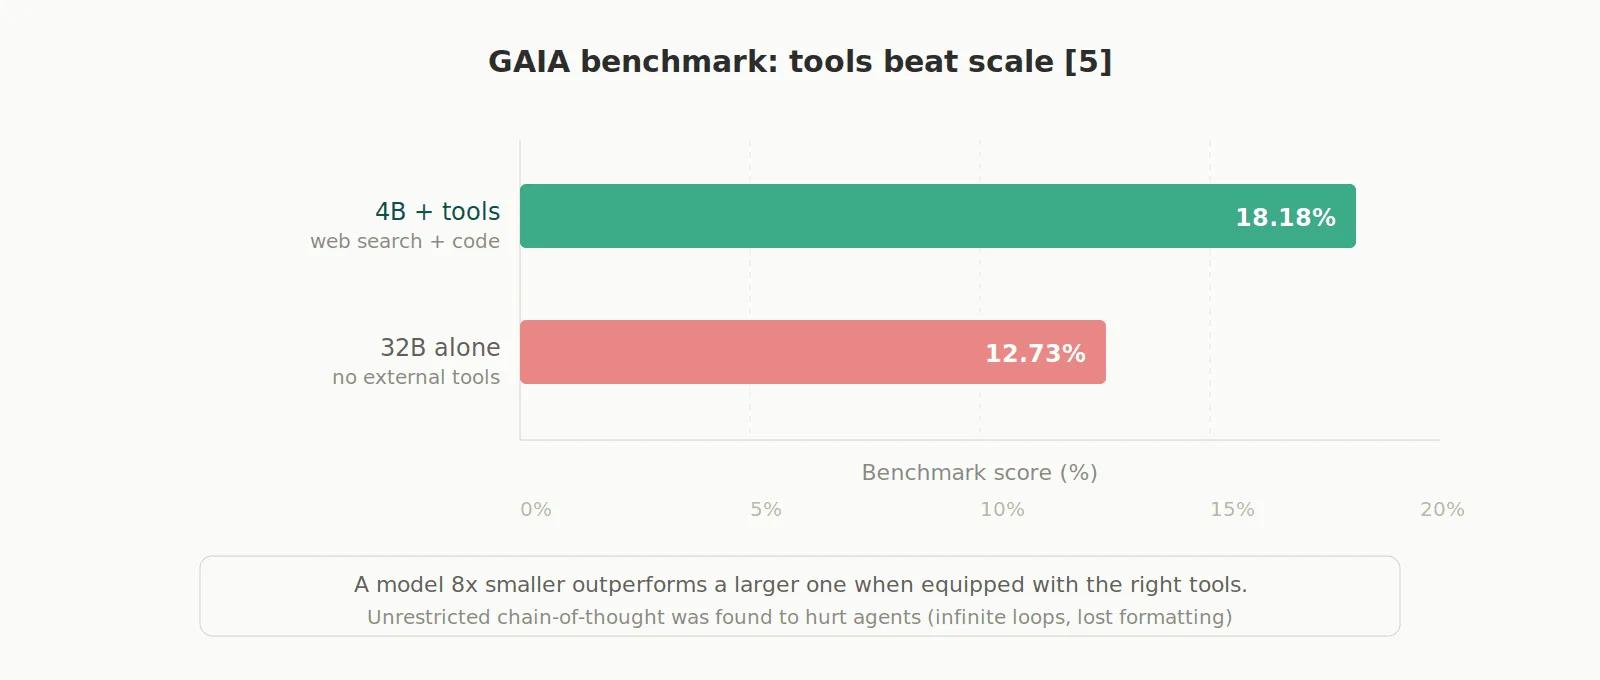
在 GAIA 基准测试中,配备工具(网页搜索、代码执行)的 40 亿参数模型胜过了不带工具的 320 亿参数模型(18.18% 对 12.73%)。此外研究发现,不加限制的“完整思考”(无约束的思维链)反而会损害智能体:让它们陷入无限循环并丢失格式。更好的做法是只在规划阶段进行推理。[5]
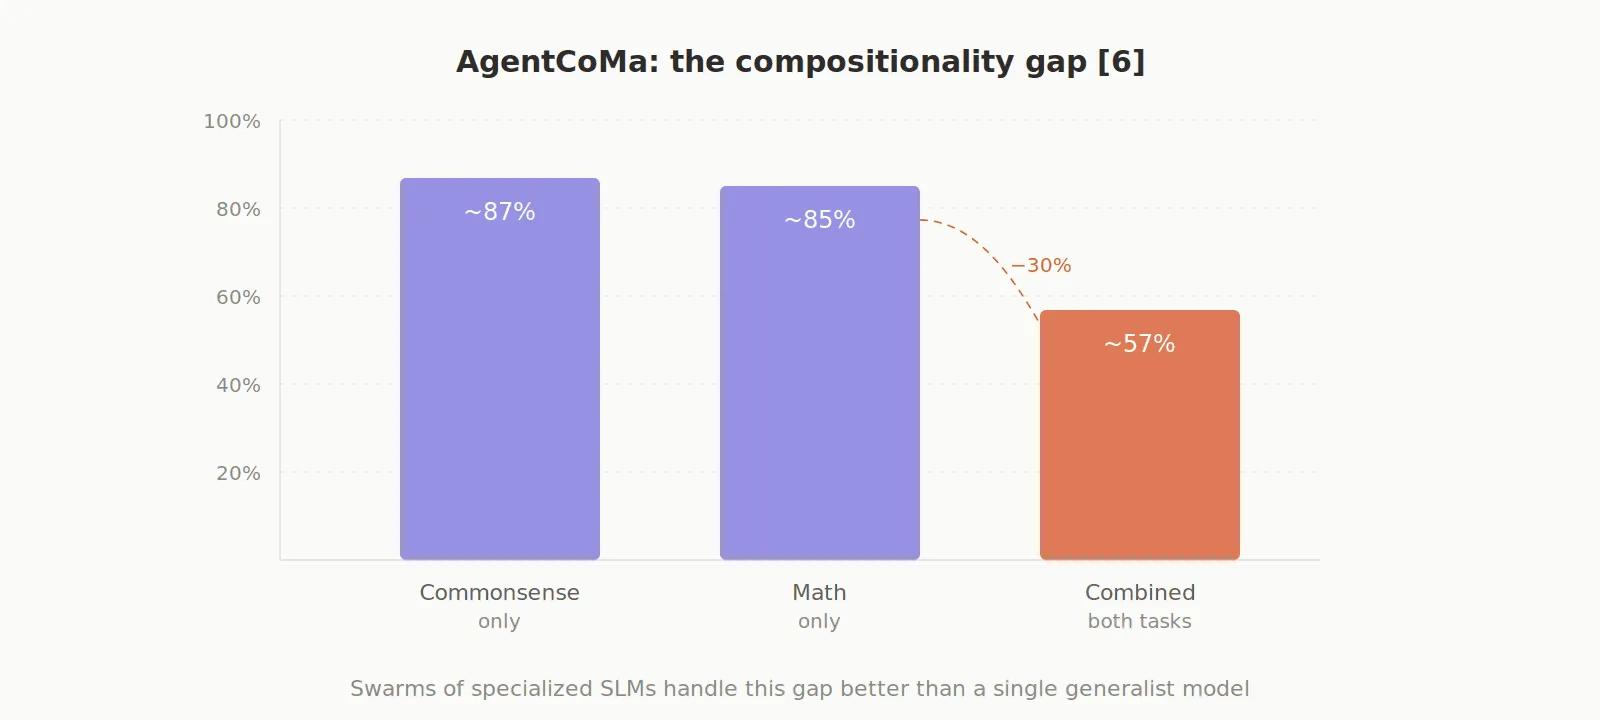
AgentCoMa 基准测试揭示了另一个问题:组合性差距。模型可以分别完成常识推理步骤和数学步骤(约 85% 以上),但当两者在同一任务中结合时,性能会下降约 30%。与其依赖单一的超大通用模型,不如用一群专业化的 SLM 来应对。[6]
5. 多智能体架构
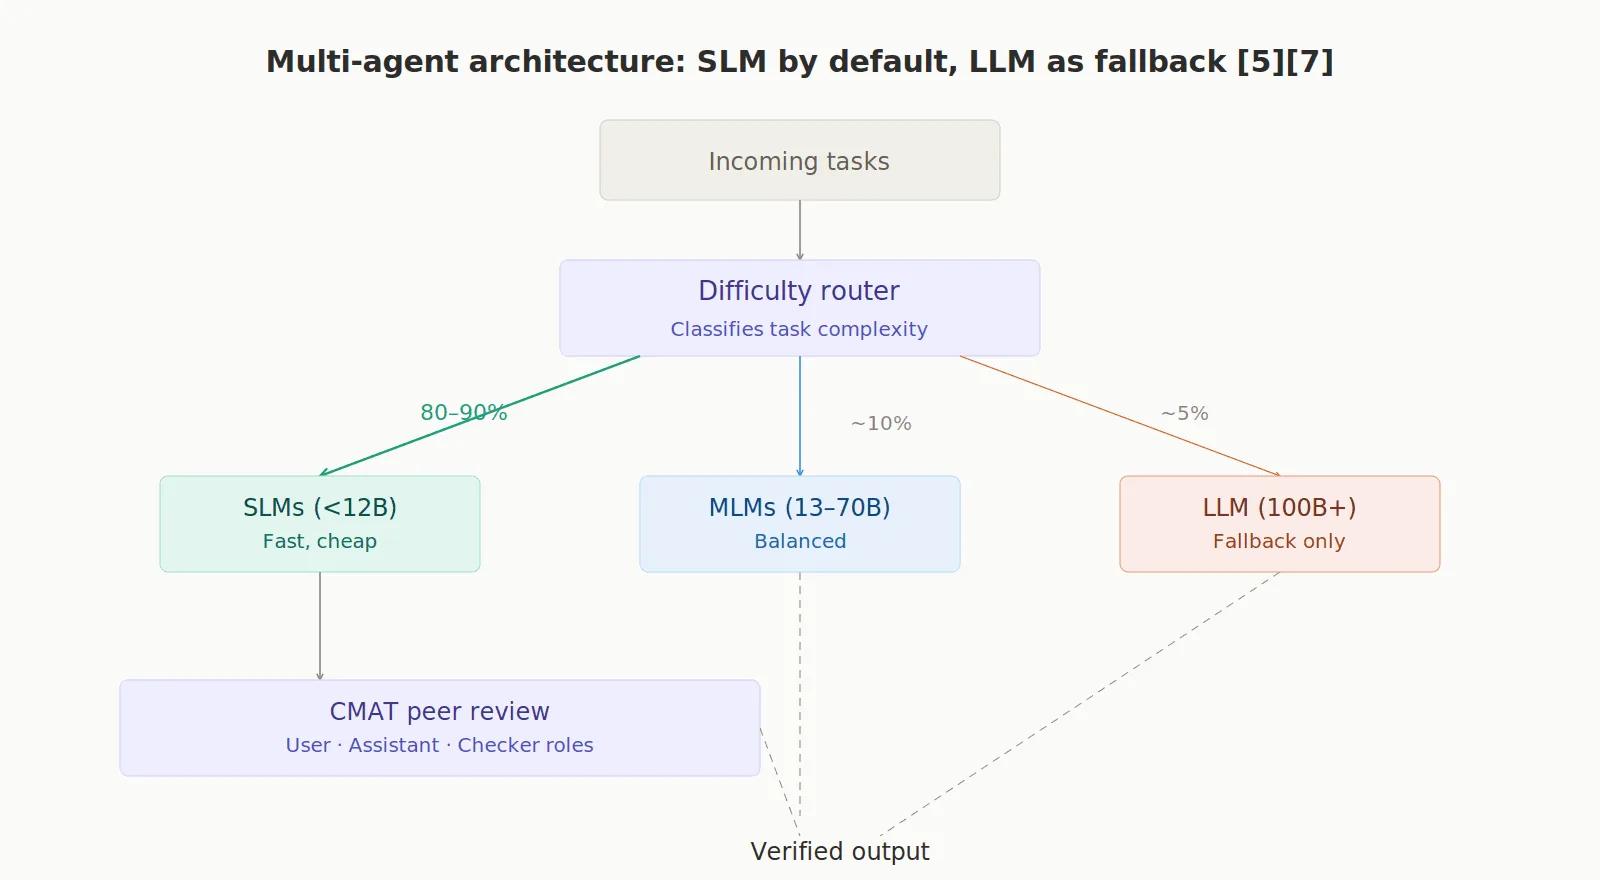
理想的运行模式是“默认用 SLM,LLM 兜底”。由路由器按难度对任务分类:简单任务交给低成本的 SLM,中等任务交给 MLM,只有真正复杂的任务才升级到大型 LLM。这样,80–90% 的工作量都由 SLM 处理。CMAT 等框架会为不同的 SLM 分配角色(User、Assistant、Checker),让它们相互审查。[7]
6. 安全
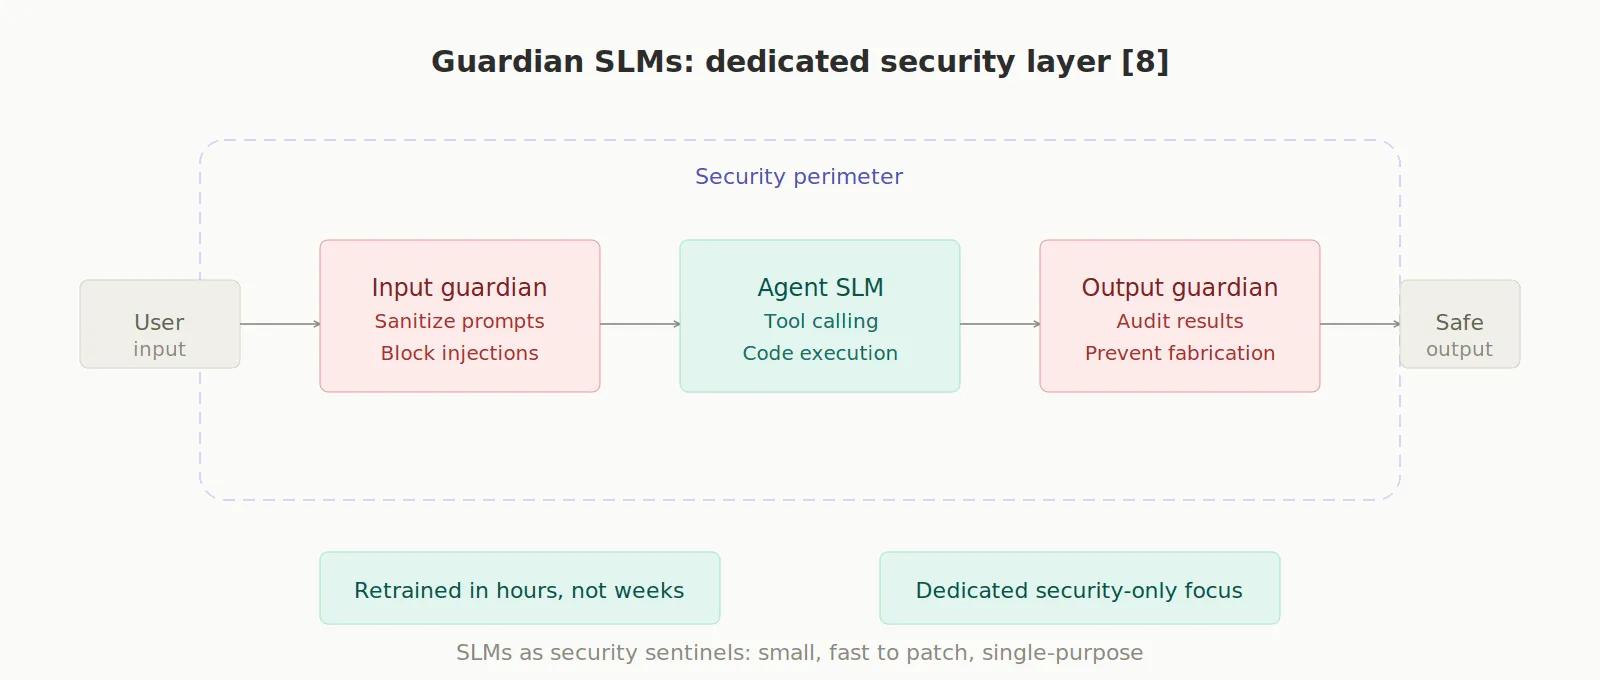
能够访问 API 和数据库的自主智能体是严重的攻击入口。SLM 在这方面有优势:可以在数小时内完成修补和重新训练。此外,还可以部署“守护型 SLM”,专门负责清洗输入、审计输出,防止提示词注入和伪造记录。[8]
结论
智能体 AI 的未来由四项关键原则驱动,它们正在远离传统的超大集中式模型。
第一,高度重视成本与延迟优势:更小的模型(参数 10 亿至 700 亿的 SLM/MLM)更受青睐,因为它们能大幅降低成本、提升速度并改善能效,让持续、自主的运行变得可行且可扩展。
这种效率直接引出第二项原则,即以工具增强取代单纯扩大规模:卓越的性能并非来自越来越大的孤立模型,而是来自将小模型与程序化工具系统地结合,这种协同效应始终优于单体模型。
第三,专业化的必要性愈发清晰:面对种类繁多的复杂推理任务,通用模型力不从心。由高效路由机制智能协调的一“群”专业化 SLM,才是最有效的解决方案。
最后,架构对效率的作用至关重要:极致 MoE、智能体蒸馏和认知脚手架等先进技术,正被用来把前沿模型的智能与能力压缩进高度紧凑、高效的执行引擎中。
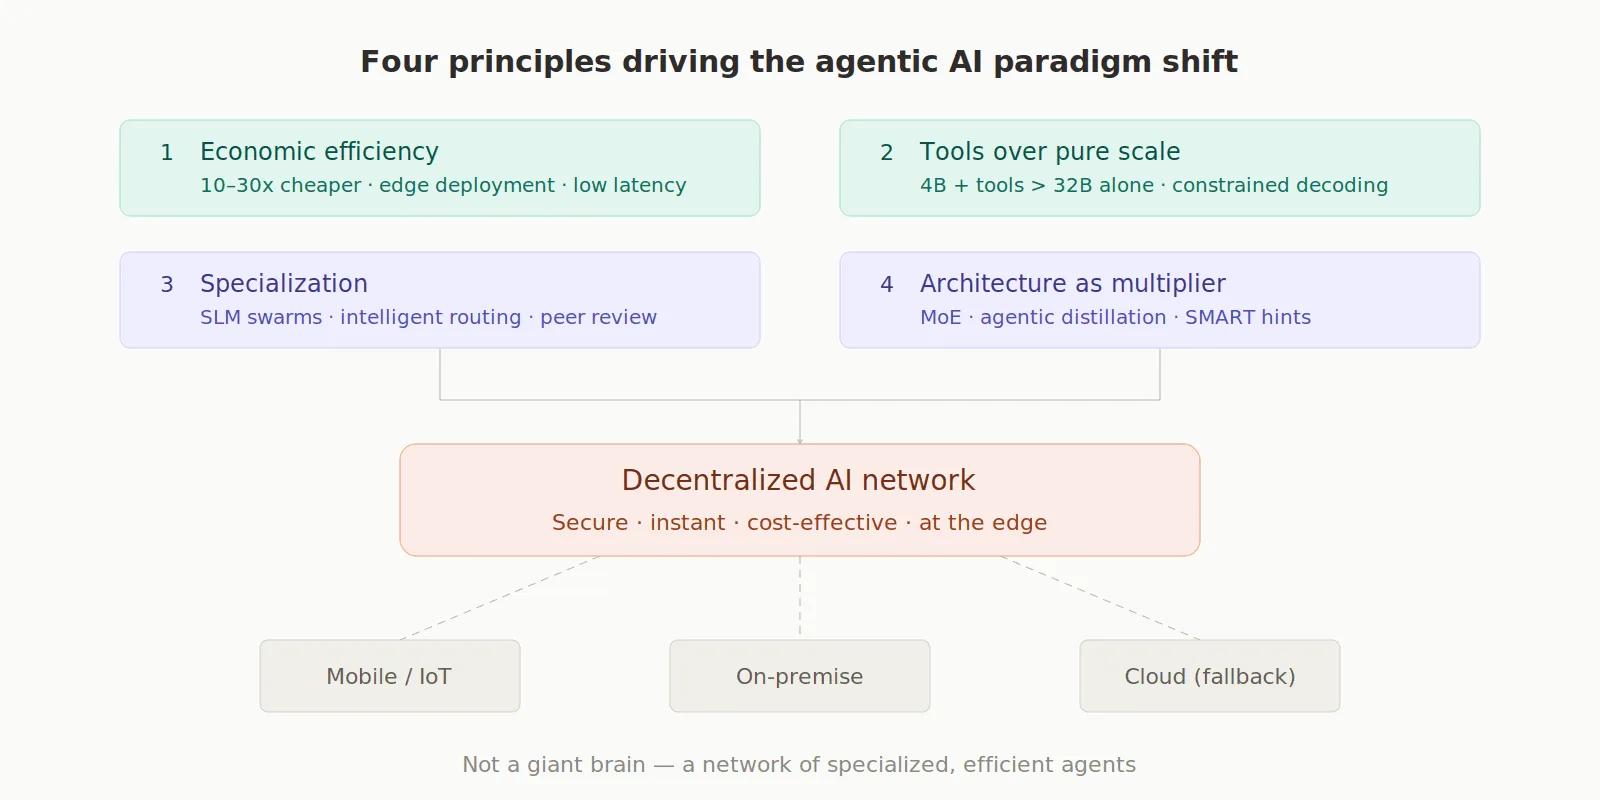
这场范式转变意味着,智能体 AI 的未来不是一个集中式的“超级大脑”,而是由中小型模型组成的去中心化网络,在网络边缘安全、即时且低成本地运行。
参考文献
[1] Jhandi, P., Kazi, O., Subramanian, S., & Sendas, N. (2025). Small Language Models for Efficient Agentic Tool Calling: Outperforming Large Models with Targeted Fine-tuning. [面向高效智能体工具调用的小型语言模型:通过定向微调超越大模型] arXiv:2512.15943. https://arxiv.org/abs/2512.15943
[2] Hu, Q., Lin, Z., Yang, Z., Ding, Y., Liu, X., Jiang, Y., Wang, R., Chen, T., Guo, Z., Xiong, Y., Gao, R., Qu, L., Su, J., Cheng, P., & Gong, Y. (2025). Sigma-MoE-Tiny Technical Report. [Sigma-MoE-Tiny 技术报告] arXiv:2512.16248. https://arxiv.org/abs/2512.16248
[3] Kang, M., Jeong, J., Lee, S., Cho, J., & Hwang, S. J. (2025). Distilling LLM Agent into Small Models with Retrieval and Code Tools. [借助检索与代码工具将 LLM 智能体蒸馏到小模型] arXiv:2505.17612. https://arxiv.org/abs/2505.17612
[4] Kim, Y., Yi, E., Kim, M., Yun, S.-Y., & Kim, T. (2025). Guiding Reasoning in Small Language Models with LLM Assistance. [借助 LLM 引导小型语言模型推理] arXiv:2504.09923. https://arxiv.org/abs/2504.09923
[5] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2026). Can Small Agent Collaboration Beat a Single Big LLM?. [小型智能体协作能否击败单个大型 LLM?] arXiv:2601.11327. https://arxiv.org/abs/2601.11327
[6] Alazraki, L., Chen, L., Brassard, A., Stacey, J., Rahmani, H. A., & Rei, M. (2025). AgentCoMa: A Compositional Benchmark Mixing Commonsense and Mathematical Reasoning in Real-World Scenarios. [AgentCoMa:融合常识与数学推理的真实场景组合式基准] arXiv:2508.19988. https://arxiv.org/abs/2508.19988
[7] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2025). Route-and-Reason: Scaling Large Language Model Reasoning with Reinforced Model Router. [Route-and-Reason:借助强化模型路由器扩展大语言模型推理] arXiv:2506.05901. https://arxiv.org/abs/2506.05901
[8] Evertz, J., Chlosta, M., Schönherr, L., & Eisenhofer, T. (2024). Whispers in the Machine: Confidentiality in Agentic Systems. [机器中的低语:智能体系统中的保密性] arXiv:2402.06922. https://arxiv.org/abs/2402.06922
[9] Sharma, R. & Mehta, M. (2025). Small Language Models for Agentic Systems: A Survey of Architectures, Capabilities, and Deployment Trade-offs. [面向智能体系统的小型语言模型:架构、能力与部署权衡综述] arXiv:2510.03847. https://arxiv.org/abs/2510.03847
[10] Belcak, P. et al. (2025). Small Language Models are the Future of Agentic AI. [小型语言模型是智能体 AI 的未来] arXiv:2506.02153. https://arxiv.org/abs/2506.02153
