

Comment les petits modèles propulsent l’IA agentique
 Toni Lopez Co-Founder at Karumi
L’intelligence artificielle vit un changement de paradigme. Pendant des années, la logique dominante était « plus c’est gros, mieux c’est » : des modèles de plusieurs centaines de milliards de paramètres (les LLM de pointe) qui cherchaient à exceller en tout. Et, de fait, ils ont accompli des choses impressionnantes en conversation générale et en raisonnement. Mais les priorités ont changé. Il ne s’agit plus seulement de répondre à des questions, mais de construire des systèmes agentiques : des IA autonomes qui planifient, appellent des API, exécutent du code, manipulent des données structurées et enchaînent les décisions. Dans ce contexte, les modèles géants se révèlent coûteux, lents et surdimensionnés.
Cet article défend l’idée que les Small Language Models (moins de 12 milliards de paramètres) et les Medium Language Models (de 13 à 70 milliards de paramètres) ne sont pas seulement suffisants pour les tâches agentiques : avec le bon entraînement et les bonnes techniques, ils peuvent même surpasser les plus grands. Dans de prochains articles, nous décortiquerons chacune de ces innovations et les expliquerons simplement, pour tous. Aujourd’hui, nous voulons montrer comment et pourquoi les petits et moyens modèles de langage vont devenir la prochaine révolution du secteur.
1. Économie et efficacité opérationnelle
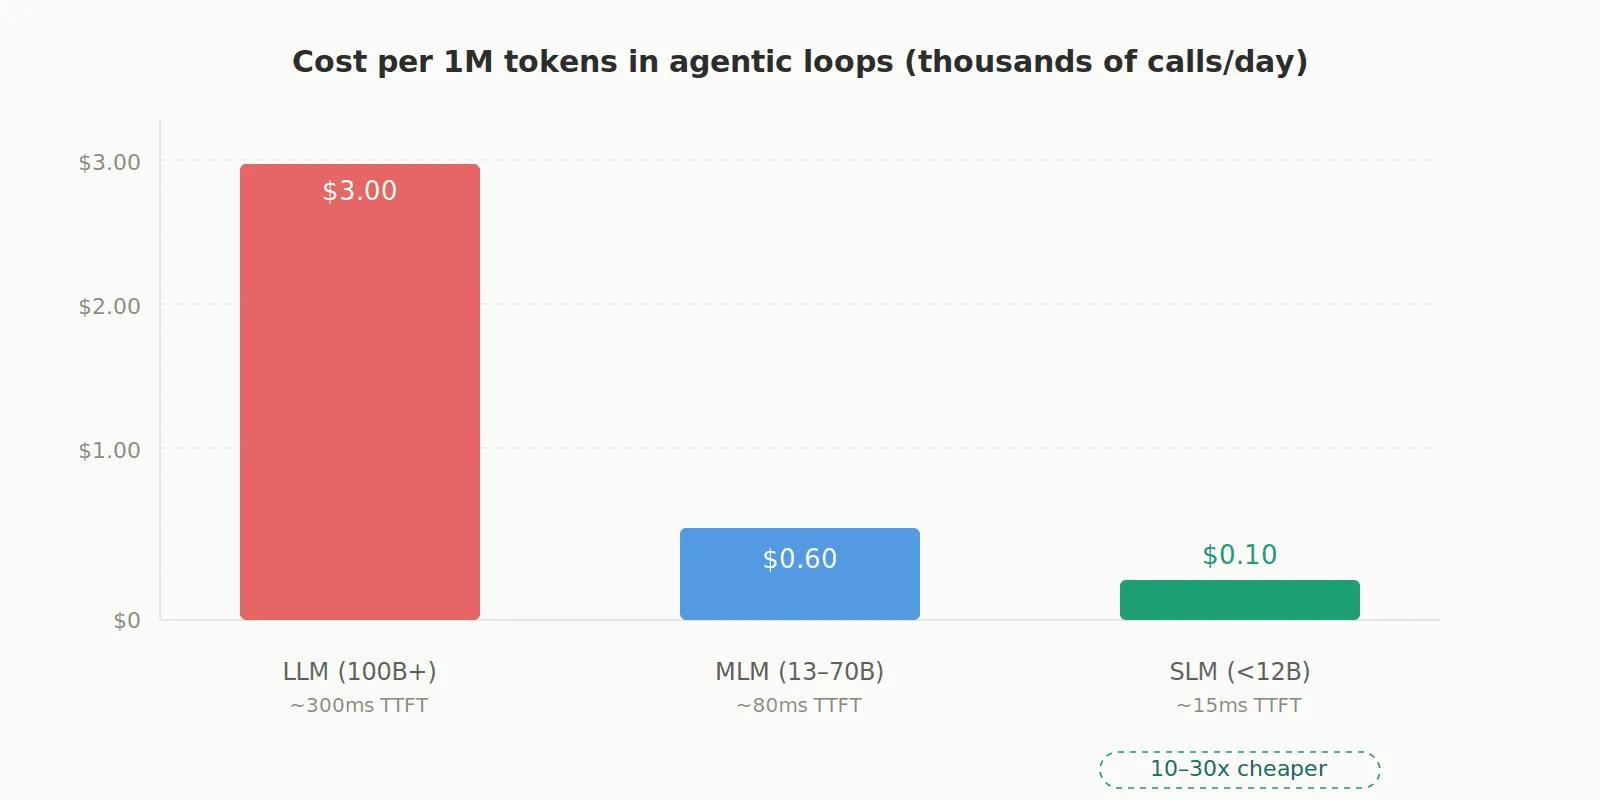
Un système agentique ne se contente pas d’une seule requête : il enchaîne des milliers d’appels dans des boucles serrées. Utiliser un modèle de plus de 100 milliards de paramètres pour cela, c’est comme prendre une Formule 1 pour faire ses courses. Les SLM coûtent de 10 à 30 fois moins cher par token, offrent une latence minimale (un time-to-first-token bien plus court) et peuvent même tourner sur CPU ou sur mobile. Ils rendent aussi possible le déploiement en périphérie (edge) : exécuter l’IA en local sans dépendre du cloud, ce qui règle les questions de confidentialité, de souveraineté des données et de latence.
2. Les compétences agentiques ne demandent pas une échelle massive
En réalité, un modèle agentique n’a pas besoin d’écrire des poèmes ou des histoires. Ce dont un agent a besoin, en quelques mots : des appels de fonctions corrects, la génération de JSON valide, le respect strict d’un schéma et la capacité d’exécuter du code. Aujourd’hui, les SLM savent parfaitement produire des sorties formatées ; les exemples que j’ai trouvés s’appuient sur des techniques de décodage contraint (XGrammar ou Outlines sont des bibliothèques qui proposent ce type de techniques), ce qui permet aux SLM de combler l’écart avec les modèles de pointe.
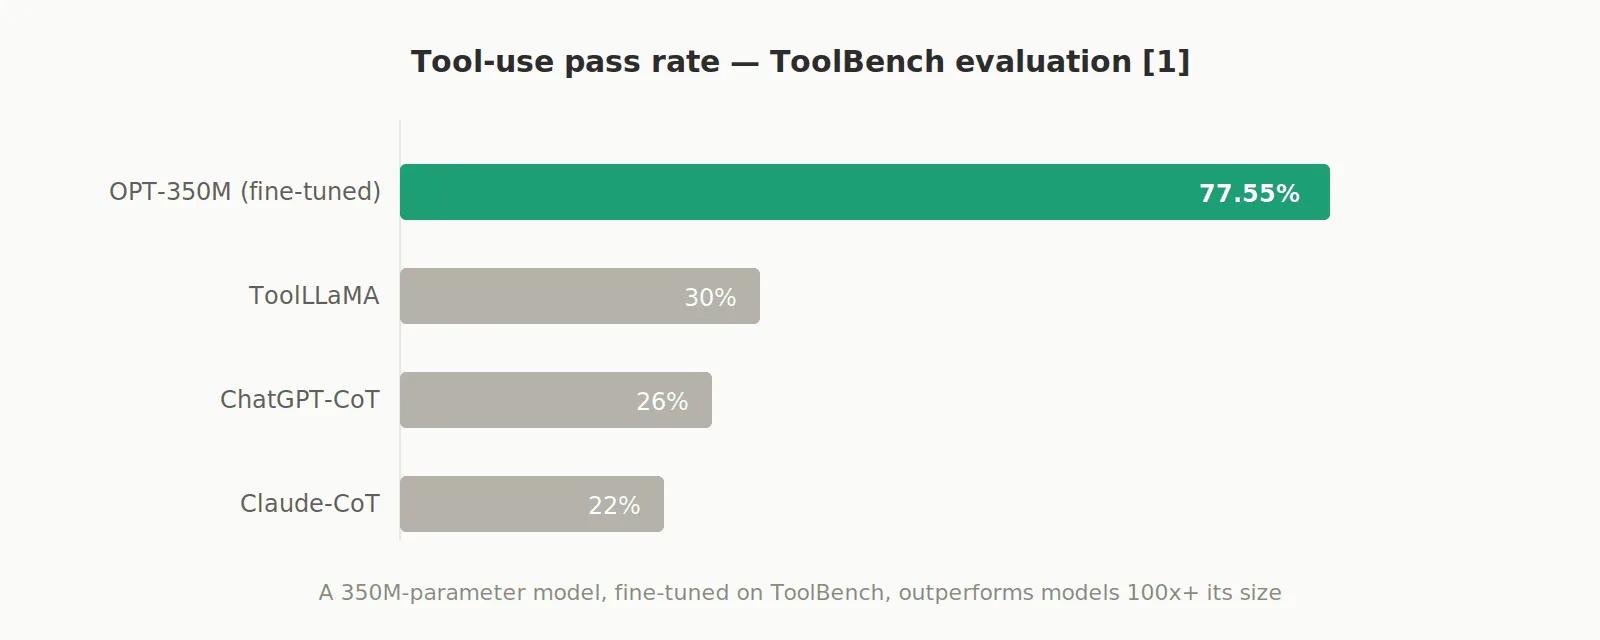
Prenons l’exemple d’un modèle de seulement 350 millions de paramètres (OPT-350M), affiné sur les données ToolBench : il a atteint un taux de réussite de 77,55 % aux évaluations d’utilisation d’outils, loin devant ChatGPT-CoT (26 %), ToolLLaMA (30 %) et Claude-CoT [1].
3. Les innovations d’architecture clés
Certaines architectures sont bien connues dans le secteur, mais ce qui est intéressant, c’est la façon dont elles sont appliquées pour obtenir de meilleures performances avec les SLM.
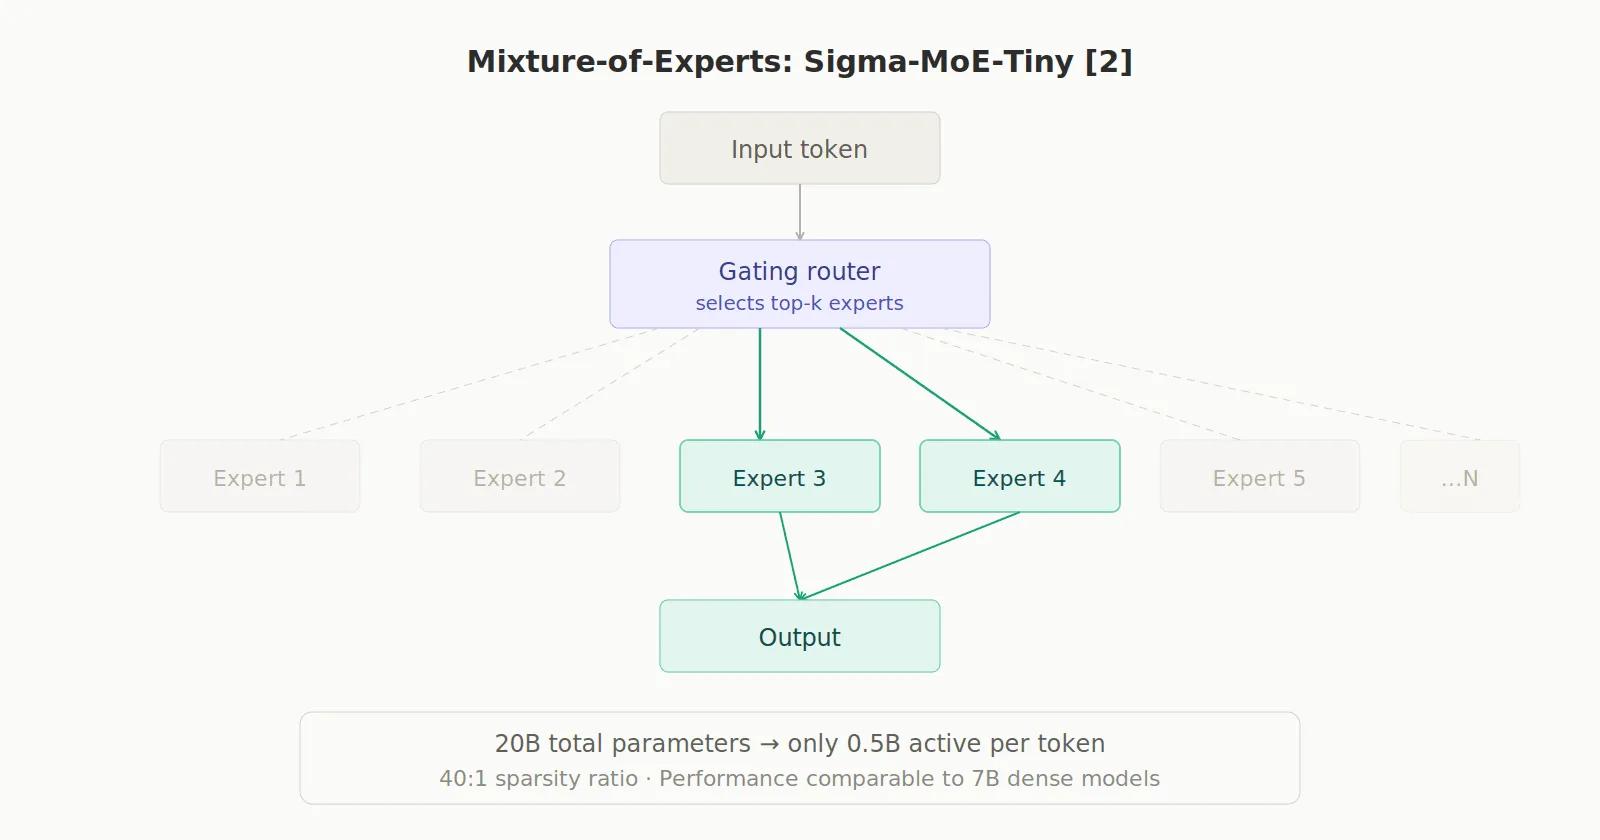
Mixture-of-Experts (MoE) : des modèles comme Sigma-MoE-Tiny comptent 20 milliards de paramètres au total, mais n’en activent que 0,5 milliard par token (un ratio de 40:1). Ils atteignent ainsi des performances comparables à celles de modèles denses de 7 milliards de paramètres en mathématiques et en code, pour une fraction du calcul. [2]
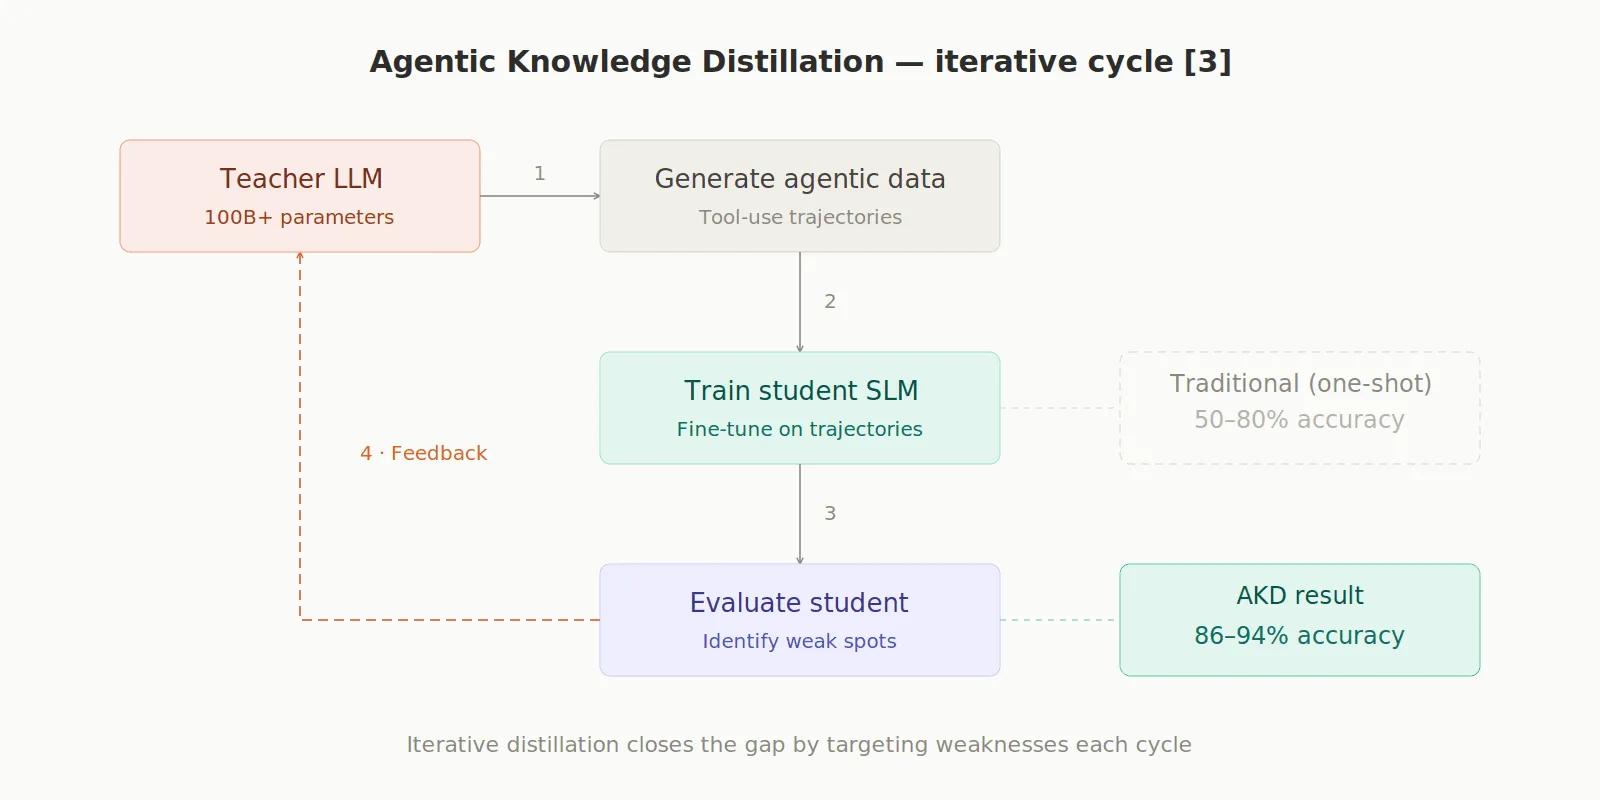
Agentic Knowledge Distillation (AKD) : un grand LLM joue le rôle de « professeur autonome » qui génère des données, évalue le petit modèle et l’entraîne de manière itérative. Les modèles distillés de cette façon atteignent 86 à 94 % de précision sur des tâches de sécurité, contre 50 à 80 % avec les méthodes traditionnelles. [3]
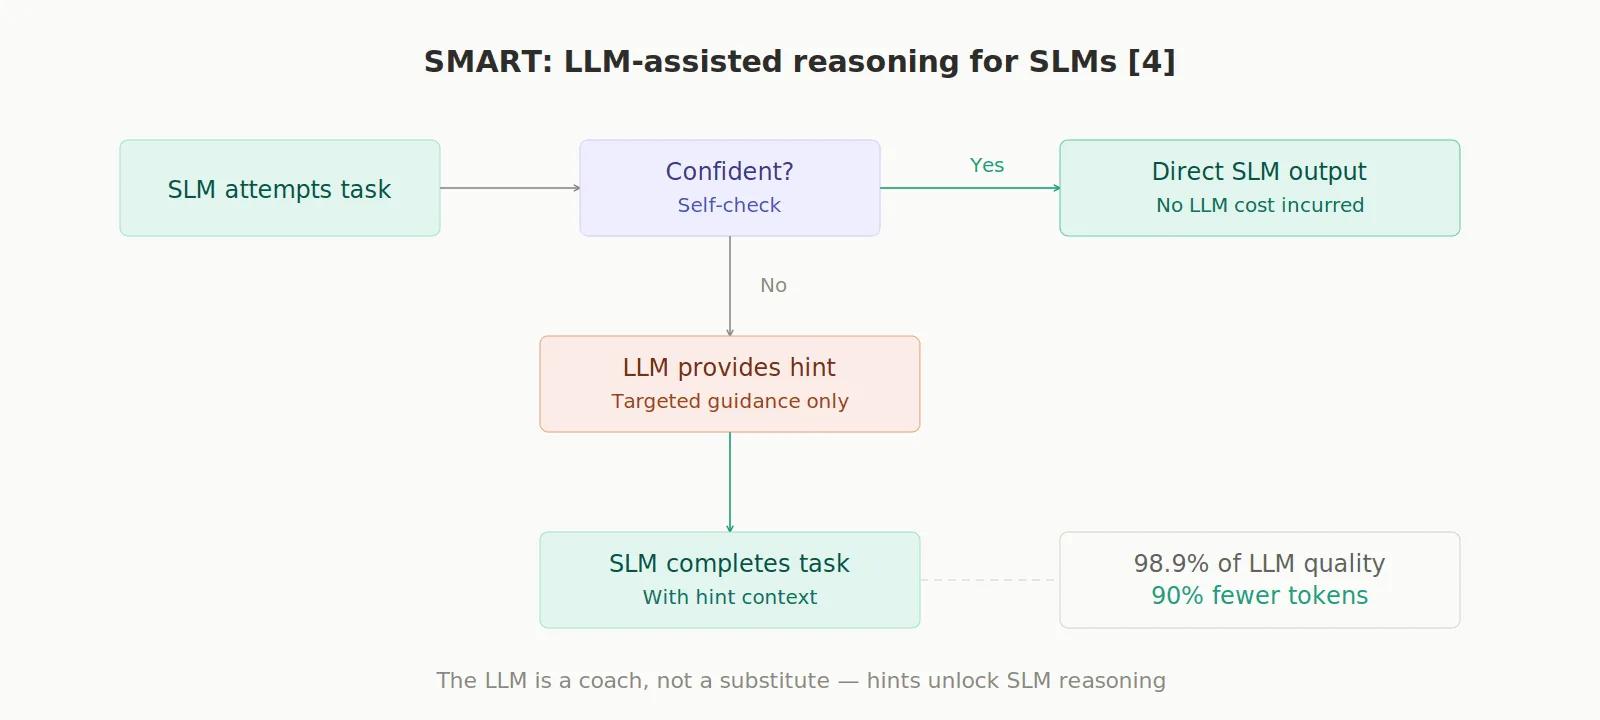
Framework SMART : lorsqu’un SLM bloque sur un raisonnement complexe, le grand LLM n’est sollicité que pour fournir un « indice » ciblé, pas pour tout résoudre. On atteint ainsi 98,9 % des performances du grand LLM avec 90 % de tokens en moins. [4]
4. Benchmarks
Les benchmarks permettent d’estimer la qualité des modèles sur des tâches précises et de s’assurer de leur fiabilité.
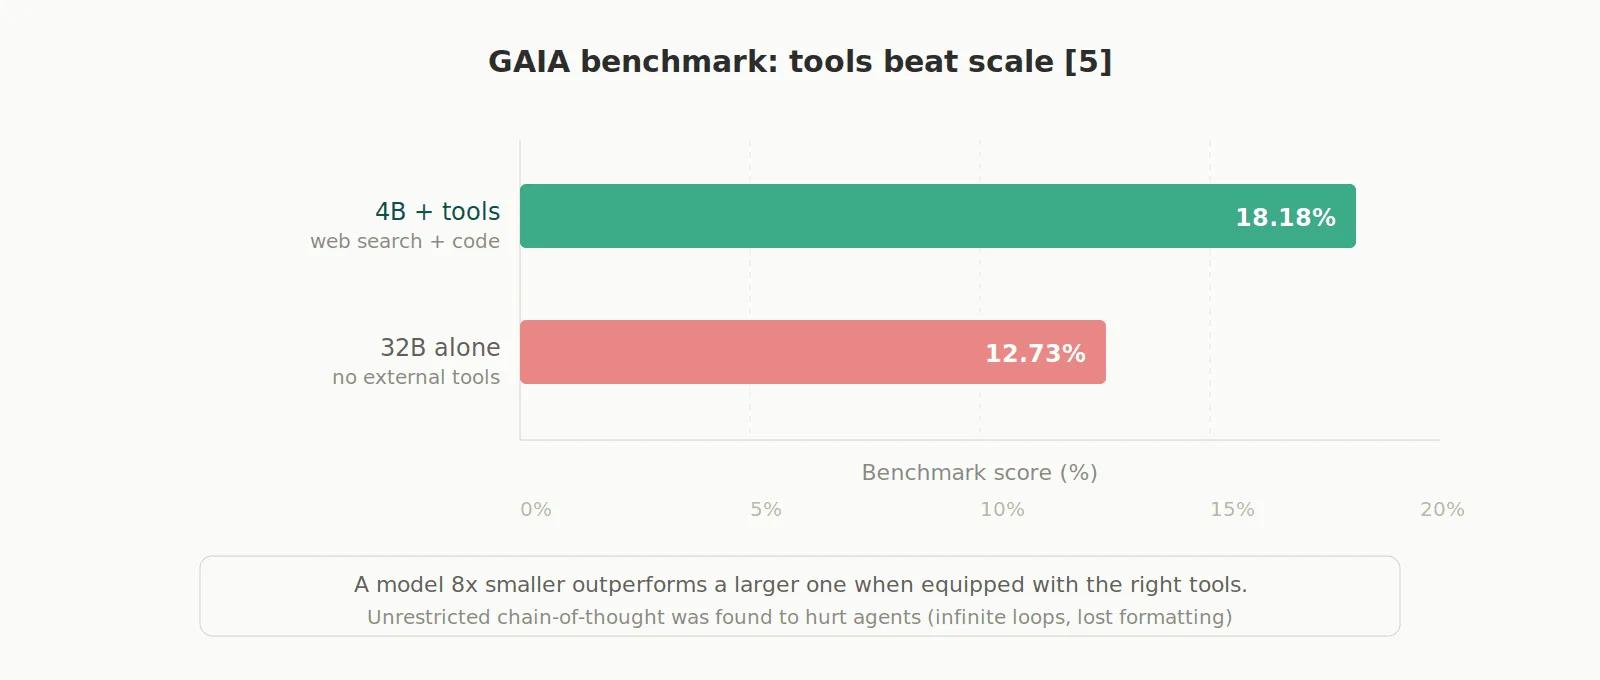
Sur le benchmark GAIA, des modèles de 4 milliards de paramètres équipés d’outils (recherche web, exécution de code) ont surpassé des modèles de 32 milliards sans outils (18,18 % contre 12,73 %). Par ailleurs, un « raisonnement complet » sans limite (chain-of-thought non contrainte) s’est révélé nuisible aux agents : il les fait entrer dans des boucles infinies et perdre le formatage. Mieux vaut limiter le raisonnement à la seule phase de planification. [5]
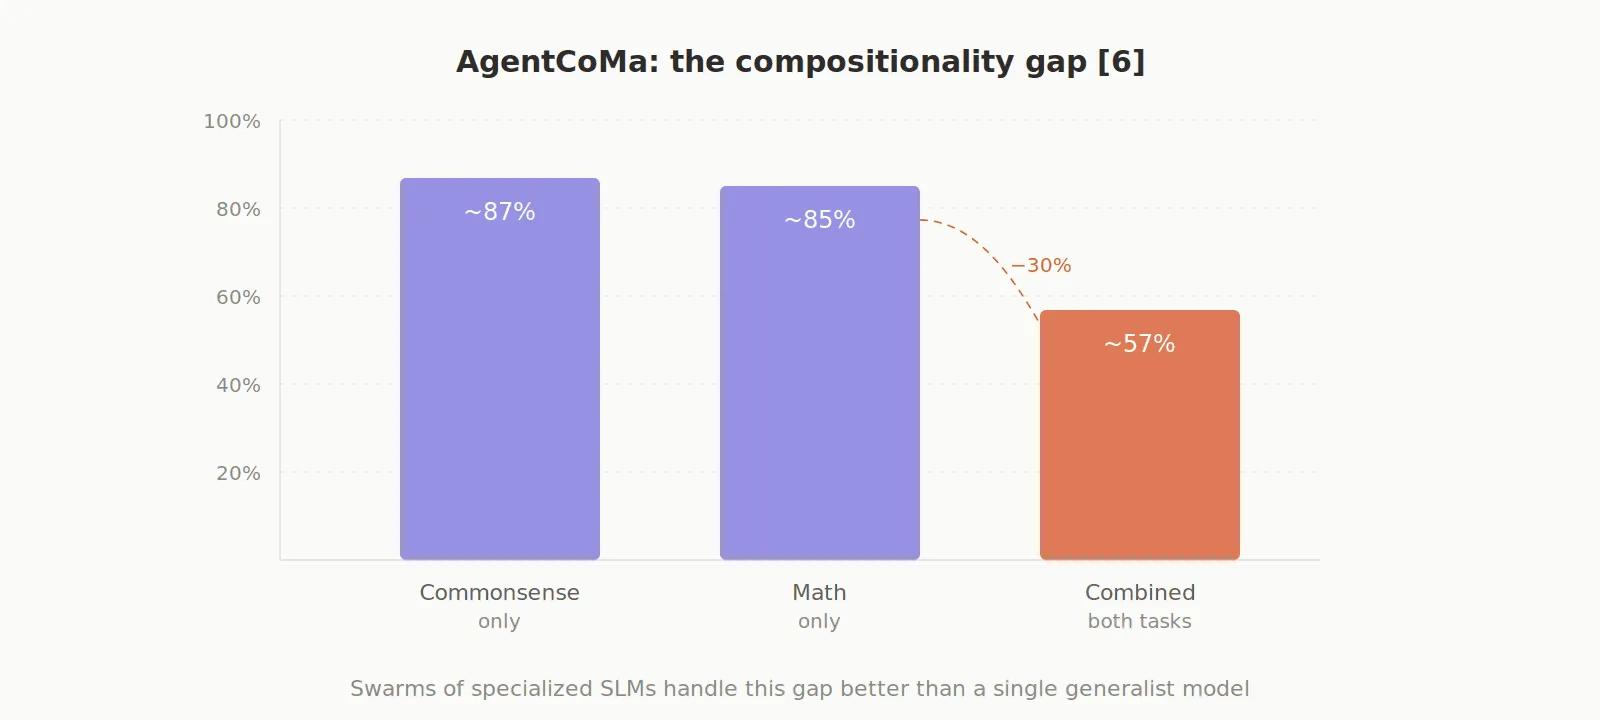
Le benchmark AgentCoMa a mis au jour un autre problème : l’écart de compositionnalité. Les modèles savent résoudre séparément des étapes de sens commun et des étapes mathématiques (~85 % et plus), mais lorsque les deux sont combinées dans une même tâche, les performances chutent d’environ 30 %. Un essaim de SLM spécialisés répond mieux à ce problème qu’un unique modèle généraliste géant. [6]
5. Architectures multi-agents
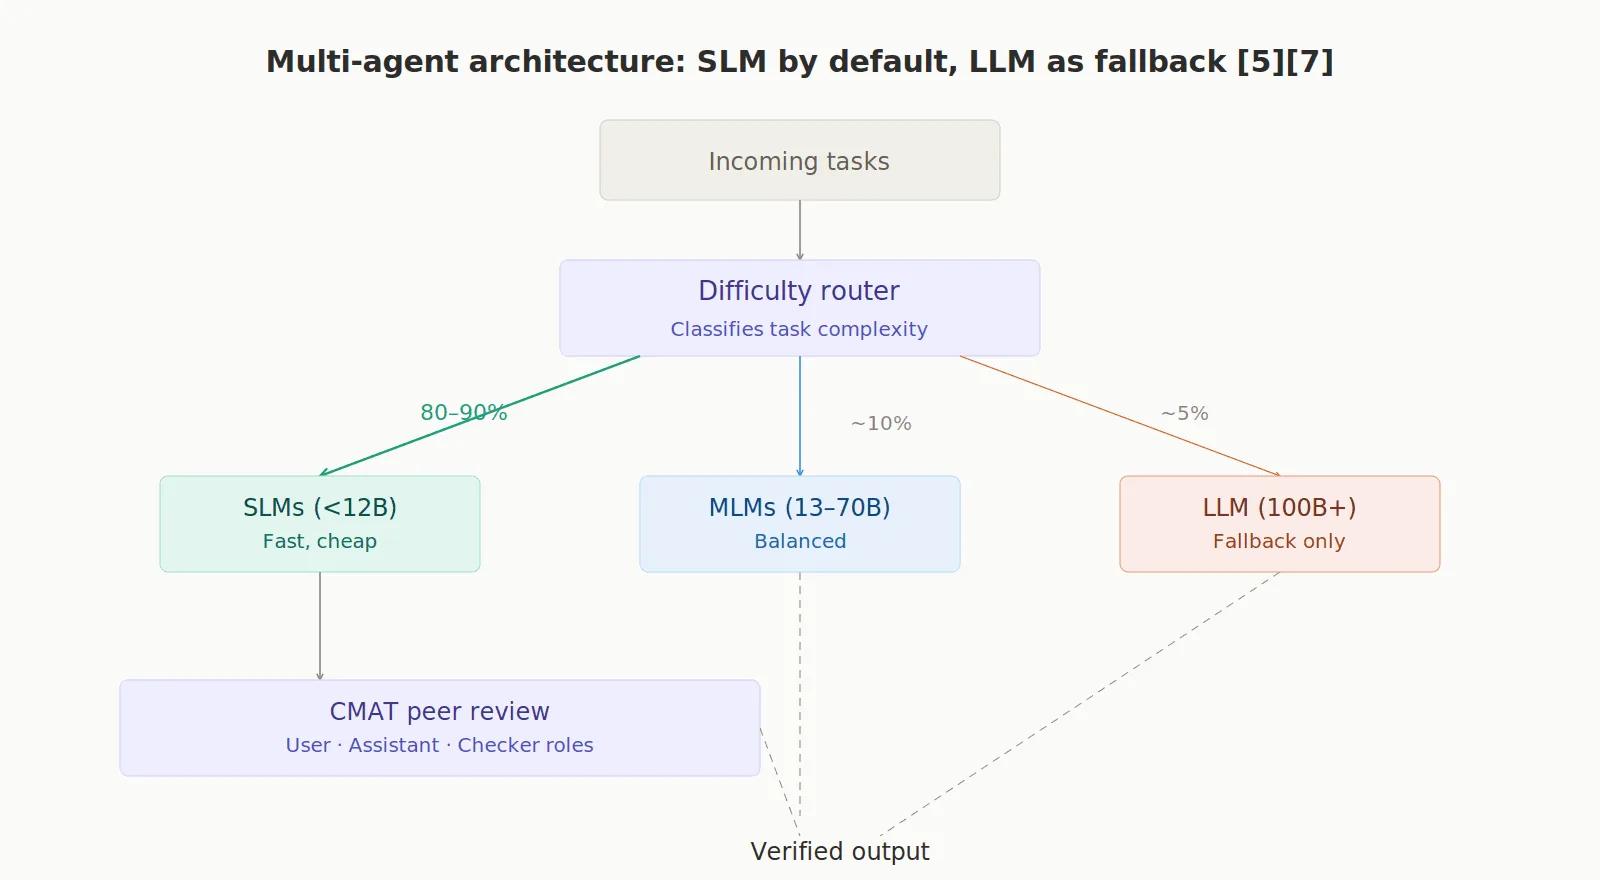
Le modèle opérationnel idéal : « le SLM par défaut, le LLM en dernier recours ». Un routeur classe les tâches par difficulté : les plus simples vont aux SLM peu coûteux, les intermédiaires aux MLM, et seules les tâches vraiment complexes remontent au grand LLM. Ainsi, 80 à 90 % de la charge de travail est traitée par des SLM. Des frameworks comme CMAT attribuent des rôles (User, Assistant, Checker) à différents SLM qui se relisent mutuellement. [7]
6. Sécurité
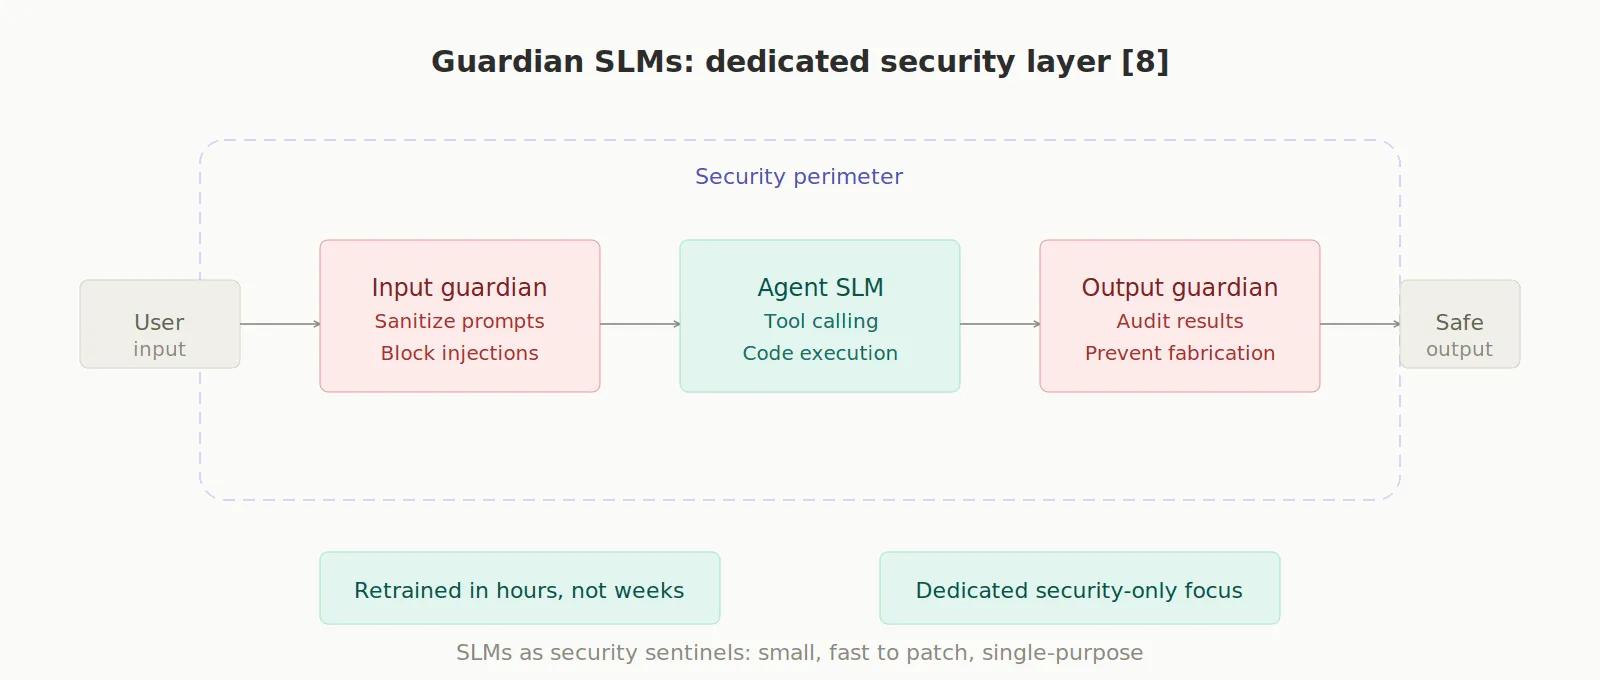
Des agents autonomes ayant accès à des API et à des bases de données constituent de sérieux vecteurs d’attaque. Les SLM ont ici un avantage : on peut les corriger et les réentraîner en quelques heures. On peut aussi déployer des « SLM gardiens », des modèles exclusivement dédiés à assainir les entrées, auditer les sorties et empêcher les injections de prompt et la fabrication d’enregistrements. [8]
Conclusion
L’avenir de l’IA agentique repose sur quatre principes clés qui s’éloignent du traditionnel modèle géant et centralisé.
D’abord, l’accent est mis sur les avantages en coût et en latence : les modèles plus petits (SLM/MLM, de 1 à 70 milliards de paramètres) sont privilégiés parce qu’ils réduisent drastiquement les coûts, accélèrent les traitements et améliorent l’efficacité énergétique, ce qui rend un fonctionnement autonome et continu réaliste et scalable.
Cette efficacité mène directement au deuxième principe : l’augmentation par les outils plutôt que la taille brute. Les meilleures performances ne viennent pas de modèles isolés toujours plus grands, mais de l’intégration systématique de modèles plus petits avec des outils programmatiques, une synergie qui surpasse régulièrement les modèles monolithiques.
Troisièmement, la nécessité de la spécialisation s’impose : les modèles généralistes se montrent inadaptés à la grande variété des tâches de raisonnement complexe. Un « essaim » de SLM spécialisés, coordonnés intelligemment par un mécanisme de routage efficace, est la solution la plus efficace.
Enfin, le rôle de l’architecture dans l’efficacité est primordial : des techniques avancées comme l’Extreme MoE, la distillation agentique et l’échafaudage cognitif permettent de condenser l’intelligence et les capacités des modèles de pointe dans des moteurs d’exécution très compacts et efficaces.
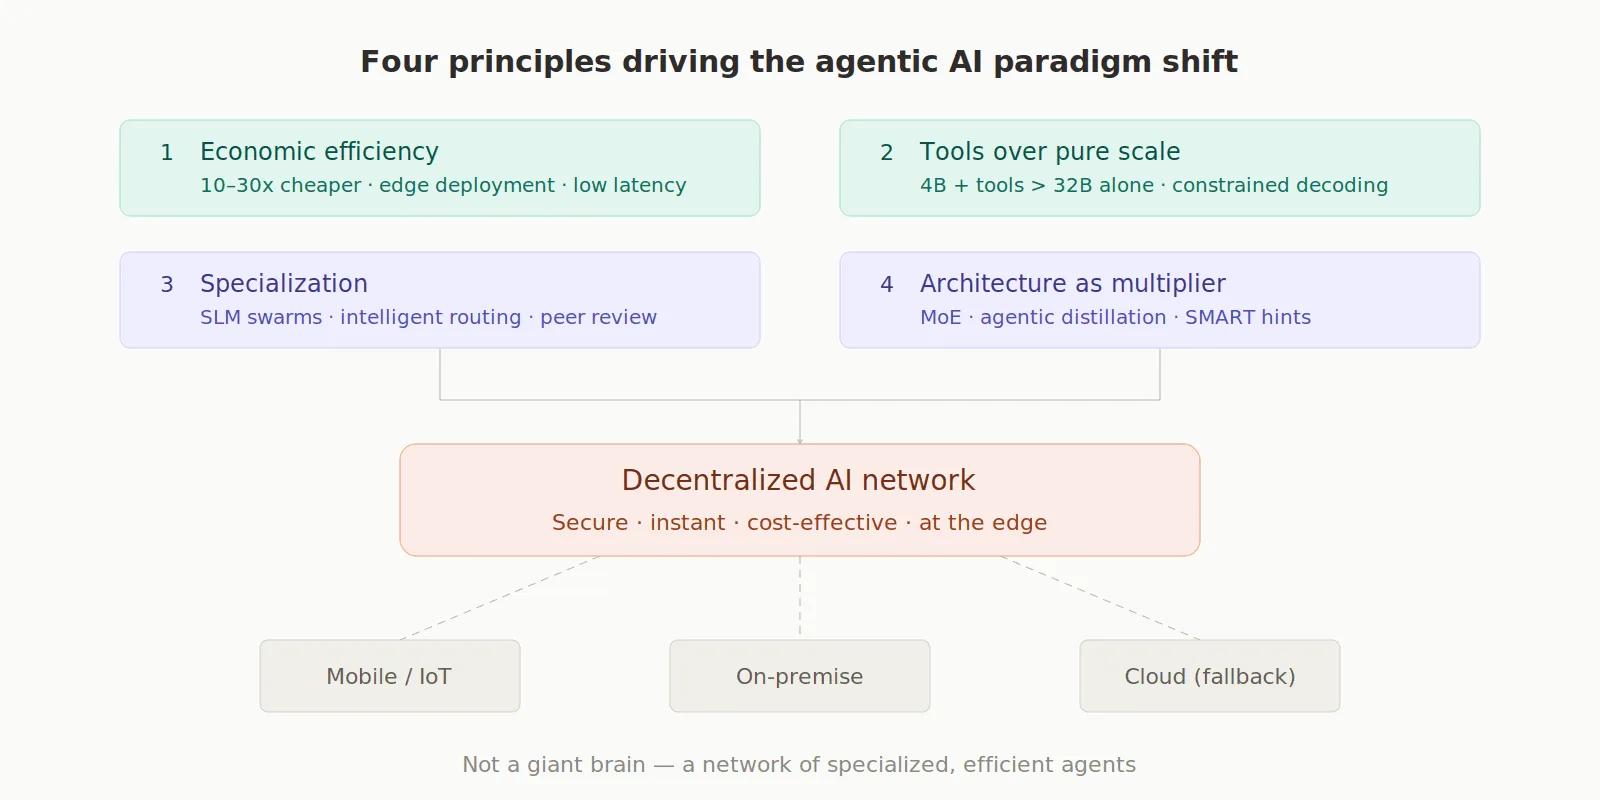
Ce changement de paradigme signifie que l’avenir de l’IA agentique n’est pas un « cerveau géant » centralisé, mais un réseau décentralisé de petits et moyens modèles qui fonctionnent de manière sûre, instantanée et économique en périphérie du réseau.
Références
[1] Jhandi, P., Kazi, O., Subramanian, S., & Sendas, N. (2025). Small Language Models for Efficient Agentic Tool Calling: Outperforming Large Models with Targeted Fine-tuning. [Des petits modèles de langage pour un appel d’outils agentique efficace : surpasser les grands modèles grâce à un fine-tuning ciblé] arXiv:2512.15943. https://arxiv.org/abs/2512.15943
[2] Hu, Q., Lin, Z., Yang, Z., Ding, Y., Liu, X., Jiang, Y., Wang, R., Chen, T., Guo, Z., Xiong, Y., Gao, R., Qu, L., Su, J., Cheng, P., & Gong, Y. (2025). Sigma-MoE-Tiny Technical Report. [Rapport technique de Sigma-MoE-Tiny] arXiv:2512.16248. https://arxiv.org/abs/2512.16248
[3] Kang, M., Jeong, J., Lee, S., Cho, J., & Hwang, S. J. (2025). Distilling LLM Agent into Small Models with Retrieval and Code Tools. [Distiller un agent LLM dans de petits modèles avec des outils de recherche et de code] arXiv:2505.17612. https://arxiv.org/abs/2505.17612
[4] Kim, Y., Yi, E., Kim, M., Yun, S.-Y., & Kim, T. (2025). Guiding Reasoning in Small Language Models with LLM Assistance. [Guider le raisonnement des petits modèles de langage avec l’aide d’un LLM] arXiv:2504.09923. https://arxiv.org/abs/2504.09923
[5] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2026). Can Small Agent Collaboration Beat a Single Big LLM?. [La collaboration de petits agents peut-elle battre un seul grand LLM ?] arXiv:2601.11327. https://arxiv.org/abs/2601.11327
[6] Alazraki, L., Chen, L., Brassard, A., Stacey, J., Rahmani, H. A., & Rei, M. (2025). AgentCoMa: A Compositional Benchmark Mixing Commonsense and Mathematical Reasoning in Real-World Scenarios. [AgentCoMa : un benchmark compositionnel mêlant sens commun et raisonnement mathématique en situation réelle] arXiv:2508.19988. https://arxiv.org/abs/2508.19988
[7] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2025). Route-and-Reason: Scaling Large Language Model Reasoning with Reinforced Model Router. [Route-and-Reason : faire passer à l’échelle le raisonnement des LLM avec un routeur de modèles renforcé] arXiv:2506.05901. https://arxiv.org/abs/2506.05901
[8] Evertz, J., Chlosta, M., Schönherr, L., & Eisenhofer, T. (2024). Whispers in the Machine: Confidentiality in Agentic Systems. [Murmures dans la machine : la confidentialité dans les systèmes agentiques] arXiv:2402.06922. https://arxiv.org/abs/2402.06922
[9] Sharma, R. & Mehta, M. (2025). Small Language Models for Agentic Systems: A Survey of Architectures, Capabilities, and Deployment Trade-offs. [Les petits modèles de langage pour les systèmes agentiques : panorama des architectures, capacités et compromis de déploiement] arXiv:2510.03847. https://arxiv.org/abs/2510.03847
[10] Belcak, P. et al. (2025). Small Language Models are the Future of Agentic AI. [Les petits modèles de langage sont l’avenir de l’IA agentique] arXiv:2506.02153. https://arxiv.org/abs/2506.02153
