

Wie kleinere Modelle agentische KI antreiben
 Toni Lopez Co-Founder at Karumi
Die künstliche Intelligenz erlebt einen Paradigmenwechsel. Jahrelang galt die Logik „größer = besser“: Modelle mit Hunderten Milliarden Parametern (Frontier-LLMs), die in allem gut sein sollten. Und ja, in allgemeiner Konversation und im logischen Schlussfolgern haben sie Beeindruckendes erreicht. Doch der Fokus hat sich verschoben. Es geht nicht mehr nur darum, Fragen zu beantworten, sondern agentische Systeme zu bauen: autonome KIs, die planen, APIs aufrufen, Code ausführen, mit strukturierten Daten arbeiten und verkettete Entscheidungen treffen. In diesem Kontext erweisen sich riesige Modelle als teuer, langsam und überdimensioniert.
Dieser Beitrag vertritt die These, dass Small Language Models (unter 12 Mrd. Parameter) und Medium Language Models (13 bis 70 Mrd. Parameter) für agentische Aufgaben nicht nur ausreichen: Mit dem richtigen Training und den passenden Techniken können sie die großen sogar übertreffen. In künftigen Beiträgen nehmen wir jede dieser Innovationen einzeln unter die Lupe und erklären sie verständlich für alle. Heute wollen wir zeigen, wie und warum kleine und mittlere Sprachmodelle zum nächsten großen Ding der Branche werden.
1. Wirtschaftlichkeit und operative Effizienz
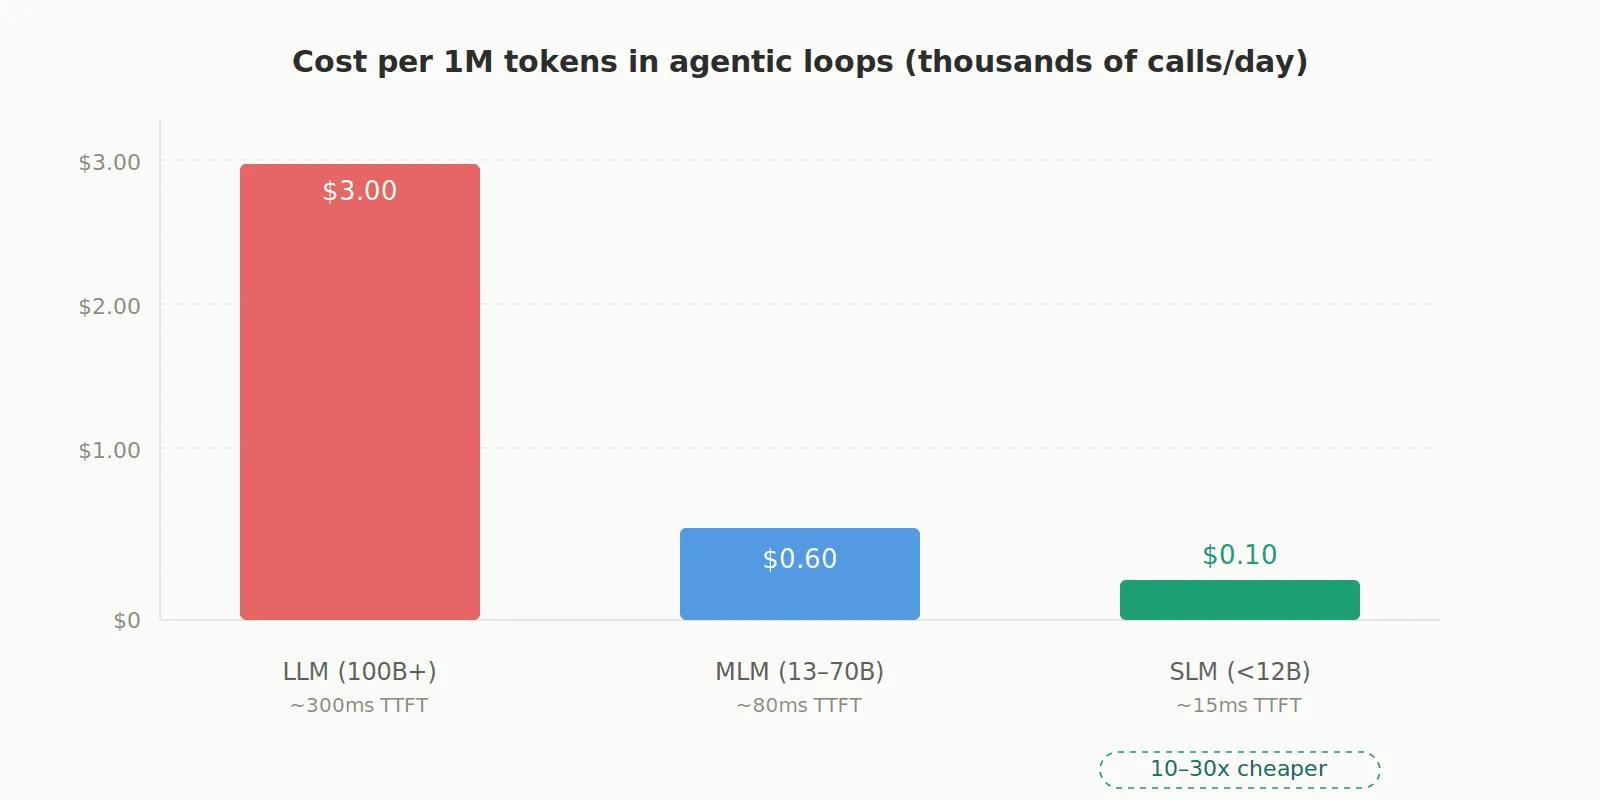
Agentische Systeme stellen nicht nur eine einzelne Anfrage, sie führen Tausende Aufrufe in engen Schleifen aus. Dafür ein Modell mit über 100 Mrd. Parametern einzusetzen, ist, als würde man mit einem Formel-1-Wagen zum Einkaufen fahren. SLMs sind pro Token 10- bis 30-mal günstiger, haben minimale Latenz (eine deutlich kürzere Time-to-First-Token) und laufen sogar auf CPUs oder Mobilgeräten. Das ermöglicht auch Edge-Deployment: KI lokal auszuführen, ohne von der Cloud abhängig zu sein – und damit Fragen zu Datenschutz, Datensouveränität und Latenz zu lösen.
2. Agentische Fähigkeiten brauchen keine massive Größe
Tatsächlich muss ein agentisches Modell keine Gedichte oder Geschichten schreiben. Was ein Agent kurz gesagt braucht: korrekte Funktionsaufrufe, valides JSON, strikte Schema-Treue und die Möglichkeit, Code auszuführen. Heute können SLMs formatierte Ausgaben einwandfrei erzeugen; die Beispiele, die ich gefunden habe, nutzen Constrained-Decoding-Techniken (XGrammar oder Outlines sind Bibliotheken, die solche Techniken anbieten), mit denen SLMs den Abstand zu Frontier-Modellen schließen.
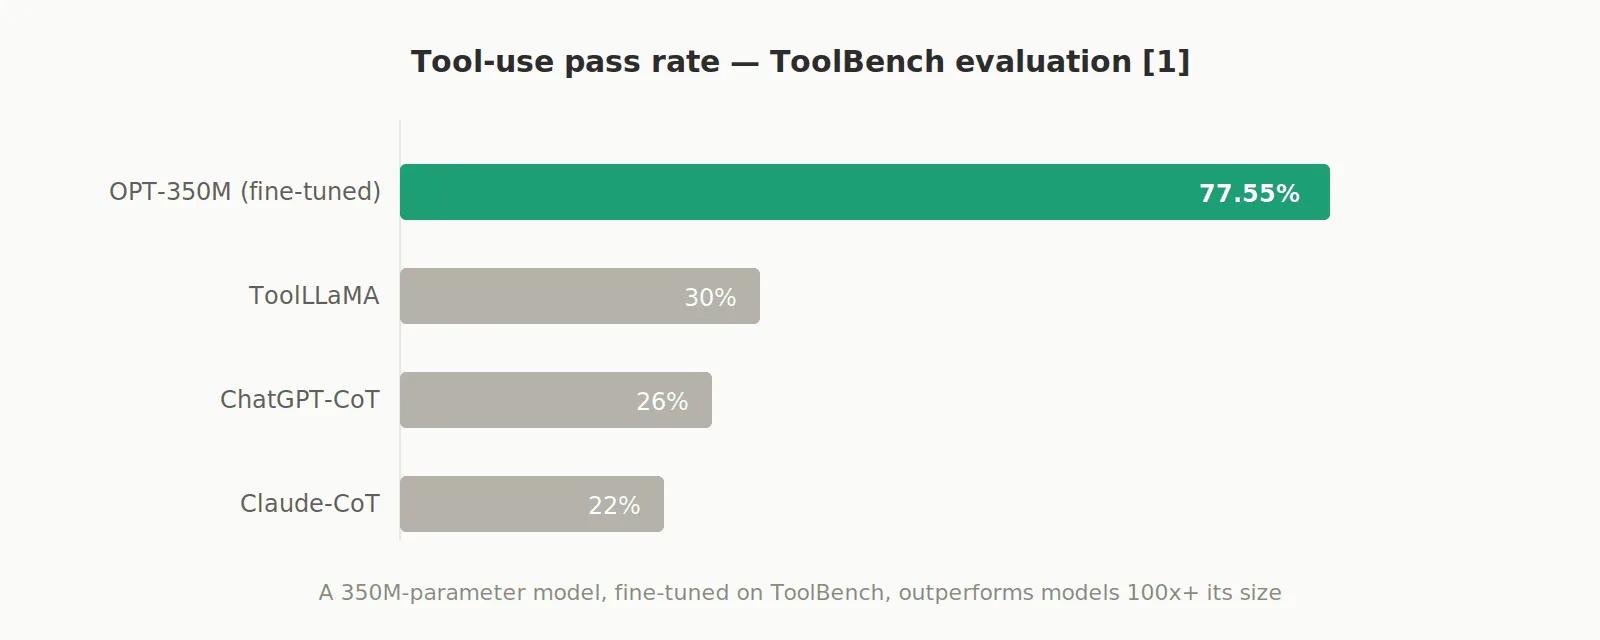
Ein Beispiel: Ein Modell mit nur 350 Millionen Parametern (OPT-350M), feinabgestimmt auf ToolBench-Daten, erreichte bei Tool-Use-Evaluierungen eine Erfolgsquote von 77,55 % und ließ ChatGPT-CoT (26 %), ToolLLaMA (30 %) und Claude-CoT weit hinter sich [1].
3. Zentrale Architektur-Innovationen
Manche Architekturen sind in der Branche längst bekannt – spannend ist, wie sie eingesetzt werden, um mit SLMs bessere Leistung zu erzielen.
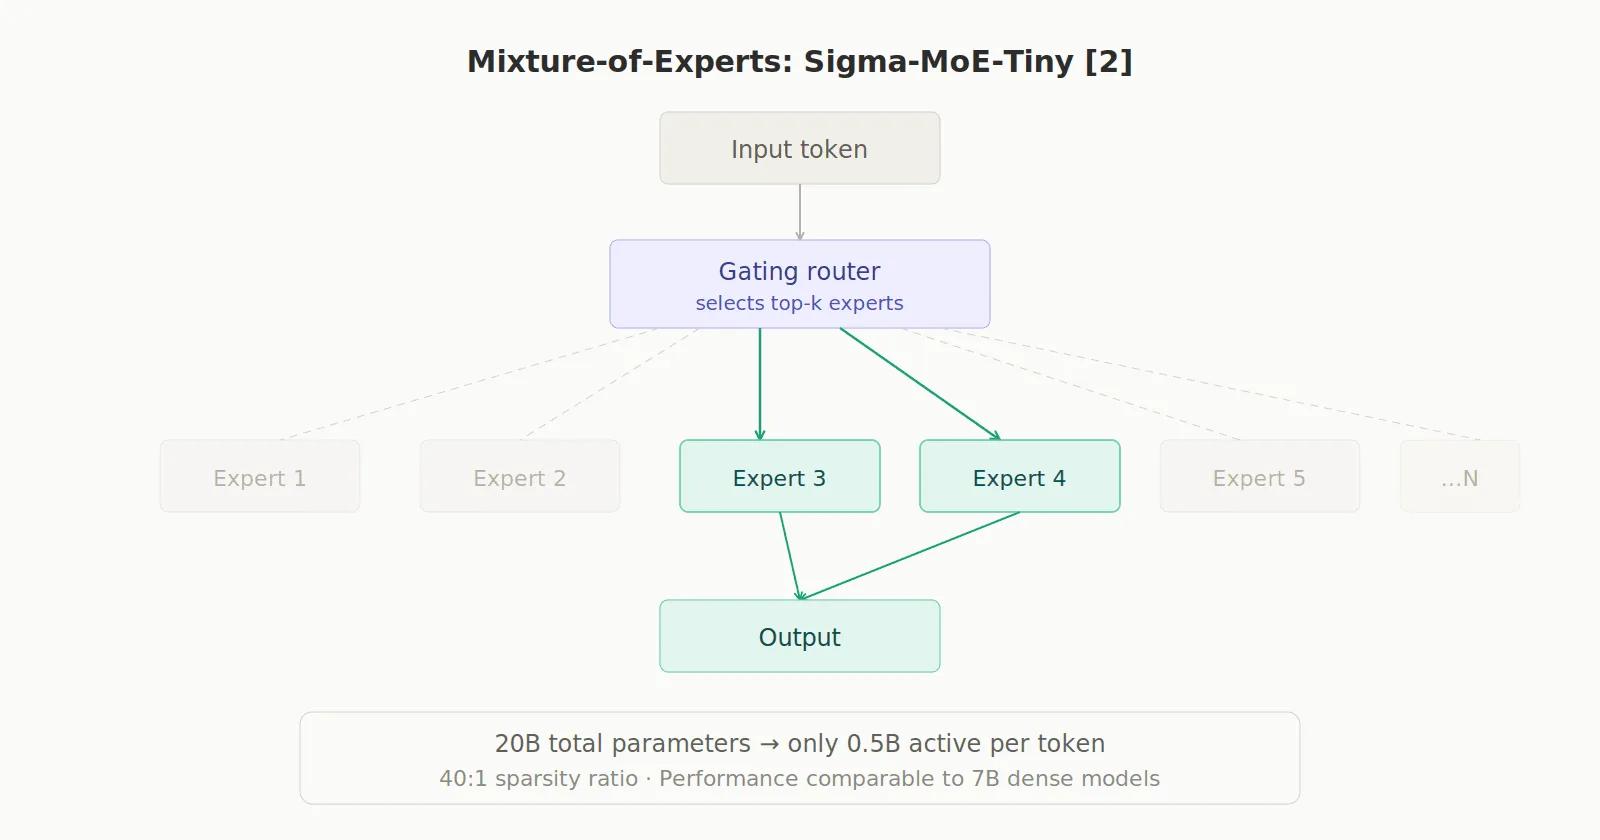
Mixture-of-Experts (MoE): Modelle wie Sigma-MoE-Tiny haben insgesamt 20 Mrd. Parameter, aktivieren aber nur 0,5 Mrd. pro Token (ein Verhältnis von 40:1). So erreichen sie in Mathematik und Programmierung eine Leistung vergleichbar mit dichten 7-Mrd.-Modellen – bei einem Bruchteil der Rechenleistung. [2]
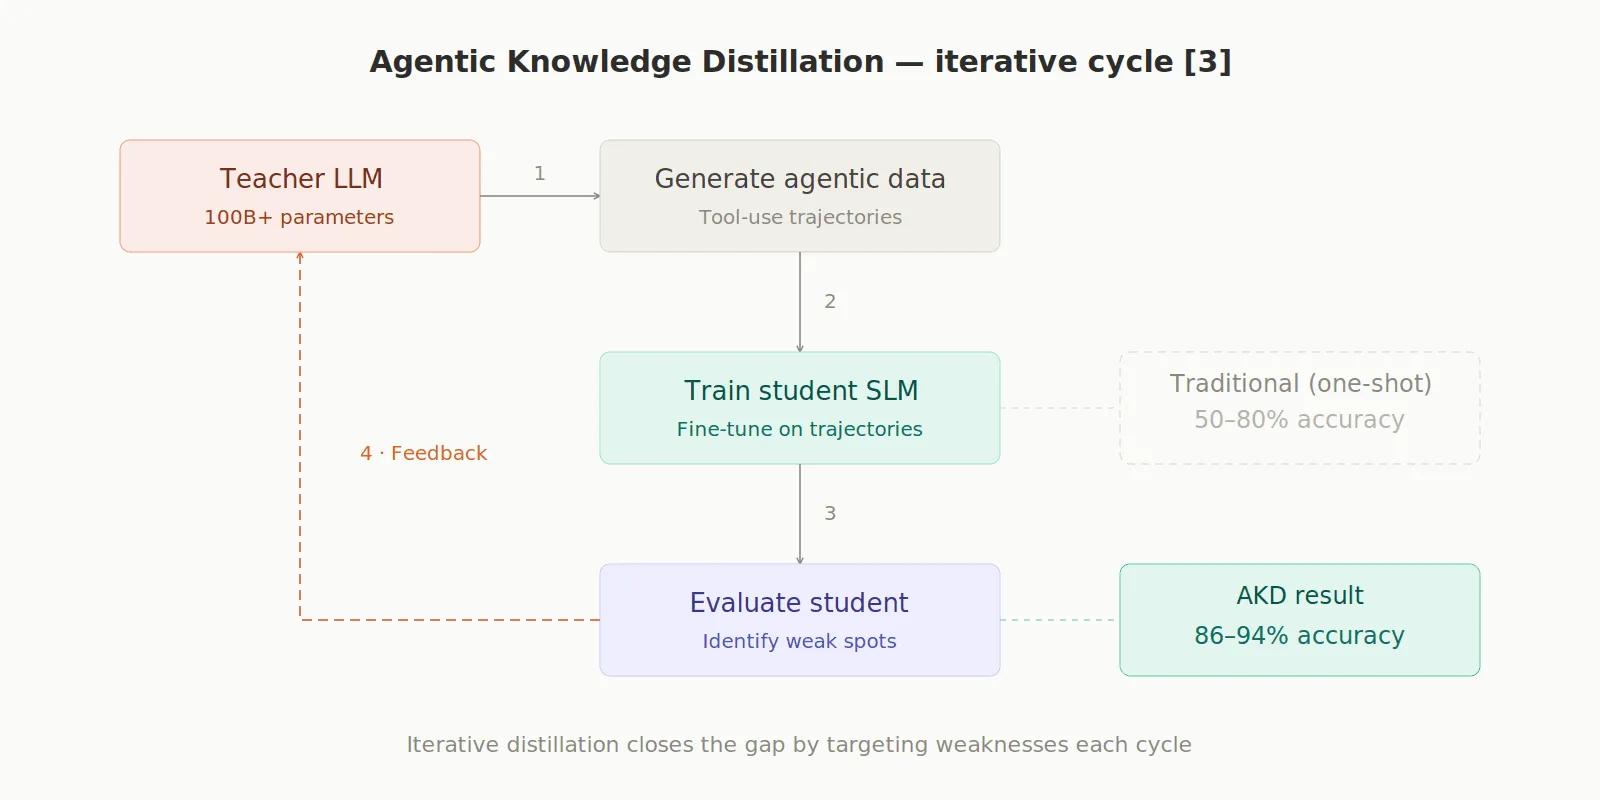
Agentic Knowledge Distillation (AKD): Ein großes LLM agiert als „autonomer Lehrer“, der Daten generiert, das kleine Modell bewertet und es iterativ trainiert. So destillierte Modelle erreichen bei Sicherheitsaufgaben 86–94 % Genauigkeit, gegenüber 50–80 % mit herkömmlichen Methoden. [3]
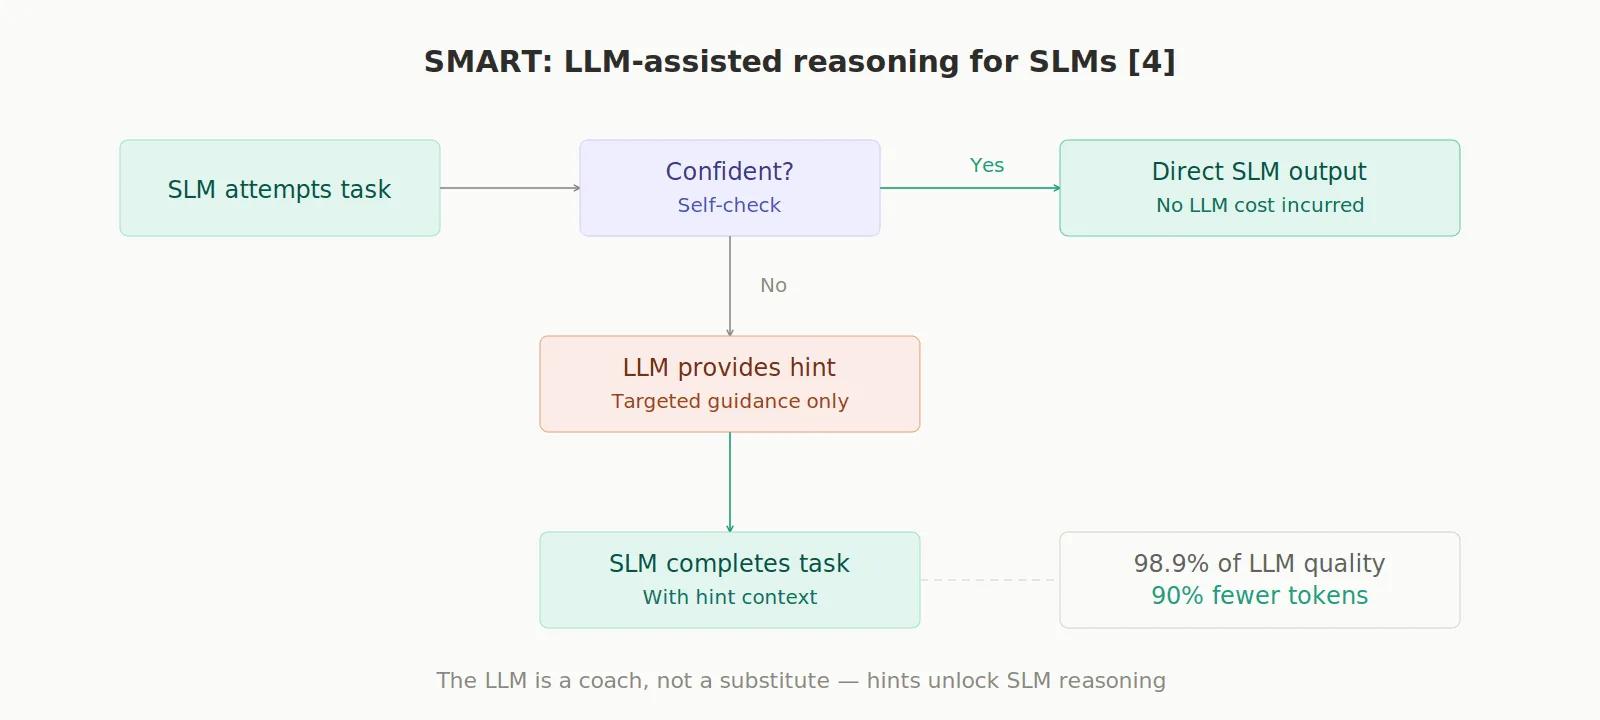
SMART-Framework: Wenn ein SLM bei komplexem Reasoning nicht weiterkommt, wird das große LLM nur hinzugezogen, um einen gezielten „Hinweis“ zu geben – nicht, um alles selbst zu lösen. So werden 98,9 % der Leistung des großen LLM erreicht, bei 90 % weniger Tokens. [4]
4. Benchmarks
Benchmarks zeigen, wie gut Modelle bestimmte Aufgaben lösen, und sichern so ihre Zuverlässigkeit ab.
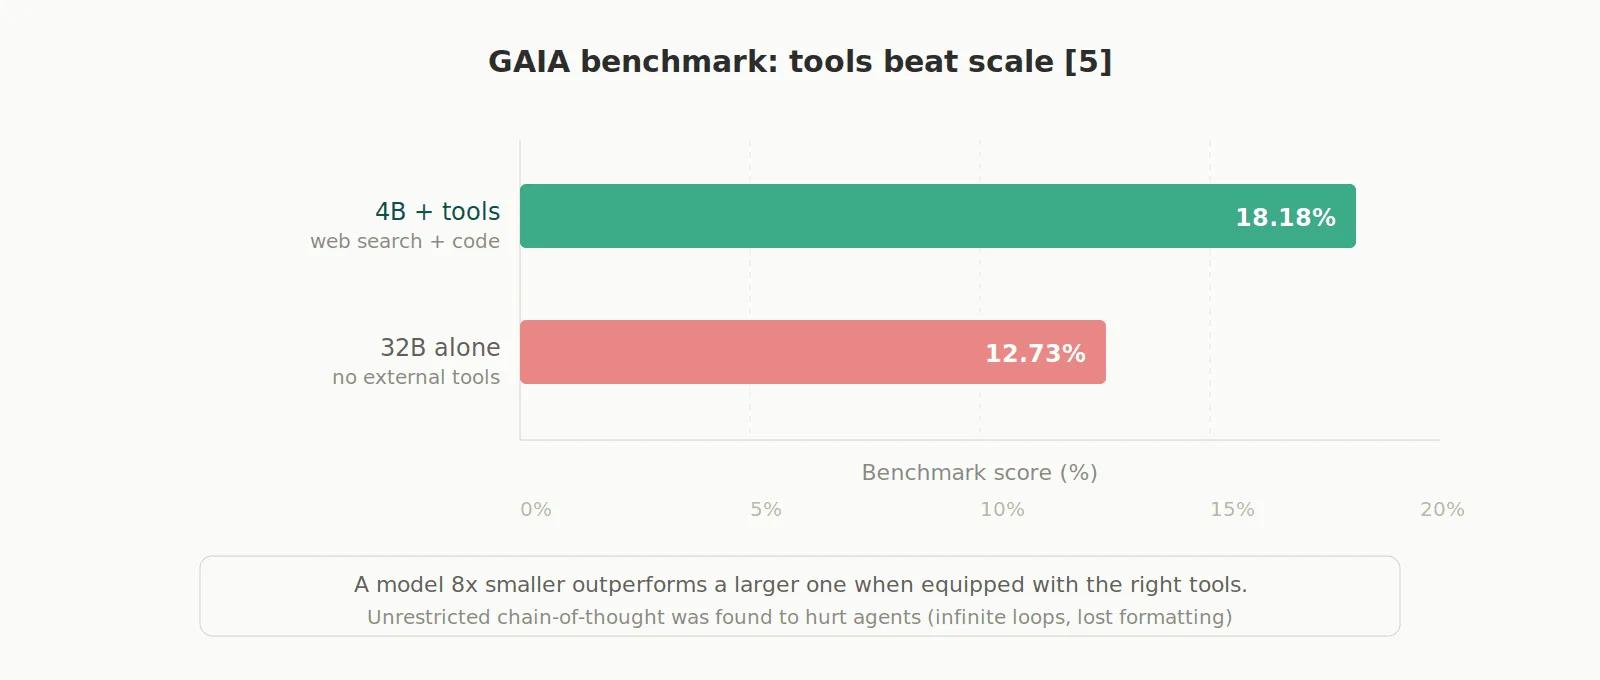
Im GAIA-Benchmark übertrafen 4-Mrd.-Modelle mit Tools (Websuche, Codeausführung) 32-Mrd.-Modelle ohne Tools (18,18 % vs. 12,73 %). Außerdem zeigte sich, dass uneingeschränktes „Full Thinking“ (Chain-of-Thought ohne Begrenzung) Agenten sogar schadet: Sie geraten in Endlosschleifen und verlieren die Formatierung. Besser ist es, das Reasoning auf die Planungsphase zu beschränken. [5]
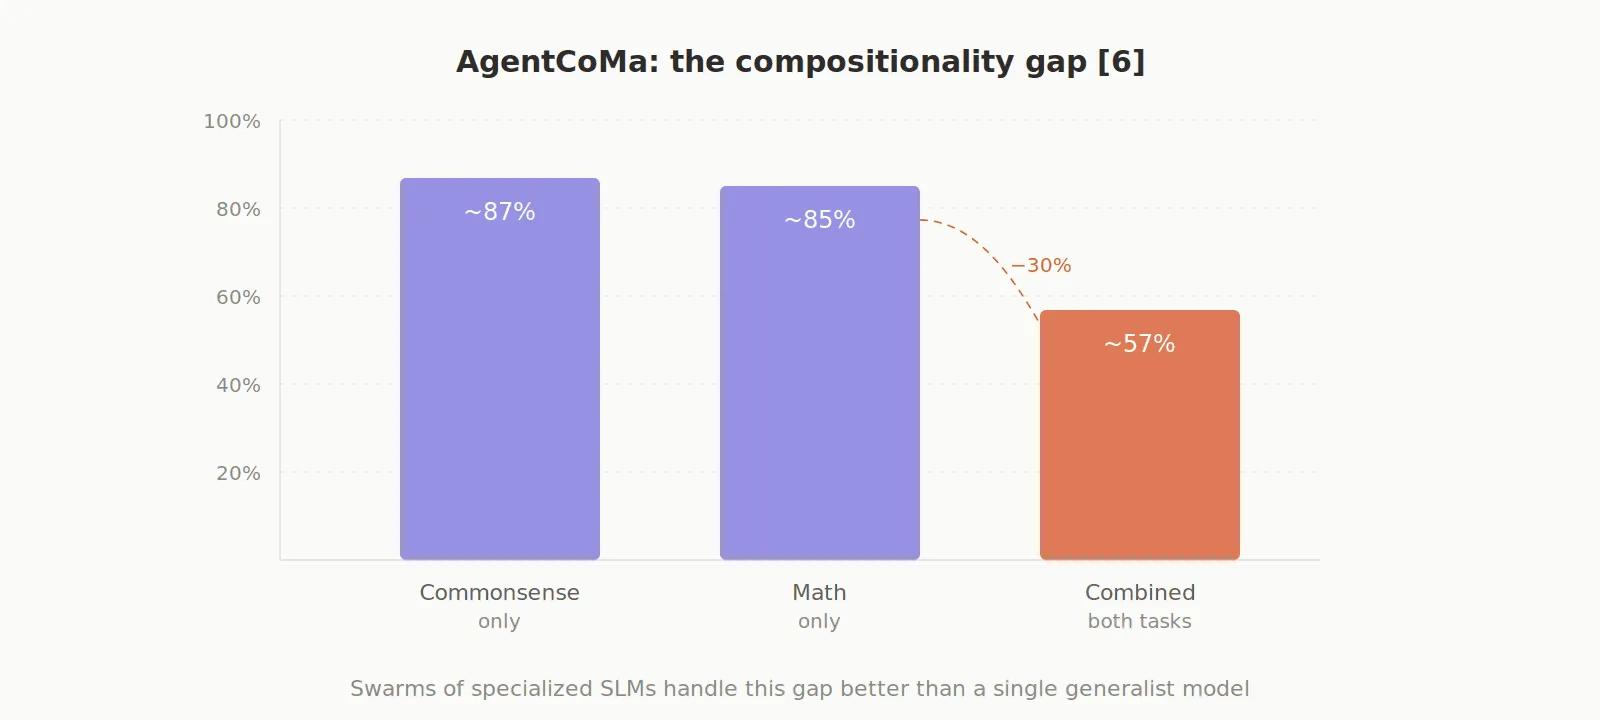
Der AgentCoMa-Benchmark deckte ein weiteres Problem auf: die Kompositionalitätslücke. Modelle lösen Alltagslogik-Schritte und Rechenschritte getrennt gut (~85 % und mehr), doch werden beide in einer Aufgabe kombiniert, sinkt die Leistung um rund 30 %. Ein Schwarm spezialisierter SLMs löst das besser als ein einziges riesiges Generalistenmodell. [6]
5. Multi-Agenten-Architekturen
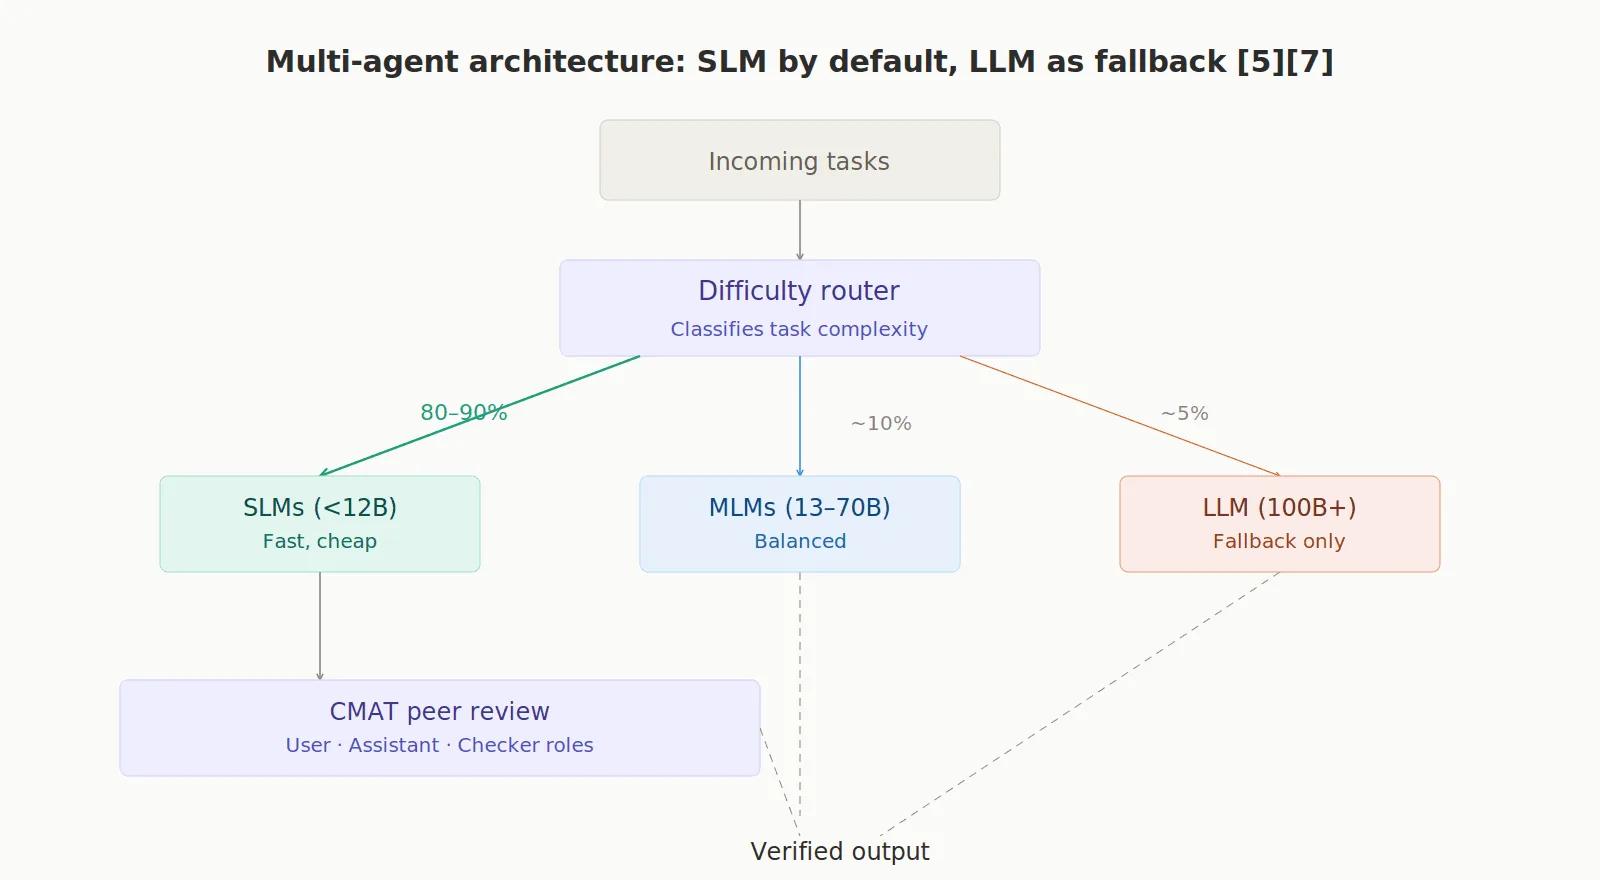
Das ideale Betriebsmodell lautet „SLM als Standard, LLM als Fallback“. Ein Router klassifiziert Aufgaben nach Schwierigkeit: Einfache gehen an günstige SLMs, mittlere an MLMs, und nur wirklich komplexe werden an das große LLM eskaliert. So werden 80–90 % der Arbeitslast von SLMs erledigt. Frameworks wie CMAT weisen verschiedenen SLMs Rollen zu (User, Assistant, Checker), die sich gegenseitig prüfen. [7]
6. Sicherheit
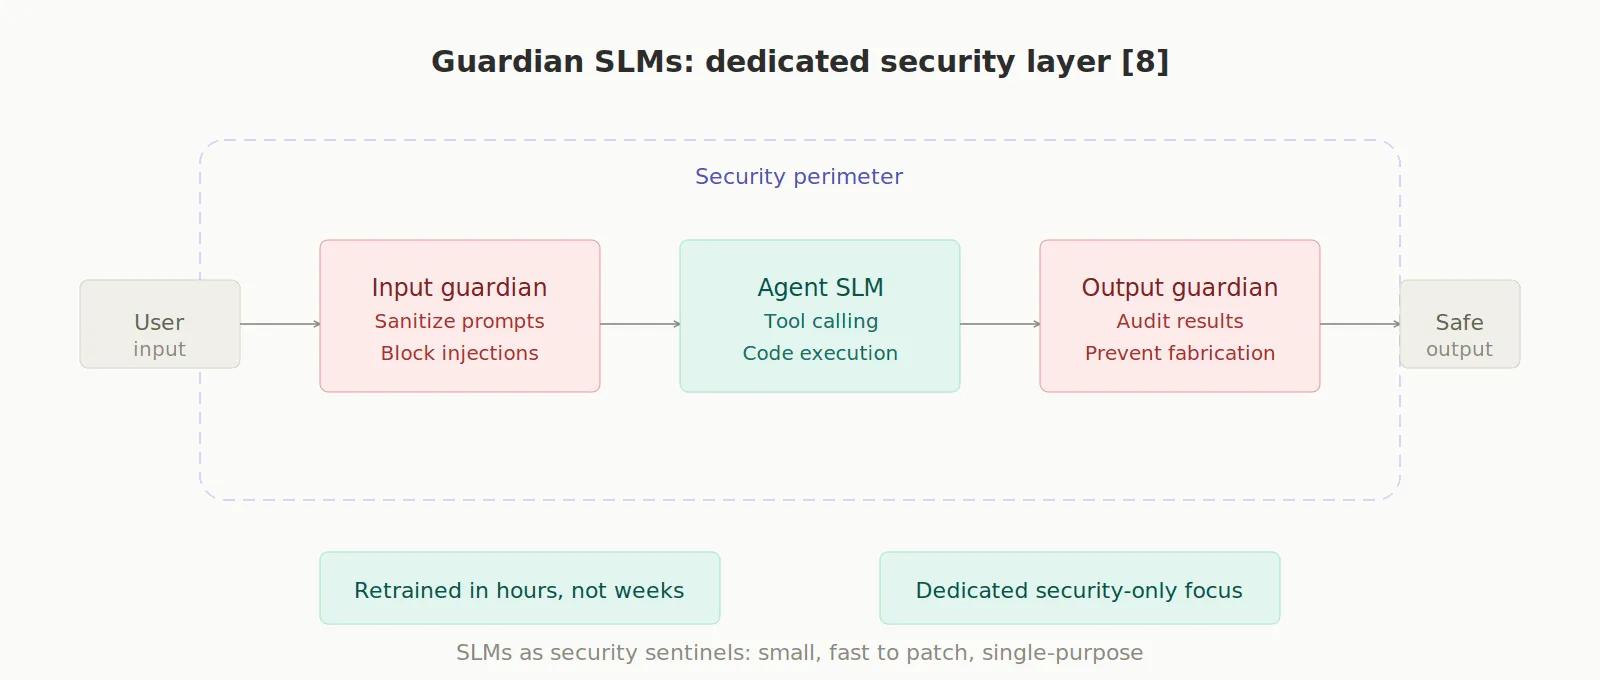
Autonome Agenten mit Zugriff auf APIs und Datenbanken sind ernstzunehmende Angriffsvektoren. Hier haben SLMs einen Vorteil: Sie lassen sich innerhalb von Stunden patchen und neu trainieren. Zusätzlich können „Guardian-SLMs“ eingesetzt werden – Modelle, die ausschließlich Eingaben bereinigen, Ausgaben prüfen und Prompt Injections sowie erfundene Datensätze verhindern. [8]
Fazit
Die Zukunft agentischer KI wird von vier zentralen Prinzipien bestimmt, die sich vom klassischen, riesigen und zentralisierten Modell abwenden.
Erstens liegt ein starker Fokus auf Kosten- und Latenzvorteilen: Kleinere Modelle (SLMs/MLMs mit 1 bis 70 Mrd. Parametern) werden bevorzugt, weil sie Kosten drastisch senken, die Geschwindigkeit erhöhen und die Energieeffizienz verbessern – das macht einen kontinuierlichen, autonomen Betrieb realistisch und skalierbar.
Diese Effizienz führt direkt zum zweiten Prinzip: Tool-Erweiterung statt reiner Größe. Überlegene Leistung entsteht nicht durch immer größere, isolierte Modelle, sondern durch die systematische Kombination kleinerer Modelle mit programmatischen Tools – eine Synergie, die monolithische Modelle immer wieder übertrifft.
Drittens wird die Notwendigkeit der Spezialisierung deutlich: Allzweckmodelle reichen für die enorme Vielfalt komplexer Reasoning-Aufgaben nicht aus. Ein „Schwarm“ spezialisierter SLMs, intelligent koordiniert durch einen effizienten Routing-Mechanismus, ist die wirksamste Lösung.
Schließlich ist die Rolle der Architektur für die Effizienz entscheidend: Fortgeschrittene Techniken wie Extreme MoE, agentische Destillation und kognitives Scaffolding verdichten die Intelligenz und Fähigkeiten von Frontier-Modellen in äußerst kompakte und effiziente Ausführungs-Engines.
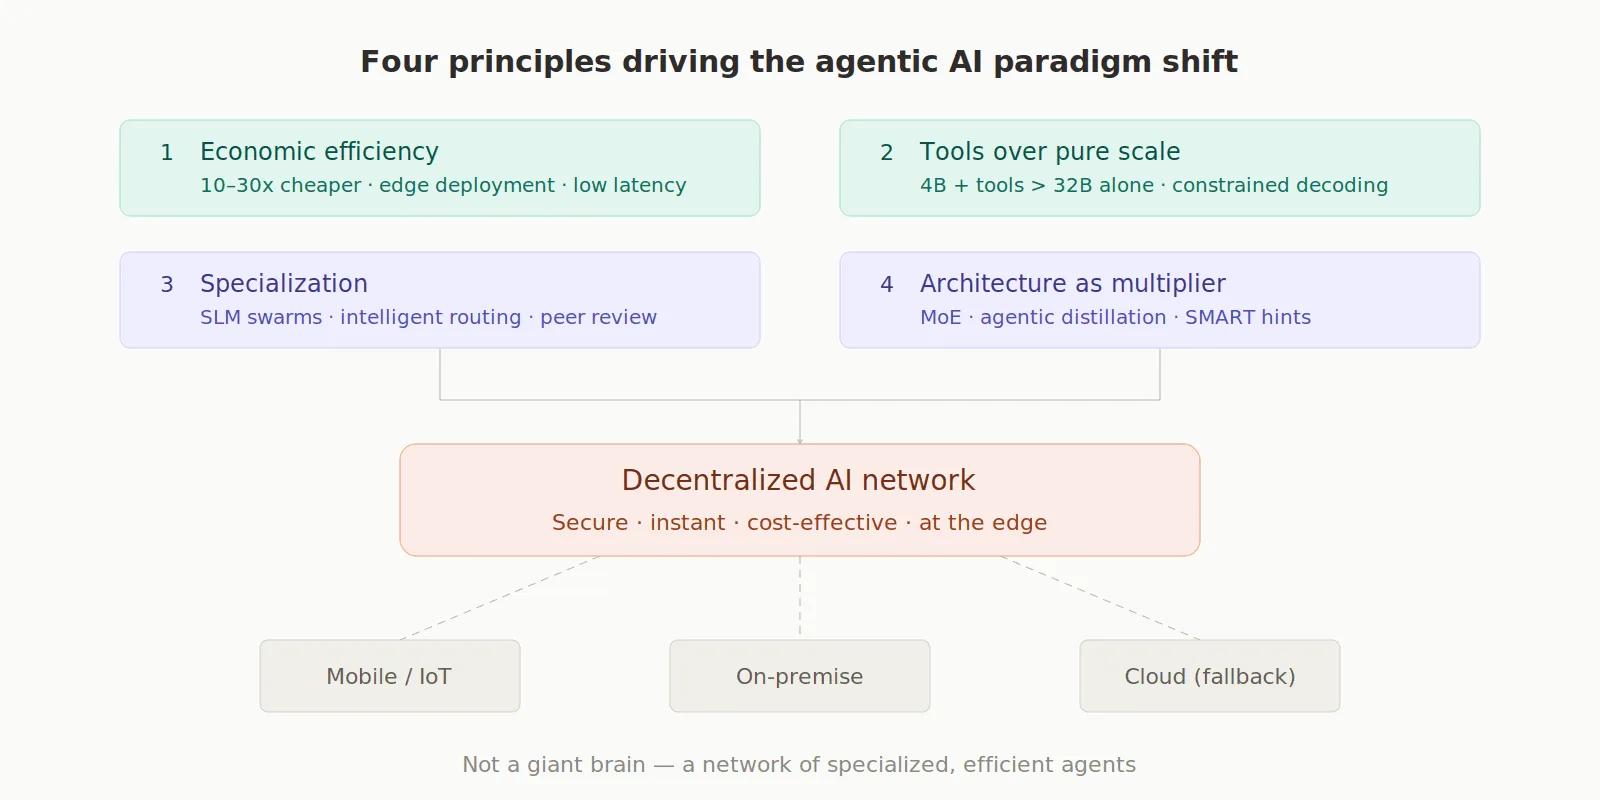
Dieser Paradigmenwechsel bedeutet: Die Zukunft agentischer KI ist kein zentrales „Riesengehirn“, sondern ein dezentrales Netz aus kleinen und mittleren Modellen, die sicher, verzögerungsfrei und kosteneffizient am Rand des Netzwerks arbeiten.
Quellen
[1] Jhandi, P., Kazi, O., Subramanian, S., & Sendas, N. (2025). Small Language Models for Efficient Agentic Tool Calling: Outperforming Large Models with Targeted Fine-tuning. [Kleine Sprachmodelle für effizientes agentisches Tool-Calling: große Modelle durch gezieltes Fine-Tuning übertreffen] arXiv:2512.15943. https://arxiv.org/abs/2512.15943
[2] Hu, Q., Lin, Z., Yang, Z., Ding, Y., Liu, X., Jiang, Y., Wang, R., Chen, T., Guo, Z., Xiong, Y., Gao, R., Qu, L., Su, J., Cheng, P., & Gong, Y. (2025). Sigma-MoE-Tiny Technical Report. [Technischer Bericht zu Sigma-MoE-Tiny] arXiv:2512.16248. https://arxiv.org/abs/2512.16248
[3] Kang, M., Jeong, J., Lee, S., Cho, J., & Hwang, S. J. (2025). Distilling LLM Agent into Small Models with Retrieval and Code Tools. [Einen LLM-Agenten mit Retrieval- und Code-Tools in kleine Modelle destillieren] arXiv:2505.17612. https://arxiv.org/abs/2505.17612
[4] Kim, Y., Yi, E., Kim, M., Yun, S.-Y., & Kim, T. (2025). Guiding Reasoning in Small Language Models with LLM Assistance. [Das Reasoning kleiner Sprachmodelle mit LLM-Unterstützung steuern] arXiv:2504.09923. https://arxiv.org/abs/2504.09923
[5] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2026). Can Small Agent Collaboration Beat a Single Big LLM?. [Kann die Zusammenarbeit kleiner Agenten ein einzelnes großes LLM schlagen?] arXiv:2601.11327. https://arxiv.org/abs/2601.11327
[6] Alazraki, L., Chen, L., Brassard, A., Stacey, J., Rahmani, H. A., & Rei, M. (2025). AgentCoMa: A Compositional Benchmark Mixing Commonsense and Mathematical Reasoning in Real-World Scenarios. [AgentCoMa: ein kompositioneller Benchmark aus Alltagslogik und mathematischem Reasoning in realen Szenarien] arXiv:2508.19988. https://arxiv.org/abs/2508.19988
[7] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2025). Route-and-Reason: Scaling Large Language Model Reasoning with Reinforced Model Router. [Route-and-Reason: LLM-Reasoning mit einem bestärkten Modell-Router skalieren] arXiv:2506.05901. https://arxiv.org/abs/2506.05901
[8] Evertz, J., Chlosta, M., Schönherr, L., & Eisenhofer, T. (2024). Whispers in the Machine: Confidentiality in Agentic Systems. [Flüstern in der Maschine: Vertraulichkeit in agentischen Systemen] arXiv:2402.06922. https://arxiv.org/abs/2402.06922
[9] Sharma, R. & Mehta, M. (2025). Small Language Models for Agentic Systems: A Survey of Architectures, Capabilities, and Deployment Trade-offs. [Kleine Sprachmodelle für agentische Systeme: ein Überblick über Architekturen, Fähigkeiten und Deployment-Abwägungen] arXiv:2510.03847. https://arxiv.org/abs/2510.03847
[10] Belcak, P. et al. (2025). Small Language Models are the Future of Agentic AI. [Kleine Sprachmodelle sind die Zukunft agentischer KI] arXiv:2506.02153. https://arxiv.org/abs/2506.02153
