

Küçük modeller ajan tabanlı yapay zekâyı nasıl güçlendiriyor
 Toni Lopez Co-Founder at Karumi
Yapay zekâ bir paradigma değişiminden geçiyor. Yıllarca hâkim mantık “büyük = iyi” oldu: yüz milyarlarca parametreye sahip, her şeyde iyi olmaya çalışan modeller (öncü LLM’ler). Evet, genel sohbet ve akıl yürütmede etkileyici işler başardılar. Ama odak değişti. Artık mesele yalnızca soruları yanıtlamak değil; ajan tabanlı sistemler kurmak: plan yapan, API çağıran, kod çalıştıran, yapılandırılmış verilerle çalışan ve zincirleme kararlar alan otonom yapay zekâlar. Bu bağlamda devasa modeller pahalı, yavaş ve gereğinden karmaşık kalıyor.
Bu yazıda, Small Language Model’lerin (12 milyar parametrenin altı) ve Medium Language Model’lerin (13 ila 70 milyar parametre) ajan tabanlı görevler için yalnızca yeterli olmadığını; doğru eğitim ve farklı tekniklerle büyük modelleri geride bırakabileceğini savunuyoruz. İlerleyen yazılarda bu yeniliklerin her birini tek tek ele alıp herkesin anlayacağı bir dille açıklayacağız. Bugünkü amacımız, küçük ve orta ölçekli dil modellerinin sektörün bir sonraki büyük hamlesi olacağını nasıl ve neden düşündüğümüzü göstermek.
1. Ekonomi ve operasyonel verimlilik
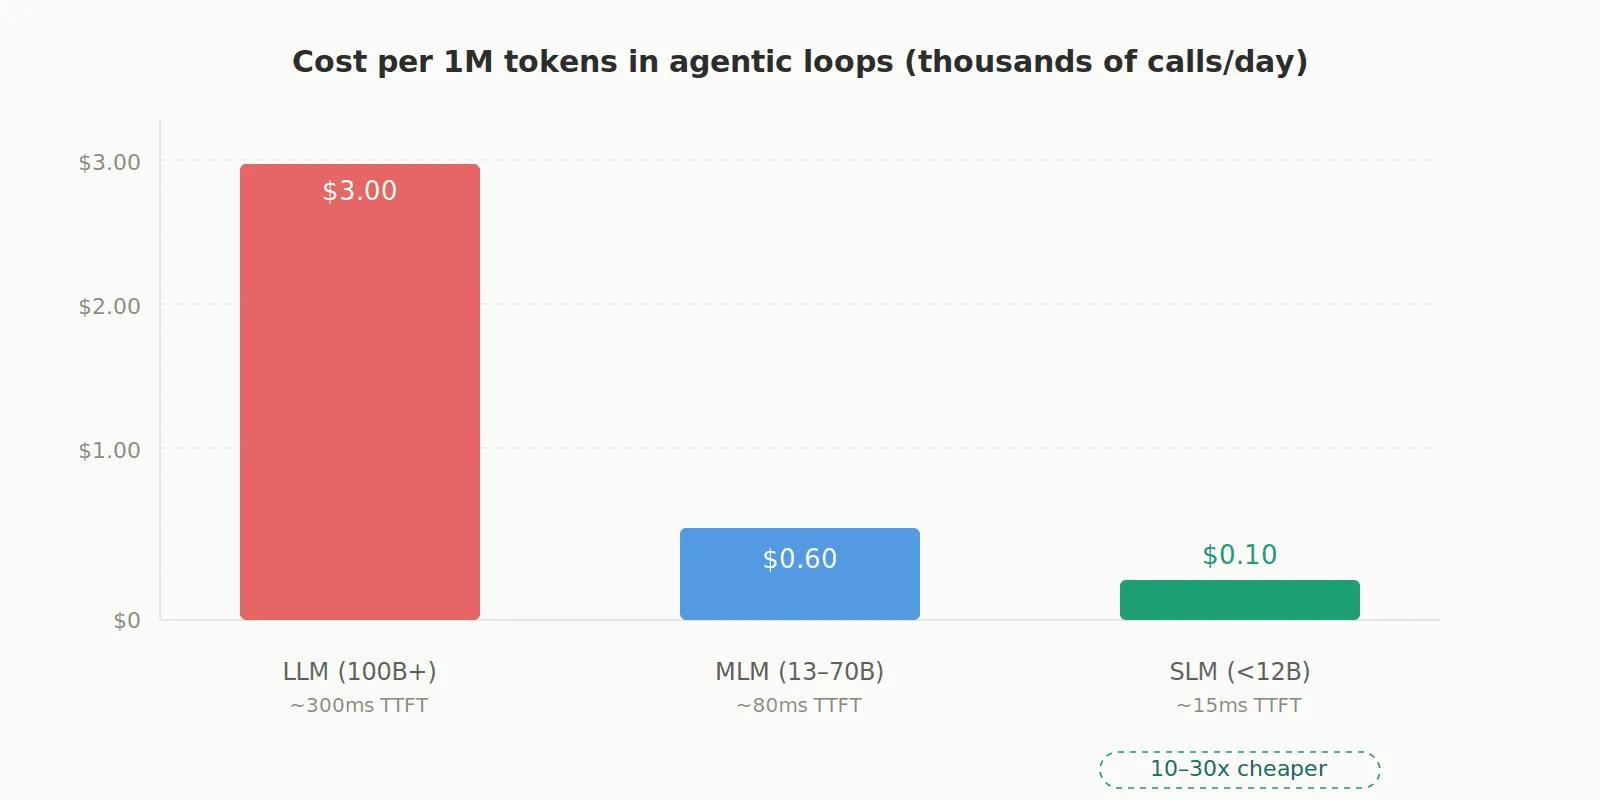
Ajan tabanlı sistemler tek bir sorgu yapmakla kalmaz; sıkı döngüler içinde binlerce çağrı yürütür. Bunun için 100 milyar parametreli bir model kullanmak, markete Formula 1 aracıyla gitmeye benzer. SLM’ler token başına 10 ila 30 kat daha ucuzdur, gecikmeleri çok düşüktür (ilk token’a kadar geçen süre çok daha kısadır) ve CPU’larda hatta mobil cihazlarda bile çalışabilir. Bu, uç (edge) dağıtımı da mümkün kılar: yapay zekâyı buluta bağımlı olmadan yerelde çalıştırmak, gizlilik, veri egemenliği ve gecikme sorunlarını çözer.
2. Ajan becerileri devasa ölçek gerektirmez
Gerçek şu ki ajan tabanlı bir modelin şiir ya da hikâye yazmasına gerek yok. Bir ajanın ihtiyacı kısaca şunlar: doğru fonksiyon çağrıları, geçerli JSON üretimi, şemaya sıkı bağlılık ve kod çalıştırabilme. Günümüzde SLM’ler biçimlendirilmiş çıktıları kusursuz üretebiliyor; bulduğum örnekler kısıtlı çözümleme (constrained decoding) tekniklerini kullanıyor (XGrammar ve Outlines bu tür teknikler sunan kütüphaneler) ve bu sayede SLM’ler öncü modellerle aradaki farkı kapatıyor.
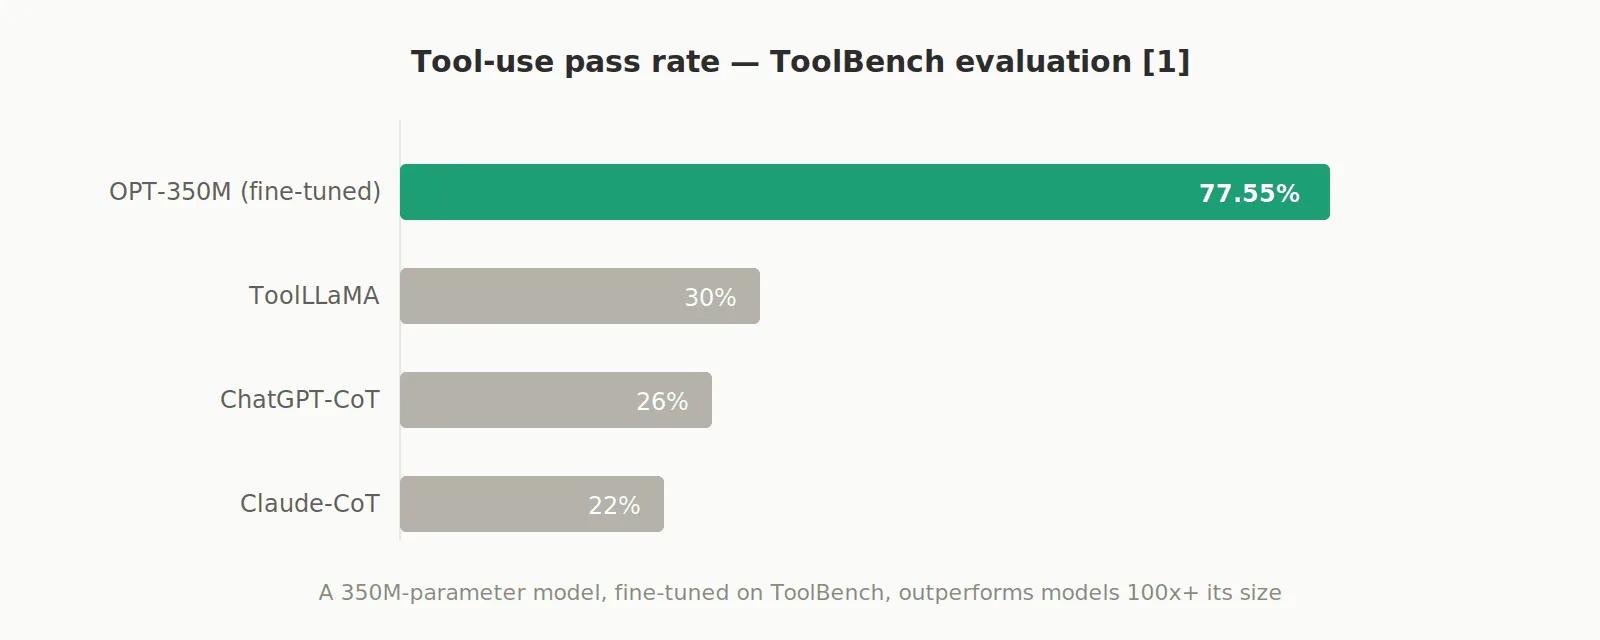
Örneğin yalnızca 350 milyon parametreli bir model (OPT-350M), ToolBench verileriyle ince ayar yapıldıktan sonra araç kullanımı değerlendirmelerinde %77,55 başarı oranına ulaştı ve ChatGPT-CoT’u (%26), ToolLLaMA’yı (%30) ve Claude-CoT’u açık ara geride bıraktı [1].
3. Temel mimari yenilikler
Sektörde iyi bilinen bazı mimariler var; ilginç olan, bunların SLM’lerle daha iyi performans elde etmek için nasıl uygulandığı.
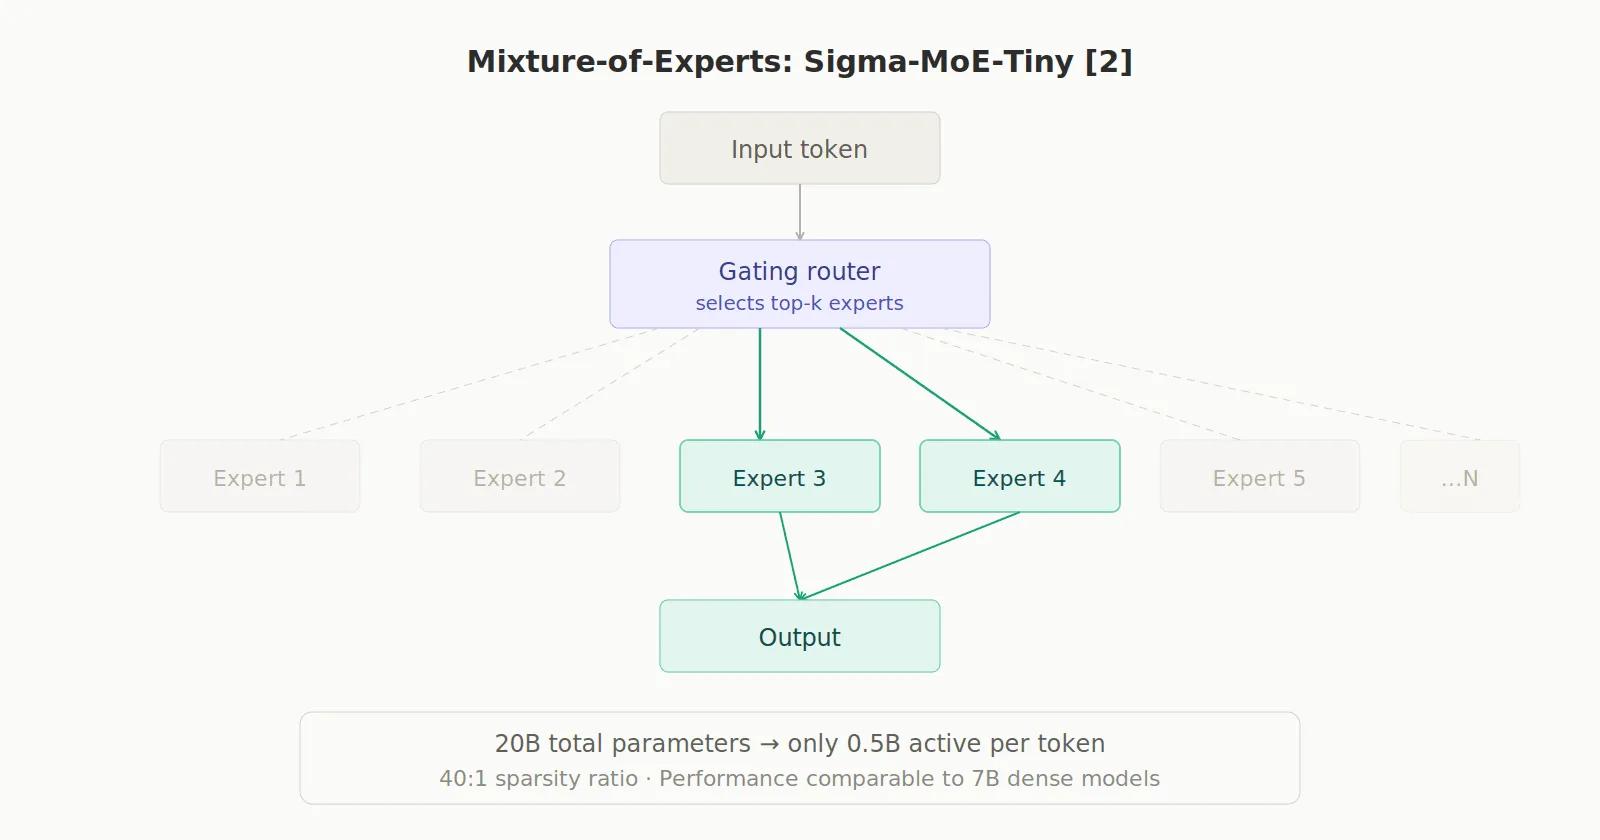
Mixture-of-Experts (MoE): Sigma-MoE-Tiny gibi modellerin toplamda 20 milyar parametresi vardır, ancak token başına yalnızca 0,5 milyarı etkinleşir (40:1 oranı). Böylece matematik ve kodlamada 7 milyarlık yoğun modellerle kıyaslanabilir bir performansa, hesaplama gücünün çok küçük bir kısmıyla ulaşır. [2]
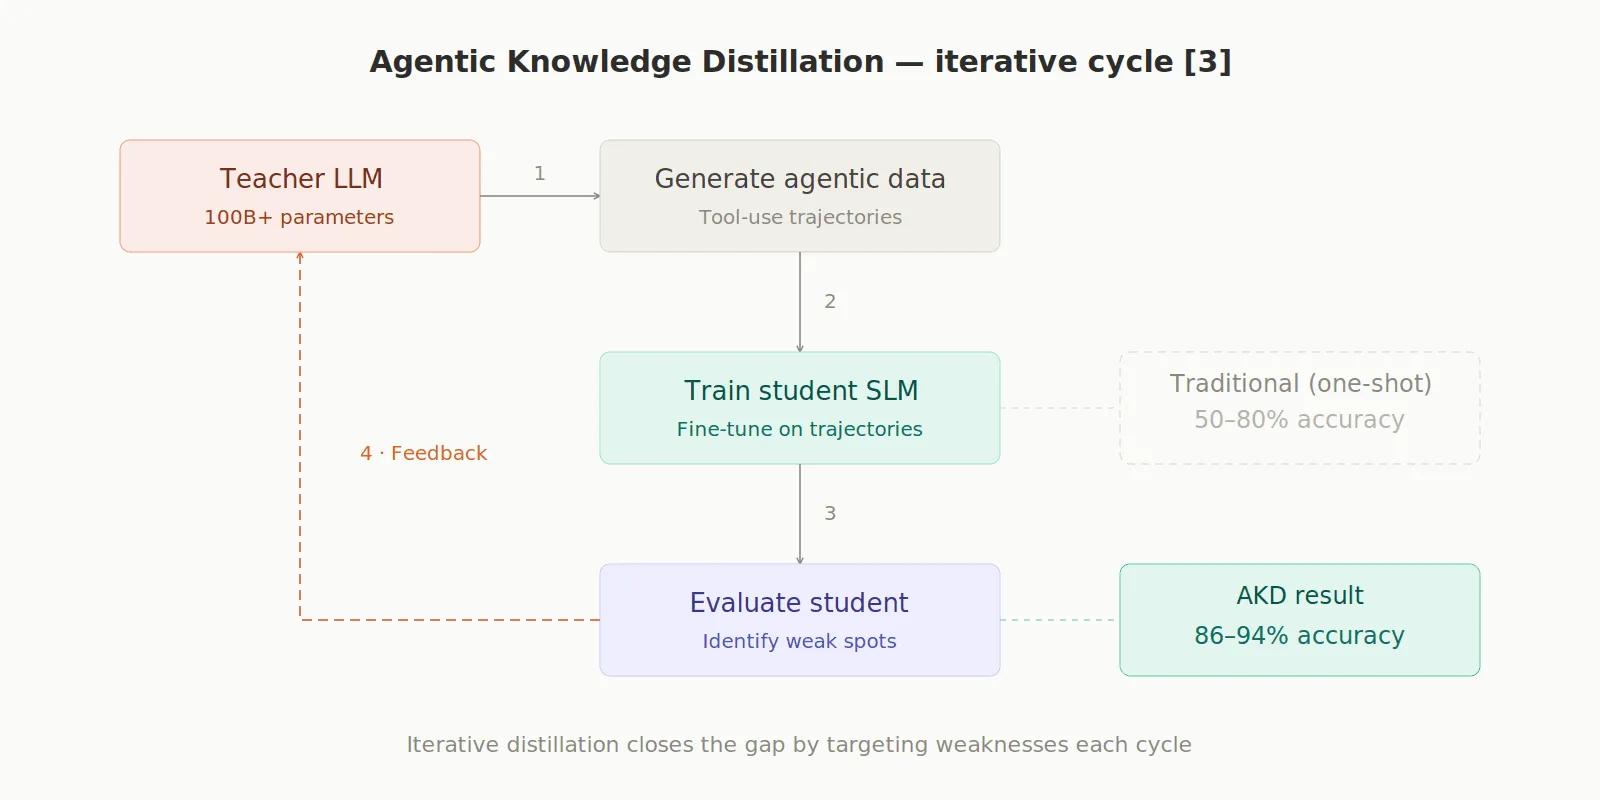
Agentic Knowledge Distillation (AKD): Büyük bir LLM, veri üreten, küçük modeli değerlendiren ve onu yinelemeli olarak eğiten bir “otonom öğretmen” rolü üstlenir. Bu şekilde damıtılan modeller güvenlik görevlerinde %86–94 doğruluğa ulaşırken geleneksel yöntemlerde bu oran %50–80’de kalıyor. [3]
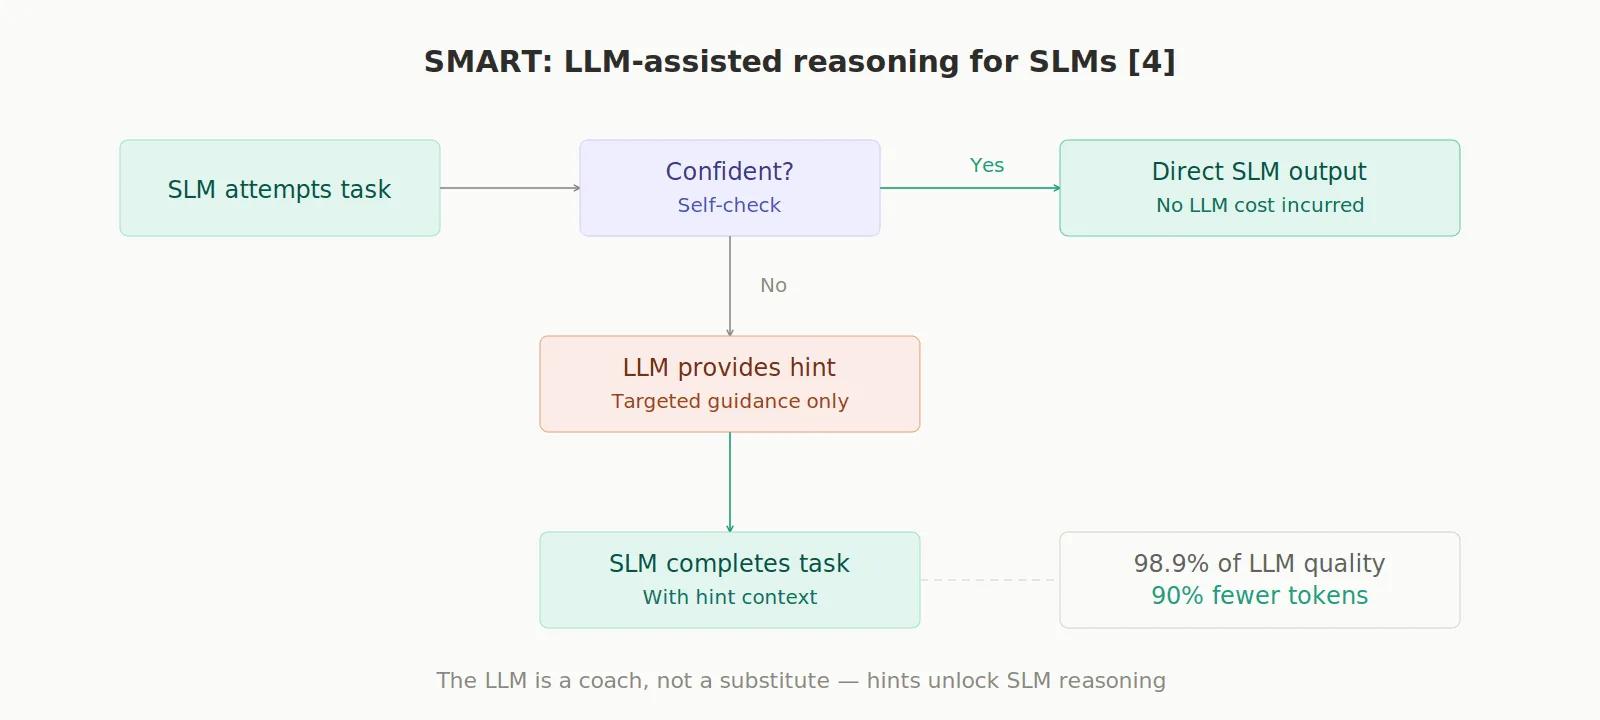
SMART Framework: Bir SLM karmaşık bir akıl yürütmede takıldığında, büyük LLM her şeyi çözmek için değil, yalnızca hedefli bir “ipucu” vermek için devreye girer. Bu yöntem, %90 daha az token kullanarak büyük LLM’in performansının %98,9’una ulaşır. [4]
4. Benchmark’lar
Benchmark’lar, modellerin belirli görevlerde ne kadar iyi olduğunu tahmin etmemizi ve güvenilirliklerini doğrulamamızı sağlar.
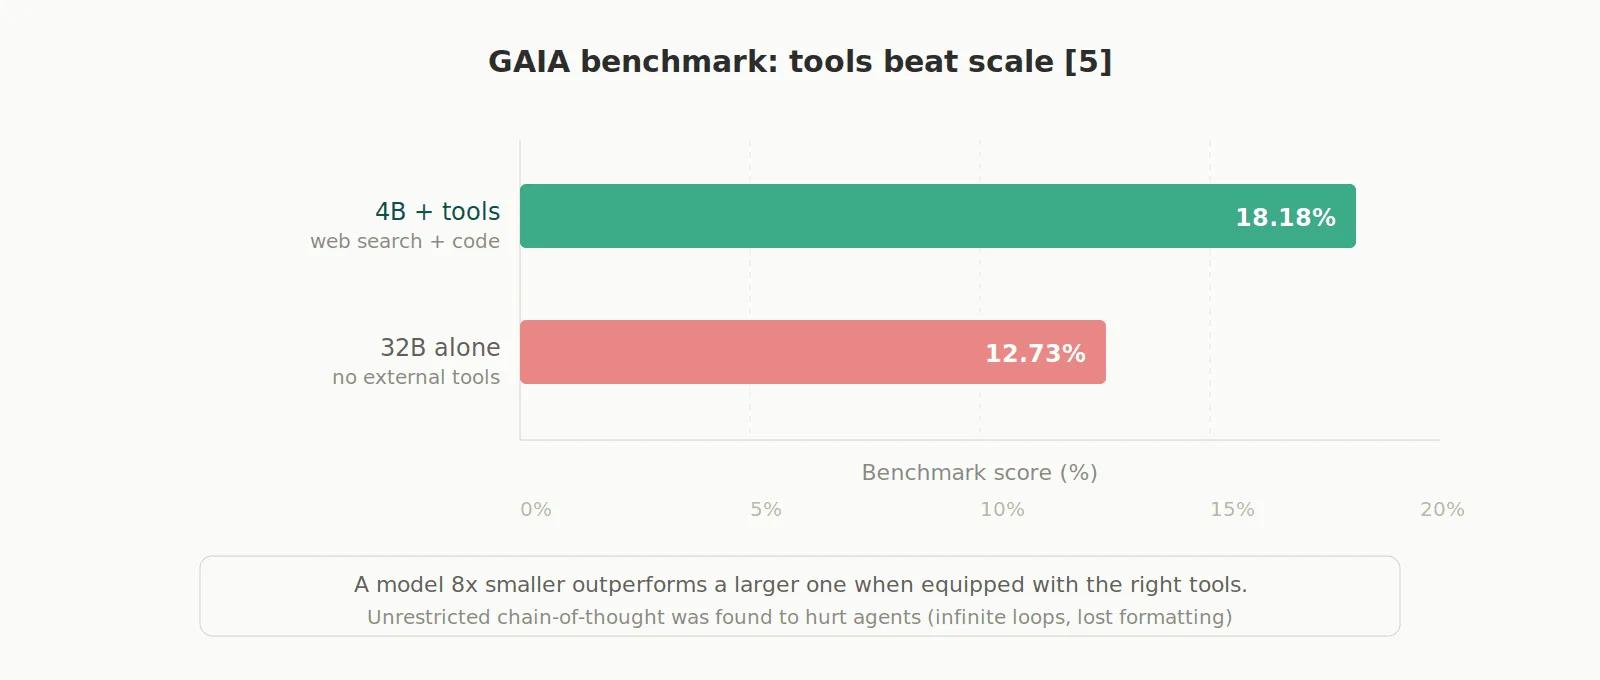
GAIA benchmark’ında araçlarla (web araması, kod çalıştırma) donatılmış 4 milyar parametreli modeller, araçsız 32 milyarlık modelleri geride bıraktı (%18,18’e karşı %12,73). Ayrıca sınırsız “tam düşünme”nin (kısıtsız chain-of-thought) ajanlara aslında zarar verdiği görüldü: sonsuz döngülere girmelerine ve biçimi kaybetmelerine yol açıyor. Akıl yürütmeyi yalnızca planlama aşamasıyla sınırlamak daha iyi. [5]
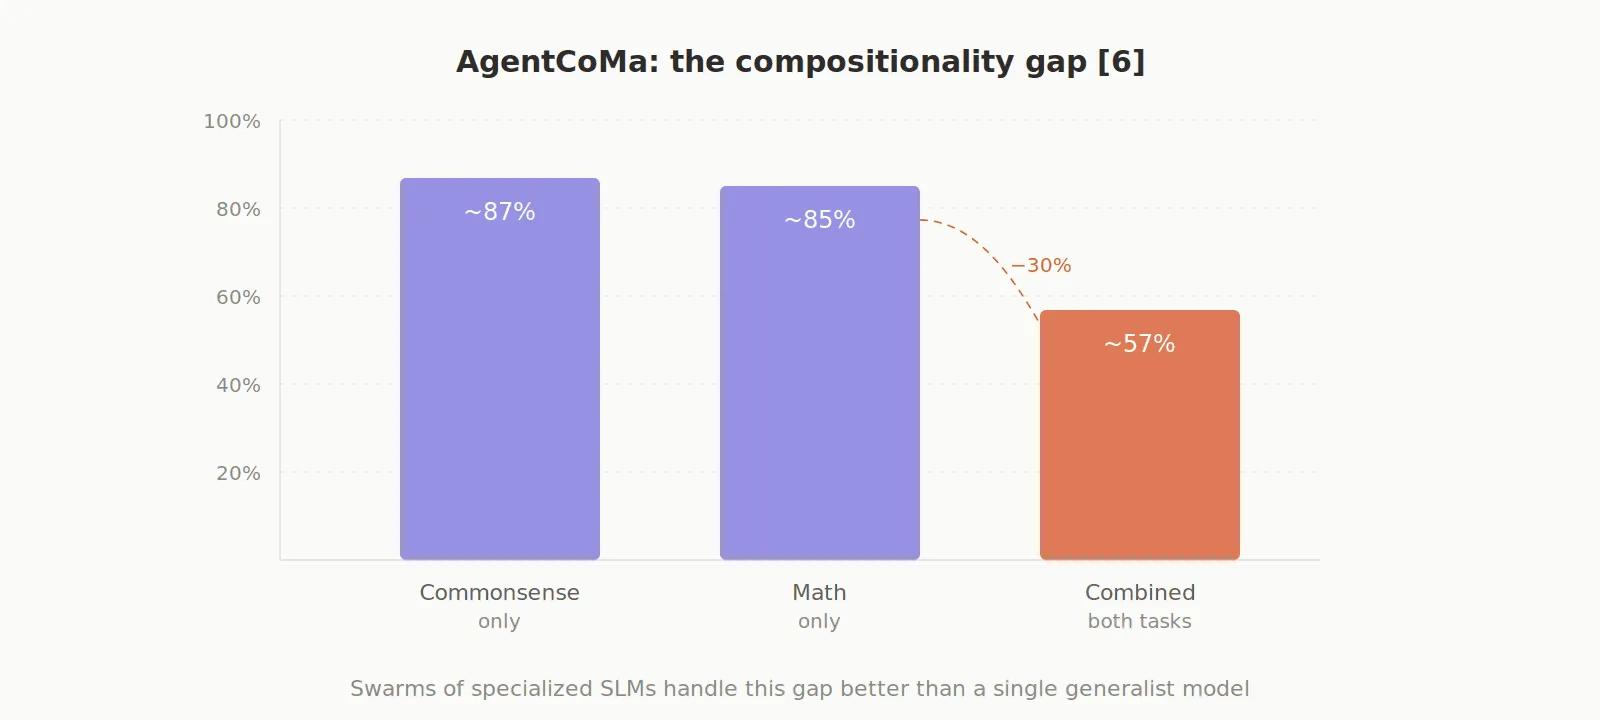
AgentCoMa benchmark’ı başka bir sorunu ortaya çıkardı: bileşimsellik açığı. Modeller sağduyu adımlarını ve matematik adımlarını ayrı ayrı çözebiliyor (~%85 ve üzeri), ancak ikisi tek bir görevde birleştiğinde performans yaklaşık %30 düşüyor. Bu sorunu tek bir devasa genel model yerine uzmanlaşmış SLM sürüleri daha iyi çözüyor. [6]
5. Çoklu ajan mimarileri
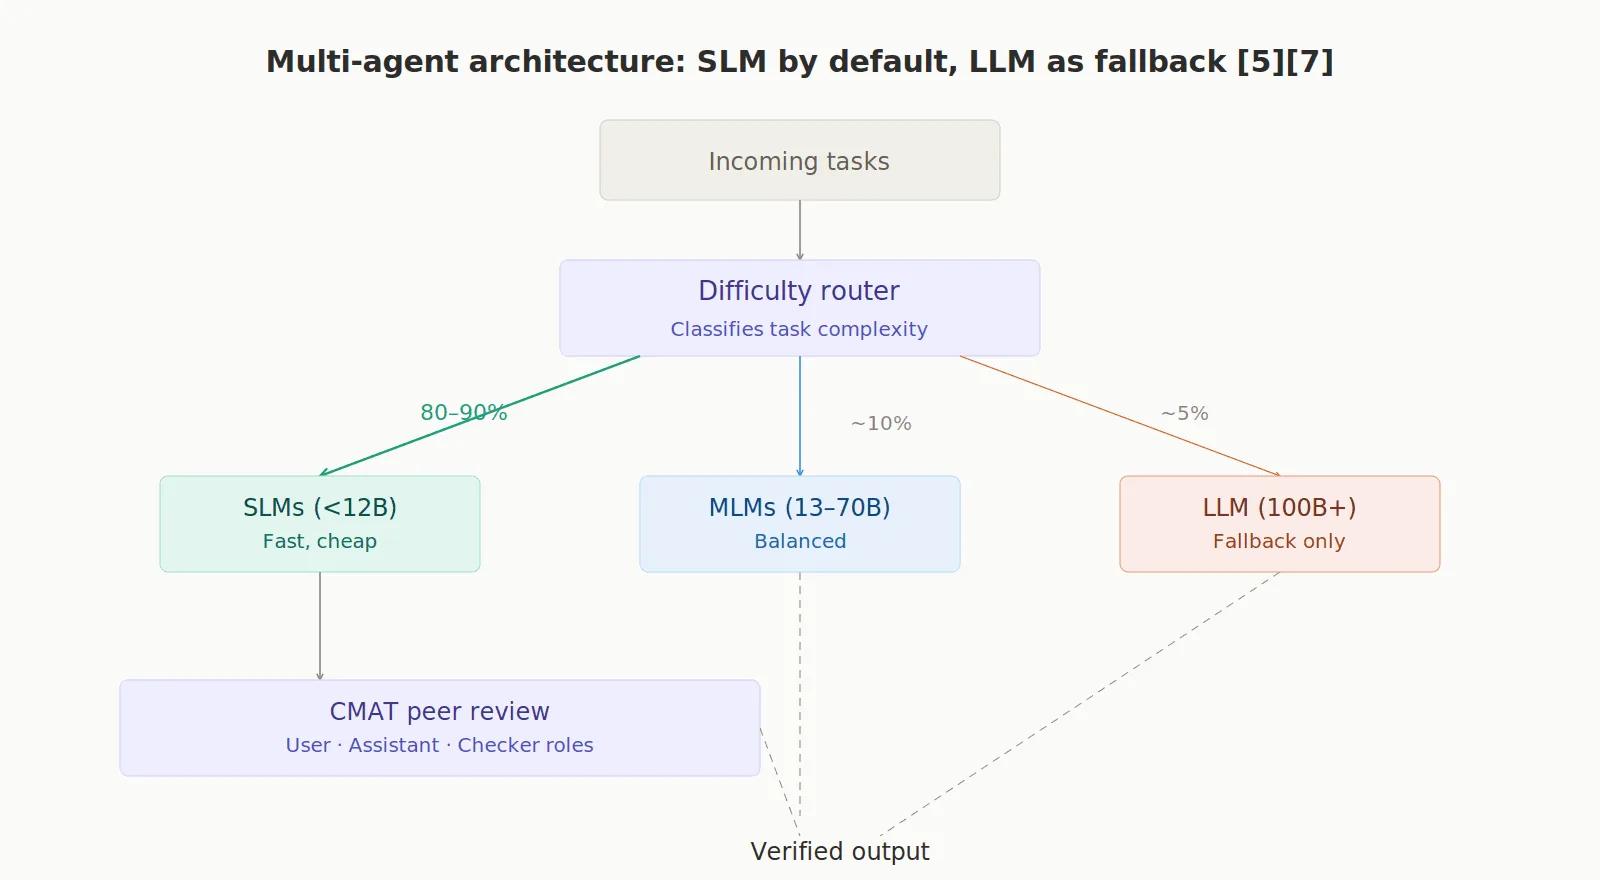
İdeal operasyon modeli şu: “Varsayılan olarak SLM, yedek olarak LLM.” Bir yönlendirici görevleri zorluklarına göre sınıflandırır: kolay olanlar ucuz SLM’lere, orta düzeydekiler MLM’lere gider ve yalnızca gerçekten karmaşık olanlar büyük LLM’e aktarılır. Böylece iş yükünün %80–90’ını SLM’ler üstlenir. CMAT gibi framework’ler farklı SLM’lere roller (User, Assistant, Checker) atar ve bu modeller birbirinin çıktısını denetler. [7]
6. Güvenlik
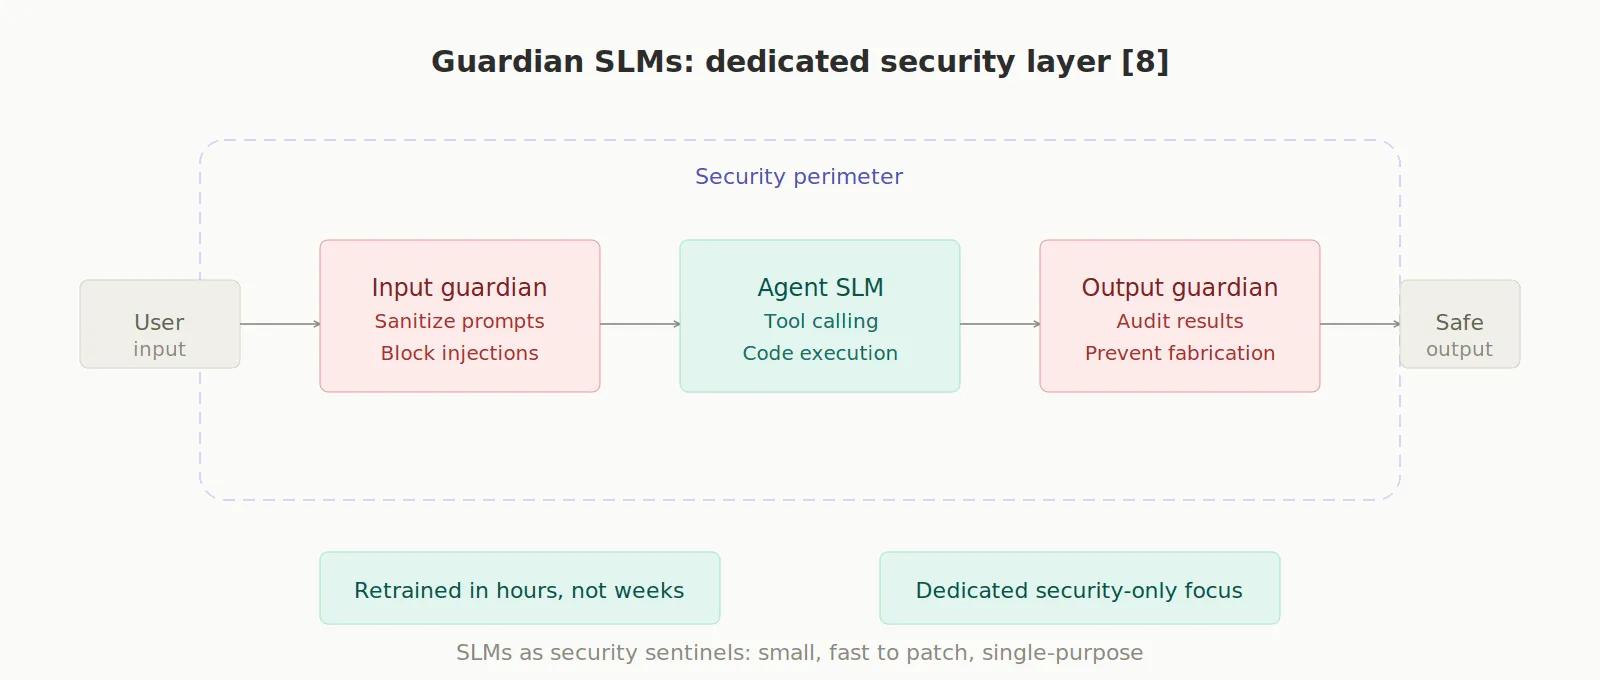
API’lere ve veritabanlarına erişimi olan otonom ajanlar ciddi saldırı vektörleridir. SLM’lerin burada bir avantajı var: birkaç saat içinde yamalanıp yeniden eğitilebilirler. Ayrıca yalnızca girdileri temizlemeye, çıktıları denetlemeye, prompt injection’ı ve sahte kayıt üretimini önlemeye adanmış “Koruyucu SLM’ler” devreye alınabilir. [8]
Sonuç
Ajan tabanlı yapay zekânın geleceği, geleneksel devasa ve merkezî modelden uzaklaşan dört temel ilkeyle şekilleniyor.
Birincisi, maliyet ve gecikme avantajlarına güçlü bir odak var: Daha küçük modeller (1 ila 70 milyar parametreli SLM’ler/MLM’ler) maliyeti ciddi ölçüde düşürdükleri, hızı artırdıkları ve enerji verimliliğini iyileştirdikleri için tercih ediliyor; bu da sürekli ve otonom çalışmayı uygulanabilir ve ölçeklenebilir kılıyor.
Bu verimlilik doğrudan ikinci ilkeye götürüyor: salt ölçek yerine araçlarla güçlendirme. Üstün performans, giderek büyüyen yalıtılmış modellerle değil, küçük modellerin programatik araçlarla sistematik biçimde entegre edilmesiyle elde ediliyor; bu sinerji monolitik modelleri tutarlı biçimde geride bırakıyor.
Üçüncüsü, uzmanlaşma zorunluluğu netleşiyor: Genel amaçlı modeller, karmaşık akıl yürütme görevlerinin muazzam çeşitliliği karşısında yetersiz kalıyor. Verimli bir yönlendirme mekanizmasıyla akıllıca koordine edilen uzmanlaşmış bir SLM “sürüsü” en etkili çözüm.
Son olarak, verimlilikte mimarinin rolü belirleyici: Extreme MoE, ajan tabanlı damıtma ve bilişsel iskele (cognitive scaffolding) gibi ileri teknikler, öncü modellerin zekâsını ve yeteneklerini son derece kompakt ve verimli yürütme motorlarına sığdırmak için kullanılıyor.
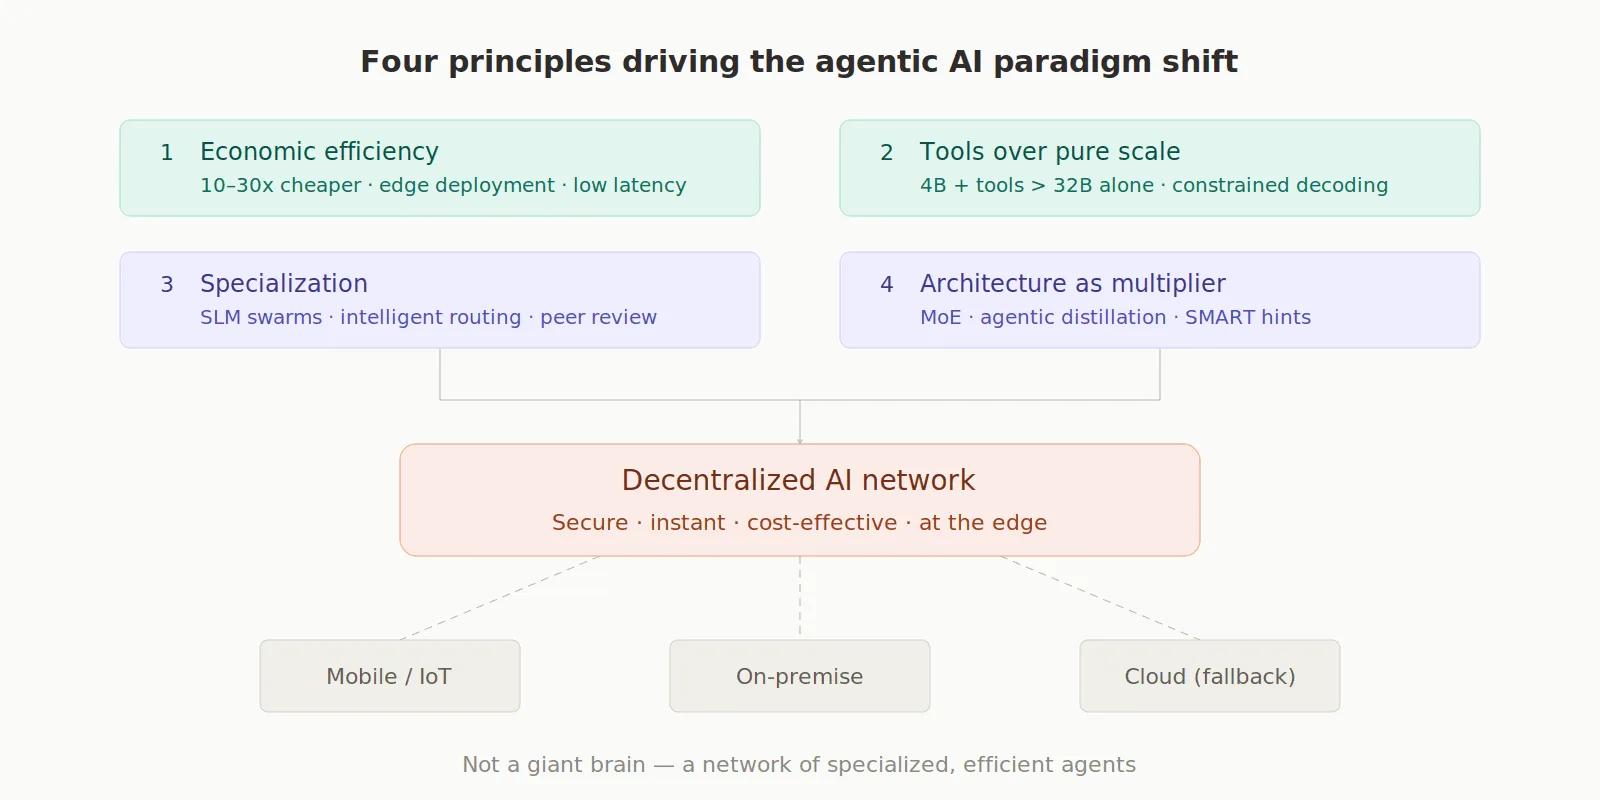
Bu paradigma değişimi, ajan tabanlı yapay zekânın geleceğinin merkezî bir “dev beyin” değil; ağın uç noktalarında güvenli, anlık ve düşük maliyetle çalışan küçük ve orta ölçekli modellerden oluşan merkeziyetsiz bir ağ olduğu anlamına geliyor.
Kaynaklar
[1] Jhandi, P., Kazi, O., Subramanian, S., & Sendas, N. (2025). Small Language Models for Efficient Agentic Tool Calling: Outperforming Large Models with Targeted Fine-tuning. [Verimli ajan tabanlı araç çağırma için küçük dil modelleri: hedefli ince ayarla büyük modelleri geride bırakmak] arXiv:2512.15943. https://arxiv.org/abs/2512.15943
[2] Hu, Q., Lin, Z., Yang, Z., Ding, Y., Liu, X., Jiang, Y., Wang, R., Chen, T., Guo, Z., Xiong, Y., Gao, R., Qu, L., Su, J., Cheng, P., & Gong, Y. (2025). Sigma-MoE-Tiny Technical Report. [Sigma-MoE-Tiny teknik raporu] arXiv:2512.16248. https://arxiv.org/abs/2512.16248
[3] Kang, M., Jeong, J., Lee, S., Cho, J., & Hwang, S. J. (2025). Distilling LLM Agent into Small Models with Retrieval and Code Tools. [Bir LLM ajanını arama ve kod araçlarıyla küçük modellere damıtmak] arXiv:2505.17612. https://arxiv.org/abs/2505.17612
[4] Kim, Y., Yi, E., Kim, M., Yun, S.-Y., & Kim, T. (2025). Guiding Reasoning in Small Language Models with LLM Assistance. [Küçük dil modellerinde akıl yürütmeyi LLM desteğiyle yönlendirmek] arXiv:2504.09923. https://arxiv.org/abs/2504.09923
[5] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2026). Can Small Agent Collaboration Beat a Single Big LLM?. [Küçük ajanların iş birliği tek bir büyük LLM’i yenebilir mi?] arXiv:2601.11327. https://arxiv.org/abs/2601.11327
[6] Alazraki, L., Chen, L., Brassard, A., Stacey, J., Rahmani, H. A., & Rei, M. (2025). AgentCoMa: A Compositional Benchmark Mixing Commonsense and Mathematical Reasoning in Real-World Scenarios. [AgentCoMa: gerçek dünya senaryolarında sağduyu ve matematiksel akıl yürütmeyi birleştiren bileşimsel bir benchmark] arXiv:2508.19988. https://arxiv.org/abs/2508.19988
[7] Shao, C., Liu, X., Lin, Y., Xu, F., & Li, Y. (2025). Route-and-Reason: Scaling Large Language Model Reasoning with Reinforced Model Router. [Route-and-Reason: pekiştirmeli model yönlendiriciyle LLM akıl yürütmesini ölçeklendirmek] arXiv:2506.05901. https://arxiv.org/abs/2506.05901
[8] Evertz, J., Chlosta, M., Schönherr, L., & Eisenhofer, T. (2024). Whispers in the Machine: Confidentiality in Agentic Systems. [Makinedeki fısıltılar: ajan tabanlı sistemlerde gizlilik] arXiv:2402.06922. https://arxiv.org/abs/2402.06922
[9] Sharma, R. & Mehta, M. (2025). Small Language Models for Agentic Systems: A Survey of Architectures, Capabilities, and Deployment Trade-offs. [Ajan tabanlı sistemler için küçük dil modelleri: mimariler, yetenekler ve dağıtım ödünleşimleri üzerine bir derleme] arXiv:2510.03847. https://arxiv.org/abs/2510.03847
[10] Belcak, P. et al. (2025). Small Language Models are the Future of Agentic AI. [Küçük dil modelleri ajan tabanlı yapay zekânın geleceğidir] arXiv:2506.02153. https://arxiv.org/abs/2506.02153
